Command Palette
Search for a command to run...
WAYPOINT-OPD:通过门控同策略蒸馏迁移 RL 诱导的策略偏移
WAYPOINT-OPD:通过门控同策略蒸馏迁移 RL 诱导的策略偏移
Bingxi Hou Guochao Jiang Guofeng Quan Weiqing Li Wenfeng Feng Guohua Liu Yuewei Zhang
摘要
策略偏移蒸馏将教师模型在强化学习(RL)之前和之后的对数概率之差作为监督信号,用于学生生成的轨迹。然而,这种端点策略偏移无法揭示教师训练过程中局部动作偏好是否保持一致演化。相同的端点偏移可能来源于早期与晚期偏移的相互增强或部分抵消。我们研究了早期与晚期教师策略偏移之间的一致性是否能够指导选择性迁移。我们提出了路径点引导的同策略蒸馏(Waypoint-OPD),该方法利用同一次 RL 运行中的教师中间检查点,在学生访问的前缀上比较相对动作偏好的早期偏移和晚期偏移。我们根据早期与晚期偏移之间的方向一致性对端点偏移进行门控,当二者指向相反方向时抑制该端点偏移。与仅使用端点偏移的迁移相比,我们的方法只需额外进行一次冻结教师评分前向计算。在数学推理和代码推理任务上,我们使用经 RL 训练的 Qwen3-4B 教师模型,以 Qwen3-8B、Qwen3-14B 和 Qwen3-30B A3B 作为学生模型进行评估。在所有六种领域-学生设置中,Waypoint-OPD 在所比较的蒸馏方法中取得了最高的领域平均得分。使用 Qwen3-8B 学生模型进行的消融实验表明,移除或打乱门控会降低数学推理性能。这些结果支持利用早期与晚期教师策略偏移之间的方向一致性,在学生训练过程中对端点偏移进行加权。我们的代码可在 https://github.com/hhhbxloveai/WaypointOPD 获取。
一句话总结
阿里云计算的研究者提出航点引导的在线策略蒸馏(Waypoint-OPD),该方法利用一个中间教师检查点比较早期和晚期强化学习策略变化,在二者不一致时对端点监督进行门控,仅需一次额外的冻结教师模型打分,且在数学和代码推理任务上,在 Qwen3-8B、Qwen3-14B 和 Qwen3-30B A3B 学生模型中取得最高领域平均分数。
核心贡献
- 论文提出航点引导的在线策略蒸馏(Waypoint-OPD),该方法利用一个中间教师检查点,在学生生成的前缀处比较早期和晚期相对动作偏好的变化,并根据二者的方向一致性对中心化的初始到最终策略变化进行门控。
- 连续教师强化学习变化之间的方向一致性作为前缀级证据,用于选择性端点迁移,在早期和晚期变化方向相反时抑制更新,同时在蒸馏期间只需一次额外的冻结教师模型打分且不需要验证器调用。
- 使用经 RL 训练的 Qwen3-4B 教师和 Qwen3-8B、Qwen3-14B、Qwen3-30B A3B 学生在数学和代码推理上的实验表明,Waypoint-OPD 在所有六个领域-学生设置中均取得最高领域平均分,并且消融实验显示移除或打乱门控会降低数学推理性能。
引言
强化学习通过人类偏好奖励改进语言模型的指令遵循能力,并通过可验证奖励改进数学和代码推理能力,但将教师模型的强化学习收益复用到目标模型上成本仍然很高。先前在线策略蒸馏方法迁移教师绝对分布、教师到基线的变化,或 RL 前与 RL 后检查点之间的端点对数概率比。端点方法受限,因为相同的初始到最终变化可能混合指向一致或相反方向的早期和晚期策略变化,而仅依赖端点的信号无法区分这些情况。作者利用教师强化学习运行过程中的中间航点检查点来衡量初始到航点与航点到最终变化之间的一致性,然后利用该一致性在学生生成的前缀上对中心化的初始到最终信号进行门控。Waypoint-OPD 保留方向一致的 RL 引起的变化,抑制反转,并且仅需一次额外的冻结教师模型打分,无需在学生迁移期间训练新教师或调用验证器。
方法
作者提出 Waypoint-OPD,该方法通过引入同一教师强化学习运行过程中的航点检查点,增强直接在线策略蒸馏的端点信号。该框架并非将航点模型用作模仿目标,而是利用其提供一致性证据。早期和晚期策略变化之间的一致性被用于对学生访问的前缀上的端点信号进行加权。
如下图所示:
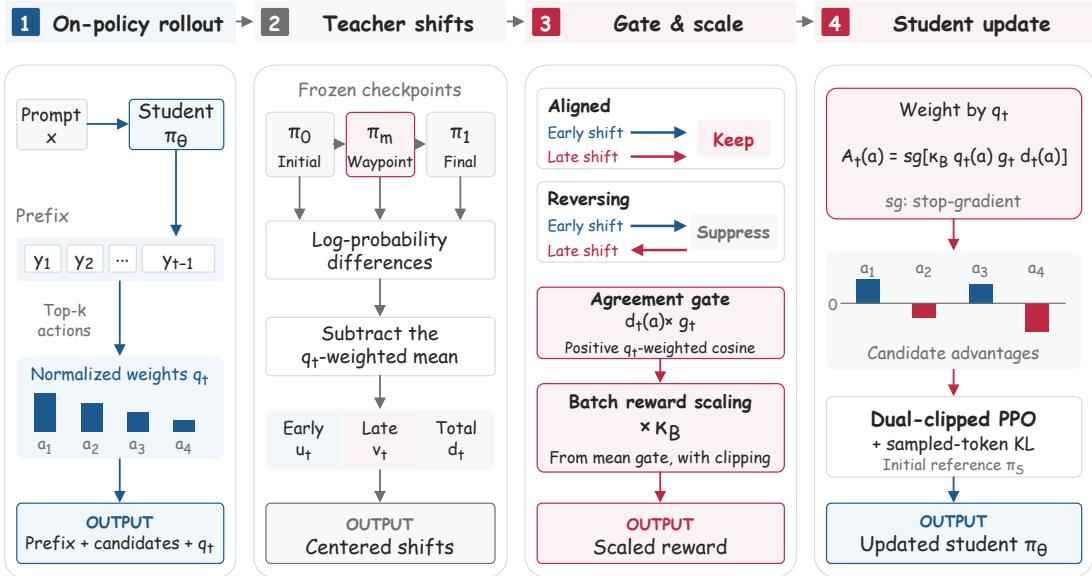
训练流程包括四个主要阶段:在线策略采样、教师变化计算、带批次缩放的一致性门控以及学生更新。
学生局部轨迹一致性
在学生访问的前缀 st 处,该方法选择学生概率最高的前 k 个 token 候选,并在该支持集上计算归一化学生分布 qt。这些权重将比较集中到可能的学生动作上。然后作者使用三个冻结教师检查点对这些候选进行评分:初始模型 π0、航点模型 πm 和最终模型 π1。两个连续教师变化计算如下:
δt(1)(a)=logπm(a∣st)−logπ0(a∣st) δt(2)(a)=logπ1(a∣st)−logπm(a∣st)这些变化可累加为总端点变化 δt=δt(1)+δt(2)。
为了消除可能影响原始变化向量之间角度的与动作无关的分量,使用归一化学生分布应用中心化算子。然后使用早期段 ut、晚期段 vt 和总端点 dt 的中心化变化来计算局部时序一致性。该一致性通过中心化早期和晚期变化向量之间的余弦相似度来衡量,并按学生概率加权:
ct=∥ut∥qt∥vt∥qt⟨ut,vt⟩qt一致性门控与批次尺度归一化
为了过滤端点信号,应用正余弦门控。如果中心化段的范数超过一个小的数值阈值 ε,门控值设为:
gt=max(0,ct)该机制在早期和晚期变化不一致时抑制端点信号,在一致时保留端点信号。如果任一段范数低于阈值,低范数回退会将门控设为一。
为了稳定不同批次之间的平均门控尺度,一个批次内所有经门控的奖励都会乘以共享缩放因子 κB:
κB=clip(max(∣Bpref∣−1∑t∈Bprefgt,εnum)τ,κmin,κmax)这种批次缩放保留了相对门控权重和零门控,同时防止奖励向量范数坍缩。
稠密候选目标
每个候选动作 a 的最终系数由批次缩放因子、归一化学生概率、一致性门控和中心化总端点变化组合得到:
At(a)=sg[κBqt(a)gtdt(a)]在求导过程中应用停止梯度算子 sg 以分离所有这些因子。
局部在线策略代理目标最大化候选动作的加权对数概率,同时使用 KL 散度惩罚将学生策略正则化至其自身的初始化:
JWP(θ)=Ex∼D[Ey∼πθ(⋅∣x)[t=1∑Ta∈Kt∑At(a)logπθ(a∣st)]−βDKL(πθ(⋅∣x)∥πS(⋅∣x))]在计算该代理目标的导数时,采样样本和候选支持集保持固定。实现采用双裁剪 PPO,其在采样策略处与代理目标共享相同梯度。相对于直接在线策略蒸馏,该方法仅增加一个冻结教师检查点和一次打分,不需要额外的可训练参数或学生采样。
实验
本工作评估了 Waypoint-OPD,该方法将来自冻结 Qwen3-4B 强化学习检查点在初始、航点和最终阶段的策略变化迁移到数学和代码基准上的 Qwen3-8B、Qwen3-14B 和 Qwen3-30B-A3B 学生模型,并使用在线策略蒸馏和端点迁移基线。Waypoint-OPD 在所有六个设置中均取得最高领域平均值,并在两个领域和所有学生规模上均优于 Direct-OPD,其中较大学生模型在数学和代码平均值上超过最终教师模型。学习轨迹结果显示训练期间相对于 Direct-OPD 的持续提升,并且在 Qwen3-8B 数学上的消融实验表明时序门控、正确的门控-前缀分配和均值归一化均对性能有贡献。
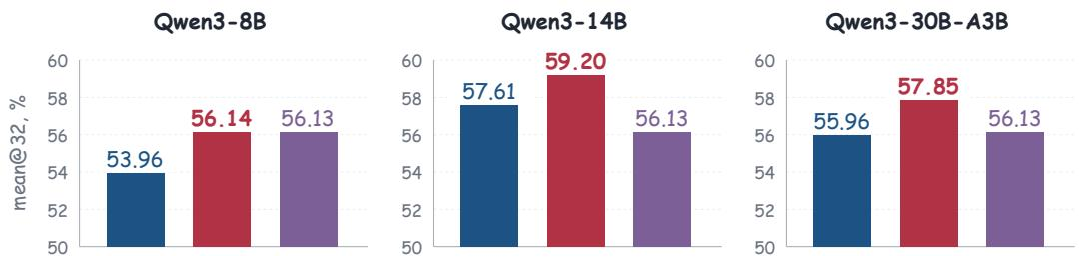
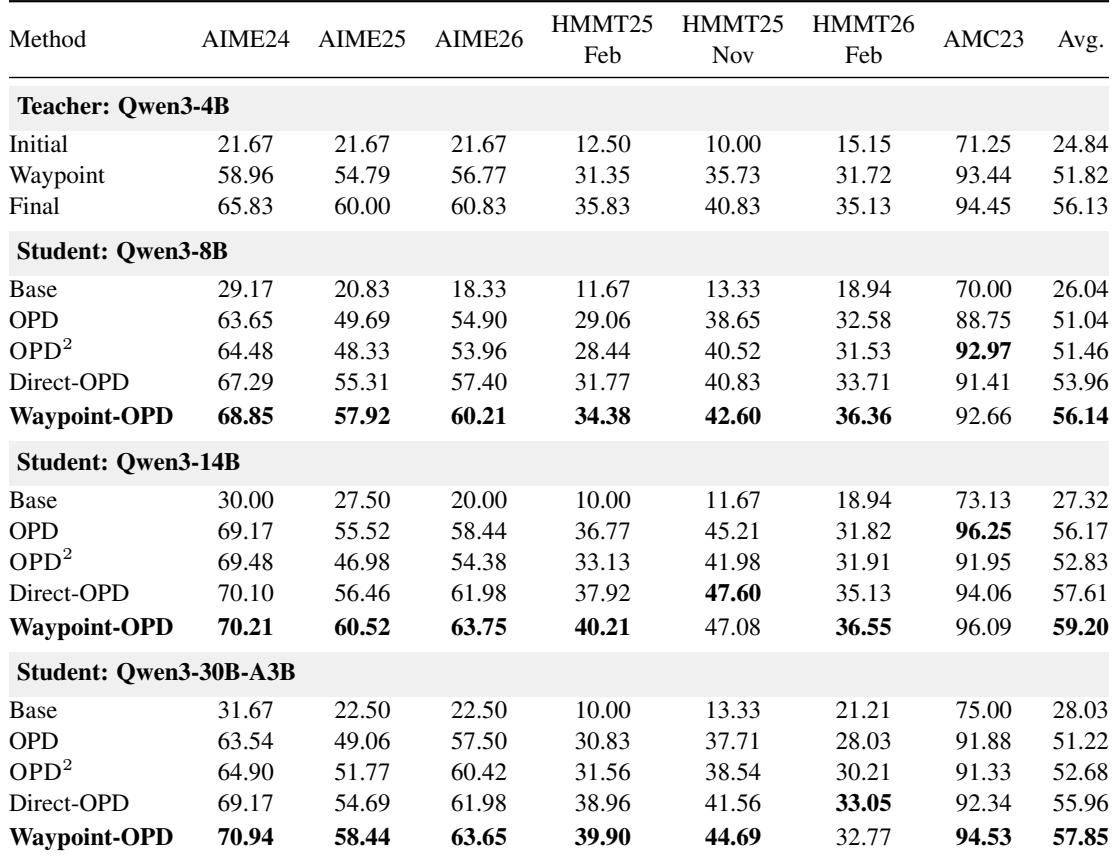
Waypoint-OPD 在数学和代码上、在所有三种学生规模下,在所评估的学生方法中均取得最高领域平均分。在数学上,它优于 Direct-OPD,14B 学生在全部七个基准上超过最终教师模型,30B-A3B 学生也超过教师平均水平,8B 学生基本持平。提升广泛且持续,在 21 项数学基准比较中有 19 项得到改善,并在 8B 学习轨迹中从第 60 步起保持优势。Waypoint-OPD 在涵盖数学和代码的全部六个设置中,在所评估的学生方法里取得最高领域平均分。在数学上,Waypoint-OPD 在三种学生规模上比 Direct-OPD 提高了约 1.6 到 2.2 个百分点。14B 和 30B-A3B 学生超过最终教师数学平均水平,8B 学生基本持平。Waypoint-OPD 在 21 项数学基准比较中有 19 项优于 Direct-OPD,并在 8B 学习轨迹中从第 60 步起保持提升。
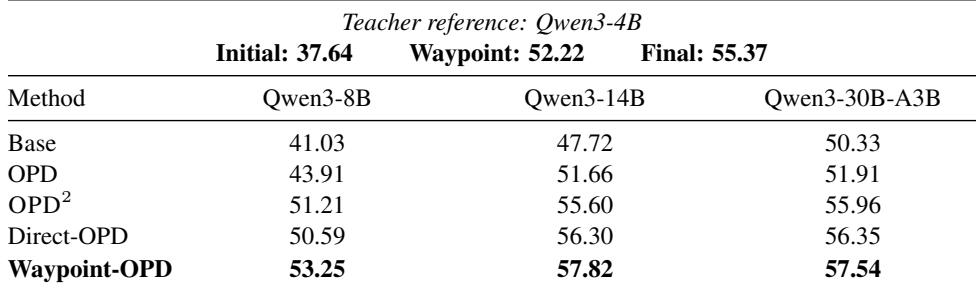
Waypoint-OPD 在全部三种学生规模下,在所评估的学生方法中取得最高平均代码推理性能。它在每一项代码比较中均优于 Direct-OPD,其中最小学生的平均提升最大,同时 14B 和 30B-A3B 学生超过最终教师检查点的平均水平。Waypoint-OPD 是三种学生规模下代码推理最强的学生方法。它在全部 15 项代码比较中均优于 Direct-OPD,且 14B 和 30B-A3B 学生超过最终教师平均代码分数。
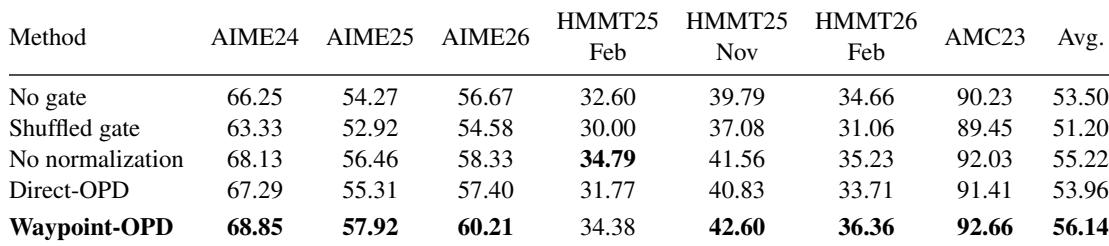
Qwen3-8B 数学推理上的消融实验表明,Waypoint-OPD 从一致性相关门控以及将每个门控与产生它的前缀正确匹配中获益最多。移除门控会降低全部七个基准上的准确率,而打乱门控分配甚至更有害。归一化提供了较小的额外平均收益并改善了大多数基准,不过未归一化变体在全部七个基准上仍优于 Direct-OPD。移除门控会降低平均准确率,并在全部七个基准上产生更低分数。打乱门控分配比移除门控更有害,且在每个基准上顺序相同。均值归一化带来的平均收益较小,改善了七个基准中的六个,HMMT February 2025 是例外。即使没有归一化,该方法在平均值和全部七个基准上仍优于 Direct-OPD。
Waypoint-OPD 在所有评估的学生规模上,在数学和代码推理任务中均一致优于 Direct-OPD,14B 和 30B-A3B 学生经常超过最终教师平均水平,8B 学生大致持平。这些提升覆盖多个基准并在训练期间持续。数学推理上的消融实验表明,一致性相关门控以及将每个门控与其原始前缀匹配是最重要的组成部分,而均值归一化提供了较小的额外收益,且没有它该方法依然有效。