Command Palette
Search for a command to run...
PLAYER-1:从合成经验中学习游戏操控
PLAYER-1:从合成经验中学习游戏操控
摘要
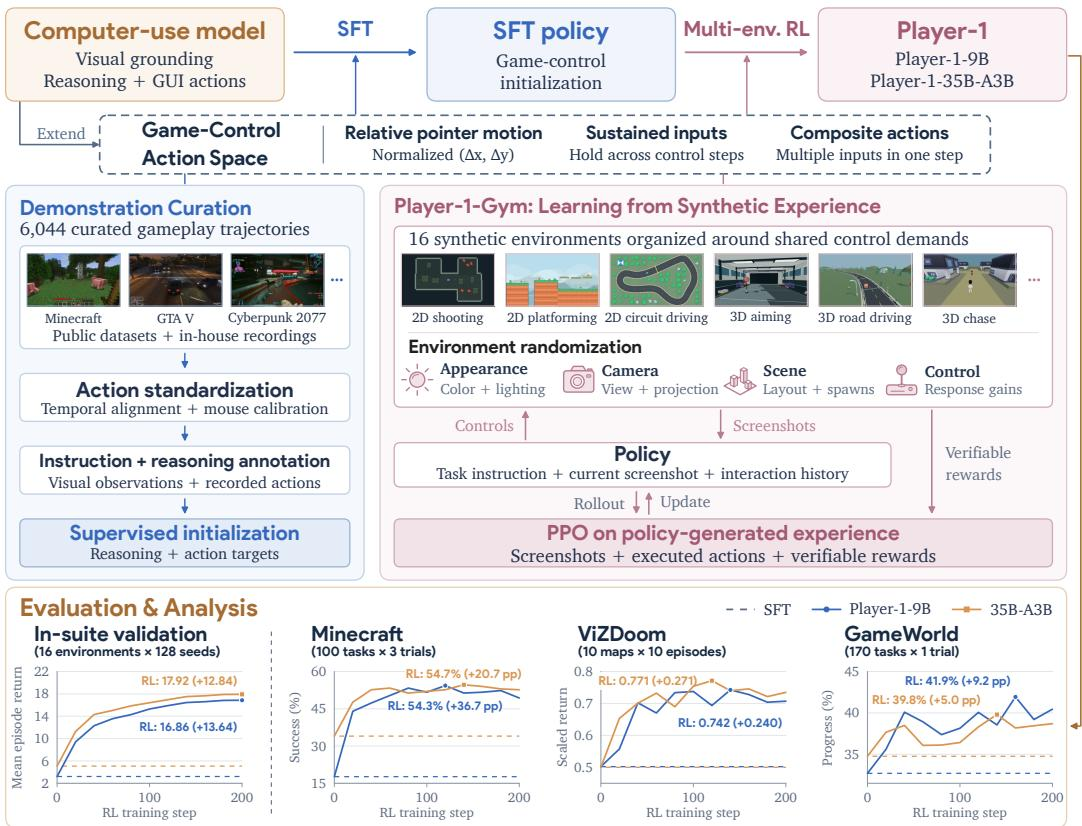
计算机使用智能体已在解读屏幕并执行键盘与鼠标操作方面展现出强大能力。然而,游戏因其视觉丰富的世界和多样的机制仍然具有挑战性,并成为迈向通用数字控制的重要且高要求的下一步。当前游戏智能体学习流程通常依赖大规模演示,而这些演示对动态游戏状态的覆盖有限;同时,可扩展的交互式训练环境仍难以获得。我们提出了 PLAYER-1,这是一个通过合成经验在演示之外学习游戏控制的后训练框架。我们通过相对指针移动、持续输入和复合动作扩展计算机使用动作空间。在监督初始化中,我们在 6,044 条精选游戏轨迹上微调计算机使用模型,这些轨迹将记录的动作与任务指令和视觉推理配对。我们构建了 PLAYER-1-GYM,包含 16 个围绕游戏间共有控制需求设计的合成 2D 和 3D 环境。可编程验证的奖励以及随机化的观测与控制动力学支持采用 PPO 的多环境强化学习。最终得到的 Player-1-9B 和 Player-1-35B-A3B 相比其 SFT 策略在 MineDojo-300 上的成功率分别提高 27.8 和 17.7 个百分点。Player-1-9B 达到 38.33% 的成功率,而最强评估基线为 12.63%;该模型还在 ViZDoom-10 和 GameWorld 上相对 SFT 取得进一步提升。进一步分析表明,更广泛的合成环境覆盖可改善迁移,而在 RL 过程中,组合多个键盘与鼠标输入的复合动作使用有所增加。我们证明,从合成经验中学习能够在监督初始化之外显著改善游戏控制,其收益可泛化到 RL 训练套件之外。
一句话总结
来自新加坡国立大学、ARC Lab、腾讯 IEG 和南洋理工大学的研究人员推出了 PLAYER-1,这是一个从合成经验中学习游戏控制的后训练框架,扩展了计算机使用动作空间,加入相对指针移动、持续输入和复合动作,在 6,044 条精选游戏轨迹上进行微调,并在十六个合成 PLAYER-1-GYM 环境中应用 PPO,将 MineDojo-300 成功率较 SFT 提高 27.8 个百分点,并泛化到 RL 训练套件之外。
核心贡献
- PLAYER-1 是一个后训练框架,扩展了计算机使用动作空间,加入相对指针移动、持续输入和复合动作,并在交互式学习之前使用 6,044 条精选游戏轨迹进行监督初始化。
- PLAYER-1-GYM 由十六个合成 2D 和 3D 环境组成,具有可编程验证的奖励,以及随机的观测和控制动态,支持使用 PPO 进行多环境强化学习。
- 生成的 Player-1-9B 和 Player-1-35B-A3B 将 MineDojo-300 成功率分别在 SFT 策略基础上提高 27.8 和 17.7 个百分点,其中 Player-1-9B 成功率为 38.33%,而最强评估基线为 12.63%,并在 RL 训练套件之外的 ViZDoom-10 和 GameWorld 上进一步取得提升。
引言
基础模型如今提供广泛的视觉理解和指令跟随能力,计算机使用 agent 将这些能力扩展到解释屏幕并控制键盘和鼠标动作。游戏是通用数字控制的一个高要求测试平台,因为在快速变化的视觉反馈下,需要精确、持续和并发的动作。先前的游戏 agent 主要从游戏演示和交互式经验中学习,但在开放式任务中演示只覆盖状态空间的有限部分,而用于交互式训练的可扩展环境仍然难以获得。为解决这一问题,作者提出 PLAYER-1,这是一个后训练框架,从精选演示开始,然后在 PLAYER-1-GYM 中从合成经验中学习。PLAYER-1-GYM 包含十六个 2D 和 3D 环境,围绕瞄准、移动和 UI 交互等共同控制需求构建。借助可验证奖励以及随机的观测和动态,该框架支持多环境强化学习,并产生超越监督初始化的模型,且能泛化到 RL 训练套件之外的游戏。
数据集
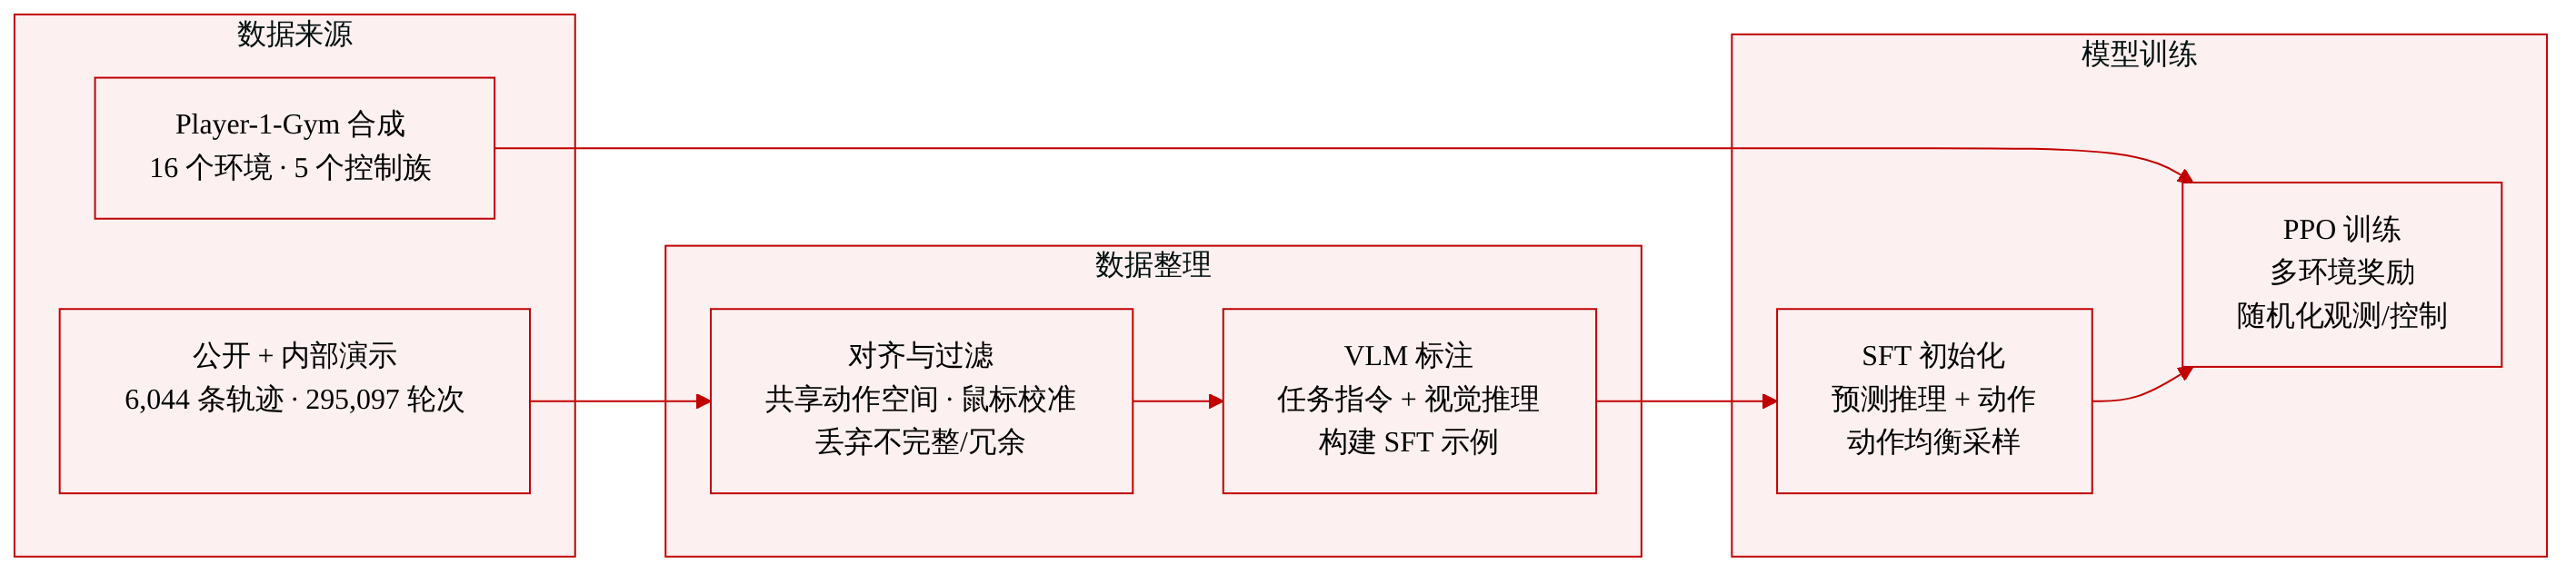
作者使用两个互补的数据组件进行游戏控制训练。
1. 精选游戏演示数据集
- 组成与规模: 6,044 条游戏轨迹,共 295,097 个交互轮次,收集自公开数据集和内部录制。
- 控制对齐与校准: 录制的控制被映射到共享的游戏控制动作空间。特定来源的鼠标校准以归一化的像素等效坐标表示相对输入。
- 过滤: 不完整或冗余的录制被过滤掉。
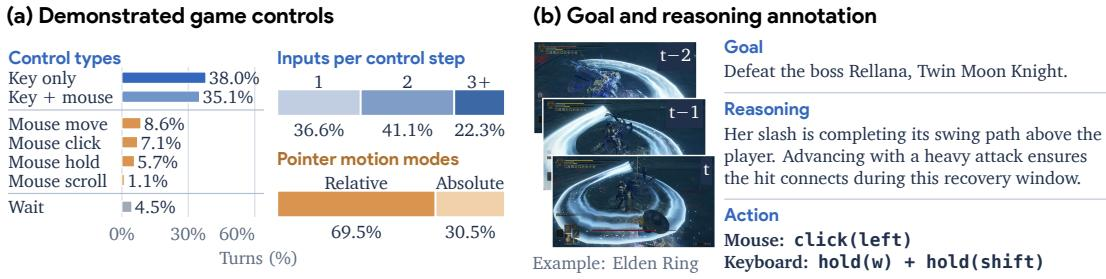
- 标注: 一个 VLM 为每个录制的动作标注任务指令和逐轮视觉推理。推理标注以任务指令、当前和过去的观测以及动作目标为条件。
- 示例格式: 每个监督微调示例被构造为 (q,It,CH(h<t),zt,at),其中 q 是任务指令,It 是当前截图,CH(h<t) 是保留历史,zt 是视觉推理,at 是动作。
- 训练中的使用: 该数据集通过监督微调初始化策略。策略学习根据任务指令、当前截图和保留历史预测 (zt,at)。作者使用 2+2 历史设置:最近两个视觉-动作轮次和两个更早的仅动作轮次,推理被省略。动作平衡采样增加了对较少出现的控制和复合动作的曝光。
2. Player-1-Gym 合成环境套件
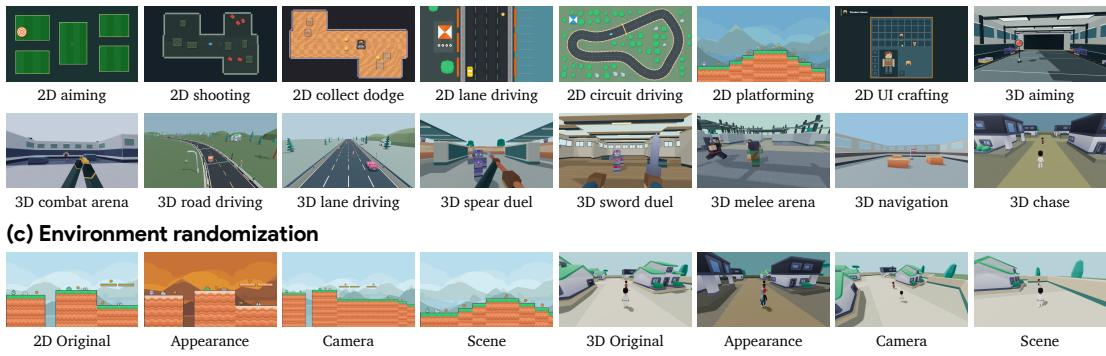
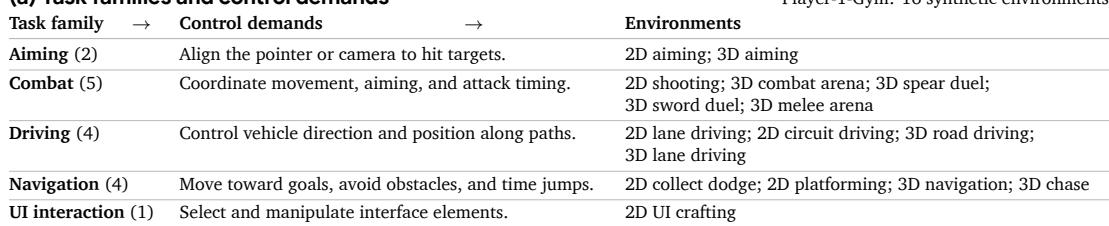
- 组成: 16 个合成环境,组织为五个控制需求家族:瞄准、战斗、驾驶、导航和 UI 交互。
- 构建: 环境由共享的 2D 和 3D 引擎、可复用资产和场景模板构建。统一运行时提供截图观测并执行共享的游戏控制动作空间。
- 奖励设计: 每个环境根据变化的游戏状态定义针对游戏和任务的评分规则。分数增量提供步级奖励,从而在没有学习型评判器的情况下给出密集、可验证的反馈。特权状态不会暴露给策略。
- 随机化: 训练经验在四个维度上被扩展:
- 外观:颜色、光照和资产
- 相机:投影、位置和初始朝向
- 场景:布局、生成点和任务特定配置
- 控制:相机旋转和移动的输入响应增益
- 训练中的使用: 合成环境支持对 SFT 初始化策略进行多环境 PPO 训练。
方法
作者提出 PLAYER-1,这是一个通过统一游戏控制动作空间将监督初始化与从合成经验中学习连接起来的框架。该方法首先扩展标准计算机使用动作以支持动态游戏控制,引入相对指针移动、持续输入和复合动作。这使得策略能够处理复杂交互,例如并发瞄准和射击或持续移动。
为初始化策略,作者利用精选游戏演示集合上的监督微调。他们处理来自公开数据集和内部录制的轨迹,将控制映射到共享动作空间。然后使用视觉语言模型为这些录制标注任务指令和逐轮视觉推理。训练示例使用任务指令、当前截图和过去轮次的保留历史构造,训练策略预测视觉推理和对应动作。采用动作平衡采样,以确保对较少出现的控制有足够曝光。
如下图所示:
初始化之后,策略在 PLAYER-1-GYM 中进行优化,这是一套围绕共享控制需求设计的合成环境。作者构建了十六个 2D 和 3D 环境,涵盖五个任务家族:瞄准、战斗、驾驶、导航和 UI 交互。每个环境提供基于游戏状态评分规则的可编程验证奖励,在没有学习型评判器的情况下提供密集反馈。为扩展训练经验,环境在外观、相机、场景布局和控制动态方面进行了广泛随机化。
合成环境和随机化示例如下图所示:
作者在这些随机化环境上使用 Proximal Policy Optimization 联合优化初始化后的策略。为减轻不同环境中奖励尺度差异对策略更新的影响,他们对广义优势估计应用了按环境的优势归一化。环境 e 中第 i 轮、第 j 个 token 的归一化优势 Ai,j 计算如下:
Ai,j=σe2+ϵAi,j−μe其中 μe 和 σe2 是环境 e 的 rollout 批次中优势的均值和样本方差。使用 return-to-go 目标来累积后续轮次的奖励,使后续结果能够指导更早的控制决策。
实验
实验评估了从 Qwen3.5 骨干初始化、经过监督微调后在十六个 PLAYER-1-GYM 环境上进行强化学习的 Player-1 模型,使用了领域内任务以及 MineDojo、ViZDoom 和 GameWorld 等外部基准。结果表明,在合成经验上进行强化学习较监督微调显著改善了任务导向控制和泛化能力,学习到的能力可迁移到未见过的游戏和交互设置。分析表明,监督初始化对有效强化学习很重要,不同环境之间的学习动态存在差异,并且模型在训练过程中自然发展出更协调的复合动作。
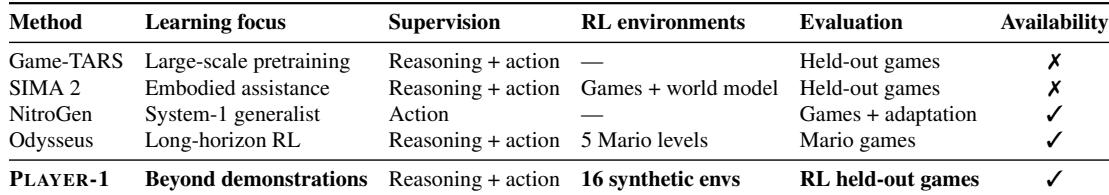
比较显示,代表性游戏 agent 流程在 RL 环境支持、评估范围和可用性方面存在差异。一些早期方法缺乏专门的 RL 环境,或在较窄的游戏设置上进行评估,而 PLAYER-1 将推理和动作监督与合成 RL 环境和留出游戏评估相结合。PLAYER-1 是可用流程中专注于在演示之外学习的流程之一。PLAYER-1 是唯一将推理和动作监督与留出游戏评估相结合且可用的被比较流程。相对于其他可用流程,PLAYER-1 在留出游戏上进行评估并使用合成 RL 环境,而可比较方法要么缺乏 RL 环境,要么仅在一组狭窄的 Mario 游戏上评估。
训练套件涵盖五个任务家族:瞄准、战斗、驾驶、导航和 UI 交互,控制需求从专注的指针对齐或界面操作,到协调移动、瞄准和攻击时机。在这些合成经验上训练的策略迁移到未见过的商业游戏,并在强化学习过程中得到改善,复合动作变得更加频繁。战斗是环境套件中表示最多的任务家族,而 UI 交互表示最少。控制需求范围从对齐指针或相机并选择界面元素,到协调移动、瞄准和攻击时机。
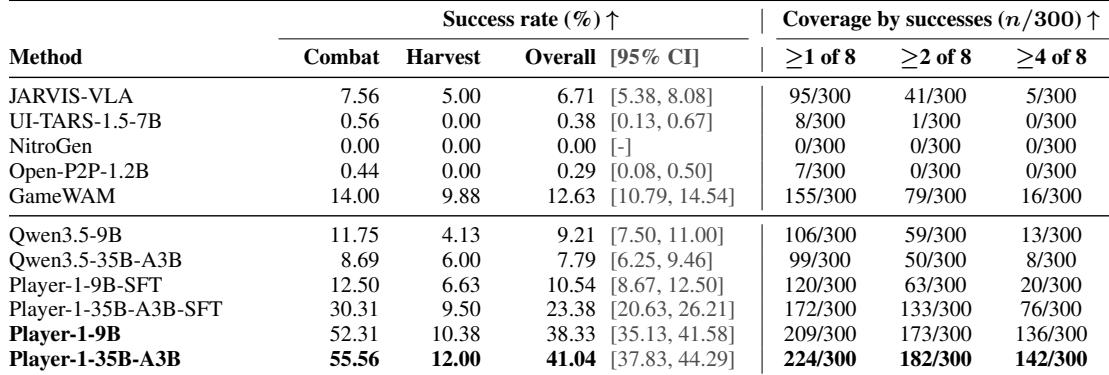
在 MineDojo-300 基准上,GameWAM 实现了最高的战斗和采集成功率,并在所有成功阈值下具有最广的任务覆盖。Qwen3.5-9B 总体排名第二,优于 JARVIS-VLA,而其余方法显示出非常有限的覆盖或没有成功试验。GameWAM 在整体成功率和至少有 1、2 或 4 次成功试验的任务数量上领先所有被评估方法。Qwen3.5-9B 是最强的次名,在整体成功率和覆盖范围上超过 JARVIS-VLA 以及所有其他基线。大多数基线很少或从未达到成功阈值,NitroGen 的成功试验为零,UI-TARS-1.5-7B 和 Open-P2P-1.2B 仅达到少量任务。
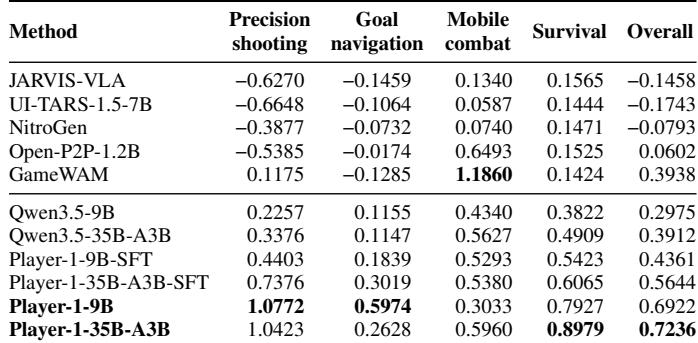
在第一人称 ViZDoom-10 任务上,GameWAM 和 Qwen3.5-35B-A3B 在总体平均缩放回报上以较大优势领先其余 agent,其中 GameWAM 略领先,Qwen3.5-9B 位居第三。基于 Qwen3.5 的模型在精准射击和生存方面最强,并且是唯一在目标导航回报上为正的被比较方法。GameWAM 在移动战斗上占主导,而大多数其他 agent 的总体得分接近零或为负。GameWAM 和 Qwen3.5-35B-A3B 占据总体前两名,Qwen3.5-35B-A3B 还在精准射击和生存上领先。GameWAM 在移动战斗上大幅领先,在该任务上远超次优 agent。
在跨 170 个任务和 34 个游戏的浏览器游戏控制中,Qwen3.5-35B-A3B 实现了最高的成功率和进度,其次是 Qwen3.5-9B 和 NitroGen。大多数被评估方法仅达到适中的成功率,而进度分数一致更高,表明任务被部分完成。较大的 Qwen 模型在两个报告指标上都优于较小的 Qwen 模型。Qwen3.5-35B-A3B 在成功率和进度上均领先所有方法。Qwen3.5-9B 在两个指标上排名第二,领先于 NitroGen 和其他基线。Open-P2P-1.2B 在报告的方法中成功率和进度最低。每种方法的进度分数都超过成功率,表明任务通常被部分完成,而不是完全解决。
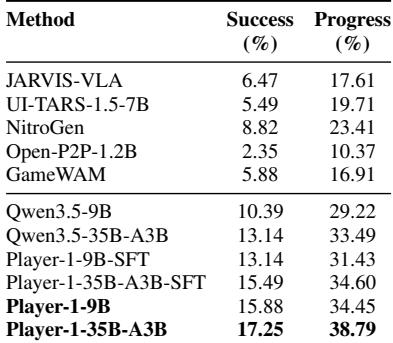
实验评估了代表性游戏 agent 流程以及涵盖瞄准、战斗、驾驶、导航和 UI 交互的训练套件。PLAYER-1 的独特之处在于,它是唯一将推理和动作监督与留出游戏评估相结合且可用的流程,而在合成 RL 环境上训练的策略可迁移到未见过的商业游戏。在 MineDojo-300 和 ViZDoom-10 上,GameWAM 和 Qwen3.5 模型在任务覆盖和回报上领先,而在浏览器游戏控制中 Qwen3.5-35B-A3B 实现最高的成功率和进度,大多数其他方法表现为有限或部分任务完成。