Command Palette
Search for a command to run...
通过批评引导的同策略蒸馏恢复可靠监督
通过批评引导的同策略蒸馏恢复可靠监督
Kaixiang Zhao Tianrun Yu Shangzhe Li Yuxiao Yang Amanda Hughes Weitong Zhang Taylor W. Killian
摘要
同策略蒸馏(OPD)在学生模型自身生成的 rollout 上,利用来自教师模型的 token 级监督训练学生模型,其假设是教师能够从学生写出的任意前缀出发得到正确答案。我们将这一性质称为教师的可恢复性,并表明它在错误 rollout 上失效:教师会跟随学生错误,尽管教师能识别这些错误。我们提出 CriticOPD,利用错误识别来恢复可恢复性。教师对错误 rollout 进行批评,使学生能够从错误处开始重写其解答。由此得到的输出(其中批评作为特权信息)由教师评分,而学生则使用不含批评的修订版本进行训练。在两个 Qwen3 学生模型和六个数学推理基准上,CriticOPD 改善了 OPD,其中在竞赛题上的提升最大。代码见 github.com/kzhao5/CriticOPD。
一句话总结
杨百翰大学和北卡罗来纳大学教堂山分校的研究人员提出 CriticOPD,一种以批评为指导的在线策略蒸馏方法,通过让教师识别错误、让学生重写解答,并在评分改写时使用批评作为特权信息,而学生在训练时看不到该批评,从而恢复教师可恢复性;CriticOPD 在两个 Qwen3 学生模型和六个数学推理基准上改进了在线策略蒸馏,其中在竞赛题上提升最大。
核心贡献
- 本文在在线策略蒸馏中引入教师可恢复性,并通过实验表明,在学生错误的轨迹上可恢复性会急剧下降,使得许多训练 token 的监督来自教师很少能正确恢复的前缀。
- 本文提出 CriticOPD,其中教师对错误轨迹进行批评,学生使用该反馈从最后一个错误处重写,并且批评仅作为评分时的特权上下文,而不是学生训练信号的一部分。
- 在两个 Qwen3 学生模型和六个数学推理基准上的实验表明,CriticOPD 改进了在线策略蒸馏,在竞赛题上提升最大,且代码已公开。
引言
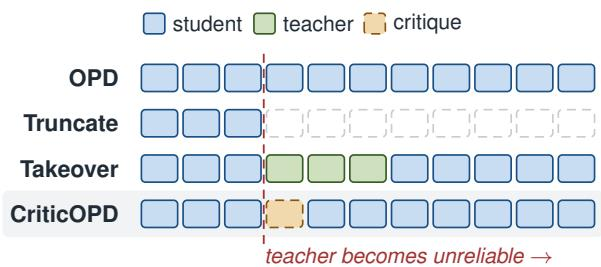
在线策略蒸馏(OPD)在 token 级别教师监督下,用学生自身的生成轨迹训练学生,从而减少当推理前缀与训练前缀不同时对离线蒸馏造成损害的占用分布不匹配。然而,当学生犯错后,教师监督变得不可靠,因为教师往往会跟随学生的错误而不是纠正错误,而先前的补救方法要么截断监督,要么让教师接管生成,这又重新引入了占用分布不匹配。作者提出 Critic-OPD,其中教师对错误轨迹进行批评,学生从最后一个错误处重写,而批评仅作为训练期间评分的特权上下文使用。这提高了修订轨迹上的教师可恢复性,使每个被监督的 token 都由学生生成,并且在推理时不需要任何反馈。
方法
作者提出 CriticOPD 来解决教师模型在学生犯错后无法正确继续的问题,尽管教师仍然能够识别这些错误。该方法根据学生在推理过程中到达的状态构造训练序列,在最小化占用分布不匹配的同时确保可靠的教师监督。该过程包括一个批评与重写机制,随后是特定的训练目标。
该过程从学生使用训练提示为给定问题 x 生成轨迹 y 开始。如果该轨迹不正确,或达到长度上限而没有给出答案,则将其送去批评和重写。正确的轨迹使用标准在线策略蒸馏(OPD)进行训练。
教师充当批评者。它接收问题、参考答案和学生以编号段落格式给出的解答。教师识别解答中的错误,列出每个错误的段落索引、错误句子和简短修正。这些错误与参考答案结合,形成批评 c。纳入参考答案使教师能够批评它自己无法解决的问题。如果批评中未发现完整错误,则用标准 OPD 训练该轨迹。
为了确定切分点,学生保留前缀直到批评中识别出的最后一个错误所在的段落,并丢弃其余部分。被丢弃的部分从位置 τ 开始,因此保留的前缀为 hτ=(x,y<τ)。这个前缀包含批评中的所有错误,确保重写从教师可恢复性通常下降的错误状态开始。
然后,学生使用反馈提示将批评 c 附加到保留前缀,并生成新的后缀,得到修订轨迹 y~。τ 之前的 token 保持不变(y~<τ=y<τ),学生在上下文中包含批评的情况下采样后缀。与教师接管不同,训练序列中的每个 token 都由学生生成。
如下图所示:
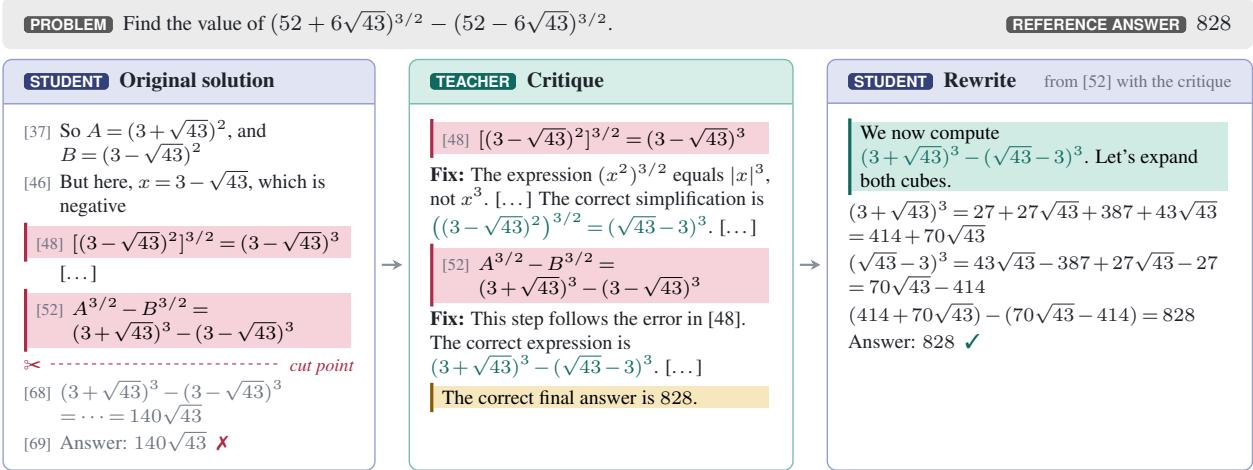
批评识别原始解答中的错误,学生从最后一个错误处重写,以得到正确答案。作者还评估了教师在这些重写轨迹上相对于原始轨迹的可恢复性。可恢复性估计为从每个前缀出发的八次续写中正确答案的比例。
如下图所示:
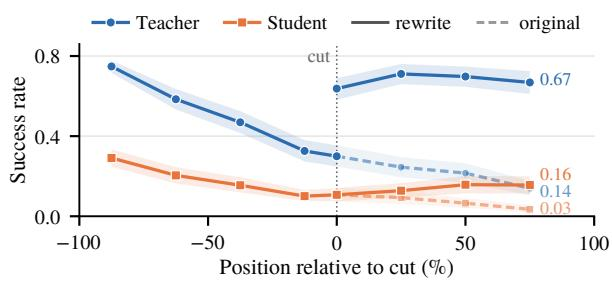
该图说明教师在重写轨迹上比在原始轨迹上可靠得多。在续写进行到 75% 处时,教师在原始轨迹上的可恢复性为 0.14,在重写轨迹上为 0.67。类似地,学生在没有批评时的成功率从 0.03 上升到 0.16。
训练目标将针对正确轨迹的标准 OPD 与针对具有有效批评的轨迹的反馈蒸馏相结合。
对于正确轨迹和没有有效批评的轨迹,作者在每个学生生成的前缀 ht 处最小化反向 KL 散度:
LOPD(y)=t=1∑∣y∣KL(πθ(⋅∣ht)∥πT(⋅∣ht))这里使用采样 token 优势。
对于具有有效批评的轨迹,训练集中在修订序列 y~ 上。设 h~t=(x,y~<t) 表示其不含批评的前缀。教师在上下文中包含批评 c 的情况下对重写进行评分,而学生看不到该批评。反馈蒸馏损失定义为:
Lfb(y~;c)=t=τ∑∣y~∣KL(πθ(⋅∣h~t)∥πT(⋅∣h~t,c))只有重写的后缀受到监督,因为保留前缀包含错误,这些错误所在状态的教师可恢复性较低。每个后缀 token 接收采样 token 优势:
Atfb=logπT(y~t∣h~t,c)−logπθ(y~t∣h~t)由于后缀是在包含批评的情况下采样的,而学生的对数概率是在没有批评的情况下计算的,因此该更新是一种代理更新,而不是无偏梯度。
整体目标最小化 Lours=LOPD+Lfb,其中每个损失对批次中各自的轨迹求和。与标准 OPD 相比,教师目标从 πT(⋅∣ht) 变为 πT(⋅∣h~t,c),在该目标下教师可恢复性高得多。学生在没有批评的情况下学习,并且在推理时不需要任何反馈。
实验
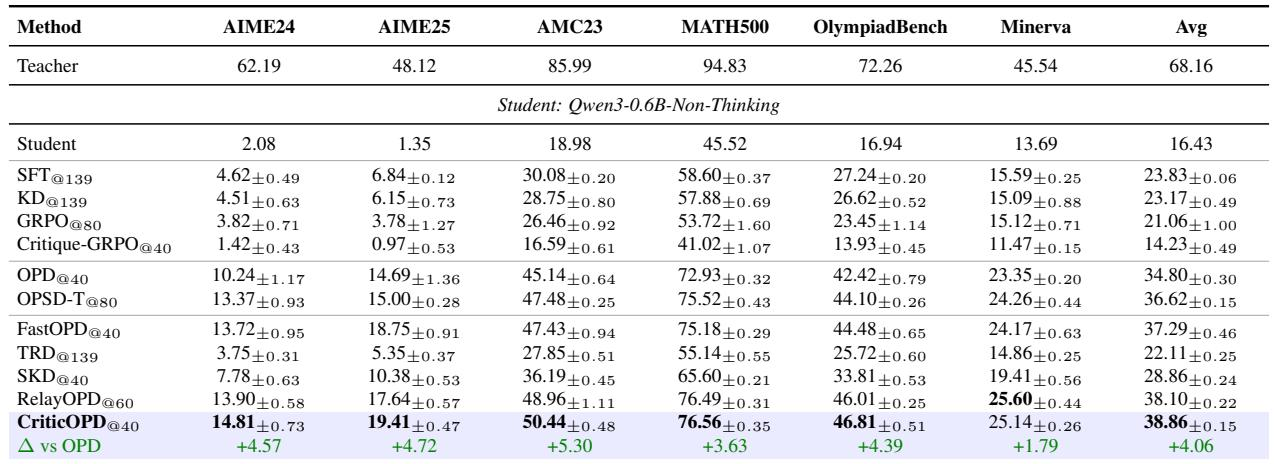
该研究评估了以批评为指导的在线策略蒸馏,使用在 DAPO-Math-17k 上从 Qwen3-4B 教师蒸馏得到的 Qwen3-1.7B 和 Qwen3-0.6B 学生模型,并在 AIME、AMC、MATH500、OlympiadBench 和 Minerva Math 上进行评估,同时进行消融和可靠性分析。学生犯错后教师的续写准确率下降,因为教师倾向于跟随错误前缀,但其标记有效错误的能力保持稳定。CriticOPD 相比 OPD 和相关基线取得改进,其中批评是最重要的组件,并且它帮助教师为纠正分配 token 级别的信用;增益集中在错误后状态,学生在这些状态上学会从自己的错误中恢复,而数学之外的表现基本保持不变。
CriticOPD 在两个测试的 Qwen3 规模上均提高了相对 OPD 基线的平均数学推理准确率,其中在 AIME 和 AMC 等竞赛式基准上提升最大。它优于 FastOPD 和 RelayOPD,并且在两个规模的大多数数学基准上是最佳学生方法。消融表明,仅使用答案或通用反馈效果较差,移除批评会导致最大的性能下降。CriticOPD 在两个测试规模的大多数数学基准上取得了最佳学生准确率,并在两个规模上均优于 OPD。最大提升出现在 AIME 2024、AIME 2025 和 AMC 2023,表明在竞赛式推理上有更强的改进。反馈消融表明批评至关重要;移除它会导致准确率大幅下降,而仅使用答案指导则低于 OPD 基线。
消融分离了反馈和训练设置的主要组件。批评是最重要的反馈元素,而移除参考答案或使用通用反馈会导致较小的平均下降。反馈对后缀评分的影响也大于对由哪个模型编写后缀的影响,表明批评既改善了重写后缀,也改善了教师评分的可靠性。在反馈变化中,移除批评造成最大的平均下降。移除参考答案或将反馈替换为通用文本导致的平均下降小于移除批评。使用教师编写的后缀而不是学生编写的后缀,其影响小于在没有反馈的情况下对后缀评分。在没有反馈的情况下对后缀评分会导致更大的平均下降,表明批评支持可靠的教师评分。
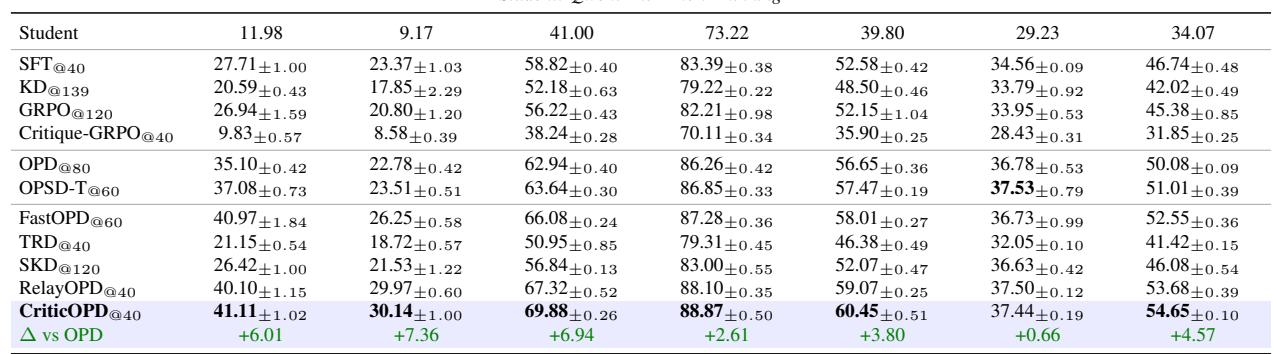
CriticOPD 在两个测试的 Qwen3 规模上均提高了相对 OPD 基线的数学推理准确率,其中在 AIME 和 AMC 等竞赛式基准上提升最大,并且作为大多数数学基准上的最佳学生方法优于 FastOPD 和 RelayOPD。消融表明,批评是最重要的反馈组件,因为移除它会导致最大的性能下降,而仅使用答案或通用反馈以及教师编写的后缀影响较小。反馈对后缀评分的影响也大于对由哪个模型编写后缀的影响,表明批评既改善了重写后缀的质量,也改善了教师评分的可靠性。