Command Palette
Search for a command to run...
Any Time, Any Space:一种以世界状态为中心的智能体视频生成框架
Any Time, Any Space:一种以世界状态为中心的智能体视频生成框架
Weijie Wang Haomin Zhang Ye Li Akide Liu Zeyu Zhang Haoyu Zhao Yefei He Donny Y. Chen Feng Chen Bohan Zhuang
摘要
长时程智能体视频生成必须将剧本转化为在非连续请求之间保持空间与时间一致性的镜头。在镜头之间传递提示词或最近帧,无法为重新回到某一场景提供共享的空间参照系,也无法为回放先前事件提供带时间索引的记录。我们提出 Any Time, Any Space(ATAS),它将剧本编译为带有明确地点、摄像机和事件时间引用的镜头请求。生成前,它从场景记忆和事件记忆中检索相关证据:前者保存已配准的静态几何,后者保存按场景、事件与时间索引的动态观测。生成后,ATAS 对片段进行重建与配准。仅当审查与状态检查接受该观测时,它才更新记忆;影片交付仍独立于记忆准入。在四个视频生成器上,ATAS 改善了所有报告的跨镜头一致性指标,并在每个骨干模型上取得了最高的综合基准分数。它还在目标图像空间重访上优于所比较的智能体和三维引导方法,在三个事件重捕获指标上领先,并在全部六项人工评分中得分最高。
一句话总结
来自浙江大学、蒙纳士大学、BAIR、加州大学伯克利分校和阿德莱德大学的研究人员提出了 Any Time, Any Space (ATAS),一种以世界状态为中心的 Agentic 视频生成框架,该框架将剧本编译为带有明确位置、相机和事件时间引用的镜头请求,检索相关场景与事件记忆,并对片段进行配准,以提升跨镜头一致性,在四个视频生成器主干上取得最高的综合基准分数。
核心贡献
- Any Time, Any Space (ATAS) 是一种以世界状态为中心的框架,将剧本编译为带有明确位置、相机和事件时间引用的镜头请求,使后续镜头能够从先前观察中查询证据。
- ATAS 将互补的空间配准场景记忆和时间索引事件记忆,与由验证控制的更新机制相结合,将影片采纳与新证据进入持久状态分开。
- 在四个视频生成器和五个 Agent 基线上的实验表明,ATAS 改善了所有报告的跨镜头一致性指标,并在每个主干上取得最高综合分数;在全部三个空间重返指标上也优于所评估的 Agent 与 3D 引导方法,在五个事件重现标准中的三个上领先,并在全部六个标准上获得最高平均人类评分。
引言
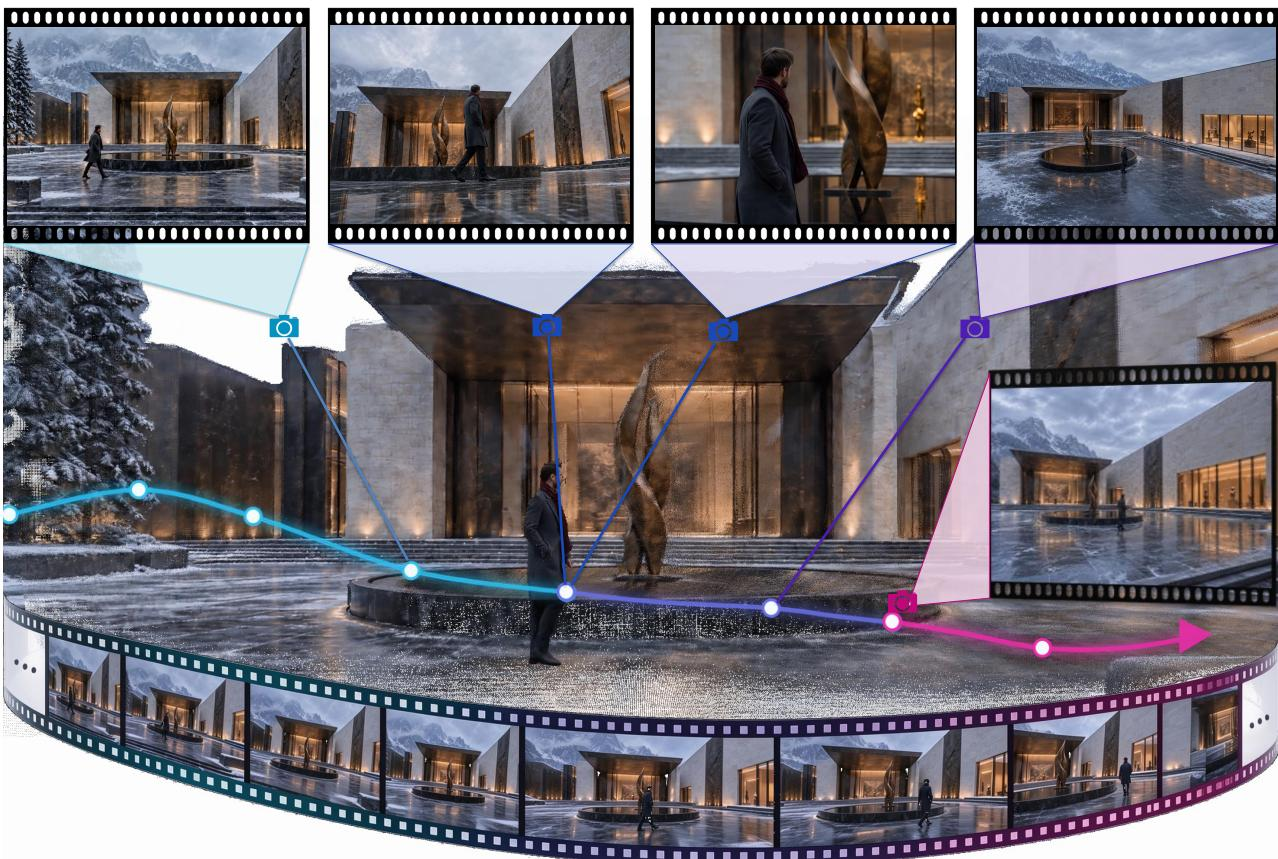
Agentic 视频生成将剧本转化为一系列视频镜头,但故事连贯性取决于在非连续镜头之间保留空间与时间关系,例如回到之前的房间或从新相机视角重放过去事件。先前系统通常通过近期帧、文本摘要或检索到的参考图像来维持连续性,这对局部连续镜头有帮助,但没有提供跨空间和时间的共享、可寻址世界状态,并且可能传播来自不可靠生成内容的错误。作者引入 Any Time, Any Space (ATAS),一种以世界状态为中心的框架,维护持久场景记忆和事件记忆:场景状态用于共享坐标框架中的空间结构,事件状态用于具有时间上下文的动态观察。ATAS 将每个剧本请求编译为有依据的镜头规格,检索相关证据,条件化一个短视频生成器,并在每个生成片段被允许更新持久世界状态之前对其进行验证。
方法
ATAS 框架通过维护一个持久世界状态来保存跨生成过程的空间与时间证据,从而将高层次剧本转化为连贯的短视频镜头。该方法的核心是编译、生成、验证和状态更新的持续循环。整体工作流如下所示。
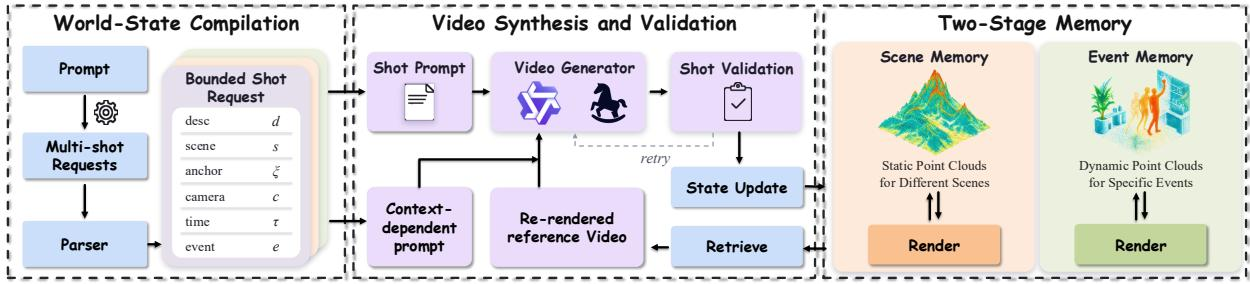
流程从世界状态编译开始。系统不是处理一系列完全指定的视频提示,而是接收高层次剧本 u,并按照场景、空间与时间关系、事件引用和相机需求递归拆分。这会产生一个有界镜头请求调度 Qt={qt,1,…,qt,Kt}。每个可渲染请求的结构为 qt,k=(dt,k,st,k,ξt,k,ct,k,τt,k,et,k),该元组封装了局部镜头描述、场景标识符、空间锚点、目标相机、请求时间区间以及可选的事件标识符。
为了对视频生成进行条件化,作者采用了一种两阶段记忆架构,维护持久世界状态 Wt=(St,Et)。场景记忆 St 存储由源观察建立的坐标框架内已接受的静态几何。当请求需要空间上下文时,系统在请求的空间锚点和相机处渲染这些坐标,生成重新渲染的场景参考 Ctscene。同时,事件记忆 Et 将动态证据保留为一组记录,包含场景、事件、源观察、时间区间,以及帧级 RGB-D、掩码和动态点云数据。如果请求引用了特定事件,系统直接从该记忆中检索匹配的动态上下文 Ctevent。
在视频合成与验证阶段,请求中的局部描述构成镜头提示,而检索到的场景和事件参考构成依赖上下文的提示 Ct=(Ctscene,Ctevent)。短视频生成器 G 利用这两个提示合成片段 Vt=G(qt,Ct)。生成后,片段经过严格的验证过程,产生两个独立决策。影片审查决定该片段是否被接受交付(ft=1)。如果被接受,重建和配准将生成片段对齐到场景坐标框架,产生配准决策(rt=1)。
最后,系统执行状态更新。候选观察只有在通过影片审查、配准以及验证来源和场景范围的额外准入检查(at=1)后,才被纳入持久状态。状态转移由以下规则控制:
Wt+1={Wt+1,Wt,ft=rt=at=1,otherwise.该设计确保影片交付与状态更新解耦。生成的片段即使未能更新持久世界状态,也可以保留在最终影片中,从而防止无效观察破坏后续镜头所需的空间与时间证据。
实验
论文在 VBench、ST-Bench 和 ViStory 上评估长视频生成,并补充了空间重返、事件重现、人类评分和效率指标。结果表明,ATAS 在多个生成器上改善了跨镜头一致性,同时保持有竞争力的局部质量;与比较的多镜头和 3D 引导方法相比,它能更好地恢复目标视图和基于源的事件重放,人类评分者也更偏好其输出。消融实验表明,场景记忆和事件记忆带来互补的连续性收益,递归编译放大这些收益,而持久记忆以减少重试和影片审查拒绝为代价,带来可测量的运行时间和吞吐量成本。
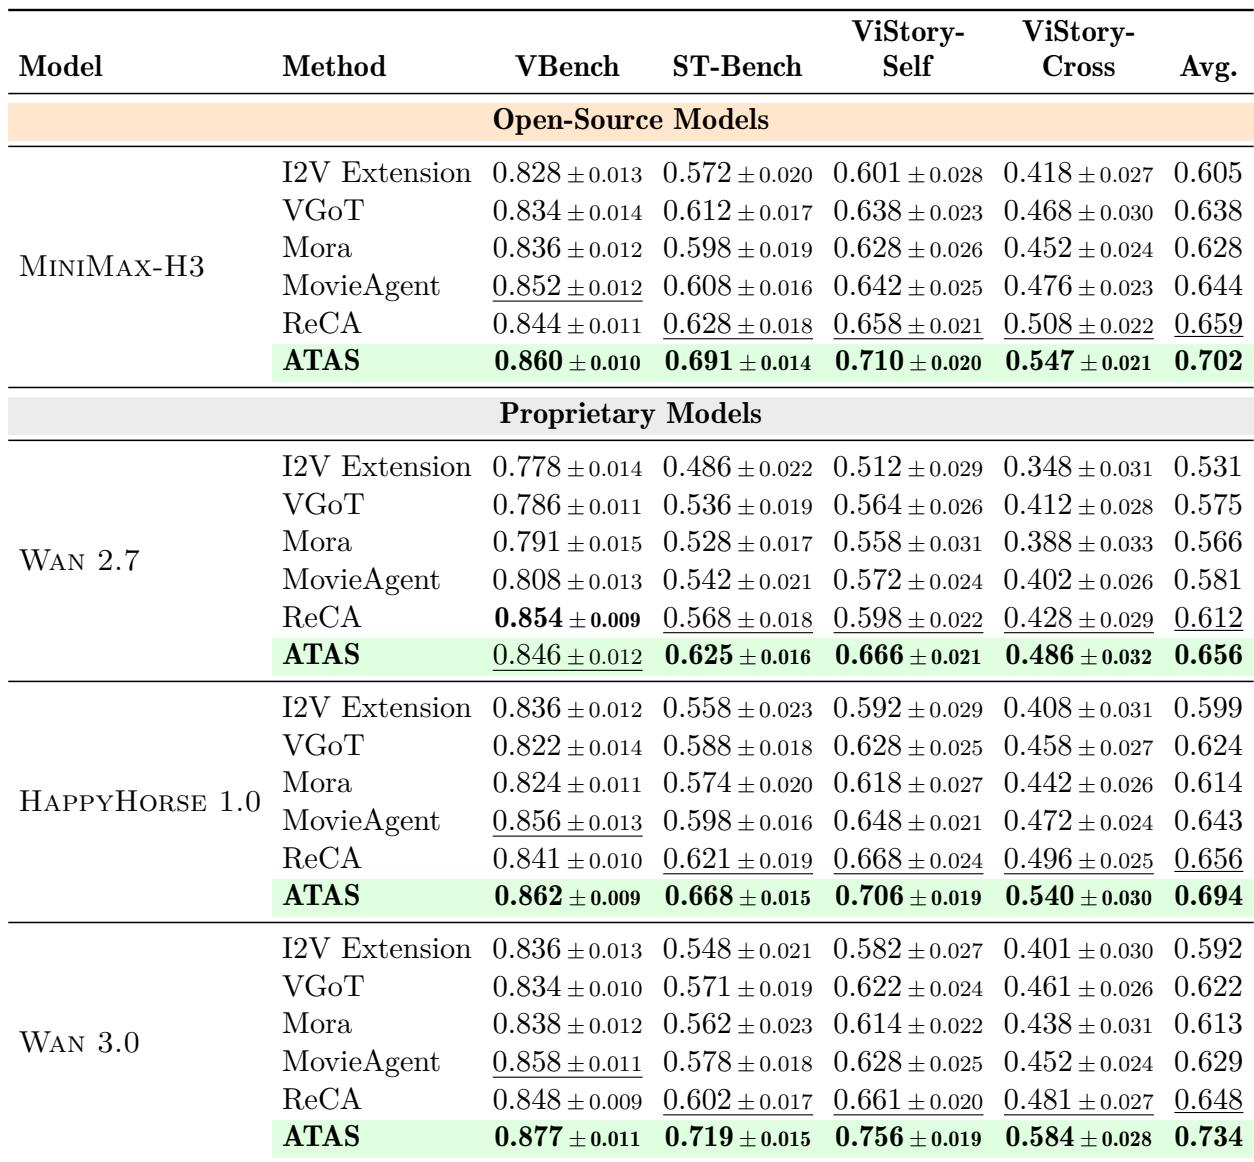
ATAS 在多镜头方法比较中持续改善 Agent 级基准性能,在 MiniMax-H3、Wan 3.0 和 HappyHorse 1.0 上的所有报告综合分数均领先。在 MiniMax-H3 组内,它在所有单项指标和平均值上均排名第一。跨主干模型的模式表明,收益来自持久多镜头状态,而非单一渲染器。ATAS 在 MiniMax-H3、Wan 3.0 和 HappyHorse 1.0 上的所有报告综合分数均领先。在 MiniMax-H3 组中,ATAS 在 VBench、ST-Bench、ViStory-Self、ViStory-Cross 和平均值上排名第一,ReCA 通常是一致性指标上最接近的竞争者。在 Wan 2.7 上,尽管在 VBench 上落后,ATAS 在 ST-Bench 和两个 ViStory 一致性得分上仍保持领先。
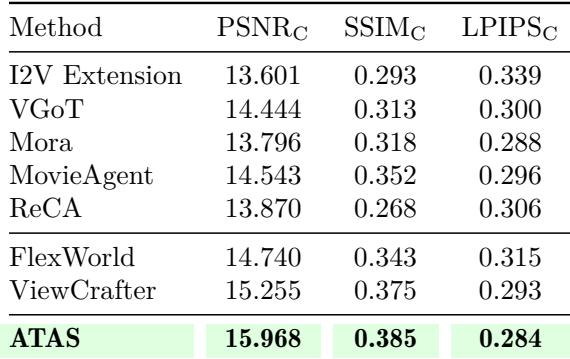
在空间重返基准上,ATAS 在公共可见性掩码下对目标视图恢复的表现优于比较的基于 Agent 的方法和 3D 引导方法。在所列基线中,ViewCrafter 整体最强,而 ReCA 的结构相似性较弱。结果表明,持久多镜头状态在返回先前访问过的位置时改善了空间一致性。ATAS 取得比所有比较方法更高的 PSNR 和 SSIM,以及更低的 LPIPS,包括最强所列基线 ViewCrafter。ViewCrafter 在所有三个空间重返指标上领先所列基线,而 ReCA 的 SSIM 最低,PSNR 也处于最低之列。该改善在基于 Agent 的方法和 3D 引导方法中均出现,支持持久多镜头状态而非单一渲染器的收益。
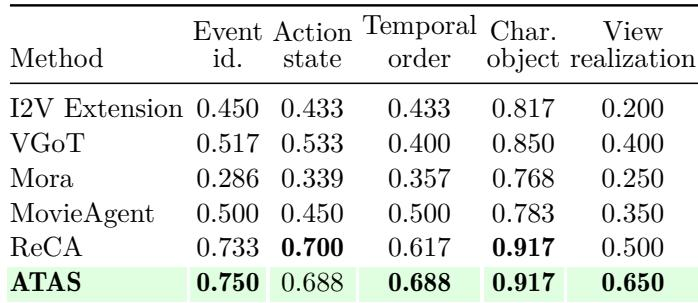
ATAS 在比较方法中实现了最强的基于源的事件重现,在事件身份、时间顺序和视角实现上领先,同时在角色和物体一致性上与 ReCA 并列。其动作状态保留略低于 ReCA,但高于其他基线。人类评分同样将剧本忠实度和角色一致性突出为更明显的优势,而背景一致性和叙事连贯性仍然较低。ATAS 在事件身份、时间顺序和视角实现上领先,并在比较方法中取得最高的视角实现得分。ATAS 在角色和物体一致性上与 ReCA 并列,在动作状态保留上仅略落后于 ReCA,表明精确的动作状态再现仍是较弱方面。
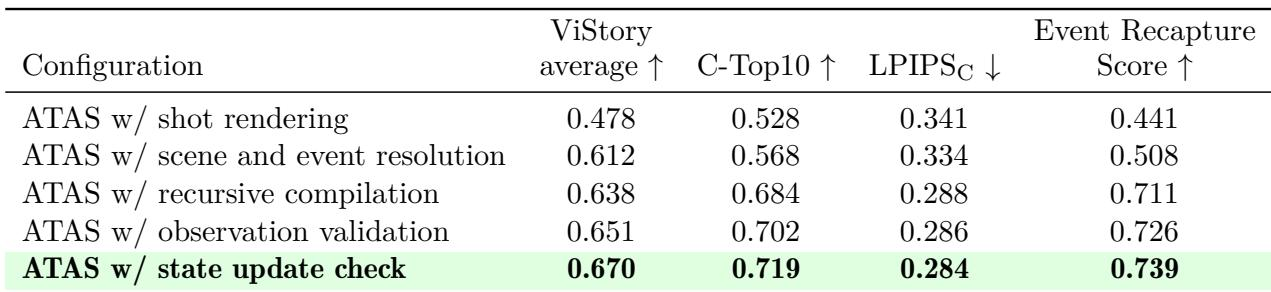
逐步加入记忆、递归编译、观察验证和状态更新检查,可提高 ViStory 平均值、检索一致性和事件重现,同时降低空间误差。最大收益来自记忆和递归编译,尤其是在事件连续性和 C-Top10 上。后续验证和状态检查组件带来的额外改进较小,表明它们主要是保持能力,而不是引入单独的检索效应。场景和事件解析显著提高 ViStory 平均值和事件重现,空间误差下降幅度有限。递归编译带来最大的事件重现增益,并在检索一致性上有明显改善。观察验证和状态更新检查在大多数指标上贡献较小的进一步增益,表明它们主要保护现有能力。
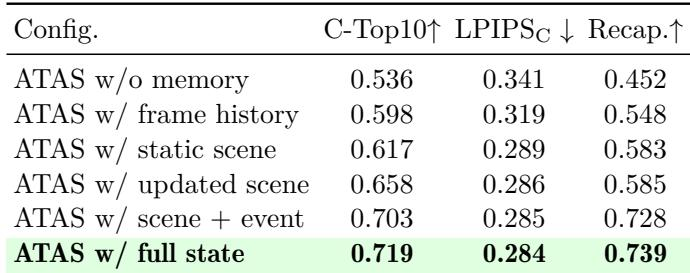
该消融在保持 ATAS 生成模型不变的情况下,改变存储证据和状态检查。帧历史在无记忆基础上改善了所有三个报告的连续性指标;静态和更新后的场景证据主要降低空间误差并改善角色匹配,而事件记忆带来最大的重现增益。完整状态取得最强的整体得分,但相较场景加事件的增益不大。与无记忆相比,帧历史改善了连续性、重现和空间一致性。静态场景证据主要降低空间误差,而更新后的场景证据改善角色匹配,对重现几乎没有改变。事件记忆带来最大的重现改善,完整状态以仅有限的最终提升达到最佳整体指标。
实验在多镜头视频生成基准、空间重返恢复和基于源的事件重现上评估 ATAS,并对记忆和状态组件进行消融。ATAS 在 Agent 级和空间一致性结果上持续领先,持久多镜头状态改善了基准综合分数、目标视图恢复、事件身份、时间顺序和视角实现,尽管精确的动作状态再现仍是较弱方面。消融实验显示,记忆和递归编译在连续性和事件重现上提供最大收益,而场景与事件证据、验证和状态检查主要细化空间一致性、角色匹配并保护现有能力。