Command Palette
Search for a command to run...
Doc 2 Harness:面向编码智能体长程 Harness 工程的 LLM 基准评测
Doc 2 Harness:面向编码智能体长程 Harness 工程的 LLM 基准评测
摘要
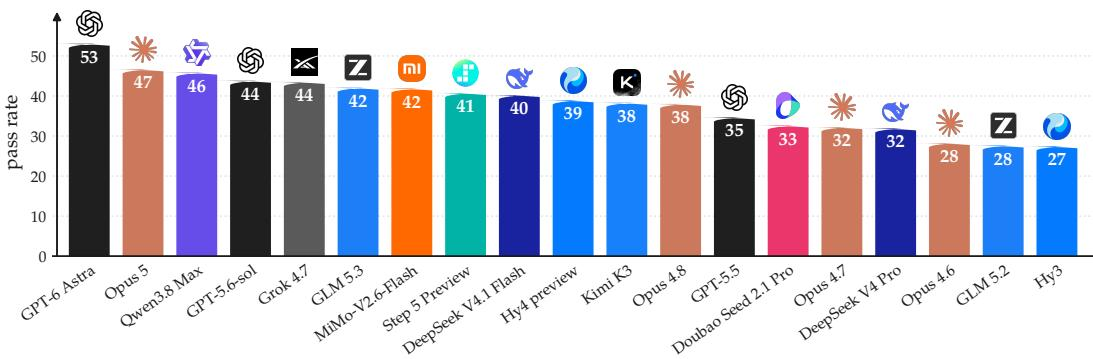
由大语言模型驱动的智能体越来越多地被部署到长程任务中,它们在这些任务中使用工具并修改真实工作区。其表现既取决于模型本身,也同样取决于模型周围的 harness。现有基准在固定 harness 下衡量下游任务的成功与否,未对 harness 工程本身进行探索。我们提出 Doc2Harness,一个直接评估长程 harness 工程的两阶段基准。在第一阶段,一个在固定 builder harness 内运行的构建模型接收仅包含接口的契约骨架和一份整合了 12 个前沿 harness 行为的开发文档,并在隔离容器中构建完整的候选 harness。在第二阶段,冻结的候选 harness 在与构建环境分离的容器中运行,每个测试用例一个容器,并由脚本化 mock 模型端到端驱动。我们通过四个可观测通道对每个测试用例评分,即发送给模型的请求、磁盘上的文件、进程退出码和命令输出;阳性对照排除了空洞通过。在 19 个前沿模型中,每个模型在 328 个测试用例上以三次独立构建进行评估,GPT-6 Astra 达到最高通过率 53.05%,而最弱模型为 27.44%,差距约为 26 个百分点。即使最强模型也未能通过近一半的测试用例,失败集中在横切功能如何在模块间划分。据我们所知,Doc2Harness 提供了首个用于衡量长程 harness 工程的确定性基准。
一句话总结
来自中国科学院计算技术研究所、清华大学、北京大学和东南大学的研究人员提出了 Doc2Harness,这是一个两阶段基准,用于评估长周期 harness 工程能力。该基准先从仅含接口契约和整合后的开发文档构建候选 harness,再在隔离容器中通过请求、文件、退出码和命令输出对候选 harness 进行评分。在 328 个测试用例上,GPT-6 Astra 达到了 53.05% 的最高通过率。
核心贡献
- 论文提出了 Doc2Harness,一个两阶段基准,直接评估长周期 harness 工程能力:构建模型根据契约骨架和一份整合了十二个前沿 harness 功能的开发文档,构建完整的候选 harness,然后在隔离容器中由脚本化 mock 模型驱动该冻结的 harness 运行。
- 每个测试用例通过四个可观察通道进行评分:发送给模型的请求、磁盘上的文件、进程退出码和命令输出;阳性对照排除了空洞通过的可能性,并支持逐条进行行为一致性检查。
- 在十九个前沿模型上,每个模型在 328 个测试用例上进行三次独立构建评估,GPT-6 Astra 达到了 53.05% 的最高通过率,而最弱模型为 27.44%。即使最强模型也有近一半测试用例失败,失败主要集中在跨切面功能如何在不同模块间拆分;该基准被描述为第一个用于衡量长周期 harness 工程的确定性基准。
引言
随着 LLM 驱动的编码 agent 在更复杂的场景中运行,管理交互循环、工具执行、权限、状态、失败恢复和验证的 harness 决定了模型能力在多大程度上能够作用于环境。然而,先前的 SWE 基准依赖成熟的代码仓库和单元测试,这适合代码补全或代码重构,但无法捕捉多种有效的 harness 实现或黑盒行为需求。现有的 harness 基准也通过下游任务来衡量质量,这混淆了驱动模型与测试时搜索的影响,而仅看输出的评分可能遗漏未授权行为。作者提出了 Doc2Harness,一个两阶段确定性基准:构建模型根据开发文档和仅含接口的契约骨架构建 harness,随后由 mock 模型通过预设的脚本化会话驱动该 harness 运行,并通过四个通道进行观察,同时使用阳性对照排除空洞通过。该方法直接评估 harness 开发本身,而不是依赖下游任务表现。
数据集
数据集描述
作者使用三种主要的文本类工件:开发文档、契约骨架和测试套件。
1. 开发文档
来源
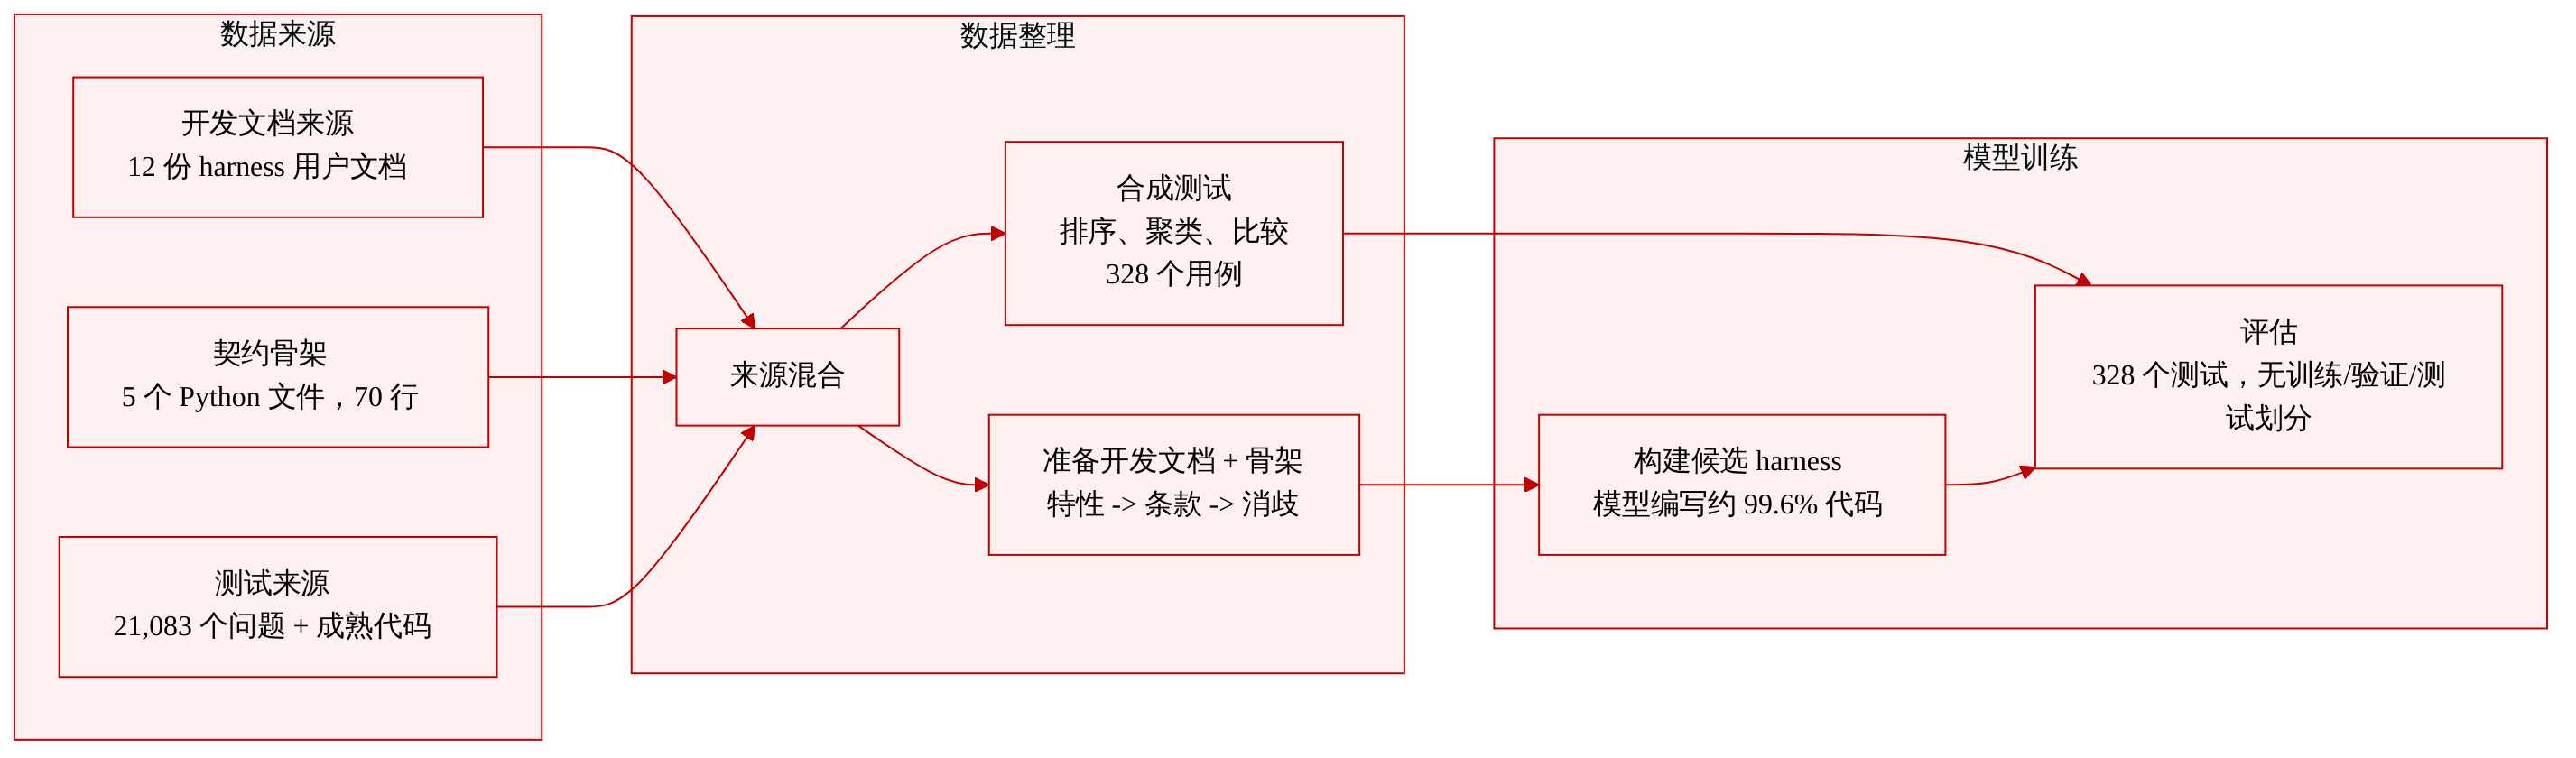
- 来自 12 个前沿 harness 的用户文档:Claude Code、Kimi Code、Gemini CLI、Qwen Code、OpenCode、OpenClaw、Codex CLI、Aider、OpenHands、Cline、Crush 和 Cursor。
处理与组合
- 首先,从文档中收集候选功能。
- 然后,作者为每个候选功能补充调用形式、参数语义和边界行为。
- 将得到的清单进行合并、去重并裁剪为一组条款。
- 每个条款包含语法、含义和预期行为。
- 条款涵盖内置工具、顶层命令、子命令、权限和角色模式、全局标志、会话内命令、持久记忆、约定文件、一致性规则、退出码以及评估 API。
- 可观察效果被限制在四个通道:模型请求、磁盘文件、进程退出码和命令输出。
- 消歧处理会合并重叠命令,例如
/compact和/summarize,并区分共享同一名称的不同概念,例如plan作为权限模式与基于角色的规划职责。
2. 契约骨架
来源与组成
- 五个 Python 源文件,总计约七十行。
- 一个安装脚本、一个入口脚本和一个项目配置。
- 三个不可变的外部契约:CLI、无头入口点和用于驱动自动化评估的 API。
规模
- 一个有代表性的完整候选 harness 约包含 30 个 Python 源文件和约 16,000 行代码。
- 最终候选 harness 中约 99.6% 的内容是由构建模型在契约骨架之外编写的。
3. 测试套件
来源与筛选
- 公开 issue 挖掘:
- 从 Claude Code、OpenCode、Gemini CLI 和 Kimi Code 拉取 issue。
- 过滤掉 pull request 后,数量分别为 9,868、5,438、4,831 和 946,总计 21,083。
- 按与开发文档的相关性对记录进行排序,从顶部开始人工审查,直到边际产出下降为止。
- 将相关报告聚类,每个聚类生成一个候选测试用例。
- 如果重叠聚类会同时通过或同时失败,则将其合并。
- 保留的候选必须能转化为确定性断言,并且不能已被覆盖。
- 跨 harness 对比:
- 使用成熟 harness(如 Kimi Code 和 Qwen Code)的公开源代码。
- 将候选实现和对比实现按开发文档功能划分为不同模块。
- 逐个模块列举实现差异。
- 仅保留可从开发文档条款目的推导出的差异。
- 现有套件扩展:
- 从种子测试用例派生变体。
- 距离检查会丢弃与种子过于接近的候选用例。
统计数据
- 最终测试套件包含 328 个测试用例。
- 测试用例被划分为九个互不相交的类别。
- 130 个测试用例由至少一个阳性对照进行门控。
- 其中 114 个由一个对照门控,15 个由两个对照门控,1 个由三个对照门控。
- 最宽的阳性对照门控六个测试用例,并确认指向工作区外部的符号链接可读。
- 另外两个阳性对照各门控五个测试用例:一个用于范围读取,一个用于搜索命中行为。
数据使用方式
- 没有传统的训练划分或混合比例。
- 开发文档和契约骨架被放入一个新创建的空容器中。
- 构建模型仅使用指定的模型网关编写候选 harness,没有其他外部网络访问。
- 预检确认容器中没有意外文件,并且 OpenCode 能正常启动。
- 测试套件用于评估;每个测试用例必须锚定到开发文档中的某个条款,并能区分不同实现。
- 评估不是迭代式的构建-评估-修复循环。每次构建最多允许提交三次。
- 没有描述图像裁剪或视觉元数据构建;工件是文本文档、源文件和测试用例。
方法
作者提出了 Doc2Harness,一个两阶段评估框架,旨在评估构建模型开发编码 agent 的 harness 的能力。整体流程包括构建阶段和评估阶段,如框架图所示。
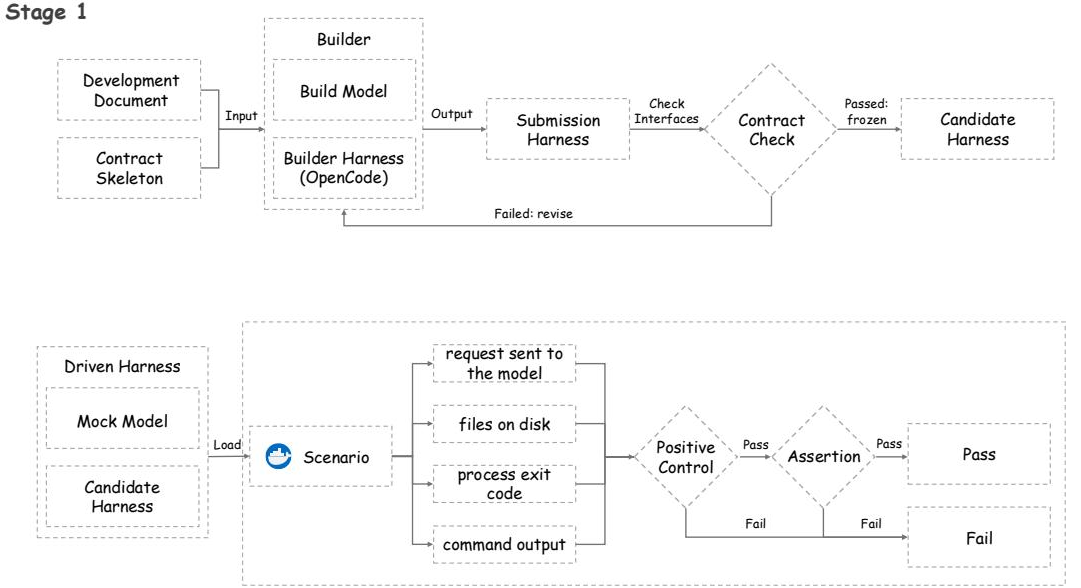
在第一阶段,即构建阶段,构建器将被评估的构建模型与固定的构建器 harness(具体为开源框架 OpenCode)结合使用。构建器以开发文档和契约骨架作为输入。契约骨架提供了必要接口,但不包含实现细节。构建器迭代构建候选 harness 并提交。随后进行契约检查,验证交付物可以编译、安装,包含所有必需命令,没有占位符桩代码,并实现了三个契约接口。如果检查通过,交付物被冻结为候选 harness。如果未通过,构建器在配额内进行修订并重新提交。
在第二阶段,即评估阶段,冻结的候选 harness 被加载到隔离容器中,与 mock 模型一起构成受驱动 harness。mock 模型按照预设脚本执行每个测试用例的场景,避免真实大语言模型的不稳定性。执行效果通过四个通道进行观察:发送给模型的请求、磁盘上的文件、进程退出码和命令输出。为确保通过的测试用例反映真实需求满足而非观察机制故障,框架引入了阳性对照机制。只有当一个测试用例通过自身断言以及所有门控阳性对照时,才会被记录为通过。
为生成第二阶段使用的测试用例,作者采用了三种合成方法的高产出驱动循环,兼顾广泛覆盖与深入检查。
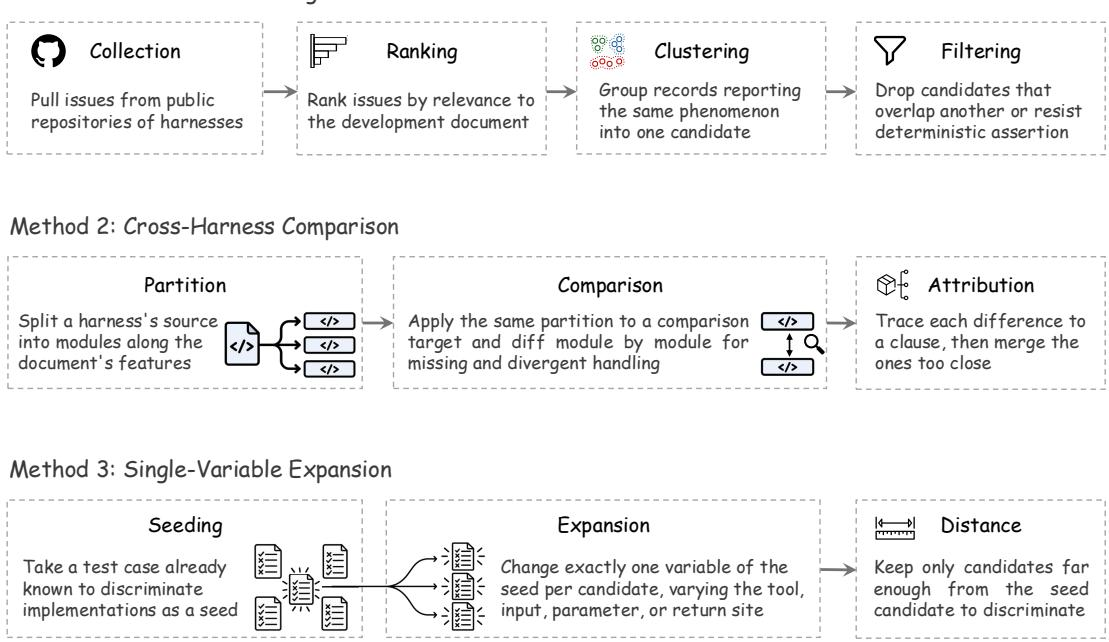
第一种方法,公开 issue 挖掘,基于一个假设:成熟 harness 中的缺陷与构建模型所犯的错误存在重叠。作者从各个前沿 harness 仓库收集公开 issue,按与开发文档的相关性排序,将报告同一现象的记录聚类,并过滤掉重叠或非确定性的候选用例。
第二种方法,跨 harness 对比,通过将候选 harness 与成熟对比对象的源代码进行比较来扩展覆盖范围。源代码根据开发文档中列出的功能被划分为模块。作者逐个模块列举实现差异,并将这些差异归因于特定条款,仅保留源自条款目的的差异。
第三种方法,单变量扩展,从一个已知能区分不同实现的种子测试用例出发,深化检查。作者只改变种子场景中的一个变量,例如所用工具、输入形式、错误参数或返回结果的位点。距离检查确保新候选用例与种子用例有足够差异,从而增加区分能力。这三种方法交替使用,直到边际产出下降。
实验
该研究使用两阶段设置评估了来自十一家厂商的十九个模型:构建器 harness 通过 OpenCode 在轮次、时间和提交限制下构建候选 harness,然后每个测试用例在各自容器中运行一次并设有超时。主要结果表明该套件尚未饱和,能够区分不同模型,顶级模型之间的差异主要体现在边界场景上。类别分析显示类别间存在显著但正相关的差异,指向一种整体能力。架构结果显示实现规模主要由模型身份决定,碎片化的 harness 往往得分较低。局限性方面,协议只衡量单次构建,且相关的测试用例可能导致集群化失败。
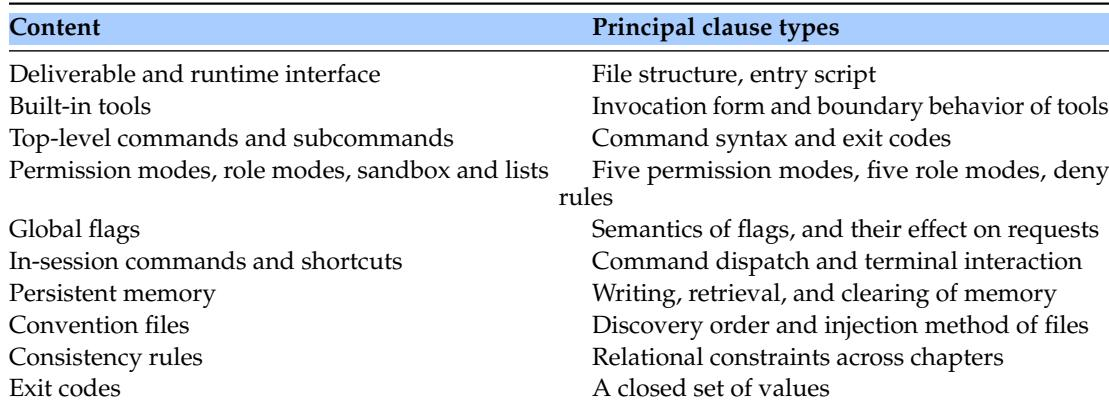
开发文档围绕外部可观察的接口区域来组织条款,包括交付物和运行时接口、内置工具、顶层命令、权限和角色模式、全局标志、会话内命令和持久记忆。每个区域被赋予主要条款类型,这些条款定义了可验证的行为,例如文件结构和入口点、工具调用边界、命令语法和退出码、访问规则、标志对请求的影响、终端交互以及记忆操作。交付物和运行时接口条款涵盖文件结构和入口脚本,将规范建立在可观察的项目布局之上。内置工具条款关注调用形式和边界行为,而命令条款规定语法和退出码。访问和交互条款描述权限模式、角色模式、拒绝规则、标志语义、命令分派和终端交互。持久记忆条款定义存储信息的写入、检索和清除。
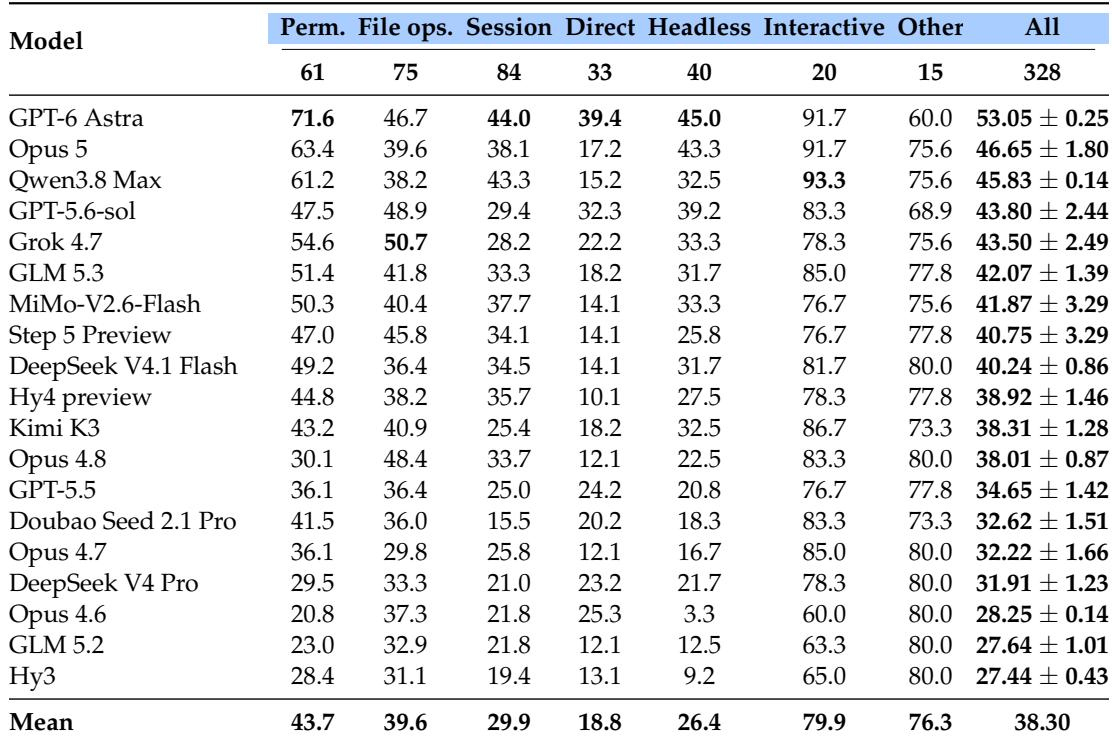
该套件远未饱和:最强模型仅通过略过半数的测试用例,而最弱模型约通过四分之一,两者之间存在超过二十五个百分点的差距。在领先模型中,整体通过率相对接近,但最佳模型在边界场景上取得优势,而排名第二的模型在这一场景下通过率大幅下降。各类别表现存在差异,对于所列模型,交互式终端任务通常得分最高,直接驱动任务得分最低。最强模型有近一半测试用例失败,而最弱模型仅通过略过四分之一,因此该套件并未饱和。整体领先者在普通场景上落后,但在边界场景上领先,而排名第二的模型在边界场景上的通过率急剧下降。
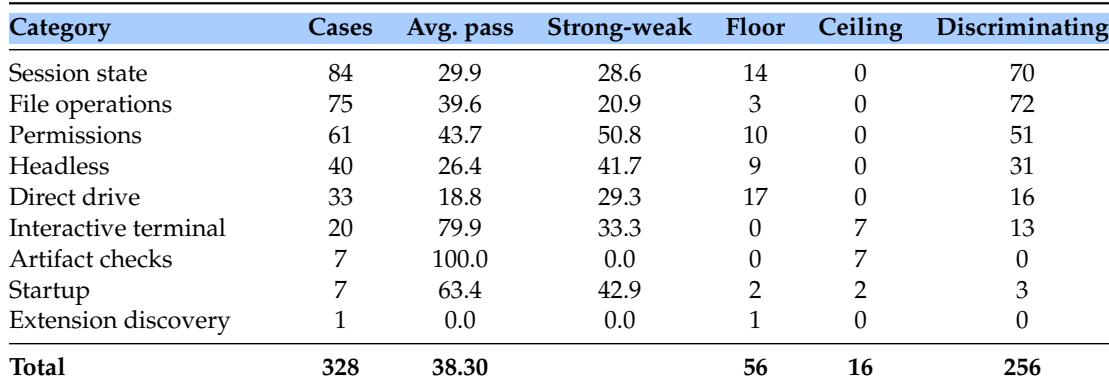
不同评估类别在区分能力上差异显著:权限类别对候选 harness 的区分度最高,文件操作类别具有相似的平均通过率但强弱差距小得多,交互式终端已接近饱和,而工件检查没有产生区分度。兜底测试用例集中在直接驱动、会话状态、权限和无头模式。尽管类别间存在正相关的成对相关性,各类别排名差异很大,这与一种大体上一维的能力结构一致。权限类别提供了最大的模型区分度,而文件操作类别平均通过率相似但强弱差距小得多。兜底测试用例集中在直接驱动、会话状态、权限和无头模式,工件检查则被所有候选 harness 通过。
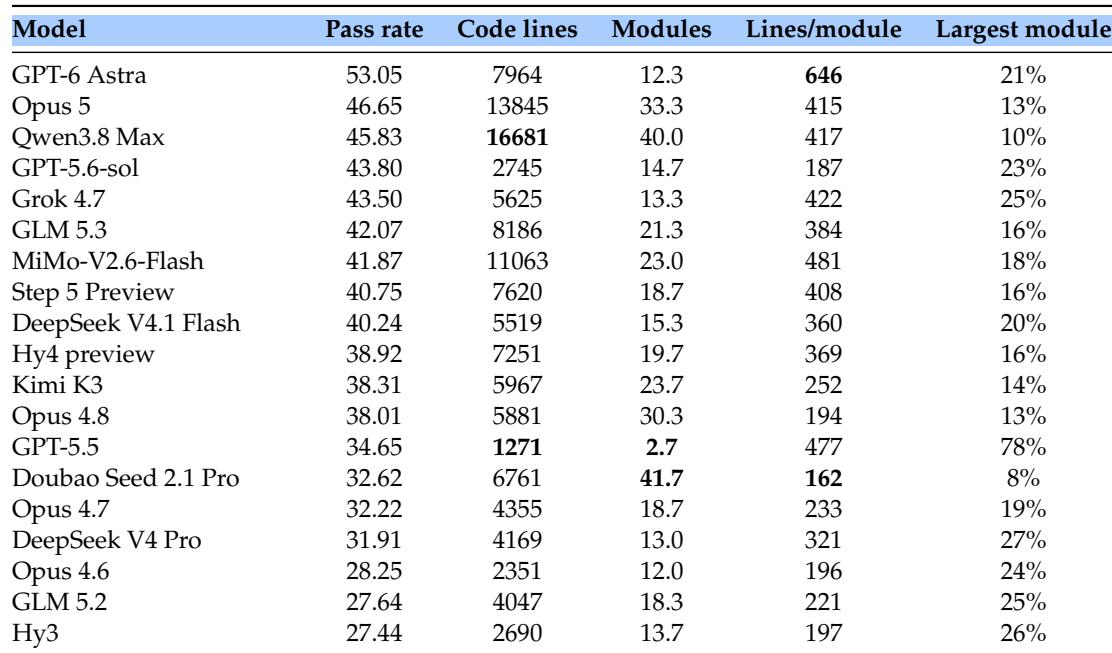
架构指标的变化主要由模型身份决定,而非同一模型的重复构建之间的差异。按代码行数计算的较大 harness 往往通过率更高,而在控制代码规模后,拆分为更多模块与较低通过率相关。每个模块行数更多的 harness 往往得分更高,表明内聚性更强的大型模块更有效。实现规模主要由模型身份驱动,同一模型的不同构建之间差异远小。控制代码规模后,更少模块和每个模块更多行数与更高通过率相关,表明碎片化代价高昂。
评估对照以下条款检查 harness:交付物和运行时接口、内置工具、命令、访问和角色模式、全局标志、会话内行为和持久记忆。该套件并未饱和:最强模型仅通过略过半数的测试用例,最弱模型约通过四分之一,最佳模型的优势主要体现在边界场景上,其中交互式终端任务得分最高,直接驱动任务得分最低。类别层级分析显示权限类别提供了最强的区分度,而工件检查没有产生区分度,交互式终端已接近饱和;兜底用例集中在直接驱动、会话状态、权限和无头模式。架构结果表明模型身份决定实现规模,并且在控制代码规模后,更少且更大的模块与更高通过率相关。