Command Palette
Search for a command to run...
RuleTrek:复杂场景中智能体规则推理的基准评测
RuleTrek:复杂场景中智能体规则推理的基准评测
摘要
大型语言模型(LLM)越来越多地处理专业领域中的复杂实际任务。然而,当场景信息分布在多个文件中时,识别并正确应用领域特定规则仍然具有挑战性。现有的规则推理基准通常仅使用少量事实性陈述来表示场景,从而简化了相关规则的识别与应用。为了弥补这一不足,本文提出了 RuleTrek,一个面向复杂场景中智能体规则推理的多领域基准。其基于规则的构建流水线提取结构化规则图,生成并增量式地组合规则特定的子场景,同时确保一致性与可解性。为了系统性地评估复杂场景中的智能体规则推理,RuleTrek 在交互式工作空间中评估三项能力:规则识别(RI)、规则演绎(RD)和端到端规则推理(E2E)。在 11 个前沿 LLM 上的实验表明,最高的 RI 和 RD 得分分别仅为 62.47% 和 60.43%,而 E2E 得分在 26.97% 到 55.29% 之间。这些结果表明,当前的 LLM 智能体在复杂场景下的规则推理中面临重大挑战。我们已在 RuleTrek 上公开代码和数据集。
一句话总结
来自中国科学院和北京智源人工智能研究院的研究者提出了 RuleTrek,一个用于 agentic 规则推理的多领域基准。其基于规则的管道提取结构化规则图,并组合一致且复杂的子场景。在 11 个前沿 LLM 上,规则识别和规则推导的最高分分别仅为 62.47% 和 60.43%,而端到端规则推理得分在 26.97% 到 55.29% 之间。
核心贡献
- RuleTrek 被提出为一个面向复杂多文件场景中 agentic 规则推理的多领域基准,在交互式工作区中评估规则识别、规则推导和端到端规则推理。
- 基于规则的场景构造管道提取结构化规则图,生成针对规则的子场景,并增量组合它们,同时确保场景一致性和基于规则的可解性。
- 在 11 个前沿 LLM 上的实验显示,规则识别和规则推导的最高得分分别为 62.47% 和 60.43%,而端到端得分在 26.97% 到 55.29% 之间,表明在分布式信息中识别和应用规则存在重大挑战。
引言
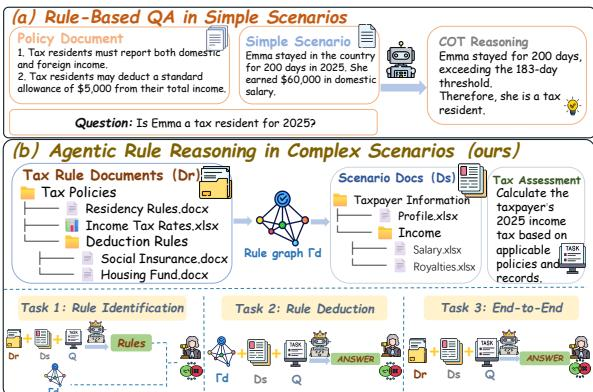
大型语言模型的近期进展使 agent 能够处理复杂的领域特定任务,如税务评估,其中解决问题需要识别适用规则并整合分布在多个文件中的场景信息。现有规则推理基准往往使用简化场景,而现实工作区基准很少评估 agent 能否在此类复杂环境中识别并正确应用领域特定规则。作者通过提出 RuleTrek 来填补这一空白,RuleTrek 是一个具有交互式工作区和基于规则的场景构造管道的多领域基准,用于评估规则识别、规则推导和端到端规则推理。
数据集

作者将 RuleTrek 描述为由真实规则仓库构建的基准数据集。
来源与领域
- RuleTrek 覆盖六个领域:
- 税务
- PostgreSQL
- 网络安全
- 软件政策
- 采购
- 游戏规则
- 对每个领域,作者收集相关真实规则文件,并保留其原始组织与格式,包括文档、表格、配置文件和源代码。
- 摘录未报告实例的确切数量或每个领域的规模。
实例组成与模式
每个基准实例包含四个组成部分:
- 规则仓库 Rd
- 已验证规则图 Γd
- 场景 ST
- 问题 Q
数据集构建与处理
RuleTrek 使用三阶段管道。所有基于 LLM 的构建步骤均使用 GPT-6-Astra。
-
阶段 1:领域规则图提取
- LLM 从收集的规则文件中提取结构化规则图。
- 节点表示基于原始仓库的具体规则。
- 边捕获如下关系:适用性依赖、资格条件、聚合、例外、覆盖、优先级和时间约束。
- 人类专家手动验证提取的规则、来源引用和依赖项,并修正不准确或缺失的信息。
-
阶段 2:针对规则的子场景构建
- 对每条规则,LLM 生成一个需要该特定规则才能解决的子场景。
- 子场景使用适合领域的文件,例如电子表格、配置文件、日志、表单、消息、表格或源代码。
- 专家手动审查每个子场景的规则一致性、可解性和信息充分性。
- 删除冗余案例,专家确保实体、上下文和信息组织方式的多样性。
-
阶段 3:依赖感知的组合
- 子场景根据已验证规则图中的依赖项增量组合。
- 添加新子场景时,可能修订现有文件,以对齐实体、时间戳、状态、版本、单位和跨文件引用。
- 人类专家在每一步组合后检查一致性和可解性。
- 如果检查失败,LLM 修改受影响文件,并对结果进行重新验证。
- 组合过程中原始规则图保持不变。
-
问题实例化
- 在最终场景通过一致性和可解性检查后,作者根据场景和规则图生成问题及答案。
- 人类专家使用原始规则和场景文件解答每个问题,验证可答性、答案唯一性和规则合规性。
- 无效实例被修改并重新验证。
过滤与质量控制
- 对规则图、子场景、中间组合场景和最终问题均进行人工验证。
- 一致性检查检查文件间信息是否保持一致。
- 可解性检查判断场景能否使用底层规则解决。
- 专家还验证答案唯一性和规则合规性。
数据使用方式
RuleTrek 作为评估基准而非训练语料。摘录未描述训练划分或混合比例。
它定义三种在相同复杂场景和问题上的评估设置:
-
规则识别(RI)
- 输入:规则仓库 Rd、场景 ST、问题 Q
- 目标:识别适用规则及其依赖关系
- 输出:估计规则图 Γ^
- 不需要已验证规则图和最终答案。
-
规则推导(RD)
- 输入:已验证规则图 Γd、场景 ST、问题 Q
- 目标:将提供的规则应用于场景并得出最终答案
- 输出:最终答案 A^
-
端到端规则推理(E2E)
- 输入:规则仓库 Rd、场景 ST、问题 Q
- 目标:从原始文档中识别适用规则,解决依赖关系,并应用它们产生最终答案
- 输出:最终答案 A^
所有设置中的 agent 都在交互式工作区中工作,可按需搜索和检查文件并执行代码。未描述图像裁剪或视觉特定预处理;数据仍保持领域特定文件格式。
方法
作者开发了一个名为 RuleTrek 的基于规则的场景构造管道,用于构建基于真实规则仓库的复杂场景。该管道由三个主要阶段和随后的问题实例化阶段组成。所有基于 LLM 的构建步骤均使用 GPT-6-Astra。
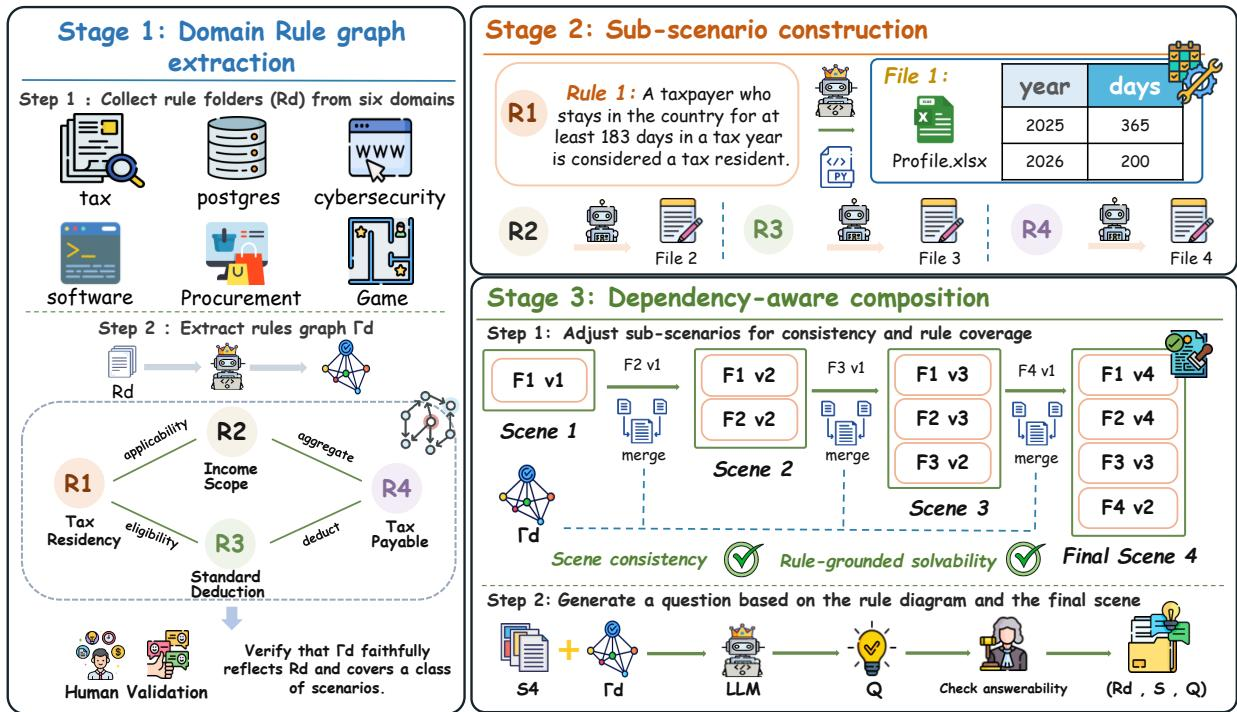
在第一阶段,即领域规则图提取中,作者从六个不同领域收集一组相关真实规则文件 Rd,包括税务、PostgreSQL、网络安全、软件政策、采购和游戏规则。使用 LLM 从这些仓库中提取结构化规则图 Γd=(Vd,Ed)。每个节点 Ri∈Vd 表示基于原始仓库的一条规则,而 Ed 中的边捕获明确关系,例如适用性依赖、资格条件、聚合、例外、覆盖、优先级和时间约束。随后,人类专家将提取的图与原始仓库进行手动验证,以确保规则、来源引用和依赖项的正确性,并修正任何不准确之处。
第二阶段聚焦于针对规则的子场景构建。为了控制哪些规则被使用并确保场景一致性,作者避免直接从规则图生成复杂场景。相反,对于每条规则 Ri∈Vd,LLM 基于 Ri 及其在 Γd 中的依赖项生成相应子场景 si。每个子场景提供应用 Ri 所需的信息,并通过领域特定文件表示,例如电子表格、配置文件、日志、表单或源代码。这些文件提供规则应用所需的实体、事件以及时间或状态信息。人类专家手动审查每个子场景的规则一致性、可解性和信息充分性,同时确保实体和上下文的多样性。
在第三阶段,即依赖感知的组合中,作者使用 LLM 根据 Γd 中编码的依赖项增量组合生成的子场景。从初始场景 S1 开始,逐步整合更多子场景,生成最终复杂场景 ST。每一步的组合操作定义为:
St+1=CΓd(St,sit+1),其中 sit+1 是新引入的子场景,CΓd 表示由规则依赖引导的 LLM 辅助组合。该过程并非简单合并文件;引入新子场景可能需要修订现有文件,以对齐实体、时间戳、状态、版本、单位和跨文件引用。每一步组合后,人类专家验证中间场景的一致性和可解性。如果任一项检查失败,LLM 修改受影响文件,随后再次进行人工验证。只有当两项检查均满足时组合才会继续,最终得到 ST,其中相互作用的规则和信息分布在多个文件中。
最后,在问题实例化阶段,当最终场景 ST 通过所有检查后,作者基于 ST 和 Γd 生成问题 Q 及其答案 A。人类专家使用原始规则和场景文件解答每个问题,以验证可答性、答案唯一性和规则合规性。无效实例被修改并重新验证,从而确保每个基准实例包含规则仓库 Rd、已验证图 Γd、场景 ST 和问题 Q。
实验
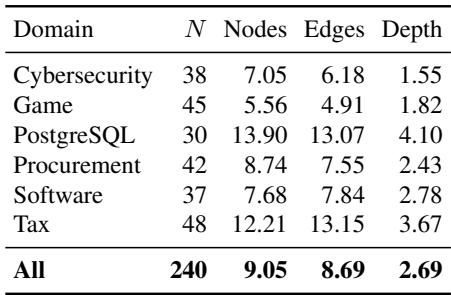
RuleTrek 在六个领域的 240 个复杂场景中评估了 11 个前沿 LLM,场景位于具有文件和代码访问能力的交互式工作区中,并使用三种设置:规则识别、使用已验证规则图的规则推导以及端到端规则推理。实验验证了 agent 在从原始文档中识别适用规则及其依赖关系方面以及正确应用已提供规则方面都存在困难,其中规则选择错误是最常见的失败原因。随着规则图规模和深度的增加,性能进一步下降,不同模型在交互效率上表现不同,而自动评分与人类判断高度一致,且在不同评判模型家族中排名稳定。
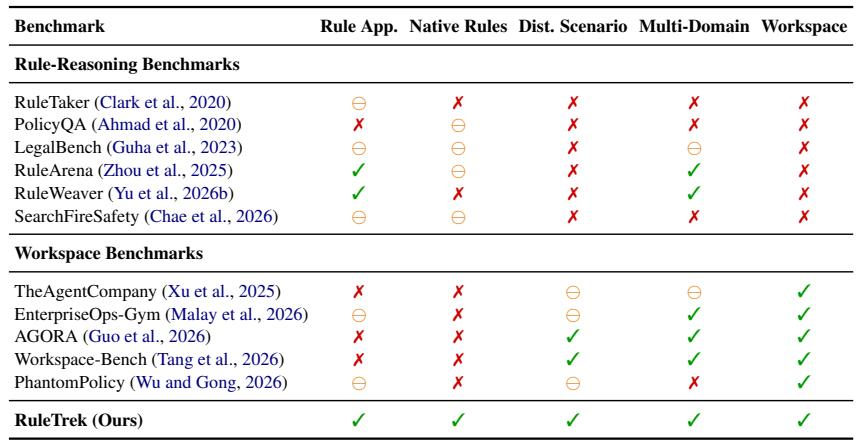
此前的规则推理基准在是否需要将领域规则应用于具体案例方面各不相同,但没有一个提供分布式场景证据或交互式工作区支持。所列基准中大多数也只部分保留或完全不保留原生规则,完整原生规则支持在所列基准中普遍缺失。这留下了在复杂多文件环境中评估规则识别和应用的空白。RuleArena 和 RuleWeaver 完全支持规则应用和多领域覆盖,但它们仍缺乏分布式场景和交互式工作区。所列规则推理基准中没有支持分布式证据或基于工作区操作的,原生规则表示最多也只是部分保留。
前沿 LLM 在所有测试领域和任务中表现出有限的规则推理能力。规则识别尤其困难,最佳平均识别得分仅接近 62%,且失败轨迹中规则选择错误占主导地位。即使提供已验证规则,推导得分峰值也在 60% 左右,端到端性能仍然更低,这表明识别和应用复杂规则两方面都限制了整体准确率。识别适用规则是主要瓶颈:最佳平均规则识别得分接近 62%,最低模型约为 33%。即使提供已验证规则,推导得分峰值接近 60%,端到端得分大约在 27% 到 55% 之间,表明规则应用仍然困难。
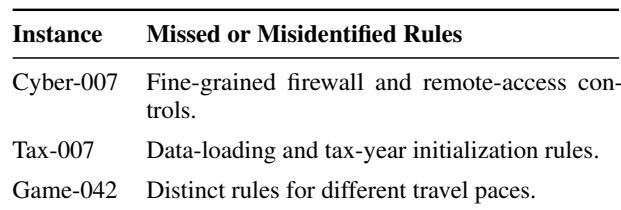
错误分析显示,模型经常遗漏网络安全中的条件特定控制、税务中的支持数据和初始化规则,以及游戏场景中不同行进速度对应的不同移动规则。这些错误反映了更广泛的规则选择失败,这是 agent 失败的最大来源,即使相关证据可用时也是如此。复杂场景使 agent 难以识别完整且结构正确的规则集。模型能够识别一般网络安全要求,但忽略了细粒度的防火墙和远程访问控制。税务场景遗漏了数据加载和税务年度初始化所需的支持规则。游戏场景错误地合并了适用于不同行进速度、不同条件下的移动规则。规则选择错误是最常见的失败类别,表明在识别适用规则方面持续存在困难。
自动评分可靠性在检索、推理和端到端任务中表现较强,人类评判一致性始终很高,但略低于人类之间的一致性。使用替代评判模型进行跨模型家族重新评分时,提交级别的协议稳健,模型排名高度稳定。在全部三项任务中,自动评判得分与独立人类标注高度一致。人类之间的一致性仍然高于人类与评判之间的一致性。当提交结果由不同模型家族的评判模型重新评分时,评分行为和模型排名保持稳定。
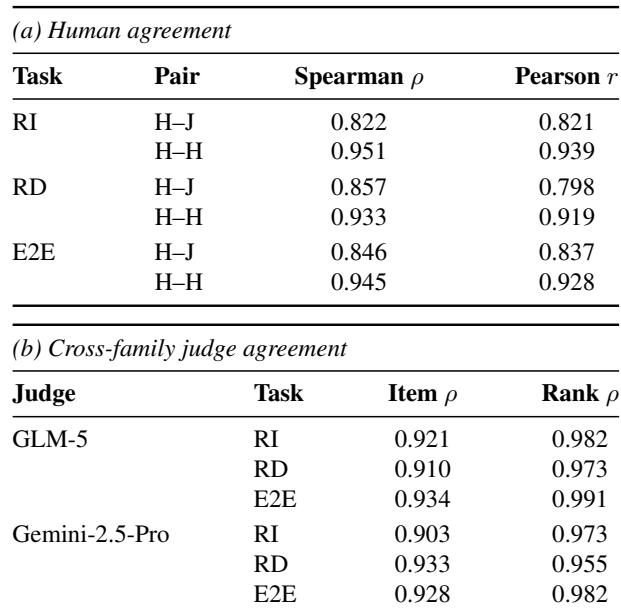
评估首先回顾了现有规则推理基准,发现没有一个基准同时结合分布式场景证据、交互式工作区和完整原生规则支持;RuleArena 和 RuleWeaver 涵盖了规则应用和多领域,但不包括这些设置。跨这些领域的前沿 LLM 实验显示规则推理能力有限:规则识别是主要瓶颈,平均识别得分约为 62%,规则选择错误占主导地位;推导得分峰值接近 60%,端到端准确率仍然更低。错误分析将这些失败归因于复杂网络安全、税务和游戏场景中遗漏的条件特定控制、支持规则和不同移动规则。自动评分经验证是可靠的,人类评判一致性在检索、推理和端到端任务中较高,跨模型家族重新评分得到稳定排名。