Command Palette
Search for a command to run...
AesCode:基于解耦跨模态奖励的美学代码生成
AesCode:基于解耦跨模态奖励的美学代码生成
摘要
将幻灯片、海报和仪表盘等信息丰富的视觉制品以代码形式生成颇具吸引力,因为其输出具有结构化、可编辑且可验证的特点。然而,代码模型无法看到自己对布局和颜色的选择在画布上如何整体呈现,这通常限制了空间规划与美学质量。图像生成器擅长视觉设计,但可能错误渲染所要求的内容,导致其输出难以作为直接复现的可靠目标。为此,我们提出了 AesCode,它在以内容提示为依据生成代码的同时,利用由同一提示生成的图像作为美学指导。具体而言,AesCode 将目标表示为一个描述整个画布的设计图,并使每个属性可归因。基于该图,我们推导出互补的跨模态奖励:确定性验证器对可从代码和渲染结果中解析的属性进行评分,而 VLM 评判器则使用与图元素和关系绑定的样本特定视觉图评分量表(VGR)评估不可解析的属性。我们通过带逐通道归一化的强化学习优化这些解耦奖励,以联合提升空间规划、美学质量和可验证正确性。为评估这一设置,我们构建了一个基准,将可验证正确性与视觉质量分别评分,其中视觉分数与人类判断高度一致。我们发现,参考图像能显著提升现有模型所生成代码的视觉质量;消融实验表明,AesCode 既受益于作为模型输入的参考图像,也受益于作为视觉奖励来源的参考图像。在给定相同参考图像的情况下,与同等规模的 Qwen3-VL 基线相比,AesCode-8B 和 AesCode-32B 分别将视觉质量提升 31.1 和 22.4 个百分点,达到与 GPT-5.5 和 Claude Opus 4.8 等闭源前沿模型相当的水平。
一句话总结
来自微软、耶鲁大学等机构的研究者提出了 AesCode,这是一种面向视觉制品的代码生成模型,它使用同一提示生成的图像作为美学引导,从设计图导出解耦的跨模态奖励,并通过带逐通道归一化的强化学习进行优化。与 Qwen3-VL 基线相比,其视觉质量和可验证正确性最高提升 31.1 个百分点,同时可与前沿模型相媲美。
核心贡献
- AesCode 在内容提示的约束下生成代码,同时使用由提示生成的参考图像作为美学引导,将目标表示为一幅描述整个画布的设计图,并使每个属性都可归因。
- 从该设计图出发,AesCode 导出互补的跨模态奖励。确定性验证器对可从代码和渲染中解析的属性评分,而 VLM 评判器使用与图元素和图关系绑定的、逐样本生成的 Visual Graph Rubric 评估不可解析的美学属性;这些解耦奖励通过带逐通道归一化的强化学习进行优化。
- 论文提出了一个信息图基准,分别对可验证正确性和视觉质量进行评分,并采用与人类一致的视觉判断。参考图像显著提升了现有模型的视觉质量;消融实验表明,AesCode 既从作为模型输入的参考图像中受益,也从作为视觉奖励来源的参考图像中受益;在给定相同参考图像时,AesCode-8B 和 AesCode-32B 相较于同规模 Qwen3-VL 基线的视觉质量分别提升 31.1 和 22.4 个百分点,达到与 GPT-5.5、Claude Opus 4.8 等前沿闭源模型相当的得分。
引言
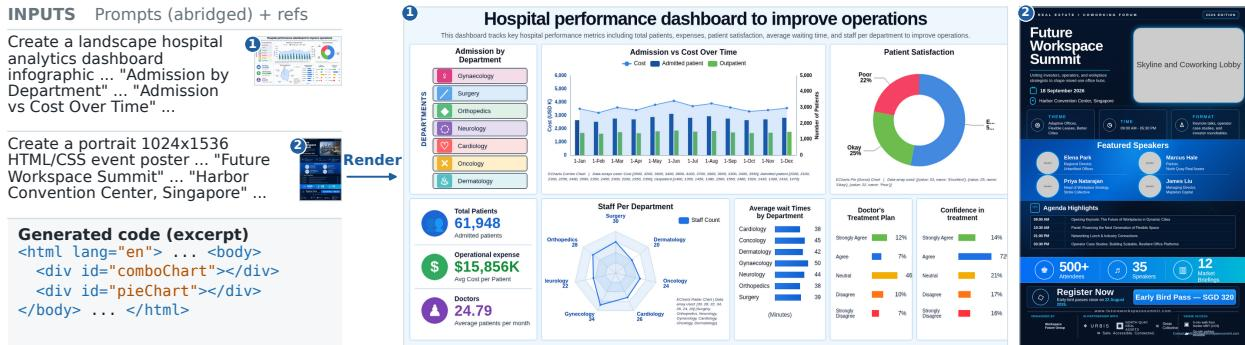
幻灯片、海报、仪表盘等信息密集型视觉制品将密集内容压缩到单一画布中,以代码形式生成它们很有价值,因为输出可保持结构化、可编辑和可验证。然而,先前的方法面临一个取舍:代码模型无法看到画布,往往生成视觉上过时的布局;图像生成器则生成引人注目但不可编辑的位图输出,且经常错误渲染文本和数据。现有的图像到代码方法将参考图像视为像素级重建的真值,这在图像是含噪声的生成先验时并不合适,因为这会鼓励复制幻觉内容并惩罚合理的设计变化。作者提出 AesCode,将目标表示为一个设计图,明确把所需内容与视觉属性和结构关系分开。这带来了解耦奖励:确定性验证器负责正确性,基于图的 VLM rubric 负责美学质量,并通过 Group reward-Decoupled Normalization Policy Optimization 进行平衡。该方法让提示生成的参考图像引导布局和风格,同时代码模型仍严格遵循提示的内容。
方法
作者利用图结构化监督来学习视觉设计生成。该框架首先构建一个目标设计图,将提示要求的内容与非权威参考线索结合。然后,它将不同的图属性路由到确定性奖励通道和感知奖励通道。最后,通过冷启动监督微调和组归一化强化学习目标对模型进行优化。
作为监督目标的设计图
提示规定了所需信息,但视觉设计允许多个有效解。由于学习需要具体信号,图像生成器提供一张合理的参考图像 Iref,该图像仍可能在事实或结构上存在错误。为避免把该参考图像当作单一整体目标,作者将监督组织为一个设计图。
监督目标定义为
Gtgt=(V,E,XV,r)=Φ(p,Iref),其中画布根节点 r 保存页面级属性并包含所有顶层元素。其余节点来自一个封闭的原子元素词汇表,包括文本、图像、图表、表格和徽章,以及区域、卡片、面板、列表和组等容器。三个或更多可互换的兄弟节点会折叠为一个带计数属性的组节点。属性 XV 记录内容、几何和外观,包括结构化的图表和表格数据。每条边 (u,τ,v) 带有一个关系类型 τ,涵盖包含、对齐、顺序、邻接和语义连接。
这种分解使提示要求和参考线索可以分别独立约束互补的属性。作者从生成的代码 c 及其渲染 I^ 中联合解析候选视觉元素,形成候选图:
G^=Ψ(c,I^).代码、DOM 和计算样式暴露结构化内容和实现细节,而渲染提供像素几何和视觉证据。候选图与 Gtgt 按属性逐一比较,以得到奖励信号。
从设计图到多目标奖励
图属性根据其可评估方式进行划分。代码中有结构化证据或渲染中有可测量证据的属性由确定性验证器处理。外观和高阶关系需要视觉判断,由逐样本的 VLM 评判通道处理。
六个确定性验证器从代码、DOM、OCR 和渲染像素计算分数。执行验证可渲染性和致命错误。文本验证所需字符串。边界衡量画布包含和宽高比一致性。表格和图表解析检查 HTML 表格和 ECharts 图表的结构、子类型和数据,防止静态替代物获得分数。语义布局将参考图像和候选图像中的 OCR 文本块进行匹配,并对它们的归一化位置一致性评分。留白在粗尺度和细尺度上比较非背景占用,捕捉留白分布情况。
对于其余属性,作者引入了 Visual Graph Rubric。他们从 Gtgt 推导出逐样本的布尔问题列表 Qtrain。每个问题绑定到一个节点、属性、关系或子图,因此设计图是为 rubric 构建提供脚手架,而不是作为策略输入。VLM 根据候选渲染回答固定问题,通过率定义为
svgr=∣Qtrain∣1q∈Qtrain∑1[I^ satisfies q].参考线索仅通过固定问题进入,Visual Graph Rubric 仅用于训练。
训练流程
冷启动监督微调首先从经过筛选的教师示范与收集的图像配对中建立可靠的“提示和图像到代码”生成。随后强化学习切换到图像生成器参考,并优化七个奖励通道。
由于这些通道在适用性、尺度、稀疏性、饱和度和学习难度上各不相同,直接聚合原始奖励会掩盖有用信号。因此作者使用 Group reward-Decoupled Normalization Policy Optimization,即 GDPO。
对于每个 (p,Iref),模型采样代码 rollout B={ci}i=1B,渲染 I^i=render(ci),并解析 G^i=Ψ(ci,I^i)。将 G^i 与 Gtgt 比较,得到七个奖励组成的向量 si。掩码 mi(v)∈{0,1} 表示通道 v 是否适用于 rollout i。令 μv 和 σv 表示适用子集 Bv={i∣mi(v)=1} 上的均值和标准差。GDPO 先对每个通道进行归一化,再对适用的优势取平均:
Ai(v)=σv+ϵsi(v)−μv,Ai=∑vmi(v)∑vmi(v)Ai(v).其中
ρi(θ)=πold(ci∣p,Iref)πθ(ci∣p,Iref),GDPO 最大化裁剪后的组目标
LGDPO(θ)=B1i=1∑Bmin(ρi(θ)Ai,clip(ρi(θ),1−ε,1+ε)Ai).适用性掩码排除了不相关的检查,因此所有有效目标都能共同贡献于一次策略更新,而无需先将原始奖励压缩成标量。
最终评估协议
训练需要具体参考,但评估必须允许多个有效设计。因此作者通过 Rule、Visual 以及二者的平均值 Overall 来评估生成制品本身。Rule 对确定性的 Text、Boundary 和 Table/Chart 检查取平均,这些检查从代码和渲染中验证精确内容、画布包含和结构化数据。
Visual 将开放式的、逐样本的质量转换为从提示要求推导出的检查清单。Content 检查必需元素的存在性和完整性。Layout 覆盖组织、关系和碰撞。Style 根据生产级标准评判层级、排版、颜色和组件完成度。VLM 根据候选渲染回答固定的是/否问题,Visual 对这三个维度取平均。这些是对制品的绝对标准,而不是成对比较。问题生成流程在独立集合上开发,经过滤剔除模糊、非视觉和实现特定的标准,然后冻结并原样应用于评估基准。
实验
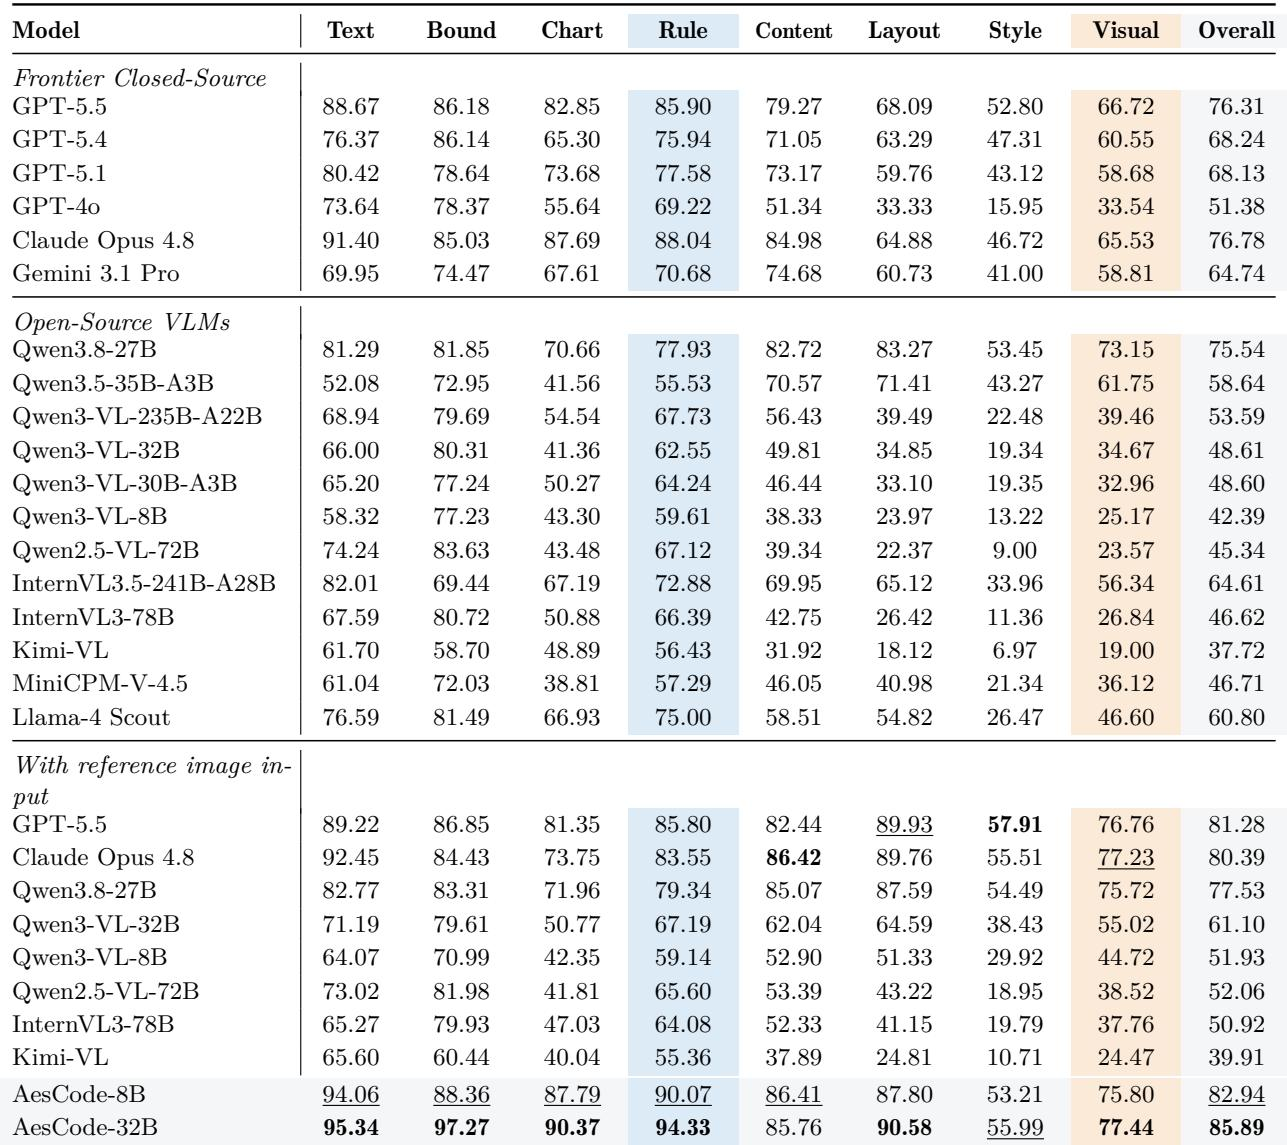
评估设置将对文本、边界和表格/图表的规则化验证与从每个提示推导出的冻结视觉检查清单结合起来,而训练则使用对精选人类设计的监督微调和带代码与视觉奖励的强化学习。主要结果表明,参考条件化改善了所有模型的视觉呈现,但风格仍然是瓶颈;AesCode 训练将 8B 模型的整体性能从 51.93 提高到 82.94,将 32B 模型从 61.10 提高到 85.89,并在外部基准上获得迁移增益。消融实验确认,强化学习和解耦的视觉图奖励带来了大部分视觉改进,人类评估与自动视觉分数一致,而剩余失败主要集中在画布溢出、关系结构和通用图标渲染上。
在 300 实例信息图基准上,所列闭源模型的规则类分数始终高于视觉分数且更稳定。Claude Opus 4.8 取得最高的整体分数,而 GPT-5.5 的视觉分数最强。风格是这些模型中最弱的指标,所有列出系统的风格分数都低于 60%。Claude Opus 4.8 在内容保真度和整体分数上领先所列模型,而 GPT-5.5 在视觉和风格分数上领先。对于较弱的模型(如 GPT-4o),视觉质量比规则合规性下降得更剧烈,其视觉和风格分数远低于规则分数。
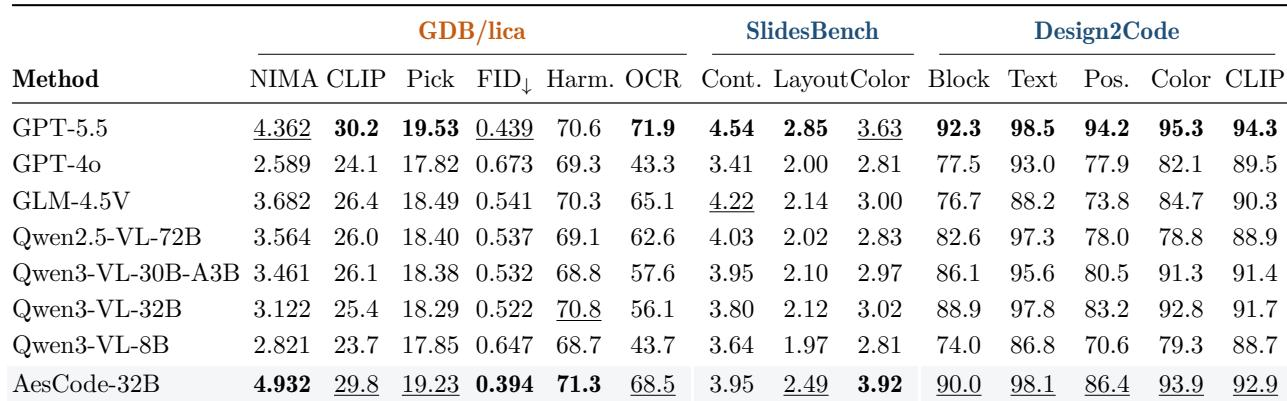
在外部迁移基准上,GPT-5.5 在大多数设计敏感指标上领先,尤其是布局和颜色;而 Qwen3-VL-32B 在若干视觉和面向重建的分数上是最接近的开放模型。Design2Code 相似度指标接近饱和,与人类美学判断的一致性较差,从而削弱了它们区分模型的能力。周边分析表明,GPT-5.5 在精确截图保真度上仍然更强,而 AesCode 的可迁移增益集中在布局和视觉设计上。GPT-5.5 在包括布局和颜色在内的大多数设计敏感指标上取得最高迁移性能,GPT-4o 和 GLM-4.5V 往往以更大差距落后。Qwen3-VL-32B 在若干布局和颜色维度上是最强的开放权重模型,而 Design2Code 相似度指标接近饱和,对美学差异不够敏感。GPT-5.5 在精确截图保真度上仍然更强,而 AesCode 的可迁移增益在于布局和视觉设计,而非重建特定的相似度。
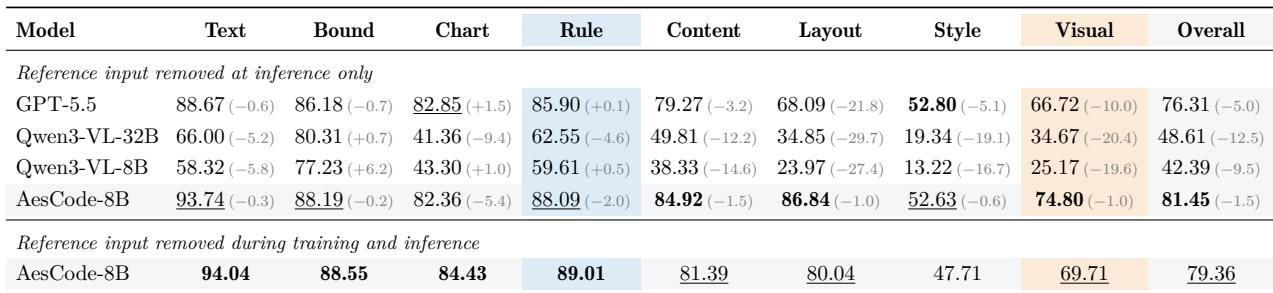
参考条件化训练使 AesCode-8B 在推理时移除参考图像的情况下,比 GPT-5.5 和 Qwen3-VL 基线更稳健得多,Visual 性能仅小幅下降。当训练时也移除参考输入、但保留基于参考的奖励时,相比仅用提示的训练仍能带来明显的 Visual 增益,尽管性能仍低于参考条件化设置。这表明参考图像既作为直接输入条件有帮助,也通过奖励作为间接监督有帮助。AesCode-8B 对推理时移除参考图像的敏感度远低于 GPT-5.5 和 Qwen3-VL 基线,Visual 仅有小幅下降。Qwen3-VL 模型在推理时移除参考输入后,布局、风格、内容和视觉分数大幅下降。训练时移除参考输入但保留基于参考的奖励,可使 Visual 远高于仅用提示的基线,但仍落后于参考条件化策略。
结合 SFT、RL、GDPO、Layout/Whitespace 和 VGR 的完整配置取得最高的 Overall 和 Visual 分数。RL 带来的增益最大,而 SFT 提供了更强的初始化;随后设计监督推动视觉质量,VGR 在不牺牲 Rule 的情况下优于标量 GRPO、CLIP 和整体式 VLM 替代方案。将 GDPO 替换为标量 GRPO 会使 Visual 降低 5.12 分,而 Rule 保持相近,这表明逐通道独立归一化对感知目标有益。将 VGR 替换为 CLIP 或整体式 VLM 会使 Visual 降低约 5 到 7 分;仅在仅代码正确性监督基础上添加 Layout/Whitespace,对 Visual 的提升也较为有限。
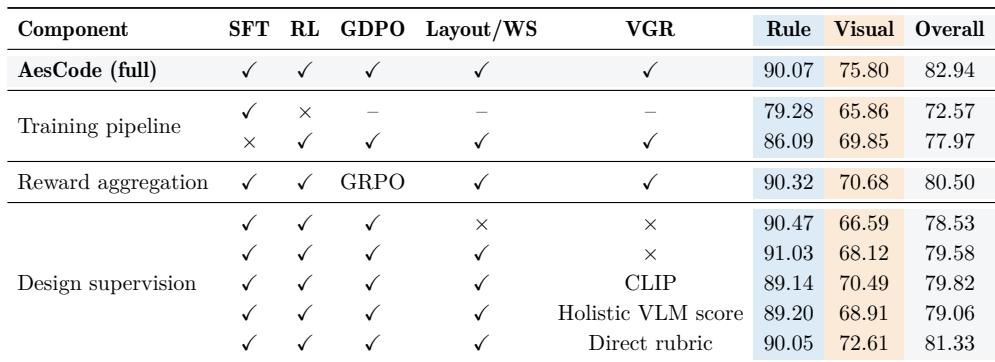
实验评估了信息图生成质量、向设计敏感基准的外部迁移、对参考图像移除的稳健性以及组件消融。闭源模型通常在规则类指标上得分高于视觉指标,风格是最薄弱维度;GPT-5.5 在视觉和布局/颜色迁移上领先,Qwen3-VL-32B 是最强的开放权重模型。参考条件化训练使 AesCode 在推理时对缺失参考图像更加稳健,表明参考图像既作为直接输入条件,也作为间接奖励监督都有帮助。消融实验表明 RL 带来的增益最大,而 VGR 和 GDPO 等设计监督比标量或整体式替代方案更能提升视觉质量,同时不牺牲规则合规性。