Command Palette
Search for a command to run...
自进化智能体 Harness
自进化智能体 Harness
Chuyang Wei Haoxiang Guan Minghang Zhu Kexin Zhou Jiyan He Xiren Zhou Huanhuan Chen Yifei Shen
摘要
Harness 自进化会修订智能体的软件脚手架,包括提示词、记忆、工作流和可执行组件,同时保持模型权重不变。我们将一个由反馈驱动的过程形式化,其中被接受的修订在多次运行之间持续保留。该框架将更新目标与提议及准入机制分离开,并区分对被解释状态的更改与对工具和代码、仓库级控制逻辑以及插件组合的修订。我们通过进化优化刻画搜索过程,并通过持续 PAC 学习检验其可靠性。在明确假设下,该分析给出期望泛化界、以历史回归预算为条件的保留界,以及使用全新独立验证数据的高概率准入规则。我们考察了持续的 Harness 修订如何影响知识共享和组织工作流,并分析其对科学可靠性、物理安全和机构问责的影响。先前工作中的案例说明了模型–Harness 协同设计、分布式执行和插件复用。可靠部署要求在任务分布和评估器变化时进行持续验证,并为学习、运行时权限和具有重大后果的行动设置独立防护措施。我们提供一份 66 页的综合性讨论,涵盖相关工作、理论、算法、评估、应用以及 Harness RSI 的更广泛影响;代码和补充材料持续更新,见 https://github.com/zgcagi/Harness-RSI。
一句话总结
来自中关村学院、中关村人工智能研究院和中国科学技术大学的研究人员提出了 Self-Evolving Agent Harness,它在保持模型权重固定的同时修改 agent 提示、记忆、工作流和代码,通过演化优化与 continual PAC-learning 将反馈驱动的持久更新形式化,并推导出泛化、保留和基于验证的准入保证,用于可靠的科学、物理安全和问责应用。
核心贡献
- 将 harness 自演化形式化为反馈驱动的修订过程,持续保留对提示、记忆、工作流和可执行组件的已接受更改,同时保持模型权重固定,并将更新目标与候选生成和准入机制分离。
- 区分了解释状态更改与工具和代码、仓库级控制逻辑以及插件组合的修订,并通过演化优化和 continual PAC-learning 分析搜索;在明确假设下,该分析给出期望泛化界、以历史回归预算为条件的保留界,以及使用全新独立验证数据的高概率准入规则。
- 给出了模型-harness 协同设计、分布式执行和插件复用的案例说明,以及部署和更广泛影响分析,要求在分布和评估器漂移下持续验证,并为学习、运行时权限和后果性行动提供独立保障;包含 66 页的论述以及持续更新的代码和补充材料。
引言
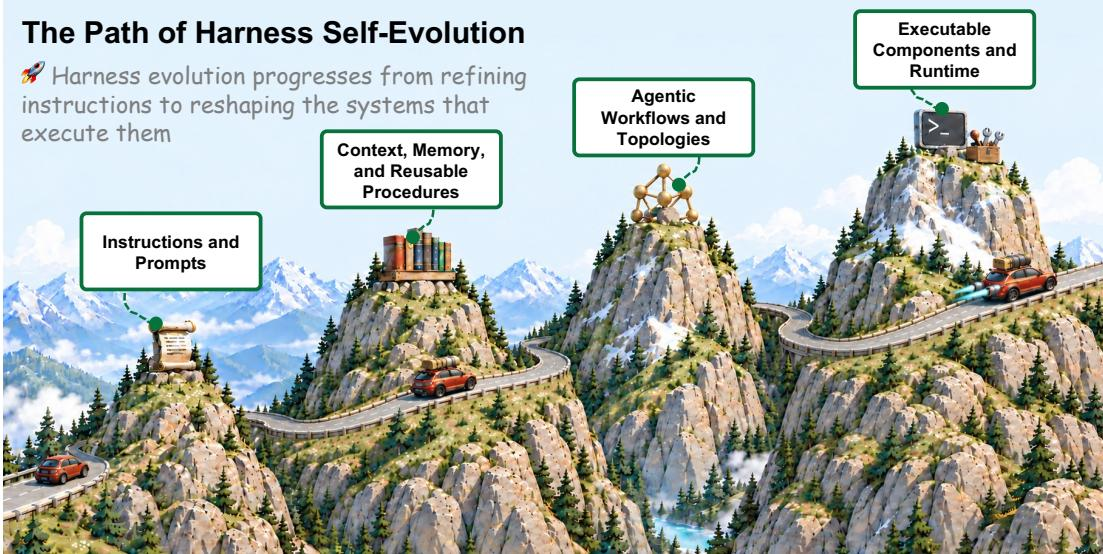
作者通过研究 harness 自演化来解决已部署 agent 的持续适应问题,其中执行反馈会围绕固定模型修订软件和配置,包括提示、记忆、工作流和工具。这之所以重要,是因为 harness 级适配能够复用现有模型部署,避免重新训练或访问权重,可配合专有 API 使用,并支持直接检查、版本管理和变更跟踪。先前工作在修改对象、候选生成方式和修订准入方式上各不相同,而仅凭经验选择并不能确立泛化或保留。作者的主要贡献是一个形式化框架,该框架定义了持久的反馈驱动生命周期,按变异边界对解释状态更新和可执行修订进行分类,从稳定性和集中性论证推导出条件泛化和有界回归结果,并分析了传播、修复负担、持续验证和安全控制等系统影响。
方法
作者将 harness 自演化组织为不同的可执行目标,并按组件实现、仓库级控制逻辑和插件组合对其分类。组件级修订将变异限制在可调用过程或指定模块内,同时将周围的编排保持在可编辑范围之外。仓库级搜索将上下文构建、编排循环、执行钩子、恢复和终止暴露给修订,重点关注对 harness 组件之间交互的控制。插件架构通过声明式接口、依赖约束和生命周期操作来组织变异,使可编辑对象可以是一个组件实现,也可以是决定哪个实现提供运行时服务的绑定。
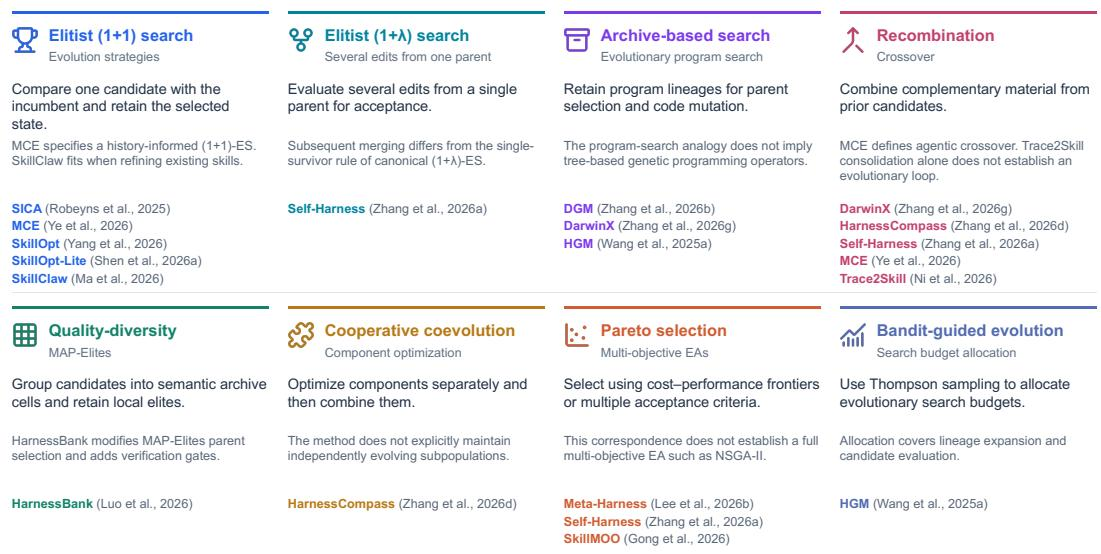
为了刻画这些更新的搜索结构,作者采用演化算法的视角,将其分为四个方面:可变状态的表示、生成编辑的变异、对其适应度的评估,以及保留状态的选择。局部精英策略将搜索集中在当前最优解附近,基于档案的多样性保留备选谱系,Pareto 选择平衡相互竞争的目标。
如下图所示:
由于这些机制基于经验适应度进行选择,已接受的修订可能会过拟合或遗忘。为了解决这个问题,作者使用 continual PAC-learning 视角建立了一个用于泛化和保留的理论框架。令 Xk 记录第 k 轮后的 harness、技能、档案和反馈记忆,其中 Hk=Deploy(Xk) 且 Xk=Ak(Xk−1,Dk;Uk)。为满足稳定性,假设 Dk 包含 nk 个从外生分布 Dk 中抽取的任务。对执行随机性取平均后的损失定义为:
Rs(H)=Ez∼Dsℓ(H,z),Rs(H)=ns1i=1∑nsℓ(H,zs,i).算法稳定性将任务敏感性与泛化联系起来。通过用独立抽样替换一个任务并重新运行下游更新,该界控制了期望泛化差距的大小:
E[Rs(Hk)−Rs(Hk)]≤βs,k.为了管理保留和累积回归,作者定义 Fs,k=Rs(Hk)−Rs(Hs)。假设每次后续转移满足一个回归预算,通过累加可得:
ERs(Hk)≤ERs(Hs)+βs,s+u=s+1∑kεs,u.新候选者的准入需要全新验证。令 Rˉk(H)=k−1∑s=1kRs(H) 表示均匀历史混合上的风险。对于候选 H′,使用 Hoeffding 界对配对差异进行界定:
Δk(H′)≤Δk(H′)+m2ln(KT/δ).只有上界为负的候选者才会被接受。如果评估器与目标风险之间的差异至多为 η,则目标风险改进的充分条件是:
Δk(H′)+m2ln(KT/δ)+2η<0.运行时修订既可能改变执行成本,也可能改变组件最适合部署的位置,这促使采用分布式执行策略。一项固定部署研究通过在混合工作负载下比较客户端、边缘服务器和云环境来说明通信权衡。客户端-边缘执行会对专家网络进行划分并压缩与任务相关的特征,而仅边缘基线则传输无损压缩的输入图像。
如下图所示:
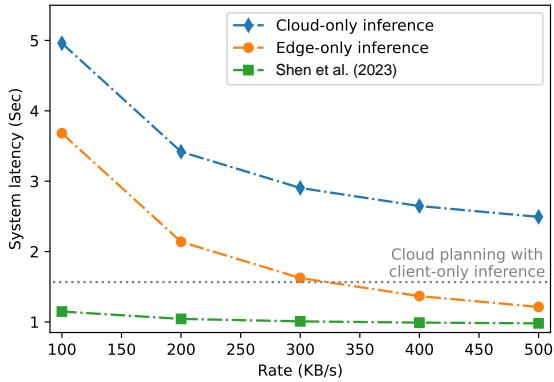
客户端-边缘协同推理在不同网络速率下最小化延迟。未来的系统设计在跨网络条件和更新频率比较部署选择时,必须纳入 harness 合成、验证和分发成本。
实验
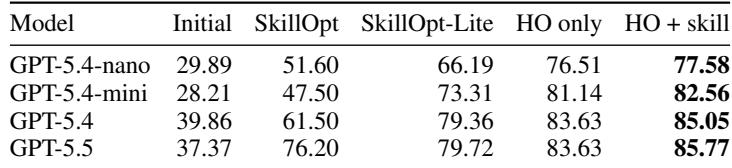
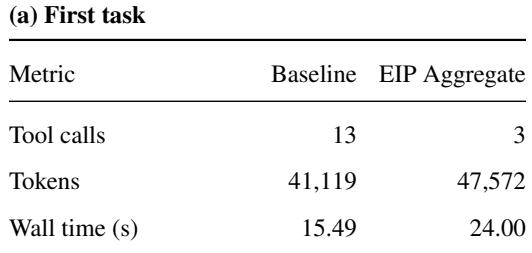
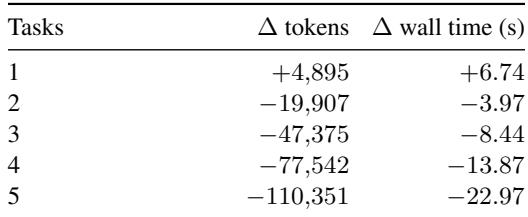
实验评估了两种形式的 harness 自演化:通过 HarnessOpt 进行的运行时修订,以及在 DSH Everything 下通过 Codex 插件进行的动态工具生成。HarnessOpt 在电子表格基准上进行了评估,其中演化后的 harness 使较小模型超过了使用早期技能优化器的较大模型,这表明模型-harness 配对而非成本匹配优势。插件实验模拟了办公工作负载和一个实时浏览基准,表明生成的工具减少了工具调用,并可在初始开销后产生累积复用节省,尽管在没有重复匹配预算比较的情况下,成本轨迹和因果收益仍未得到解决。
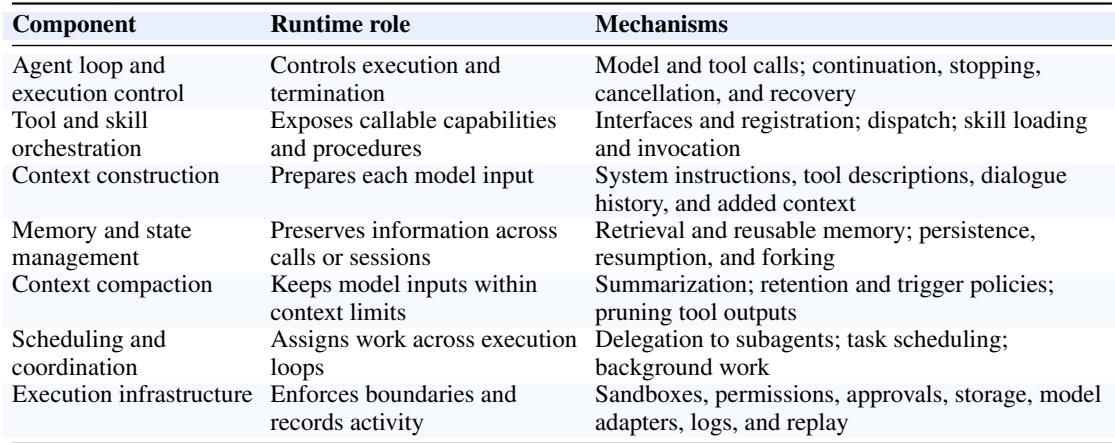
一个 harness 被分解为七个运行时函数,这些函数在任务环境中管理模型执行,涵盖执行控制、工具和技能编排、上下文准备与压缩、记忆与状态管理、调度与协调以及执行基础设施。这些函数共同控制调用、上下文、记忆、委托和沙箱化执行,一个实现可以将它们组合在一起,而不必将每个函数分配给独立模块。Agent loop 与执行控制管理模型和工具调用,以及继续、停止、取消和恢复。执行基础设施通过沙箱、权限、审批、存储、模型适配器、日志和重放来强制执行边界并记录活动。
在全部四个模型上,SpreadsheetBench 准确率从初始基线到 SkillOpt、SkillOpt-Lite、HarnessOpt-only 和 HarnessOpt-with-skill 逐步上升。带技能的 HarnessOpt 为每个模型带来了最高准确率,相较 SkillOpt-Lite 提高约 5.7 到 11.4 个百分点。使用 HarnessOpt 和技能的最小模型超过了仅使用 SkillOpt 的最大模型,这表明模型-harness 配对收益而非成本匹配优势。带技能的 HarnessOpt 是全部四个模型中最准确的配置,相较 SkillOpt-Lite 的提升幅度为 5.69 到 11.39 个百分点。使用 HarnessOpt 和技能的 GPT-5.4-nano 达到 77.58%,超过使用 SkillOpt 的 GPT-5.5 的 76.20%,表明 harness 修订可以弥补该基准上的模型规模差异。
与基线相比,EIP 配置显著减少了首个任务的工具调用,但增加了首个任务的 token 使用量和墙钟时间。累积结果提示首个任务之后可能存在复用节省,但首个任务累积值中未解决的差异使得两份报告无法合并为单一成本轨迹。首个任务的工具调用大幅下降,而 token 和墙钟时间成本在 EIP 下上升。累积数据表明从第二个任务开始出现节省,但首个任务的核算差异仍未解决。
累积比较显示首个任务出现初始 token 和墙钟时间增加,之后从第二个任务开始累积差异转为负值。节省随任务增长,在五个任务后达到最大累积减少量。首个任务总计与所报告累积首行值之间的差异使得两份报告无法被视为一条一致的成本轨迹。相对于基线,首个任务在 tokens 和墙钟时间上存在累积开销。从任务 2 开始,累积差异转为负值,节省在任务 5 之前持续增加。首个任务总计意味着比累积行报告更大的初始增加,因此两份报告无法合并为一条连续的轨迹。
LiveBrowseComp 结果将 XYZ + dsh-everything 列在所列 sub-40B 系统的首位,略微领先于 XYZ-Aquila-mini。其余 mini 规模参赛系统的分数稳步下降,所列最低系统远落后于领先者。分数单位未指定,因此该比较更适合视为相对排名。XYZ + dsh-everything 以小幅优势领先 XYZ-Aquila-mini,位居所示 sub-40B 组第一。其余系统呈现明显的分数下降趋势,最低排名条目远低于前两名。来源指出分数单位未指定,并且该系统在全部十一个报告系统中排名第二。
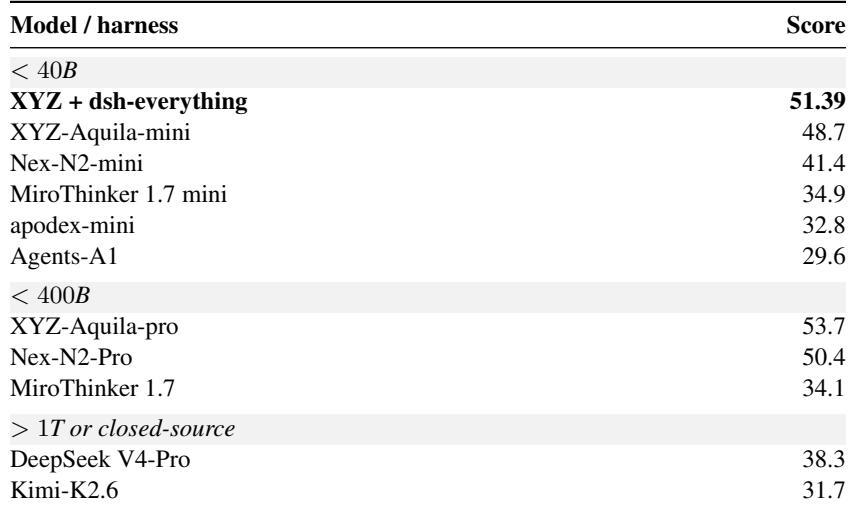
该评估研究了一个被分解为运行时函数的 harness,这些函数用于执行控制、工具和技能编排、上下文准备、记忆、调度和基础设施,然后在不同任务上测试优化后的配置。SpreadsheetBench 结果表明,带技能的 HarnessOpt 提高了全部四个模型的准确率,并且使用该 harness 的较小模型可以超过仅使用 SkillOpt 的较大模型,这表明模型-harness 配对收益而非规模效应。成本实验发现,EIP 减少了首个任务工具调用,但增加了 token 和墙钟时间,累积节省从第二个任务开始出现,尽管报告差异使单一一致成本轨迹无法成立。LiveBrowseComp 在 sub-40B 系统中将 XYZ + dsh-everything 排在略高于 XYZ-Aquila-mini 的位置,排名较低的系统落后,且分数单位未指定。