Command Palette
Search for a command to run...
GreenWAM:面向机器人的世界基础模型
GreenWAM:面向机器人的世界基础模型
Gennady Sidorov Valerii Kornilov Denis Grankin Polina Fedotova Aleksey Postnikov
摘要
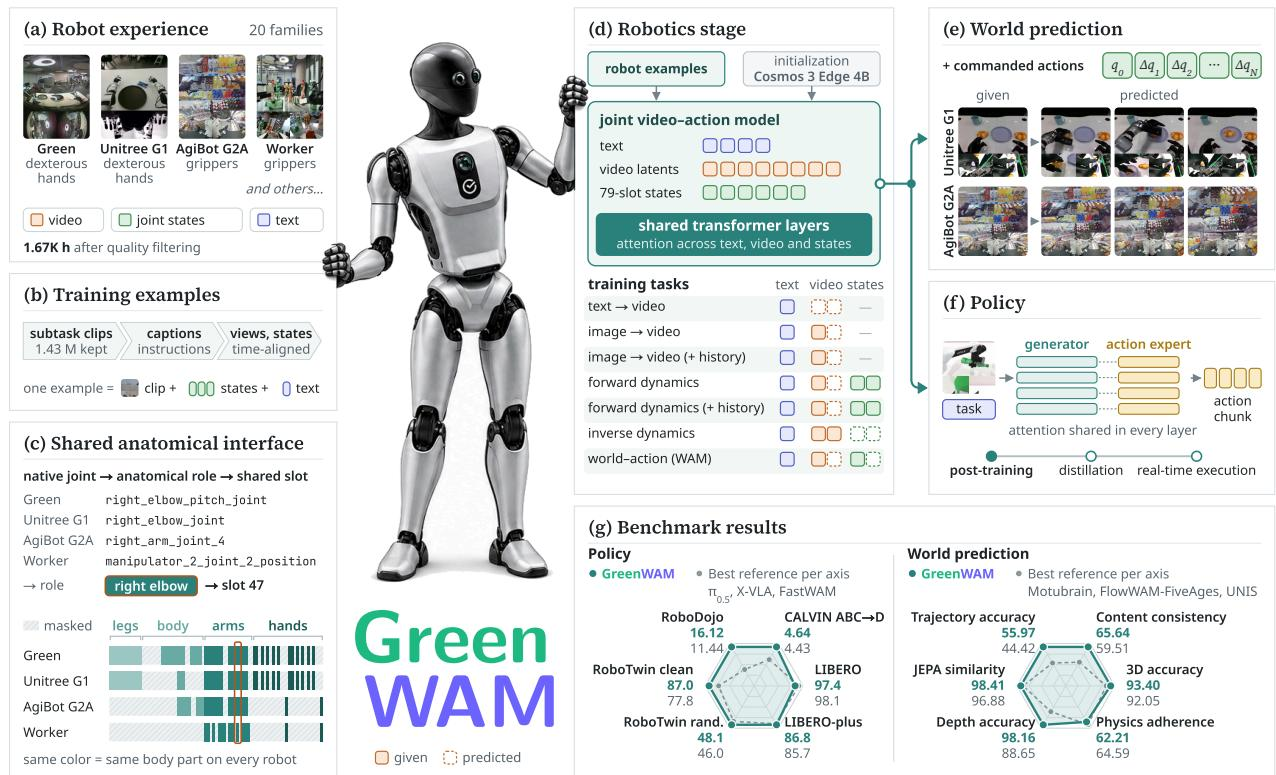
机器人需要一个能够预测其动作将如何改变场景的世界模型,以及一个选择这些动作的策略。模型通常仅针对其中一种角色进行构建和评估,而且每个机器人都以自己的格式记录动作。我们研究一个机器人世界模型是否能够跨不同机器人本体同时承担这两种角色,以及哪些因素使其可行。我们提出了 GreenWAM,一个面向机器人的世界基础模型,以及产生该模型的方案:(1) 一个共享的解剖动作空间,在通用关节坐标下描述 20 个机器人族,涵盖从双臂机械臂到灵巧人形机器人;(2) 在视觉、动作条件化和世界-动作模式下对这些机器人族进行联合训练;(3) 从生成器中分离出动作专家的策略。作为世界模型,GreenWAM 在 WorldArena 1.0 上取得了顶级的轨迹、深度和 3D 精度,领先于我们比较中的所有世界-动作模型和视频生成器。作为策略,它进入 RoboTwin 2.0 排行榜前列,在所比较的方法中取得了最高的零样本 LIBERO-plus 成功率,并在 CALVIN 和 LIBERO 上与专门的视觉-语言-动作和世界-动作策略具有竞争力。我们进一步将 GreenWAM 适配到真实人形机器人,在该机器人上,它比从 π0.5 和 Cosmos 3 Edge 适配得到的策略更常成功,并将其蒸馏为用于实时控制的单步策略。对照实验得出三个发现:机器人专门化同时改善世界预测与控制;在适配开始时分离出动作专家会有所帮助;在策略适配期间保留世界模型模式可保持对场景变化的鲁棒性。
一句话总结
Brain Team 与 Sber Robotics Center 提出 GreenWAM,一个面向机器人的世界基础模型,构建于覆盖 20 个机器人家族的共享解剖动作空间,并采用视觉、动作条件与世界-动作联合训练,以及从生成器分离出的动作专家策略;该模型在 WorldArena 1.0 上取得一流的轨迹、深度和 3D 精度,在所比较方法中达到最高的零样本 LIBERO-plus 成功率,并在真实人形机器人上优于从 π0.5 适配得到的策略。
核心贡献
- GreenWAM 是一个面向机器人的世界基础模型,通过共享解剖动作空间和在视觉、动作条件与世界-动作模式下的联合训练,将 Cosmos 3 Edge 适配到 20 个机器人家族,使单一模型同时充当世界模型和策略。
- 作为世界模型,GreenWAM 在 WorldArena 1.0 上取得一流的轨迹、深度和 3D 精度,领先所有比较的世界-动作模型和视频生成器;作为策略,其进入 RoboTwin 2.0 排行榜前列,在所比较方法中取得最高的零样本 LIBERO-plus 成功率,并在 CALVIN 和 LIBERO 上具有竞争力。
- 在真实人形机器人上,GreenWAM 的成功率高于从 π₀.₅ 和 Cosmos 3 Edge 适配的策略,并可蒸馏为以 28.3 Hz 运行的单步策略。受控实验表明,机器人特化、适配开始时分离动作专家以及保留世界模型模式是关键设计选择;同时发布用于 RoboTwin 2.0、LIBERO、CALVIN 和 WorldArena 模型的权重与评测代码。
引言
世界基础模型从大规模视频中学习场景如何演化,而世界-动作模型复用这些知识来联合预测观测和动作。对机器人控制而言,这一要求尤其高:模型必须既预测机器人运动时场景如何变化,又生成该运动本身,因此机器人身体的表示处于核心地位。以往工作受到限制,因为机器人数据分散在不同本体、关节布局、夹爪、灵巧手、相机、帧率和任务边界之间。现有模型通常通过逐本体的动作投影、末端执行器位姿或填充的关节向量来描述每台机器人,使跨身体的解剖对应关系隐式或缺失。作者提出 GreenWAM,这是一个从 Cosmos 3 Edge 通过共享解剖动作空间适配得到的世界基础模型:每个机器人的编解码器将关节映射到腿部、躯干、手臂和手指关节的公共槽位,并且单一模型在视觉、动作条件和世界-动作模式下联合训练。由此得到单一模型,通过一个动作接口在不同机器人身体上同时充当世界模型和策略,包括控制留出的 Franka 手臂和真实人形机器人。
数据集
数据集描述
作者将机器人经验数据集描述为跨本体语料库,由多个机器人来源构建,并准备为子任务级训练原子。
数据集构成与来源
- 语料库覆盖 20 个主要机器人家族,全部为双臂:
- 带平行夹爪的双臂平台
- 带夹爪或灵巧手的人形机器人
- 真实与模拟场景
- 它结合了:
- LeRobot 格式的公开机器人数据集
- 内部机器人数据集
- 作者的人形机器人数据
- 基本训练单元是 atom:一个来自单个 episode 的子任务片段,带有同步视图、测量状态、文本和来源信息。
- 论文第 A 节给出布局描述、准入规则和阶段数量。
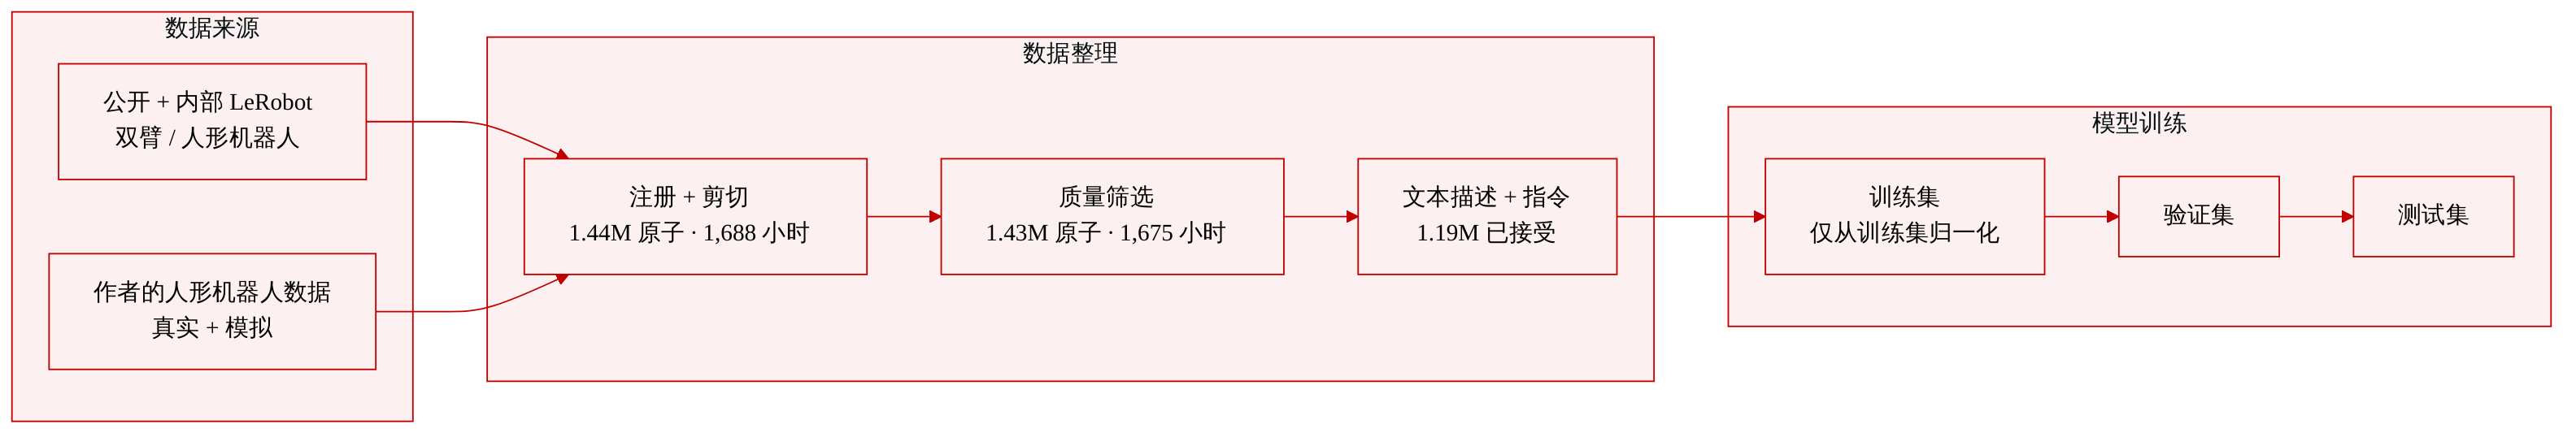
语料库规模与过滤
- 注册阶段首先为每个来源确定相机角色、状态布局和机器人属性。
- 将 episode 切分为 atom 后,得到准入语料库:
- 144 万个完整子任务 atom
- 1,688.5 小时
- 质量过滤保留:
- 143 万个 atom
- 1,674.7 小时
- 经过字幕和命令推导后剩余:
- 119 万个带有已接受命令的 atom
- 过滤规则包括:
- 语义子任务边界来自来源标注。
- 仅当 episode 没有更细的时间标注时,才整体使用该 episode。
- 排除模糊或不完整的边界。
- 过长的 atom 直接拒绝,而不是任意切成窗口。
- 移除空闲区间、重复帧段、时间切分和不可读片段。
- 对于依赖文本的训练模式,atom 还需要有已接受的字幕或命令。
文本与指令构建
- 视频字幕器 Qwen3.8-27B 为每个 atom 写入结构化字段:
- 主体、背景、光照、美学、上下文
- 尝试记录
- 带时间的动作阶段
- 时序字幕
- 一致性检查
- 来源任务标签提供预期目标。
- 注册事实确定本体、末端执行器类型以及真实或模拟域。
- 字幕器通过读取最后一帧而不是仅凭标签,记录尝试进行到了什么程度。
- 若字幕中的运动与标签中的物体和动作类型不匹配,则该字幕被拒绝。
- 第二个纯文本阶段将动作阶段转换为前瞻性命令:
- 保留观测到的运动、物体引用和阶段顺序。
- 包含部分或失败的尝试。
- 不补全片段中未展示的预期任务。
- 不接触原始数据集指令。
- 推导出的文本按训练模式以不同方式使用:
- 视觉模式使用视觉描述
- 前向动力学和 WAM 使用推导出的命令
- 逆动力学使用固定的轨迹恢复指令
视频、状态对齐与目标
- 每个来源的相机选择和顺序是明确的。
- 同步 RGB 视图被拼接到一个画布中,同时保留原始 episode 时间戳。
- 降帧率时选择对应的视频和状态时间,而不重新缩放物理关节位置或位移。
- 自回归样本连接完整的相邻 atom,并在被拒绝的间隙处停止。
- WAM 需要正面的成功标签:
- 失败、未知和未标注的结果被排除在 WAM 之外
- 它们仍可进入其他符合条件的模式
- 状态派生目标由测量状态通过公共轨迹编解码器构建:
- q_k = codec_l(s(t0 + Δ_k))
- 该编解码器将每种布局映射到共享解剖槽位
- 逆动力学预测绝对 q_k。
- 前向动力学和 WAM 使用来自已实现机器人运动的增量目标。
- 归一化统计仅在训练划分上计算。
训练混合
- 采样选择一个模式、一个机器人集群、一个数据集和一个窗口。
- Worker/ARX5 和 Green 人形机器人集群获得固定份额。
- 其他集群和数据集按其可接受的子任务数量的平方根加权。
- 每个来源只在其数据支持的模式中被采样。
方法
作者提出 GreenWAM,一个面向机器人的世界基础模型,在多种机器人本体上统一视频预测和动作生成。该模型从 Cosmos 3 Edge 4B 检查点初始化,采用 transformer 混合骨干,将冻结的推理器与训练得到的生成器耦合,并配合因果视频 VAE 和 rectified-flow 训练。以往方法通常依赖末端执行器位姿增量及本体特定投影,而 GreenWAM 在来自 20 个机器人家族的测量关节和笛卡尔状态上重新训练动作模式,并将它们映射到共享解剖动作空间。
如框架图所示:
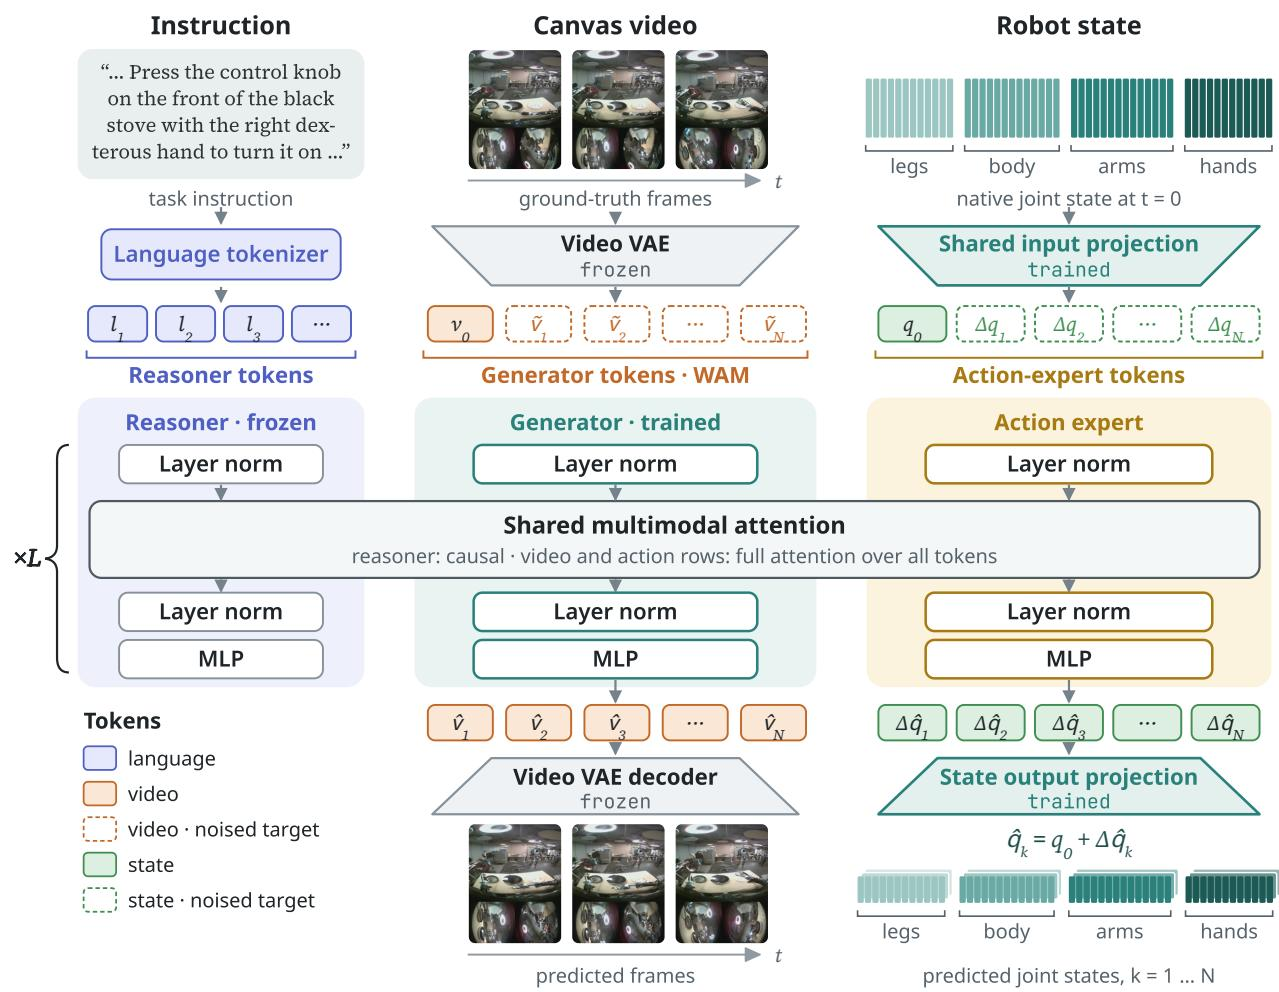
该架构处理任务指令、多相机视频画布和原生关节状态。布局专用编解码器在共享输入投影之前,将原生关节映射到共享解剖槽位。在标准 GreenWAM 配置中,状态和动作 tokens 通过主生成器。对于策略适配,动作专家从生成器中分离出来,单独处理状态和动作 tokens,同时保留与视频流的联合注意力。
参见动作表示与数据分布的对比:
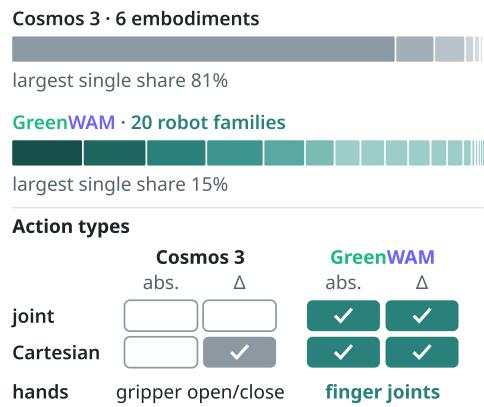
该对比突出了 GreenWAM 如何超越其前身的六个本体和夹爪开合动作,扩展到支持 20 个机器人家族,具备关节和笛卡尔表示,包括用于灵巧手的手指关节。
为了适应不同数据集之间状态布局、关节顺序和惯例的巨大差异,作者在投影之前建立共享解剖动作空间。布局专用编解码器将原生通道映射到 79 个解剖坐标,然后由单一共享输入和输出投影器处理。这确保特定槽位(例如左肘)在所有平台上对应相同的关节运动。该词汇表分为四个块:腿、身体、手臂和手。
共享解剖动作空间如下图所示:
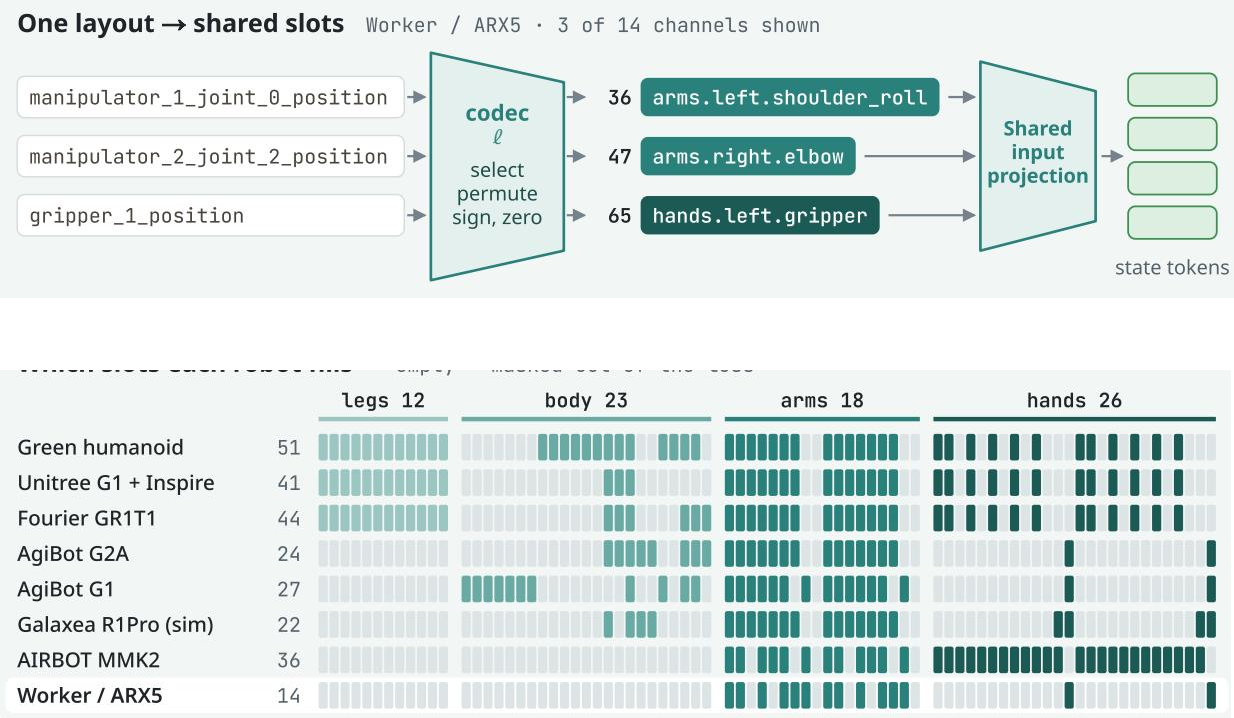
编解码器选择、置换并调整原生通道的符号和零偏移,以与共享槽位对齐。共享输入投影随后将槽位向量映射为状态 tokens。图中底部展示了不同的机器人布局(例如 Green 人形机器人和 Unitree G1)如何填充腿、身体、手臂和手块中的特定槽位,而空槽位在损失计算期间被掩码。
GreenWAM 在七种模式上联合训练,使一组生成器权重可以预测未来视频、机器人轨迹或两者。模式由哪些流作为干净条件、哪些流作为加噪目标来定义。对于模式 m,令 cm 为干净条件,Sm 为生成的流。所有生成的流共享噪声水平 σ,干净目标 x0 沿 rectified-flow 路径加噪。生成器预测速度 v=ϵ−x0,最小化损失:
Lm=Eσ,ϵs∈Sm∑λs∥Ms∥1∥Ms⊙(v^θ(xσ,cm,σ)s−vs)∥2其中 Ms 掩码有效元素,λs 对流加权。训练混合将四分之三的样本分配给视频预测,四分之一分配给通过逆动力学和世界-动作建模进行的状态生成。
数据管理流水线如下图所示:
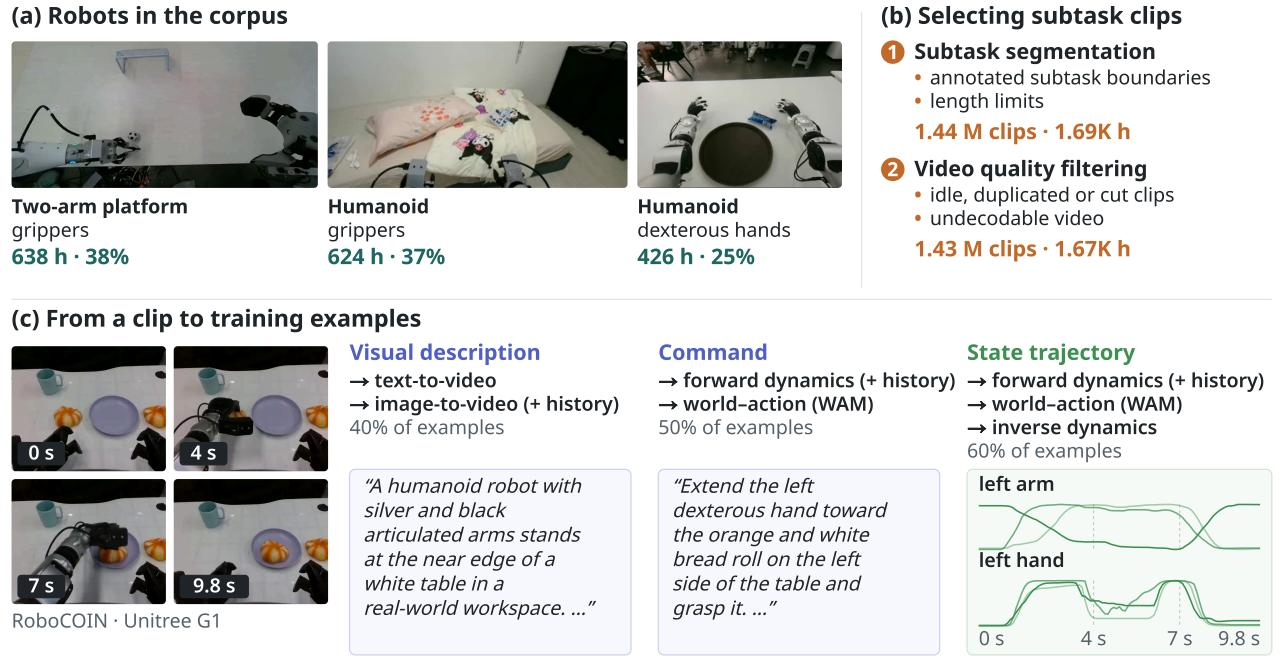
公开机器人数据集按阶段处理。Episode 在标注边界处切分为子任务片段,按视频质量过滤以移除空闲或不可解码片段,然后用于推导视觉描述和命令。状态轨迹服务于多种动作模式,既作为前向动力学的条件,也作为世界-动作预测和逆动力学的目标。
字幕和命令推导过程如图所示:
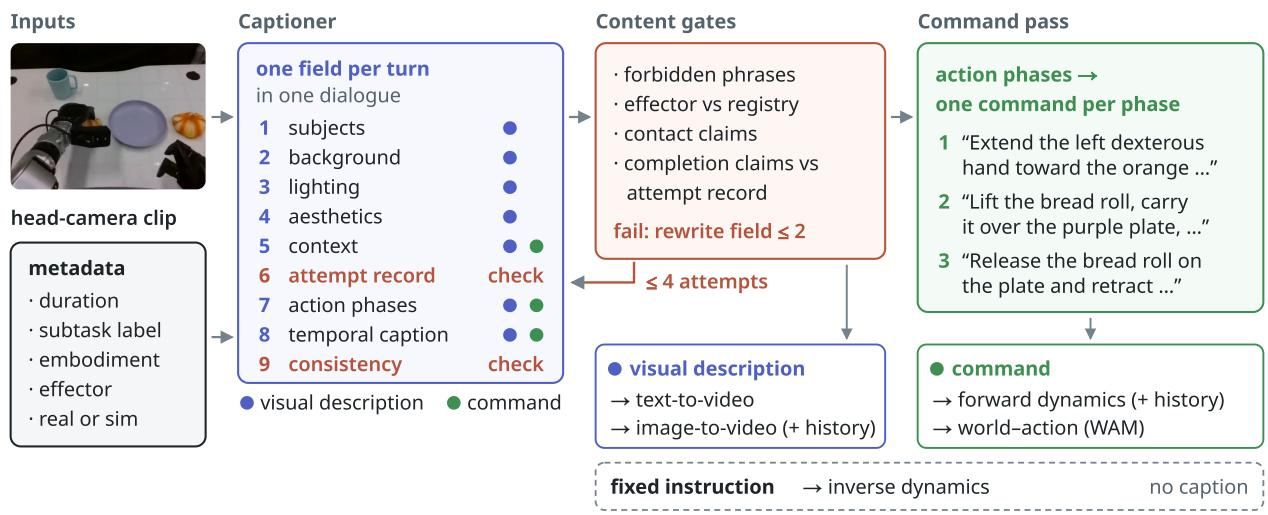
字幕器为每个片段生成结构化记录,包括主体、背景、动作阶段和一致性检查。内容门控根据尝试记录核查禁用短语和完成声明。随后的命令阶段将动作阶段转换为前瞻性命令,保留观测到的运动和阶段顺序。这些视觉描述作为文本生成视频模式的条件,而推导出的命令作为前向动力学和世界-动作预测的条件。
对于策略适配,作者将动作 tokens 拆分到专用 transformer 中,同时将视频 tokens 保留在生成器中。联合注意力在每一层连接两个流,使动作预测保持对视觉动态的访问。动作专家通过复制生成器塔进行初始化,两个塔在后训练期间逐渐分化。为实现实时控制,适配后的策略使用模态特定一致性目标蒸馏为单步学生模型,在保持任务成功率的同时显著降低推理延迟。
实验
实验在两个角色上评估 GreenWAM。作为世界模型,其在留出的机器人记录和 WorldArena 基准上测试,生成的运动遵循缩放后的动作命令,并在轨迹、深度和 3D 精度上在所比较的世界-动作模型中得分最高。作为策略,其被适配到 RoboTwin 2.0、CALVIN、RoboDojo、LIBERO 和真实人形机器人打包任务,取得较强的干净和随机化成功率、较高的零样本 LIBERO-plus 性能以及 95.6% 的分布内真实机器人成功率。受控消融表明,机器人特化初始化、独立动作专家以及保留世界模型预测模式均能提高策略成功率;保留视频预测主要提高对随机化场景的鲁棒性,因为分布外成功率与策略想象视频的精度相关。
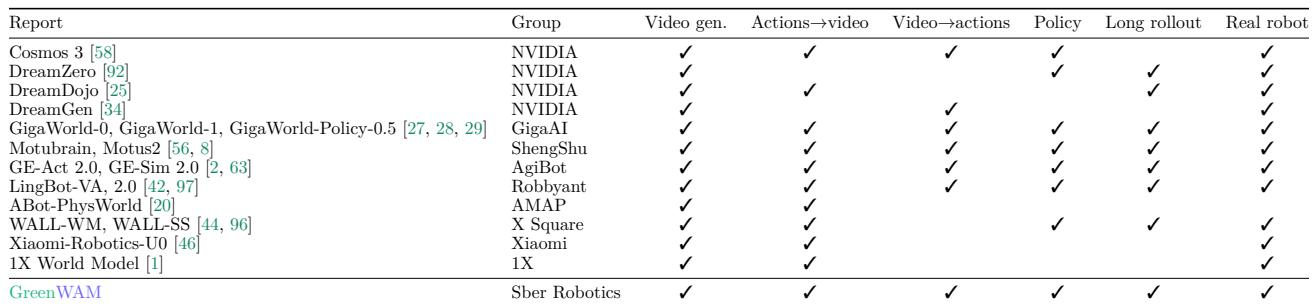
该对比按是否展示视频生成、前向和逆动力学、策略学习、长时 rollout 和真实机器人能力来分组近期技术报告。GigaAI、ShengShu 和 AgiBot 条目的六项所列能力全部被标记,而 NVIDIA 条目覆盖视频生成和动力学,但在策略、长时 rollout 和真实机器人支持方面有所不同。标记表示能力覆盖情况而非质量。GigaWorld、Motubrain/Motus2 和 GE-Act/GE-Sim 是仅有的每项所列能力均被标记的条目,包括长时 rollout 和真实机器人实验。Cosmos 3 在视频生成、动作条件视频、视频到动作、策略和长时 rollout 上被标记,但没有真实机器人;DreamZero 和 DreamDojo 的标记较少,DreamGen 在 NVIDIA 条目中最少。
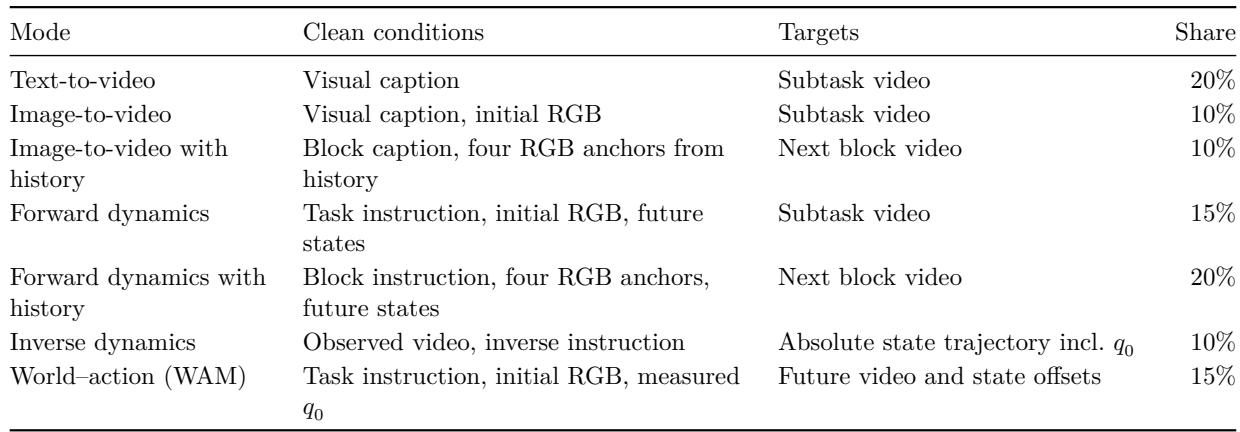
单一生成器在七种模式上训练,混合了视频生成、前向动力学、逆动力学和世界-动作建模。采样份额最大的是文本生成视频和带历史的前向动力学,而图像生成视频和逆动力学模式相对较少。世界-动作模式以任务指令、初始 RGB 图像和测量的初始状态为条件,预测未来视频和状态偏移。文本生成视频和带历史的前向动力学是采样最重的模式,合计占样本采样概率的 40%。世界-动作和没有历史的前向动力学各占 15%,图像生成视频、带历史的图像生成视频和逆动力学各占 10%。历史条件视频模式使用来自先前帧的四个 RGB 锚点作为干净条件。世界-动作模式从任务指令、初始 RGB 和测量的初始状态预测未来视频和状态偏移。
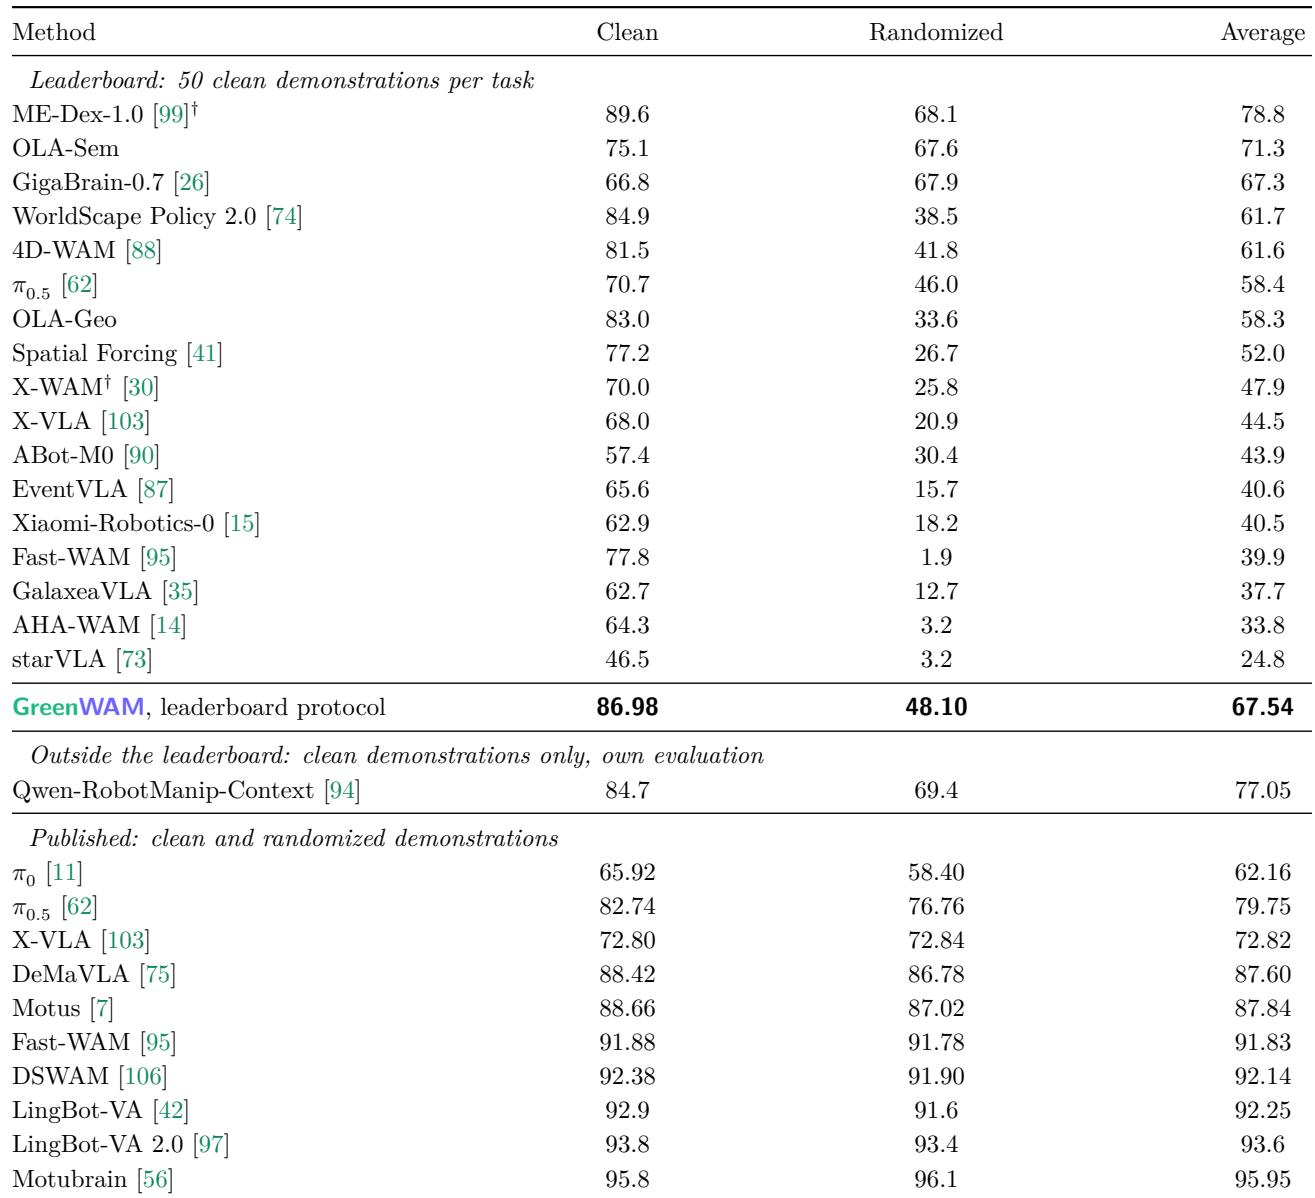
基准显示,干净成功率通常较高,但随机化成功率在不同方法间差异显著。ME-Dex-1.0 在所列条目中具有最佳的平均和随机化性能,而多个干净分数较高的模型在随机化条件下大幅下降。GreenWAM 达到具有竞争力的干净和平均成功率,但在最稳健的随机化性能方面仍落后。ME-Dex-1.0 在平均和随机化成功率上均领先所列方法,在随机化场景下的退化小于干净分数较高的替代方法。WorldScape Policy 2.0 和 4D-WAM 等模型在干净演示上表现强劲,但随机化成功率大幅下降,而 GreenWAM 具有强劲的干净和平均结果,但随机化成功率仅为中等。
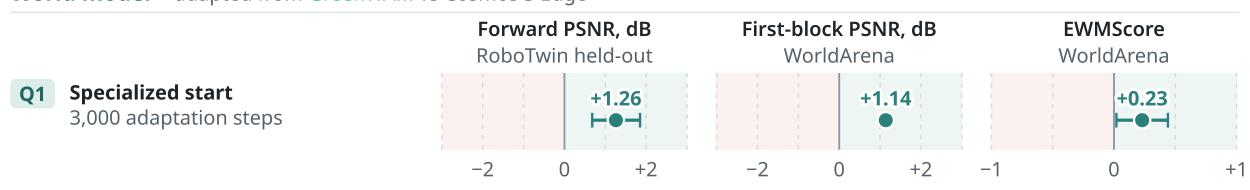
与对比项相比,进行 3,000 个适配步骤的特化启动改善了所有三项报告的评测指标。在留出的 RoboTwin 前向帧和第一块 WorldArena 帧上,预测质量获得约 1 dB 的提升,而 WorldArena EWM 分数提升幅度较小但为正。该模式符合更广泛的结论:更强的正向预测伴随更好的策略成功率。从世界模型启动进行特化适配,在留出的前向预测、第一块视频预测和 WorldArena EWM 分数上均带来正收益。两个帧预测指标提升约 1 dB,而 EWM 分数提升较温和但仍为正。
实验从视频生成、前向和逆动力学、策略学习、长时 rollout 和真实机器人能力方面比较技术报告;还考察了七模式生成器训练分布、干净与随机化策略成功率,以及从世界模型启动的适配。从定性结果看,只有 GigaWorld、Motubrain/Motus2 和 GE-Act/GE-Sim 覆盖所有所列能力,而 ME-Dex-1.0 在随机化场景下仍然最稳健,多个干净分数较高的方法退化明显。进行 3,000 个步骤的特化适配改善了前向预测和 WorldArena EWM,支持了更强的正向预测伴随更好策略成功率的总体结论。