Command Palette
Search for a command to run...
Jeva:从第一性原理出发的系统一模型
Jeva:从第一性原理出发的系统一模型
Qi Li Xinchao Wang
摘要
系统一模型支持直接、低延迟的决策。然而,近期从序列化文本中预测答案的做法本身并未尊重决策问题的结构。我们认为,当前设计对四项重要的结构要求重视不足:(i)空值感知(null-aware):模型应区分答案缺失与候选之间的不确定性;(ii)排列不变(permutation-invariant):重排候选项不应改变决策;(iii)选项可扩展(option-scalable):候选集增大不应要求重新定义输出空间;(iv)可缓存(cacheable):对重复出现的候选项进行的与请求无关的计算应当可以跨请求复用。我们提出了 Jeva,一种决策原生架构,可同时满足这些要求。共享编码器独立地表示请求和每个选项,而紧凑的决策栈仅基于不可变选项记忆来精化请求状态。对称聚合产生排列等变概率;共享评分可适配大小可变的候选集。单独的覆盖度估计将答案缺失与候选竞争区分开来,从而支持显式的空结果。与请求无关的选项表示和层投影支持跨新组装集合的复用。这些机制统一了 Choice、Noul 和 Score 输出。在多项评估中,Jeva 在具备强类型化决策性能的同时实现了近乎完美的空值检测,并且在所有测试排列下均未出现决策翻转。它可扩展到数千个候选,并借助跨请求复用在显著降低延迟的同时不改变决策。
一句话总结
新加坡国立大学的研究人员提出了 Jeva,一种决策原生架构,通过共享编码器、不可变选项内存、对称聚合和覆盖率估计,联合实现空值感知、排列不变性、选项可扩展性和可缓存性,从而取得强类型决策性能、接近完美的空值检测、无排列引起的决策翻转,并通过跨请求重用降低延迟。
核心贡献
- Jeva 是一种决策原生架构,通过独立编码请求和每个选项、根据不可变选项内存细化请求状态,并应用对称聚合与共享打分,联合处理空值感知、排列不变性、选项可扩展性和可缓存性。
- 该架构统一了 Choice、Noul 和 Score 输出,并用单独的覆盖率估计区分答案缺失与候选竞争,从而实现显式空值结果。
- 在使用 Qwen3.5-4B 骨干和一个决策块时,Jeva 取得强类型决策性能、接近完美的空值检测,并在测试的排列下没有决策翻转;它可扩展到 2,048 个候选,在全集打分上中位延迟加速超过 2 倍,在跨请求重用上超过 20 倍,且不改变决策。
引言
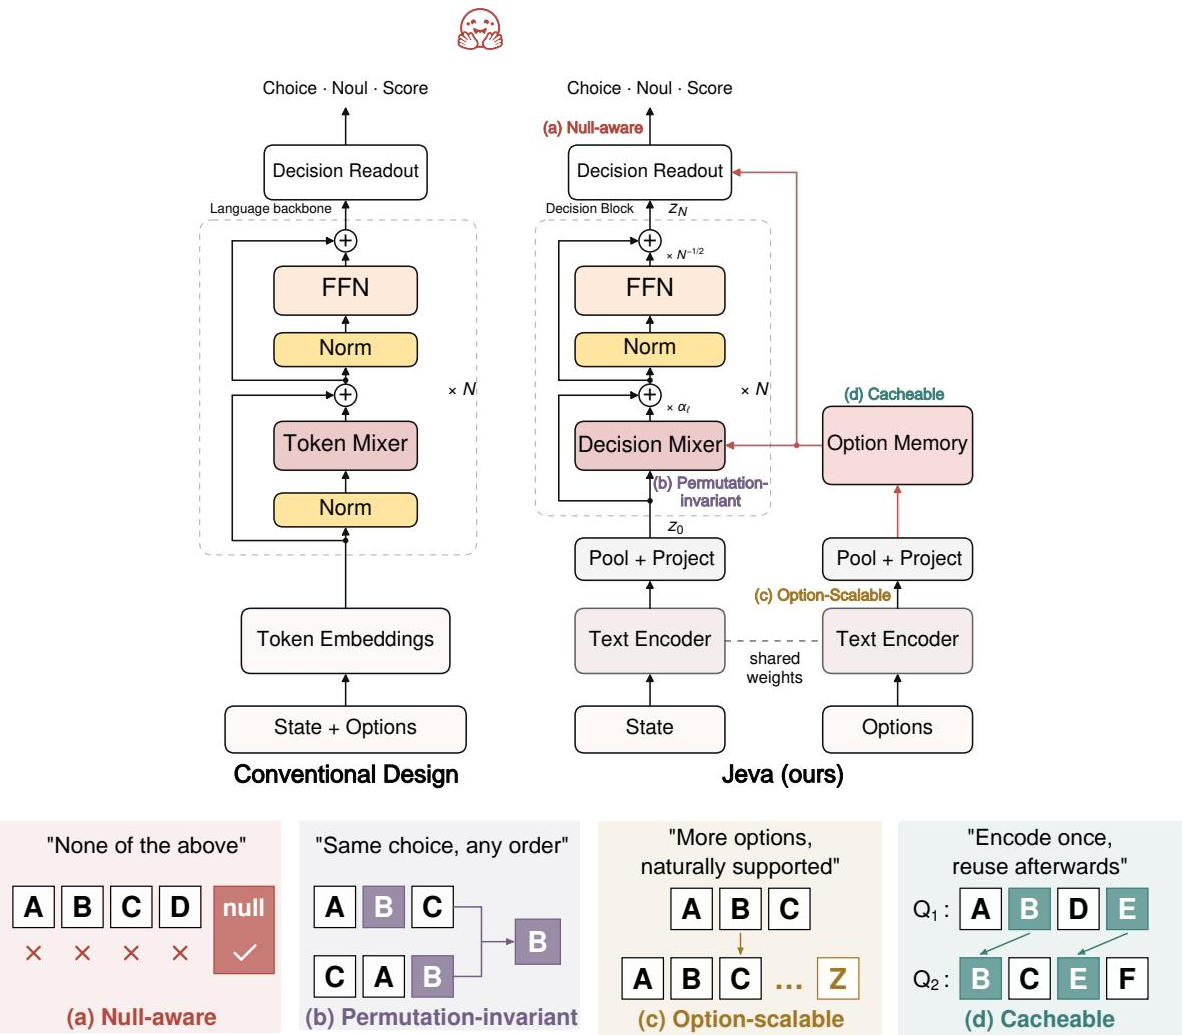
许多语言模型请求需要紧凑的类型化决策,例如选择工具、识别文档或分配分数。这些决策需要候选顺序对称性、对可变候选数量的支持、显式空值感知以及可重用的候选表示以降低延迟。先前的开源 system one 模型通常将请求和候选作为文本联合编码,这使候选表示与请求特定计算耦合,使预测对候选顺序敏感,通过固定输出空间限制候选数量,并且没有清晰区分答案缺失与备选项之间的不确定性。作者提出 Jeva,一种决策原生架构,使用共享语言编码器独立编码请求和每个选项,然后通过读取不可变选项内存仅细化请求状态。对称聚合、共享候选打分和单独的覆盖率门控提供排列等变概率、可变大小候选支持、显式空值检测和可重用选项计算。
方法
独立编码与集体决策
作者利用共享语言骨干分别编码请求和每个选项,将可重用语义编码与依赖集合的判断分离。紧凑决策模块仅根据不可变选项内存细化请求状态,在保留依赖集合打分的同时支持计算重用。
如下图所示:
一个请求包含状态 x、问题 ι、决策类型 t 和候选 O=(o1,...,oK)。输入使用两个文本模板格式化:Tx(t,ι,x) 组合决策类型、问题和状态,而 To(t,oi) 仅包含决策类型和候选文本。令 Eθ 为语言骨干,其后接最后一个非填充 token 池化。无偏投影给出:
z0=PxEθ(Tx(t,ι,x)),ui=nrm(PoEθ(To(t,oi))),其中 nrm 是稳定的 ℓ2 归一化,且 z0,ui∈Rd。U=[u1⊤;…;uK⊤] 的行在一次前向传递中保持不变。Jeva 使打分状态依赖于候选集合,通过紧凑的每请求计算支持偏好反转,同时保持选项表示可重用。
候选条件状态细化
L 个块中的每一个通过 H 个头读取 U。对于头 h,查询由状态派生,而键和值由选项派生。候选加权消息通过注意力计算:
aℓih=∑jexp((qℓh)⊤kℓjh/τℓ)exp((qℓh)⊤kℓih/τℓ),mℓ=WℓOConcath=1H(∑iaℓihvℓih).这些权重产生用于状态细化的候选证据熵正则化分配。状态经历两次残差更新:
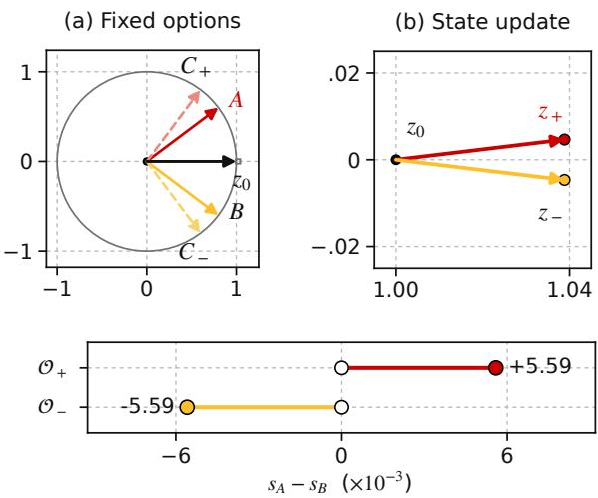
zℓ=zℓ+αℓmℓ,zℓ+1=zℓ+L−1/2Fℓ(RMSNorm(zℓ)),其中 Fℓ 是无偏 SwiGLU 网络,αℓ=τℓσ(γℓ)/L。只有 zℓ 演化;键和值仅依赖未改变的选项。这种设计允许单个块根据周围候选从同一集合中唯一选择不同选项,这是独立打分器无法实现的特性。
参见下图:
竞争、覆盖率与类型化输出
Jeva 计算最终分数 si=zL⊤ui 和条件候选概率 q=softmax(s/τdec)。为了形成候选和空值(⊥)上的完整分布 p,模型单独估计至少存在一个可接受候选的概率 ρ:
ρ=σ(τcovmaxisi−bcov),p⊥=1−ρ,pi=ρqi.其中 bcov 是学习到的覆盖率阈值,τcov>0 是学习到的温度。这实现了 P(Y=i)=P(Y=⊥)P(Y=i∣Y=⊥)。在已有最大值以下添加选项不会改变 ρ,从而区分覆盖率估计与候选分数归一化。
对称性、重用与扩展
原子选项内存同时存储条目语义向量和投影视图:
Mt(oi)=(ui,{kℓih,vℓih}ℓ,h).请求按当前候选顺序收集这些条目。集合缓存存储已组装的候选元组,而混合缓存还在新组装集合间重用单个选项。状态编码和决策细化仍会为每个请求执行。
如下图所示:
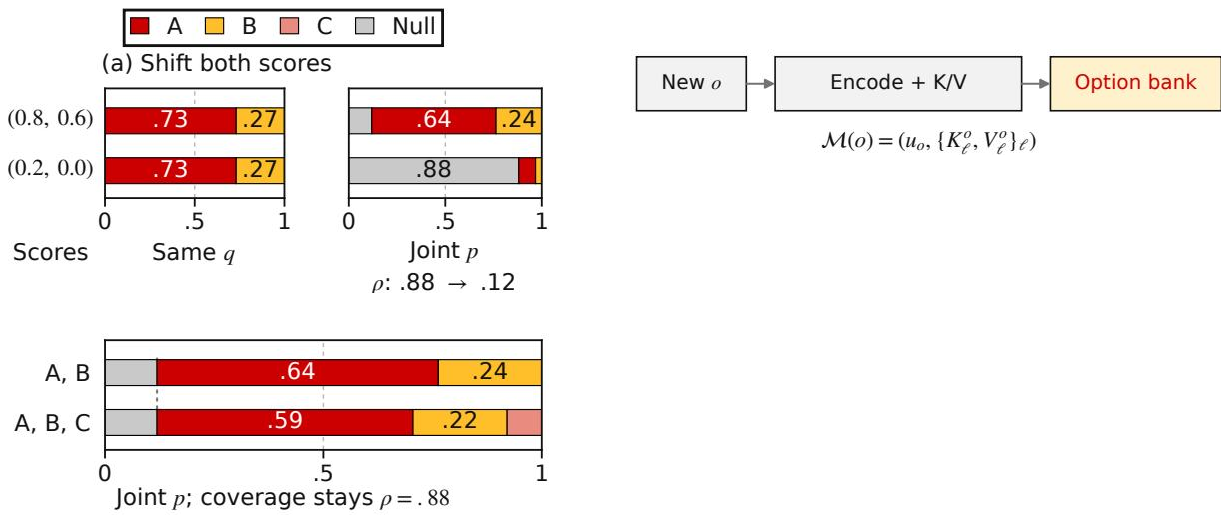
排列候选会相应排列候选概率,但保持 zL、空值概率和类型化输出不变。用相同的缓存条目替换选项计算也会保持所有输出不变。决策成本与 K 呈线性关系,M 个选项的存储为 O(M(L+1)d) 个值。
直接监督学习
对于归一化的开放集目标 (y⊥,y1,…,yK),令 cy=∑iyi 和 g=logit(ρ)。作者最小化:
ℓ=BCEWithLogits(g,cy)−i∑yilogqi.该主损失是 p 上的联合交叉熵:全空值样本监督可用性,而不施加虚假的候选排名。模型使用 Qwen3.5-4B 骨干,池化宽度为 2560,决策宽度 d=768,L=1,H=8,f=3072。训练采用 rank-64 LoRA,包括两个投影和决策头,使用覆盖类型化决策、意图选择、验证、阅读与推理以及大候选检索的课程。LoRA 在服务时合并,并为生成的固定模型准备内存。
实验
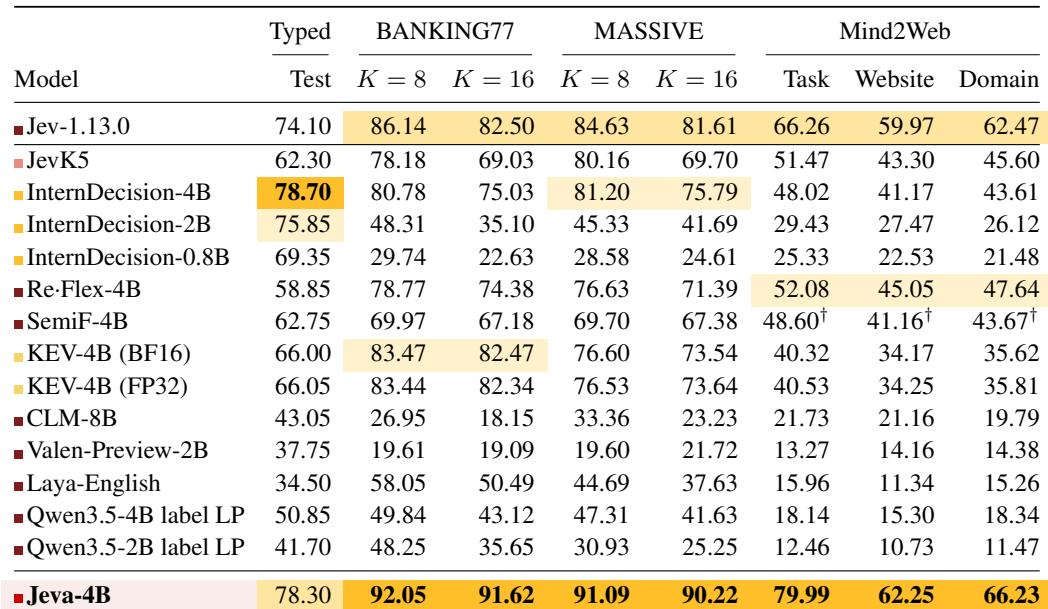
实验在 Typed Decisions、BANKING77、MASSIVE 和 Mind2Web 切片上评估决策准确性、空值检测、候选可扩展性、批处理效率和缓存重用。Jeva 表现出较强的全覆盖决策质量、接近完美的顺序不变性,以及对不支持请求的有效检测。它还通过单遍打分和长度感知批处理扩展到非常大的候选集,同时精确集合缓存和混合缓存保持决策并显著降低延迟。总体而言,结果验证了 Jeva 相对于基线在稳健性、覆盖率和效率上的优势。
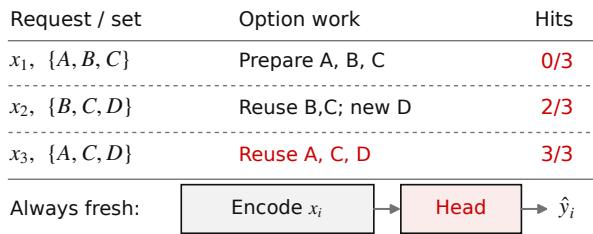
在固定模型、类型和编码策略下,初始为空的选项库开始时没有可重用的候选工作,随后在新请求与先前集合重叠时重用已准备的选项。全集合查找持续未命中,而逐选项重用跨重叠集合增长,状态编码和决策保持新鲜。重用从第一个集合无命中,到部分重叠集合的部分命中,再到完全覆盖集合的完全命中。仅重用先前已准备的选项;新选项按需准备且不驱逐。全集合缓存查找对每个新请求集都未命中,而状态编码和决策输出保持新鲜。
Jeva 在八个全覆盖决策切片中的七个上取得最高的第一 argmax 准确率,在 BANKING77 和 MASSIVE 的两种候选数量以及所有 Mind2Web 划分上领先。例外是 Typed Decisions,其中一个竞争模型排名更高。较小模型在 BANKING77、MASSIVE 和 Mind2Web 上大幅落后。Jeva 在八个全覆盖准确率切片中的七个领先,包括 BANKING77 和 MASSIVE 的两种候选数量以及所有 Mind2Web 划分。Typed Decisions 是 Jeva 唯一不是最高模型的全覆盖切片。若干较小模型在 BANKING77、MASSIVE 和 Mind2Web 上出现大幅准确率下降。
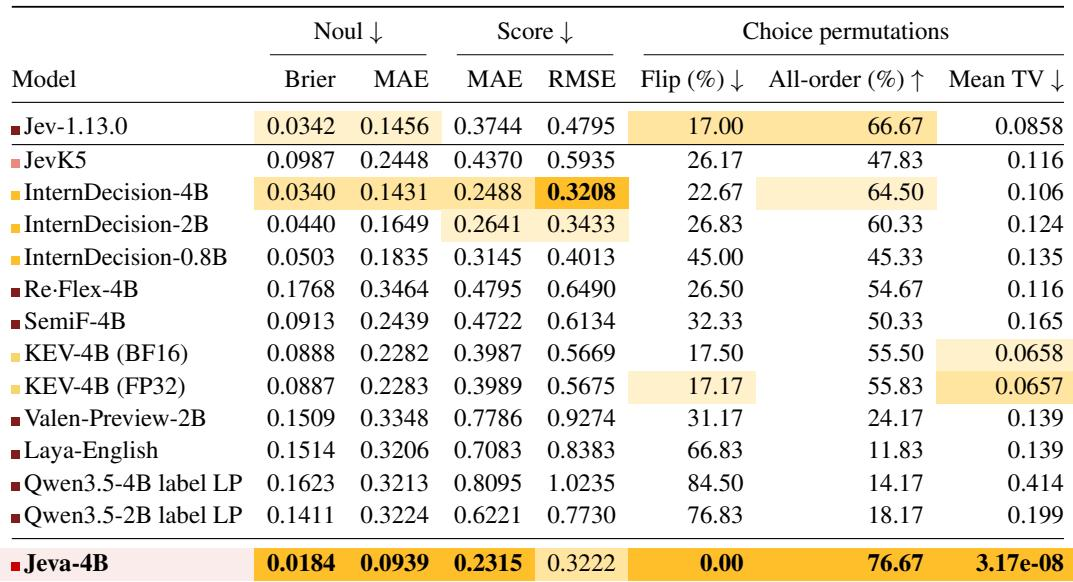
Jeva 在评估模型中表现出最强的类型化保真度和顺序稳定性。它在软目标上取得最低的 Noul 和 Score 误差指标,并在候选顺序变化中记录零决策翻转,而其他模型显示更高误差和非零翻转率。其余基线差异显著,较小变体和 Re-Flex 误差最大。Jeva 在软概率目标上取得最低的 Noul Brier 和 MAE,以及最低的 Score MAE 和接近 InternDecision-4B 的 Score RMSE。Jeva 在原始、反转和种子随机顺序上均无选择翻转,平均总变化接近零,原始准确率与全顺序准确率相同。Jev-1.13.0、InternDecision-4B 和 JevK5 显示顺序敏感性,翻转率在 17% 到 26% 之间,全顺序准确率降低。在其余基线中,InternDecision-0.8B 翻转率最高,而 Re-Flex-4B 的 Noul 和 Score 误差最大。
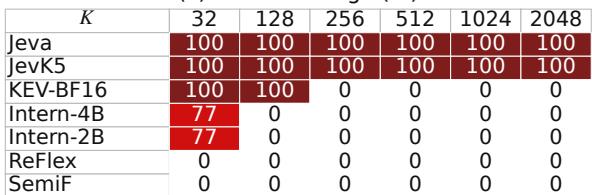
Jeva 和 JevK5 在所有候选数量分组中保持完整有效覆盖,而其他方法随着候选集增长很快变得不受支持。Jeva 还覆盖所有请求,且聚合准确率高于递归 JevK5,长度感知批处理在较大候选数量下大幅降低 p50 延迟且不改变决策。Jeva 和 JevK5 是仅有的在每个测试候选数量分组中保持完整有效覆盖的方法。KEV-BF16 支持最小分组,但在超过 128 个候选后覆盖率降至零,而 InternDecision 变体在 32 个候选时仅覆盖部分请求,之后没有覆盖。ReFlex 和 SemiF 在任何测试分组中都没有有效覆盖。Jeva 在单次决策头遍历中对完整候选集打分,聚合准确率高于递归 JevK5。长度感知批处理在保持准确率和顺序的同时大幅降低大候选数量下的 p50 延迟,在最大分组中约降低八倍。在候选集扩展测试中,Jeva 在每个规模上保持正确的查询数多于 JevK5 和 CLM,其全规模准确率也明显超过 JevK5。
实验评估了选项库重用、决策准确性、类型化保真度和顺序稳定性,以及跨候选数量的扩展行为。重用测试显示,全集合缓存查找始终未命中,而逐选项重用从第一个集合的无命中增加到覆盖集合上的完全命中,仅重用先前已准备的选项,决策保持新鲜。在基准和保真度测试中,Jeva 在八个全覆盖准确率切片中的七个领先,在顺序变化下记录零决策翻转,并显示最低的软目标误差,而较小基线准确率较低或顺序敏感性更强。覆盖率和延迟实验发现,Jeva 和 JevK5 是仅有的在所有候选数量分组中保持完整有效覆盖的方法,Jeva 比递归 JevK5 更准确,长度感知批处理在不改变决策的情况下降低延迟。