Command Palette
Search for a command to run...
Urbex:面向城市尺度 3D 场景的智能体式空间定位
Urbex:面向城市尺度 3D 场景的智能体式空间定位
Yu Wang Rui Dai Wei Chen Yi Wang Bo Dang Kaikui Liu Xiangxiang Chu Yansheng Li
摘要
城市尺度的 3D 定位通常被形式化为候选排序,这需要预先计算的实例候选区域,并且在大型户外场景中效率低下。我们提出 Urbex,一个智能体式视觉语言框架,将定位重新表述为主动空间搜索。Urbex 将城市尺度的 3D 场景表示为一个交互式多视角环境,使 VLM 智能体能够查询地标、放大到局部区域、渲染倾斜视图,并提交一个已定位的边界框。我们利用强化学习在 CityRefer 上优化该工具使用策略,采用平滑定位奖励和轻量级塑形奖励以实现高效探索。实验表明,Urbex 在 CityRefer 上取得了最佳的 Hit@1 和 IoU,支持无候选且无需真值框的定位,并且比最强的城市尺度排序基线快得多。在 STPLS3D-Refer 上的零样本结果进一步表明其跨场景鲁棒性有所提升。
一句话总结
武汉大学、DreamX 团队和阿里巴巴集团提出 Urbex,一个 Agent 式视觉语言框架,将城市尺度三维定位转化为交互式多视图环境中的主动空间搜索,使 VLM Agent 能够查询地标、放大局部区域、渲染倾斜视图并提交已定位的边界框;在 CityRefer 上使用平滑定位奖励和轻量塑形奖励进行强化学习训练后,Urbex 在 CityRefer 上取得最佳 Hit@1 和 IoU,支持无需真实边界框的无候选定位,并提升在 STPLS3D-Refer 上的零样本鲁棒性。
核心贡献
- 论文提出了 Urbex,一个 Agent 式视觉语言框架,将城市尺度三维定位重新表述为交互式多视图环境中的主动空间搜索;在该环境中,VLM Agent 可以查询地标、放大局部区域、渲染倾斜视图并提交已定位的边界框,而不是对预计算的候选实例进行排序。
- 论文在 CityRefer 上为工具使用策略开发了一种强化学习形式化方法,使用平滑定位奖励和轻量塑形奖励,在有限交互预算下鼓励准确且高效的探索。
- 实验表明,Urbex 在 CityRefer 上取得最佳 Hit@1 和 IoU,无需真实边界框即可进行无候选定位,运行速度显著快于最强城市尺度排序基线,并在 STPLS3D-Refer 上提升零样本跨场景鲁棒性。
引言
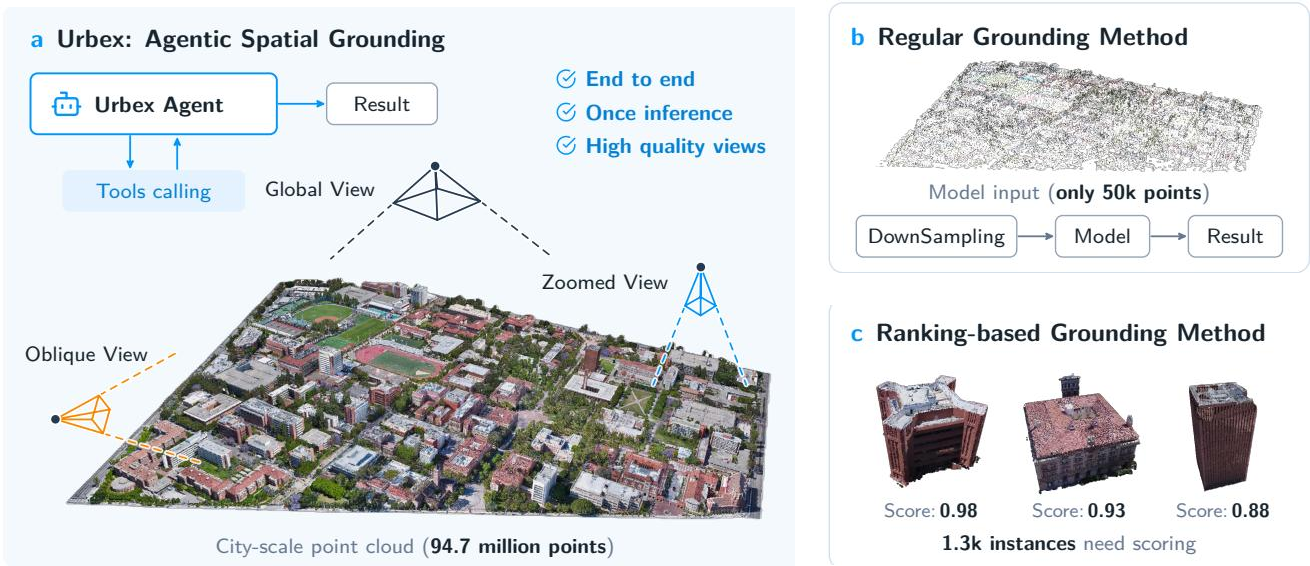
从自然语言中定位三维物体是具身智能的一项核心能力,可应用于自动驾驶、机器人导航和航空巡检。城市尺度定位尤其具有挑战性,因为室外场景包含数百万个点,查询通常需要对细粒度外观和长距离空间线索进行推理。现有室内方法对点云进行下采样并丢失关键几何信息,而城市尺度候选排序方法依赖预计算提议,推理成本随候选数量增长,并将定位退化为静态检索。作者提出 Urbex,一个 Agent 式框架,将城市尺度定位重新表述为主动空间搜索。视觉语言模型迭代地查询地标、放大到有希望的区域、检查倾斜视图以进行三维确认,并提交边界框;强化学习同时优化最终定位精度和中间搜索行为。
方法
方法
Urbex 将城市尺度三维定位形式化为主动空间搜索,而不是静态候选检索。作者通过少量坐标对齐的视觉观测来呈现大型三维场景,视觉语言模型可以对这些观测进行查看并采取行动。该方法包含三个主要部分:将城市尺度几何转换为 VLM 可操作的多视图空间的交互式环境;使用结构化工具调用的 Agent 式推理循环;以及学习何时及如何使用这些工具的强化学习目标。
面向城市尺度三维定位的交互式环境
给定城市尺度三维场景 S 和自然语言查询 q,目标是定位所指对象 o⋆ 并输出其空间范围。Urbex 不假设候选集并学习候选上的评分函数,而是在推理时不接收候选集。环境通过一组视图 V 呈现场景,Agent 可以通过工具调用扩展这些视图。策略在已知的鸟瞰视图对齐视图 v 中预测自由形式边界框 b^v,环境将该预测映射到世界空间边界框。真实边界框仅用于训练奖励和评估,不作为推理输入。
每个视图 v∈V 包含图像观测 Iv 以及从视图坐标系到世界坐标的映射 Tv。初始观测是全局鸟瞰图像 Iglobal。Agent 在归一化二维坐标系中表达边界框,环境维护相应的视图到世界变换。这为 VLM 提供了一致的空间接口,同时保持原始三维场景中的度量定位。
环境提供三种互补工具。地标查询解析命名地标,例如建筑或道路名称,并返回其世界位置以及在所选视图中的投影。当表达包含专有名词时,这支持全局空间锚定。放大将选定边界框映射到原始高分辨率鸟瞰图像,并返回带有新视图标识符和变换的局部裁剪。由于原始鸟瞰图像长边可能超过 10,000 像素,放大可以恢复下采样全局观测中缺失的细节。倾斜渲染从指定方位方向渲染选定候选区域,生成具有三维感知的视图,有助于验证物体形状、高度和空间位置。倾斜视图用作辅助证据,而不是最终边界框提交的坐标框架。
使用多视图工具的 Agent 式推理
策略 πθ 是一个 VLM,接收当前观测 ot 和交互历史 ht。历史包含原始查询、先前的工具调用、返回的视图标识符、坐标约定和视觉观测。在每一步,策略生成推理轨迹和动作:
(thoughtt,at)∼πθ(ot,ht).动作 at 要么是结构化工具调用,要么是最终答案。工具调用可以指定地标名称、源视图、二维裁剪框、候选框或倾斜渲染方向。环境执行工具,并在历史中追加文本响应,以及可应用时追加新的图像观测。
该推理过程分解为全局搜索、局部观察和候选确认。Agent 首先解析表达,以在鸟瞰视图中识别目标属性和空间锚点,然后放大到有希望的区域以分辨小物体或密集的局部上下文,最后在俯视证据不足以进行三维验证时渲染倾斜视图。由于工具响应会被追加到历史中,模型可以回溯较早的视图,并在全局证据与局部证据之间切换时保持坐标一致性。该协议可以直接与提示式 VLM 一起使用,形成零样本工具使用基线,但搜索空间仍然很大。模型不仅要学习如何解释每个视图,还要学习何时查询地标、放大、渲染或停止。
面向主动空间搜索的强化学习
一个回合被建模为有限时域马尔可夫决策过程。状态由交互历史、当前视图和工具反馈组成。动作空间包括有效工具调用和最终答案提交。给定动作和场景,环境转移是确定性的,而轨迹层面的随机性来自策略采样。当 Agent 提交答案或达到最大助手轮数时,回合结束。
终止奖励使用提交的世界空间边界框 b^ 和真实边界框 b⋆:
Rterm=λiouIoU(b^,b⋆)+λdistexp(−τd(b^,b⋆))−λstepTmaxT.其中 d(b^,b⋆) 是地平面中的中心距离,T 是助手轮数,Tmax 是交互预算。IoU 项奖励精确定位。距离项即使重叠为零时也提供连续学习信号,这在大型城市尺度场景的训练早期很常见。步数代价抑制不必要的长轨迹。
除终止奖励外,轻量过程奖励会塑形中间工具调用行为:
R(τ)=Rterm+t=1∑TRtool(st,at).对于放大,当放大中心相比上一次放大更接近目标时,奖励为正;远离时奖励为负,并设置较小上限以防止其主导终止目标。对于倾斜渲染,奖励与渲染候选区域和目标区域之间的重叠成比例,同样作为塑形信号设置上限。无效工具名称、格式错误的参数、不可能的框以及工具执行错误都会获得负奖励。这些工具级奖励是来自真实标注的特权训练信号,绝不会包含在 Agent 的文本观测中,因此不会在推理时泄露目标信息。
Urbex 使用分组相对策略优化进行训练。为避免单独价值网络的内存开销,GRPO 直接从多个并发采样轨迹中估计基线。对于每个输入查询和初始环境状态,行为策略 πθold 采样一组 G 条轨迹 {τ1,τ2,…,τG}。在评估每条轨迹的累积奖励 R(τi) 后,按下式计算组内相对优势:
Ai=σR+ϵR(τi)−μR,其中 μR 和 σR 是该组奖励的均值和标准差。策略通过最大化裁剪后的 GRPO 目标进行优化:
JGRPO(θ)=G1i=1∑GTi1t=1∑Ti[min(ri,t(θ)Ai,clip(ri,t(θ),1−ϵc,1+ϵc)Ai)−βDKLi,t],其中 ri,t(θ)=πθ(ai,t∣si,t)/πθold(ai,t∣si,t),ϵc 是裁剪阈值,β 控制对参考策略 πref 的 token 级 KL 惩罚。
仅依靠该 RL 目标,而没有监督轨迹示范,模型在多视图环境中探索并学习特定于任务的工具使用策略。具体而言,它学习何时查询地标、放大区域应有多大、倾斜视图是否值得其步数代价,以及累积证据何时足以提交最终边界框。
实验
实验在 CityRefer 上评估 Urbex 的域内定位能力,并在 STPLS3D-Refer 上评估零样本跨场景泛化能力,同时在 With-GT 和 Without-GT 协议下与通用多模态模型、室内定位方法和城市尺度候选排序基线进行比较。Urbex 在大多数指标上取得最佳整体精度,同时比最强的排序基线快约十倍,并且能最好地迁移到未见场景,表明其学到了一种可复用的搜索策略。消融实验表明,每种工具,尤其是地标查询,以及每个奖励分量都有助于主动搜索,其中八轮预算提供了最佳精度效率权衡。进一步分析表明,模型受益于地理线索和有界验证,但其预测框可能仍大于目标,这促使进行后选择框细化。
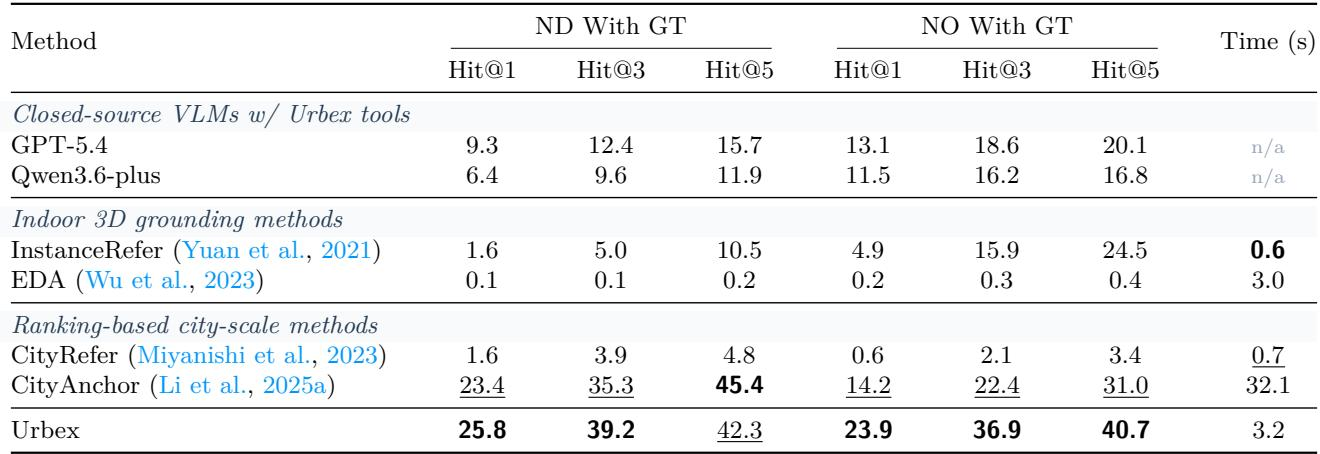
在 CityRefer 上,Urbex 在 with-GT 设置下实现了最强的无候选定位,在两个测试划分的 Hit@1 和 Hit@3 以及一个划分的 Hit@5 上领先。使用相同工具环境的提示式闭源 VLM 达到了一定精度,但仍远低于 Urbex;室内定位方法迁移到城市尺度场景的效果较差。Urbex 也显著比最强排序基线更高效,因为它检查少量有信息量的区域,而不是穷举地对大量实例评分。Urbex 在两个测试划分的大多数 with-GT 指标上领先,而 CityAnchor 仅在一个划分上保持最高的 Hit@5。具有工具访问权限的提示式闭源 VLM 比朴素使用有所改善,但仍远不及训练后的 Urbex 策略。室内三维定位方法在城市尺度输入上表现不佳,其中一个基线在点云下采样后在两个划分上几乎完全失败。在在线计时下,Urbex 比最强排序基线快一个数量级,因为它只对少量区域评分,而不是对所有候选实例评分。在 without-GT 设置中,候选排序方法进一步处于劣势,因为它们需要单独的提议生成阶段。
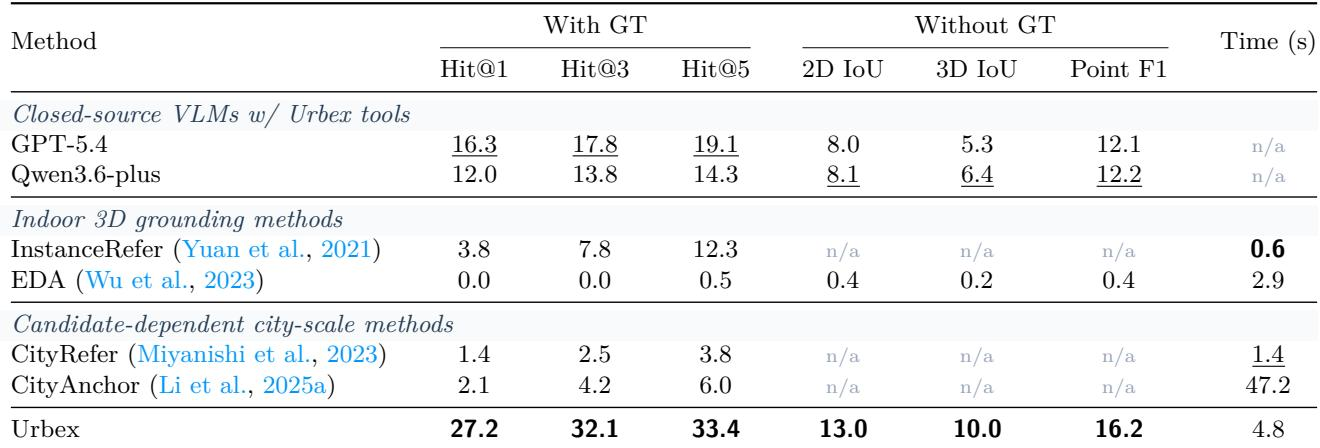
对于室内三维定位方法,零样本迁移到 STPLS3D-Refer 很困难,它们在域偏移下性能急剧下降。可以访问交互式工具环境的闭源 VLM 作为基线表现更好,但所提出的 Urbex Agent 在每个准确率指标上都优于所有报告的方法。重新标注结果为 Urbex 的迁移能力提供了补充证据,其目标识别能力强于所比较的基线。室内三维定位基线在 STPLS3D-Refer 零样本迁移上表现挣扎,EDA 的 top-1 准确率接近零,空间重叠非常低。使用交互式工具环境的闭源 VLM 是最强的报告基线,GPT-5.4 在 Hit@1、Hit@3 和 Hit@5 上均高于 Qwen3.6-plus。Urbex 在所有报告的准确率指标上领先,并且在未经进一步训练的情况下,对重新标注表达也表现出更高的 Hit@1。
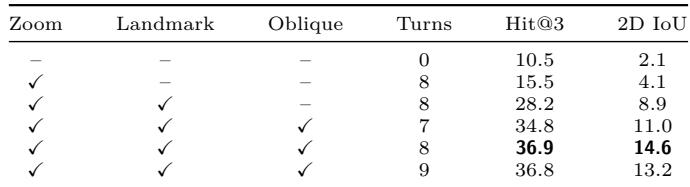
对 Urbex 的工具接口和交互预算进行消融表明,每个组件都对主动搜索有贡献。没有工具时,Agent 在目标识别和定位上明显更差;添加放大、地标查询和倾斜渲染逐步改善 Hit@3 和二维 IoU。将轮数预算从七轮增加到八轮会改善结果,但九轮没有带来进一步的目标识别收益,且定位略下降。单个工具收益最大的是添加地标查询,与仅放大相比,Hit@3 大幅上升,二维 IoU 翻倍以上。倾斜渲染通过在地标查询之后增加三维感知视觉验证,进一步改善结果。八轮预算提供最佳精度效率权衡;七轮表现不足,九轮在没有改善目标识别的情况下略微降低定位。
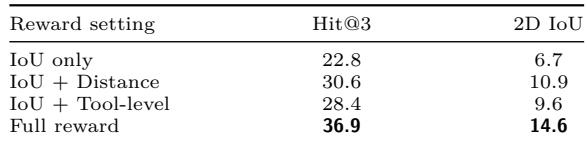
奖励消融表明,仅使用 IoU 奖励会产生最弱的目标识别和定位。添加距离塑形或工具级塑形均能改善这两项指标,其中距离塑形带来的单项增益更大。组合所有奖励项可获得最佳结果,表明定位质量、距离进展和稳定工具使用是互补的。在所有奖励设置中,完整奖励实现了最高的 Hit@3 和二维 IoU。距离塑形对两项指标的改善均大于仅使用工具级塑形。工具级塑形相比仅 IoU 仍有帮助,但影响小于距离塑形。
实验使用 CityRefer 以及向 STPLS3D-Refer 的零样本迁移,对 Urbex 的城市尺度三维语言定位进行评估,并与室内定位方法、候选排序基线以及可访问相同交互式工具的闭源 VLM 进行比较。Urbex 始终实现最强的目标识别和定位,同时通过检查少量有信息量的区域而不是穷举地对候选评分,保持更高效率。消融进一步表明,交互式工具,尤其是地标查询和倾斜渲染、八轮交互预算,以及结合距离项和工具级项的奖励塑形,都对 Agent 的主动搜索性能有所贡献。