Command Palette
Search for a command to run...
RoTA-Bench:通过交互式投影对齐评估 3D 空间推理
RoTA-Bench:通过交互式投影对齐评估 3D 空间推理
Qingchuan Ma Yuexiao Ma Xiang Meng Yixuan Zou Tianyu Xie Wang Chen Yuhui Zeng Yuhang Wu Xiawu Zheng Rongrong Ji
摘要
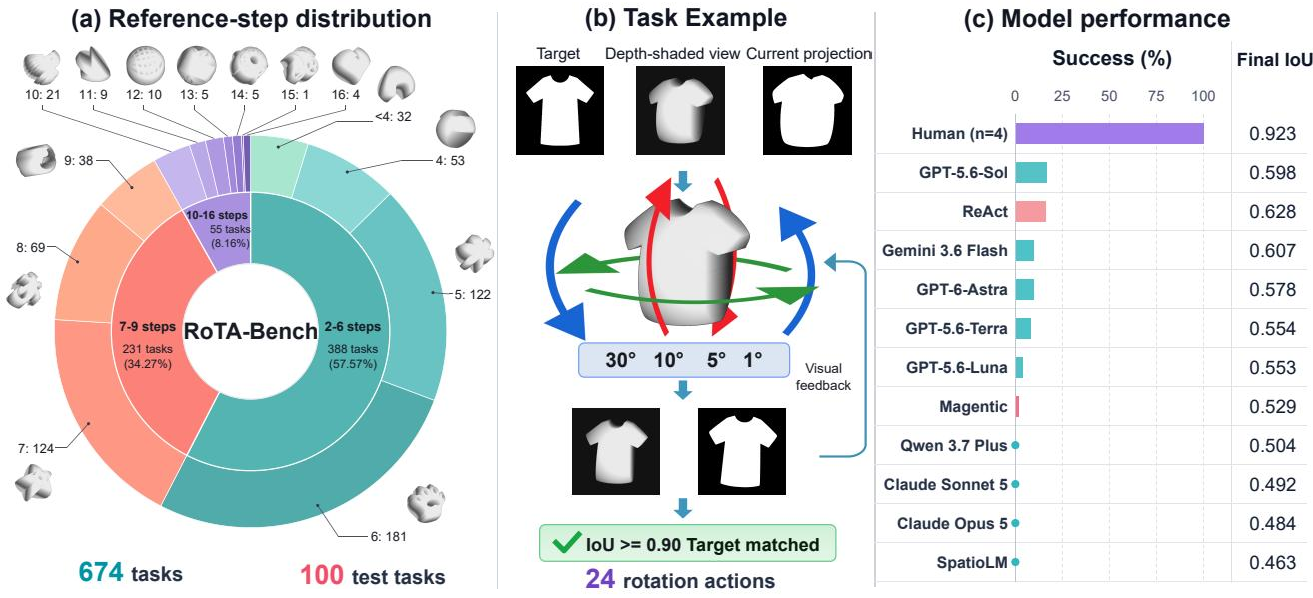
视觉-语言模型能否将 2D 观测转化为支持精确动作的 3D 理解?这需要推断物体几何形状、预测旋转的影响,并通过视觉反馈改进动作。我们提出 RoTA-Bench,通过交互式 3D 到 2D 投影对齐来评估这些能力。给定目标剪影,模型观察旋转后的物体,并在有限动作预算内选择一系列旋转动作,以恢复目标投影。我们的自动化流程从 2D 图标构建保持剪影的 3D 物体,并使用可逆初始化保证可解性,共产生 674 个任务和一个分层抽样的 100 任务测试集。实验发现:(i)人类与模型之间存在显著差距:GPT-5.6-Sol 仅在 17% 的任务上成功,而 20 名本科生参与者集体完成测试集四次,成功率达 100%;(ii)图像空间进展与位姿空间进展可能发生偏离:在匹配状态下,模型比人类更频繁地出现剪影重叠改善但位姿对齐恶化的情况(19.4% 对 10.9%);(iii)细粒度控制对交互历史敏感:若移除交互历史,模型 96.8% 的动作停留在 30 度粗步长上,观测到的任务成功率大幅下降。这些发现凸显了将视觉证据转化为精确 3D 控制的挑战,这超出了识别或匹配单张图像的能力。
一句话总结
来自厦门大学、南洋理工大学和多媒体可信感知与高效计算重点实验室的研究者提出 RoTA-Bench,一个交互式 3D 到 2D 投影对齐基准。该基准从 2D 图标构建保持轮廓的 3D 物体,并通过可逆初始化保证可解性;研究发现 GPT-5.6-Sol 在分层抽样的 100 个任务测试集上仅成功 17%,而 20 名本科生参与者达到 100%,暴露出在历史敏感的细粒度 3D 控制上存在显著的人类与模型差距。
核心贡献
-
RoTA-Bench 是一个交互式基准,用于评估视觉语言模型能否将 2D 观察转化为支持精确动作的 3D 理解,并通过闭环 3D 到 2D 投影对齐来执行动作。它从 2D 图标构建保持轮廓的 3D 物体,通过可逆初始化保证可解性,共产生 674 个任务和分层抽样的 100 个任务测试集。
-
GPT-5.6-Sol 仅成功 17% 的任务,而 20 名本科生参与者集体以 100% 成功率完成了测试集四次,揭示出显著的人类与模型差距。
-
图像空间和姿态空间的进展可能出现分歧:在匹配状态下,模型比人类更常在改善轮廓重叠的同时恶化姿态对齐(19.4% 对 10.9%)。移除交互历史后,模型 96.8% 的动作停留在粗粒度 30 度步长,并显著降低观测任务成功率。
引言
视觉语言模型正越来越多地被用于视觉问答、交互式 agents 和具身系统,这些系统必须将空间理解转化为精确的物理动作,但它们在 3D 位置、朝向和空间关系方面仍然表现不佳。现有静态基准通过被动的单轮问题评估空间推理,没有动作执行或闭环视觉反馈;而交互式基准往往偏重高层规划、工具使用或路径规划,针对离散轴对齐物体,而不是感知旋转姿态变化。为填补这一空白,作者提出 RoTA-Bench,一个自动构建的交互式 3D 到 2D 投影对齐基准。其流程将 2D 图标拉伸为 3D 物体,通过可逆旋转初始化方向以保证可解性,并要求模型在 24 个离散旋转动作中迭代选择,使物体轮廓与目标视图对齐,最终产生 674 个任务和分层抽样的 100 个任务测试集。
数据集
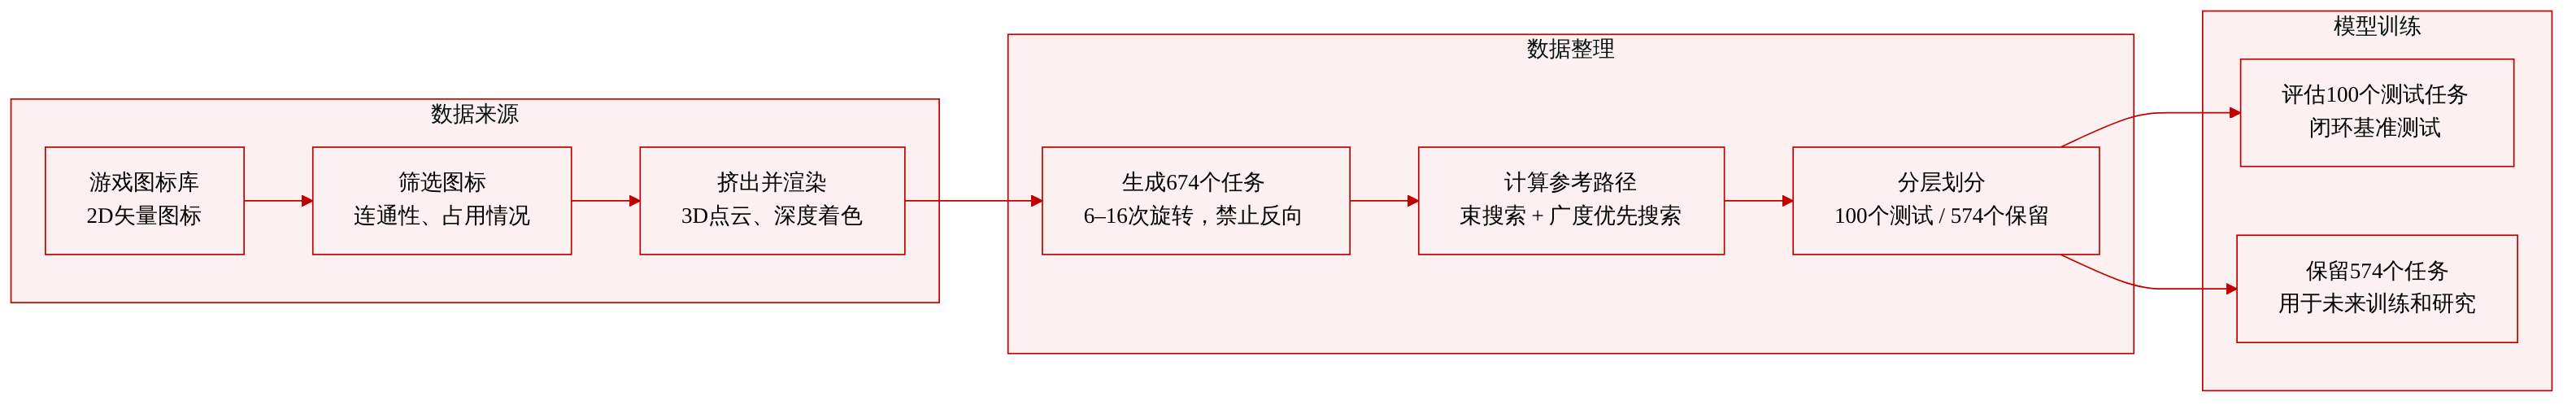
作者将 RoTA-Bench 构建为一个自动化基准,用于评估视觉语言模型能否将 2D 观察转化为 3D 理解以实现精确动作。数据集构建分三个阶段:任务生成、参考搜索和数据集构建。
-
来源与组成
- 2D 矢量图标来自开源的 Game-icons 库。
- 每个图标在根据连通性、占有率、宽高比和前景点数进行过滤后,被栅格化为高分辨率二值掩码。
- 平面图标点集被缩放至半径为 r 的圆盘内,并沿深度轴使用球形包络 h(x,y)=max(r2−x2−y2,0) 对称拉伸。
- 所得实体被离散化为密集 3D 点云。
- 视觉观测通过正交投影渲染,并带有随深度变化的明暗和高斯平滑,以提供单目深度线索并减少离散化间隙。
- 任务生成流程产生 674 个规范任务,每个任务来自唯一源图标。
-
关键子集细节
- 规范目标姿态固定为单位旋转。
- 初始姿态通过 6 至 16 次离散 30 度旋转生成。
- 旋转方向从六个候选相机方向中均匀采样,禁止立即反向旋转以避免相互抵消。
- 已经投影对齐的初始姿态被丢弃。
- 最终冻结的测试集包含 100 个任务。
- 测试任务使用比例分层抽样,在至少 4 步的参考路径长度上,通过 Hamilton 方法和确定性哈希排序选取。
- 其余 574 个任务保留用于未来训练和研究。
-
数据使用方式
- 论文使用 100 个任务的分层测试划分对视觉语言模型进行闭环评估。
- 参考路径通过姿态引导的束搜索和限制为 30 度的广度优先搜索计算,生成比原始逆生成路径更短的轨迹。
- 由于所有旋转可逆,执行逆生成序列可恢复规范姿态,从而在构造上保证 100% 可达性和可解性。
- 当前基准不使用训练混合比例;仅评估冻结的测试划分,其余任务保留用于未来工作。
-
额外处理细节
- 球形拉伸将每个旋转后姿态限制在 x2+y2+z2≤r2 内,避免视口裁剪,并在所有任务中固定相机缩放。
方法
作者将交互式投影匹配任务形式化,以评估视觉语言模型能否将 2D 观察转化为精确动作所需的 3D 理解。每个任务实例包含一个以原点为中心的刚体 3D 物体 G⊂R3、一个初始姿态 R0∈SO(3),以及规范目标姿态 R⋆=I3。在每一步 t,环境提供观测三元组 Ot=(I⋆,Vt,It),其中 I⋆ 是不变的目标轮廓,It 是当前投影轮廓,Vt 是带深度明暗的辅助视图,提供缺失的深度和遮挡线索。agent 从由 24 个相机固定旋转动作和一个终止 STOP 命令组成的离散动作集中选择动作 at。这些动作覆盖 pitch、yaw 和 roll,并具有四种步长,以支持粗调和细调。物体姿态按 Rt+1=Q(at)Rt 更新。任务成功由当前轮廓与目标轮廓之间的投影交并比(IoU)决定,要求 st=IoU(It,I⋆)≥0.90。
自动化流程通过三个连续阶段构建基准:任务生成、参考搜索和数据集构建。在任务生成阶段,2D 矢量图标被栅格化为二值掩码并转换为 3D 物体。为了在任意旋转下严格限制空间轮廓,平面点集被缩放到半径 r 的圆盘内,并在球形包络 h(x,y)=max(r2−x2−y2,0) 下沿深度轴对称拉伸。这种球形不变性避免视口裁剪,并在全局固定相机缩放。初始姿态通过一系列离散旋转生成,并且由于 SO(3) 中的每个旋转都可逆,执行逆序列可保证 100% 可达性和任务可解性。
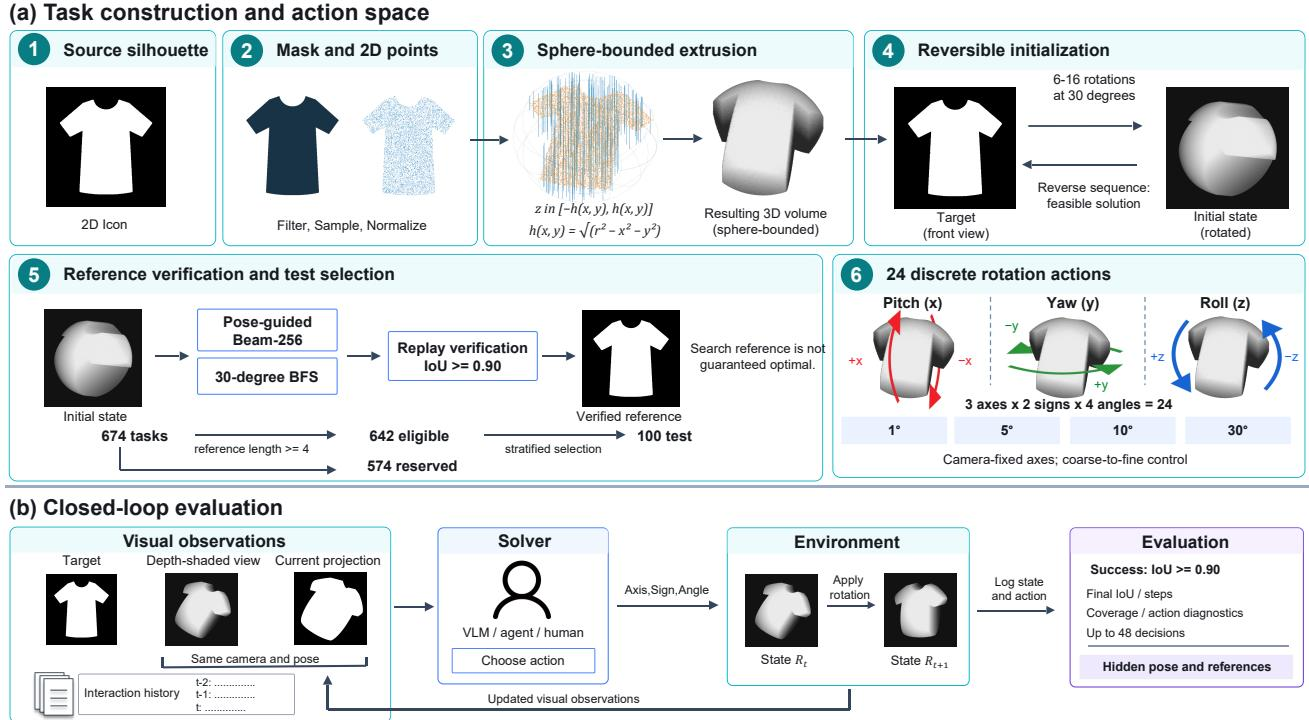
在参考搜索阶段,作者使用姿态引导的束搜索和 30∘ 限制的广度优先搜索计算参考路径,以发现远短于原始逆生成路径的轨迹。最后,按参考路径长度使用比例分层抽样冻结一个分层测试集。在闭环评估期间,求解器接收视觉观测和交互历史来选择旋转。环境应用所选旋转,更新 3D 状态并渲染新的观测。回合在达到 IoU 阈值、主动停止、达到最大动作预算或停滞时终止。
实验
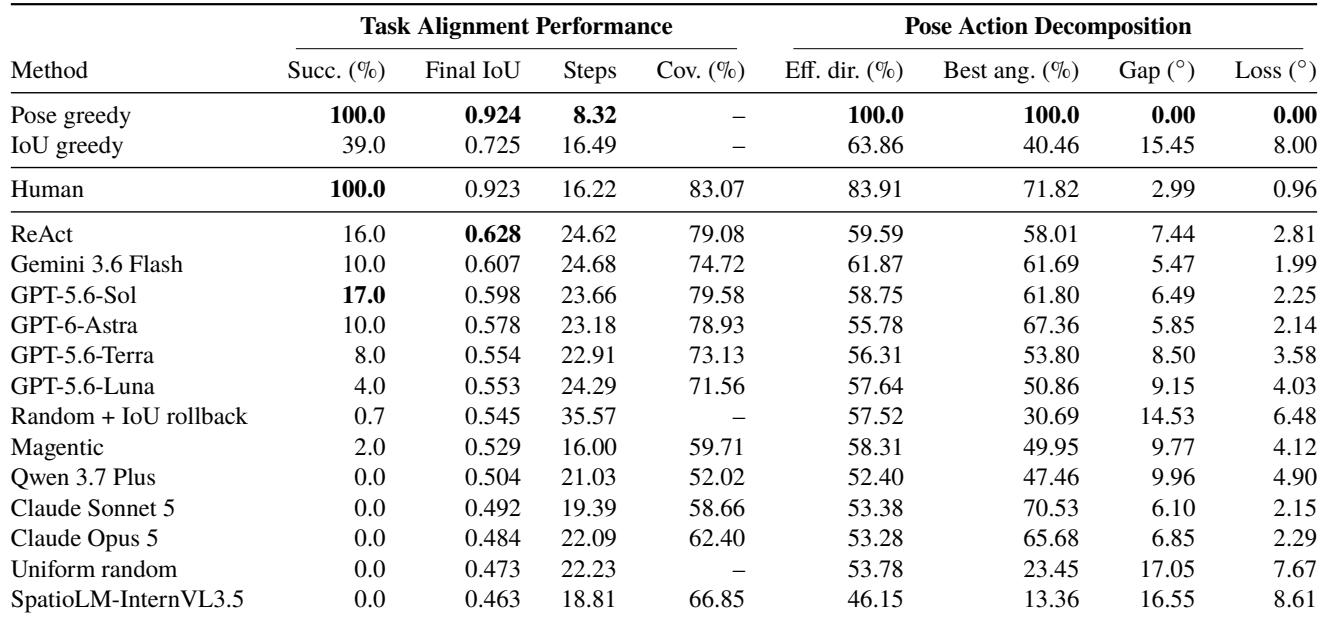
实验在 RoTA-Bench 上评估多个视觉语言模型、agent 框架、人类参与者以及随机或贪心基线的交互式 3D 投影对齐,使用任务成功率、IoU、姿态误差以及旋转方向和角度诊断。前沿模型表现不佳,而人类解决了所有任务;姿态贪心基线完全成功,而 IoU 贪心基线经常失败,表明可靠的 3D 姿态估计至关重要。失败分析显示模型看到了足够的表面,但在旋转方向和角度选择上不如人类有效;消融实验表明,移除交互历史会严重削弱细粒度角度控制。动作级比较进一步表明,模型更多依赖图像空间重叠,而不是底层姿态差异,人类则同时平衡两种信号。
人类参与者完成所有任务,最终重叠率高且动作选择准确,而最佳前沿系统成功完成不到五分之一的任务,最终 IoU 低得多。多个模型观察到的物体表面比例与人类相近,但动作选择更差:有效方向接近随机,角度精度较低。姿态贪心动作在相对较少步数内实现完美成功,突出当前模型动作选择与有效 3D 对齐之间的差距。人类表现几乎完美,但前沿模型仅达到个位数到十几百分点的成功率。多个前沿模型的视觉表面覆盖率接近人类,因此失败并非主要由于探索不足。前沿模型的有效方向率远低于人类,并接近随机选择。即使模型选择了有效方向,其角度也不如人类准确,角度差距更大,最佳角度率更低。姿态贪心基线以更少步数实现完美成功,而 IoU 贪心基线弱得多,表明姿态感知的动作选择至关重要。SpatioLM-Understanding-InternVL3.5 出现策略崩溃,大多数动作退化为一个重复的 yaw 动作,最终 IoU 低于随机探索。
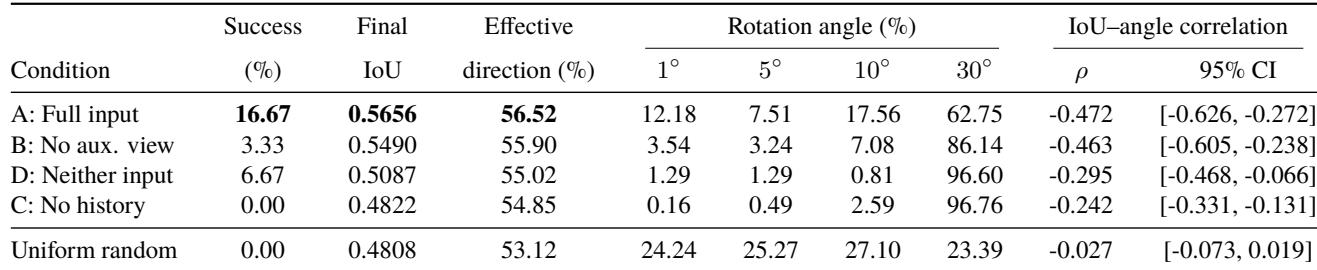
移除辅助视图或交互历史会降低 GPT-5.6-Sol 的任务成功率和最终 IoU,其中移除历史导致更大下降,并使最终 IoU 接近均匀随机基线。不同条件下的有效方向率几乎保持不变,而移除输入后旋转角度选择强烈偏向 30 度旋转。动作前 IoU 与旋转角度幅度之间的相关性在缺少交互历史时减弱最明显,表明历史主要支持细粒度旋转幅度决策。移除交互历史将任务成功率降为零,并将最终 IoU 降到接近均匀随机基线,降幅大于移除辅助视图。即使成功率和最终 IoU 下降,不同消融条件下有效方向率仍几乎不变。缺少交互历史时,30 度旋转成为主要动作,1 度细调几乎消失,削弱了 IoU-角度相关性。
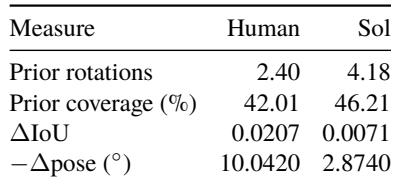
在匹配状态下,人类输入动作时经历了更少的先前旋转,随后在轮廓重叠和姿态误差减少方面均获得比模型更大的平均收益。即使在 2D 重叠暂时下降时,人类动作也更常减少底层姿态误差,而模型更常以牺牲姿态精度为代价改善重叠。与模型相比,人类开始匹配动作时先前旋转更少,可见覆盖率相似。人类结果比模型更有利于减少姿态误差,出现更多重叠下降但姿态误差减少的动作,而重叠改善但姿态误差增大的动作少得多。
实验评估人类和前沿视觉语言模型在 3D 物体对齐任务上的表现,并通过消融和匹配状态分析隔离动作选择与输入历史的作用。人类实现接近完美的成功率和准确的动作姿态感知,而前沿模型尽管观察到相似的表面覆盖率,却在大多数任务上失败,表现出接近随机的有效方向选择和不够精确的旋转角度;姿态贪心基线证实,仅改进动作选择就能解决该任务。消融表明交互历史主要支持细粒度旋转幅度决策,而非方向选择;匹配状态比较显示人类优先减少姿态误差而非提高 2D 重叠,而模型常常以牺牲姿态精度为代价改善重叠。