Command Palette
Search for a command to run...
Harness²:面向开放世界的递归式智能体框架构建
Harness²:面向开放世界的递归式智能体框架构建
Ruiyao Xu Yanfei Chen Zhongying CuiZhu Bhavana Dalvi Mishra Yifei Ming Han Yu Rujun Han Chen-Yu Lee Tomas Pfister
摘要
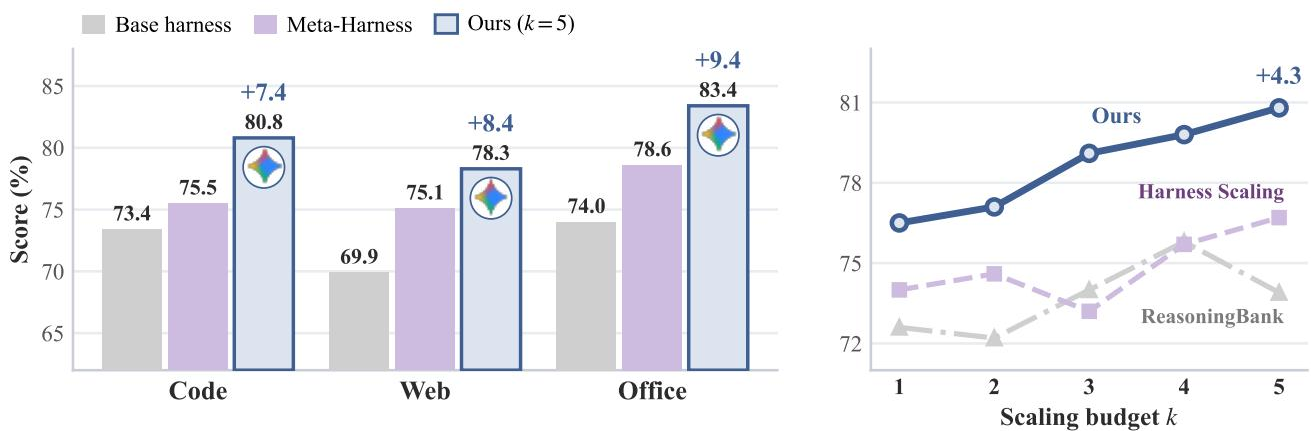
大语言模型(LLM)智能体的能力不仅取决于其底层模型,也取决于其执行框架。递归自我改进(RSI)为自动演进这些框架提供了有前景的路径。然而,在开放世界场景中部署 RSI 仍面临两个关键挑战:第一,开放世界任务通常在框架设计阶段并不可见,且在测试时具有新颖性,因而缺少可用于可靠指导在线框架编辑的真值验证器;第二,RSI 过程仍高度依赖于任务,无法泛化到新的场景。我们提出 Harness2,一种即插即用的递归式智能体框架构建框架,通过两个相互关联的递归层级解决这些挑战。任务级递归使用对比式 Propose–Probe–Compose 步骤来改进当前任务的框架,无需真值验证器即可可靠地指导编辑,并可通过并行或顺序递归进一步扩展。构建级递归随后从这些编辑中抽取经验,更新一个持续改进框架,使智能体更好地适应未来任务。在三个专业基准和四种模型–框架配置上,单步操作相较于基础框架持续提升了 GLM-5 和 Gemini 3.5 Flash 的表现,带来最高 11.5 分的 WorkBuddy-Bench 提升、4.5 分的 JobBench 提升,以及 11.8 个百分点的 LAB 提升;随着任务级递归预算增加,提升幅度进一步扩大。
一句话总结
西北大学和 Google Cloud AI Research 推出 Harness²,这是一个即插即用的递归式 agent harnessing 框架,可在没有真值验证器的情况下,针对未见过的开放世界任务演化 LLM agent harness。该框架结合了任务级对比式 Propose, Probe, Compose 精炼,以及 harnessing 级经验抽取,使 GLM-5 和 Gemini 3.5 Flash 相较于其基础 harness,在 WorkBuddy-Bench 上最高提升 11.5 分,在 JobBench 上提升 4.5 分,在 LAB 上提升 11.8 个百分点。
核心贡献
-
Harness² 是一个即插即用的递归式 agent harnessing 框架,可在无法获得测试时真值验证器的开放世界设置中,演化 LLM agent 执行 harness。
-
任务级递归通过对比式 Propose, Probe, Compose 步骤改进当前 harness,支持并行或顺序递归,并可通过更大的精炼预算扩展。
-
Harnessing 级递归从被采纳的编辑和积累的经验中更新持续改进 harness,在三个专业基准和四种模型及 harness 配置中带来提升,包括 WorkBuddy-Bench 最高 11.5 分、JobBench 4.5 分,以及 LAB 11.8 个百分点。
引言
LLM agent 不仅依赖模型质量,也依赖其 harness,即提示、记忆、技能、工具和编排逻辑。随着 agent 被用于办公、法律和其他高风险工作流,人工设计和更新这些 harness 的成本变得高昂,因此该研究关注 harness 自身的递归自我改进。
既有方法通常针对固定任务、单元测试或验证反馈优化 harness,然后部署静态配置。在任务需求持续变化的开放世界环境中,这可能会失效。较新的在线方法能够适应新任务,或继续沿用先前执行 harness,但它们仍然面临困难:真实任务往往缺少真值,任务特定编辑可能无法迁移,并且在条件变化时直接复用高度定制化的 harness 可能引入噪声。
该研究推出 Harness²,这是一个用于递归 agent harnessing 的即插即用框架。它使用任务级递归,通过对比式 Propose, Probe, Compose 步骤改进当前任务的 harness,并基于行为对比而非真值测试候选编辑。它还使用 harnessing 级递归从这些精炼过程中学习,存储可复用组件和关于变化为何有效的经验,使未来的 harness 更新可以更具针对性。
方法
该研究推出 Harness²,这是一个用于开放世界中递归 agent harnessing 的即插即用框架。Harnessing 指的是优化围绕冻结基础模型的运行时支撑结构,使其能够作为自主 agent 运行。该框架通过两个相互耦合的递归层级,既改进当前任务的 harness,又从这一过程中抽取经验以指导后续 harnessing。
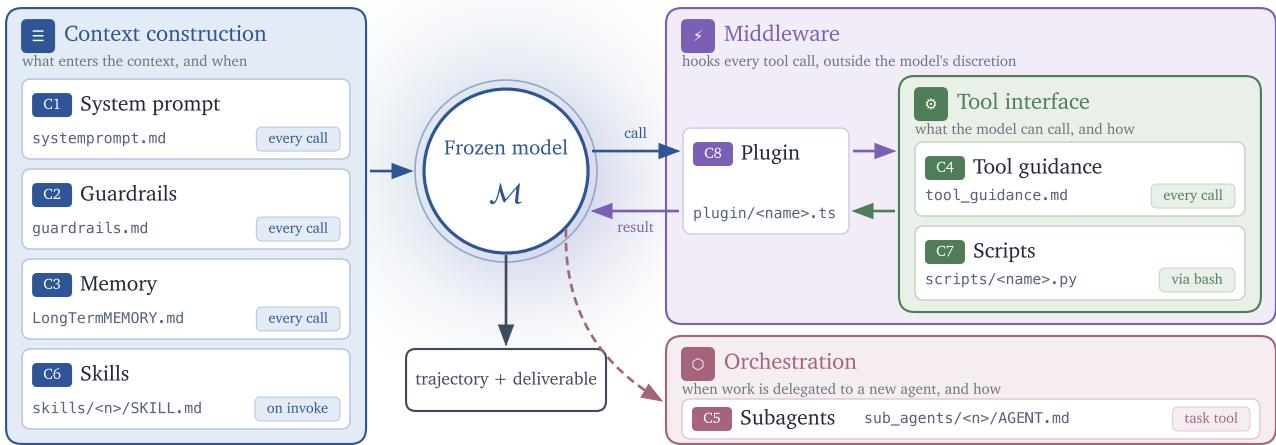
Harness 配置与设置 令 M 为参数冻结的模型。一个 harness H=(c1,…,cK) 由 K 个可编辑组件组成。它与 M 组合形成 agent A(⋅;M,H),且不改变模型权重。执行 harness 采用文件级分解,暴露 K=8 个组件:系统提示、护栏、记忆、技能、工具指导、脚本、子 agent 和中间件插件。每个组件都作为运行时的文件挂载。
递归式 agent harnessing 流水线 递归式 agent harnessing 将两个递归更新耦合在一起。任务级递归利用生成的 harness 和执行证据改进当前执行 harness,而 harnessing 级递归更新指导这一精炼过程的改进 harness。执行 harness 是被改进的系统,改进 harness 是实现改进的机制。
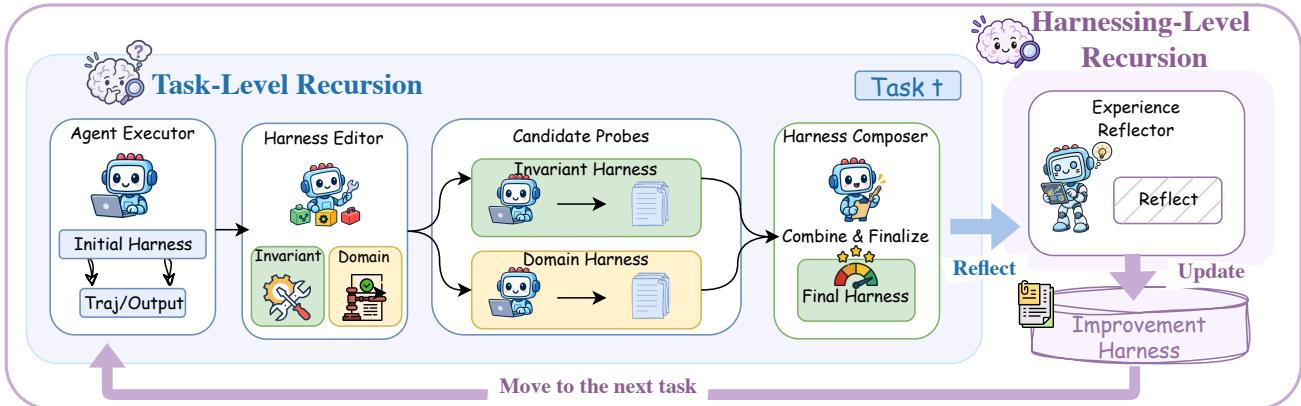
任务级递归 任务级递归旨在针对当前任务改进执行 harness。为了克服开放世界设置中缺少真值反馈的问题,该研究引入由 Propose, Probe, Compose 构成的对比式改进步骤。
令 e=(τ,y) 表示一条执行记录,其中包含轨迹 τ 和交付物 y。该步骤将改进操作 Φ 应用于当前执行 harness H 和可用的任务局部执行及改进历史 E:
(H′,e′,ξ)=Φ(qt,H,E;Rt).它返回后继 harness H′、其执行记录 e′,以及一个步骤记录 ξ。
-
Propose: 流水线首先获得参考执行 e0∼A(qt;M,H)。在任务、当前 harness、参考执行、早期历史和 Rt 中的库的条件作用下,流水线提出两个候选:一个面向规划和工具使用等 agent 缺陷的不变量候选,另一个面向当前领域知识和约束的领域特定候选。
-
Probe: 每个候选 harness 都在匹配配置下对同一任务执行。将其轨迹和交付物与参考执行比较,会产生行为对比,提供证据说明编辑是否缓解了目标缺陷,或是否引入了回归。
-
Compose: 流水线读取参考执行、候选 harness、它们的差异,以及所有可用证据,形成后继 H′。Compose 过程是选择性的,根据具体观察合并获得支持的改动,或保留当前 harness。
在这一对比式步骤的基础上,该研究引入由探索预算 k 控制的两种任务级递归形式。
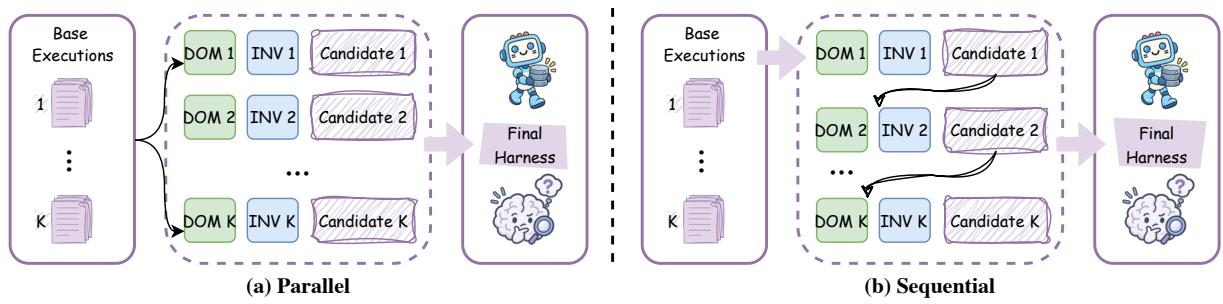
- 并行递归: 流水线收集 k 个参考执行,然后独立提出并探测 k 个不变量候选和 k 个领域特定候选。每个独立的 Compose 会话都会接收完整的候选集和参考执行池,以产生一个后继 Hj′:
- 顺序递归: 从 H(0)=H0 开始,串联 k 个对比式步骤,每一步都以前序 harness 和累计执行历史 E(r−1) 为条件:
当 k>1 时,一个 agent 式选择器会将匿名化交付物与任务请求进行比较,以选择最终 harness Ht⋆。单个对比式步骤即可在基准上提升性能,并行递归则随着预算 k 增加带来进一步提升。
Harnessing 级递归 Harnessing 级递归利用改进当前执行 harness 的经验来改进未来的 harnessing。每个任务之后,流水线会更新改进 harness Rt 中的库。
-
反思改进过程: 流水线审查完整改进记录 Dt,其中包括参考执行、候选 harness、Compose 决策和选定结果。反思会抽取关于哪些改动针对了观察到的缺陷,以及在何种条件下有效的经验。只有获得执行对比支持的经验才会被保留。
-
更新改进 harness: 流水线将已采纳的 harness Ht⋆ 和获得支持的经验保留在 harness 改进库中:
每个库条目包含一个可执行 harness 和一条经验记录。索引使后续会话可以按需检查相关条目。
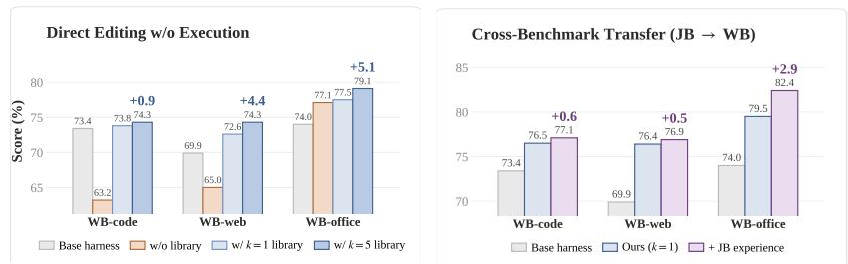
- 在后续改进中复用: 下一个任务从共同执行 harness H0 开始,但精炼过程由更新后的改进 harness Rt+1 指导。早期组件会被选择性复用或调整。使用更大递归预算积累的库支持更强的后续 harness 编辑,跨基准迁移的经验也会提升性能。
实验
该论文在专业任务基准、两种 executor 模型和两种 harness 设置下评估该方法,并与固定、检索式、离线优化和逐实例扩展基线进行比较。结果显示,单次 harness 改进步骤能够稳定增强性能,较弱的 executor 通常获益更多,任务级递归还会在不同 harness 上提供额外但非均匀的提升。进一步分析将增益归因于递归精炼、有利的计算与性能权衡、改进库、范围化编辑和 Compose 机制,同时展示了跨基准复用,以及在无需更强 editor 的情况下实现自我改进。
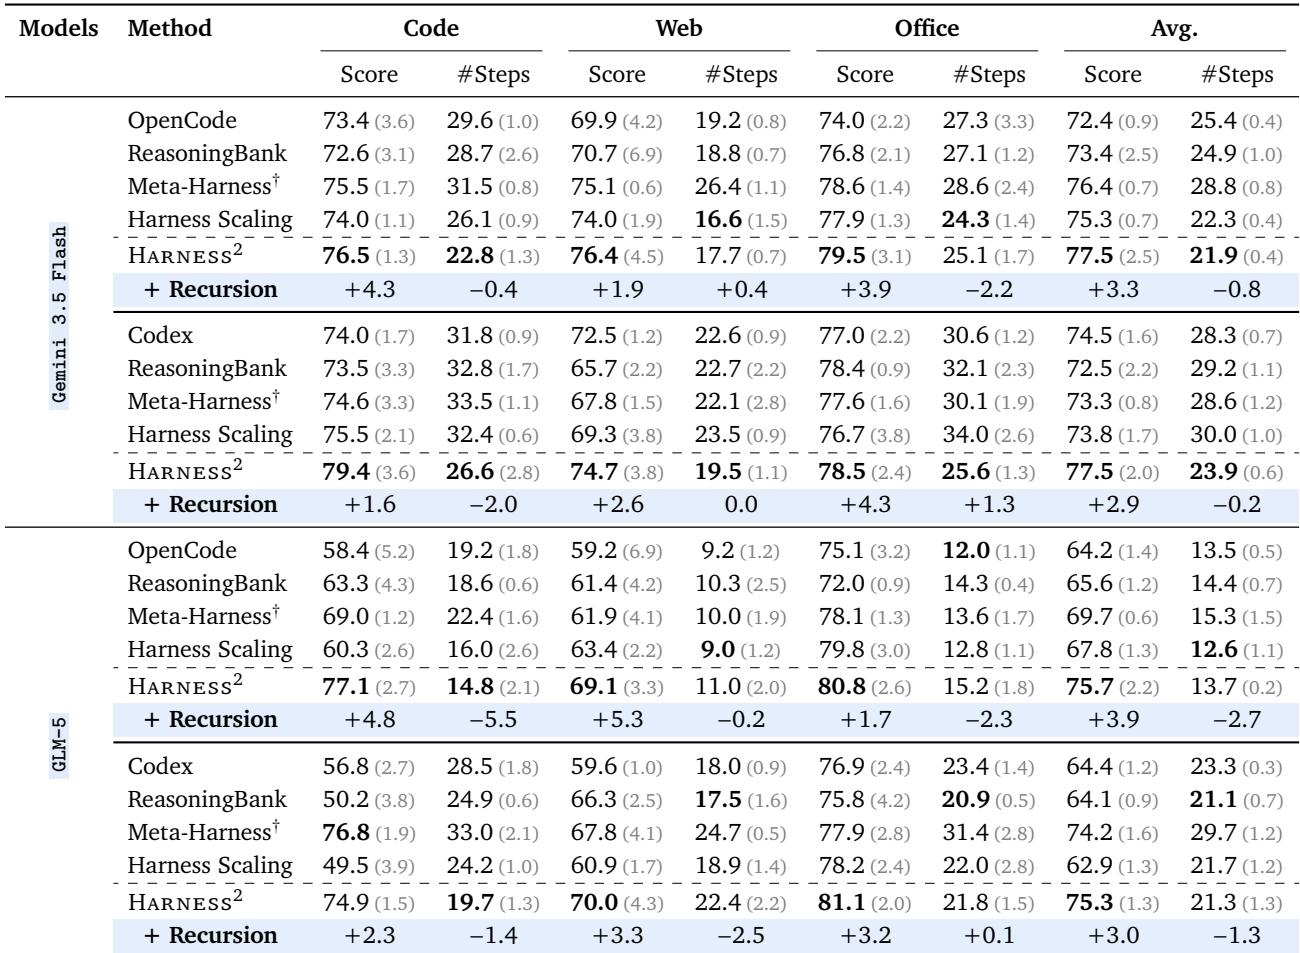
在所评估的模型和初始 harness 中,单次改进步骤通常提高 WorkBuddy-Bench 领域分数,其中 GLM-5 的绝对增益大于 Gemini 3.5 Flash。并行任务级递归在单次步骤基础上带来进一步提升,并以模型特定的方式改变了 OpenCode 与 Codex 之间的差异。在两种初始 harness 下,单次改进步骤都能提升 Gemini 3.5 Flash 和 GLM-5 的平均 WorkBuddy-Bench 分数。单次步骤之后的任务级递归带来额外收益,并可能缩小 OpenCode 与 Codex 的差距,但不同模型之间并不统一。
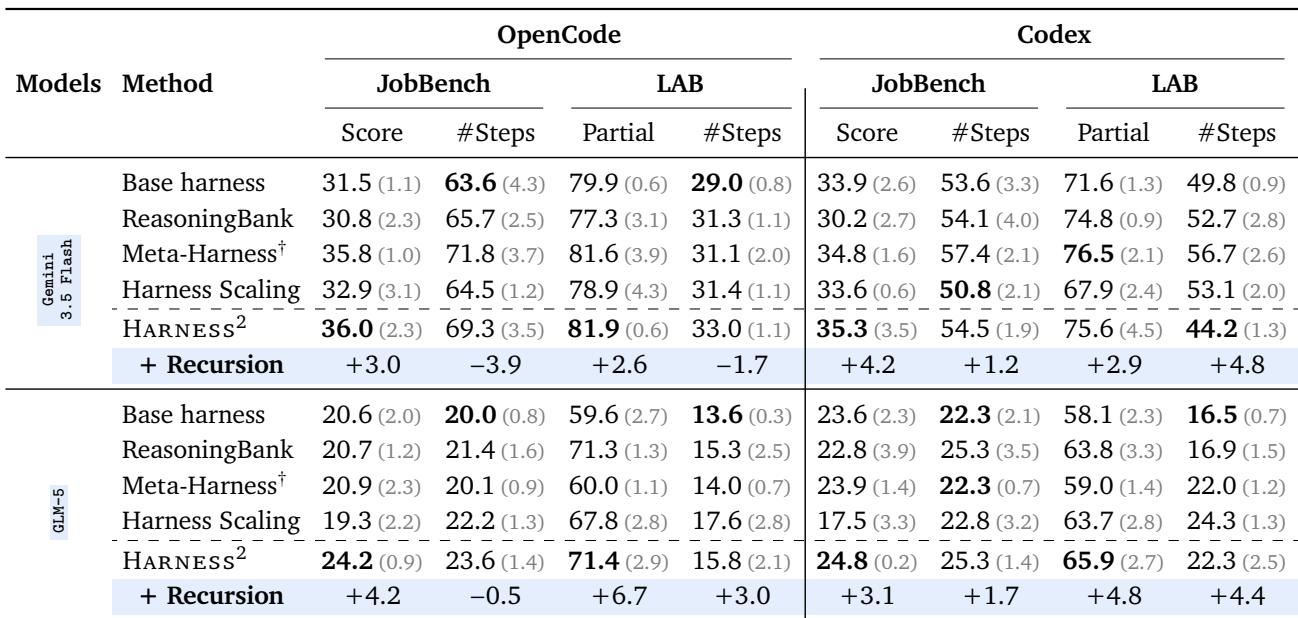
在 JobBench 和 LAB 上,Harness² 在 OpenCode 和 Codex 两种设置下均优于基础 harness 和许多替代方法。并行任务级递归在 JobBench 分数和 LAB 部分通过率上带来额外提升,尤其缩小了 JobBench 上两个初始 harness 之间的差距。该改进并非完全均匀,因为某些替代方法可能降低性能,并且在 Gemini 搭配 Codex 时,某替代方法可能在 LAB 部分通过率上领先。Harness2 在两种初始 harness 下均提高了 JobBench 分数,使其高于基础 harness。递归在 JobBench 和 LAB 上将收益扩展到单次 harness 更新之外。初始 harness 之间的差异仍然存在,但在 JobBench 上经过递归后有所缩小。
完整 Harness² 配置在 WorkBuddy-Bench 和 JobBench 上均优于所有消融变体。移除范围化候选会在 JobBench 上造成最明显的弱点,而移除库和 Compose 过程也会降低两个基准上的性能。完整配置在比较的消融配置中给出最佳结果。范围化候选在 JobBench 上尤其重要,因为排除它们会显著降低性能。库和 Compose 过程都对最终性能有贡献,因为移除任一项都会相对于完整设置降低分数。
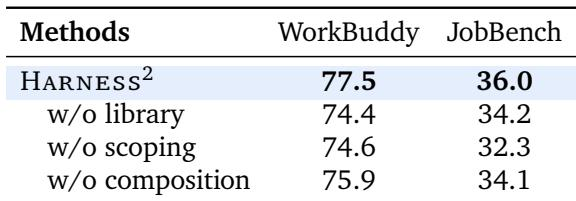
在 WorkBuddy-Bench、JobBench 和 LAB 上,Harness² 相对于基础 harness 和若干替代方法通常能够提升性能,单次改进步骤提高基准分数,任务级递归带来进一步提升。这些改进缩小了 OpenCode 和 Codex 等初始 harness 之间的差异,但并未消除差异,说明增益具有鲁棒性,但仍依赖模型和 harness。消融实验表明,完整的 Harness² 设计最有效,而移除范围化候选、库组件或 Compose 机制会降低性能。