Command Palette
Search for a command to run...
多流注意力残差
多流注意力残差
Xiaohan Qin Xiangdong Zhang Tuo Dai Sunan Zou Huaijin Wu Yebin Yang Zhuo Xia Lin Yao Yuliang Liu Junchi Yan
摘要
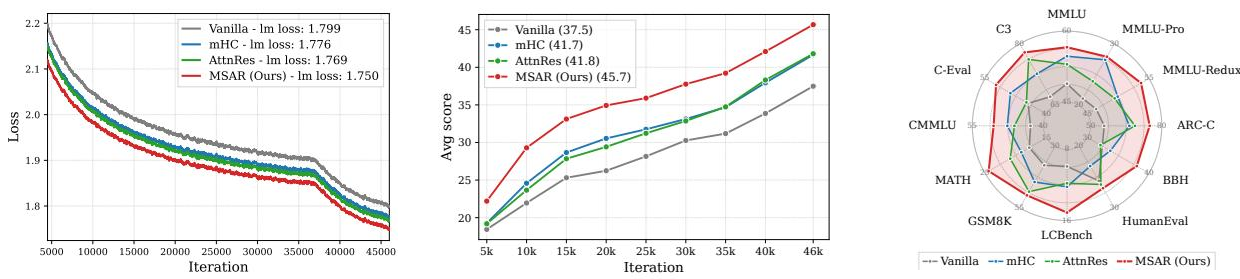
注意力残差(AttnRes)实现了沿网络深度的内容依赖检索,可视为深度轴上的单流 softmax 注意力。受多头注意力在序列轴上的成功所启发,我们提出多流注意力残差(MSAR),它是 AttnRes 的扩展,将这一机制推广为多头深度注意力,以极少的额外开销带来显著性能提升。MSAR 通过多尺度因果卷积从序列上下文中获取流多样性,使不同头能够通过不同的上下文视图检索历史表示,同时保持隐藏表示的完整性。检索到的流通过轻量级自适应混合进行组合,以生成单流层输入。通过保留单流来源并按需扩展它们,MSAR 支持多流计算,而无需持久的多流存储或通信。在 18B 和 28B MoE 规模的全部 12 个下游基准上,MSAR 一致优于先前的残差变体,包括标准残差连接、流形约束 Hyper-Connections(mHC)和 AttnRes。缩放律实验显示,相较于标准残差基线,MSAR 实现了 1.58 倍的等损失计算加速比,而 AttnRes 为 1.35 倍,mHC 为 1.30 倍。这些结果表明 MSAR 是一种有前景的大规模预训练残差架构。
一句话总结
上海交通大学的研究者与合作者提出多流注意力残差(Multi-Stream Attention Residuals,MSAR),这是注意力残差(Attention Residuals)的一种扩展,通过多尺度因果卷积和轻量自适应混合,将单流深度注意力推广为多头深度注意力;在 18B 和 28B MoE 规模下,其在全部 12 个下游基准上优于标准残差连接、流形约束超连接(manifold-constrained Hyper-Connections,mHC)和注意力残差(Attention Residuals),并相对标准残差基线实现了 1.58× 的等损失计算加速。
核心贡献
- 多流注意力残差(MSAR)通过使用多尺度因果卷积产生流多样性,并使用轻量自适应标量混合来组合检索到的流,将单流注意力残差扩展为多头深度注意力。
- 该方法仅在计算期间扩展为多个流,从而保持单流持久源存储和流水线通信开销不变,同时与 AttnRes 跨阶段缓存和两阶段推理兼容,并且参数和训练 FLOPs 开销极小。
- 在 18B 和 28B MoE 规模下,MSAR 在全部 12 个下游基准上始终优于标准残差连接、流形约束超连接(mHC)和注意力残差(AttnRes),扩展律实验显示其相对标准残差基线实现了 1.58 倍等损失计算加速,而 AttnRes 为 1.35 倍,mHC 为 1.30 倍。
引言
在现代 PreNorm 架构中,按深度扩展基于 Transformer 的 LLM 往往收益递减,因为单一残差流会累积固定的加法更新,导致早期层特征被稀释,使后续层更难检索。近期的残差重新设计通过引入多个流来应对该问题,例如超连接(Hyper-Connections)和 mHC,或者用逐深度 softmax 检索替代固定累积,如注意力残差(AttnRes)。这些方法可被理解为沿深度轴的类注意力机制,但将 AttnRes 风格的深度注意力扩展到多头检索一直较为困难:对隐藏状态进行通道拆分会破坏其一致性,而 HC 风格的全维候选流在归一化后往往坍缩为几乎相同的键。作者提出多流注意力残差(MSAR),该方法使用低开销的多尺度因果深度可分离卷积,从序列上下文创建多样化的全维流,对每个流执行深度注意力,并通过轻量混合融合检索到的状态。这样便在保持训练 FLOPs 和参数开销极小的同时,将残差检索转化为多头的深度注意力原语。
方法
作者将残差连接形式化为深度混合问题。在标准 Transformer 堆栈中,每个残差分支接收隐藏状态 hl∈Rd,并产生更新 fl(hl)。标准残差递推为
hl+1=hl+fl(hl).通过定义 v0=h1 以及 vi=fi(hi)(i≥1),展开该递推得到
hl=i=0∑l−1vi.因此,传统残差在所有先前源上以固定单位系数进行深度混合。基于该视角,作者提出多流注意力残差,即 MSAR,其将残差源扩展为多个流,并对每个流应用可学习的深度注意力。
在 MSAR 中,每个残差源 vi 被扩展为 m 个流。第一个流是恒等流,vi(0)=vi。对其余流,作者在相邻 token 上使用轻量因果深度可分离 1D 卷积。恢复 token 索引 t 后,扩展为
\mathbf{v}_{i,t}^{(r)}=\sum_{\delta=0}^{\kappa_r-1}\mathbf{c}_{i,r,\delta}\odot\mathbf{v}_{i,t-\delta},\quad r=1,\dots,m-1,$$ 其中 $\mathbf{c}_{i,r,\delta}\in\mathbb{R}^d$ 包含逐通道卷积权重,$\kappa_r$ 控制局部感受野。在主要配置中,作者保留原始流,并添加三个核大小分别为 $\{4,8,12\}$ 的因果卷积,得到 $m=4$ 个流。这种构造为每个残差源提供了多个上下文视角,而无需引入稠密投影层。 每个扩展流被视作独立的深度注意力头。目标层 $l$ 对每个流具有一个可学习的伪查询 $\mathbf{q}_l^{(r)}=\mathbf{w}_l^{(r)}$。键为扩展后的源 $\mathbf{k}_i^{(r)}=\mathbf{v}_i^{(r)}$。在每个流内,通过对所有先前深度源做 softmax 计算注意力权重: $$\alpha_{i\to l}^{(r)}= \frac{\phi(\mathbf{q}_l^{(r)},\mathbf{k}_i^{(r)})} {\sum_{j=0}^{l-1}\phi(\mathbf{q}_l^{(r)},\mathbf{k}_j^{(r)})},$$ 其中\phi(\mathbf{q},\mathbf{k})=\exp\left(\mathbf{q}^{\top}\operatorname{RMSNorm}(\mathbf{k})\right).
流 $r$ 的检索状态为\mathbf{z}l^{(r)}=\sum{i=0}^{l-1}\alpha_{i\to l}^{(r)}\mathbf{v}_i^{(r)}.
得到的多流状态被收集为 $\mathbf{Z}_l=[\mathbf{z}_l^{(0)},\dots,\mathbf{z}_l^{(m-1)}]^{\top}\in\mathbb{R}^{m\times d}$。由于这些流必须合并为单个层输入,作者使用一种轻量的流形约束超连接式混合器: $$\mathcal{H}_l^{\mathrm{pre}}= \sigma\left(\alpha_l^{\mathrm{pre}} \operatorname{RMSNorm}\left(\operatorname{Flatten}(\mathbf{Z}_l)\right) \mathbf{W}_l^{\mathrm{pre}}+\mathbf{b}_l^{\mathrm{pre}}\right) \in\mathbb{R}^{1\times m}.$$ 此处 $\mathbf{W}_l^{\mathrm{pre}}\in\mathbb{R}^{md\times m}$,$\alpha_l^{\mathrm{pre}}$ 是可学习缩放因子,$\mathbf{b}_l^{\mathrm{pre}}\in\mathbb{R}^{1\times m}$ 是逐流偏置,$\sigma$ 是 sigmoid 函数。最终目标层输入是检索流的加权和: $$\mathbf{h}_l=\left(\mathcal{H}_l^{\mathrm{pre}}\mathbf{Z}_l\right)^{\top} =\sum_{r=0}^{m-1}\left[\mathcal{H}_l^{\mathrm{pre}}\right]_r\mathbf{z}_l^{(r)}.$$ 直接在每个残差分支上应用 MSAR 会需要存储每一层的输出。为降低内存和流水线通信开销,作者引入了 Block MSAR。将 $L$ 个残差分支划分为 $N$ 个连续块。在每个块内,更新在单个流中累积。块 $n$ 的完成摘要为\mathbf{b}n=\sum{j\in\mathcal{B}_n}f_j(\mathbf{h}_j),
其中嵌入被保留为初始源 $\mathbf{b}_0=\mathbf{h}_1$。对于块 $n$ 内的目标层 $l$,当前块会贡献其前序输出的部分摘要:\mathbf{b}n^{<l}=\sum{\substack{j\in\mathcal{B}_n\ j<l}}f_j(\mathbf{h}_j).
随后对嵌入、已完成块摘要和当前部分摘要执行深度注意力。对每个流 $r$, $$\mathbf{z}_l^{(r)}= \sum_{j=0}^{n-1}\alpha_{j\to l}^{(r)}\mathcal{E}_r[\mathbf{b}_j] +\alpha_{n\to l}^{(r)}\mathcal{E}_r[\mathbf{b}_n^{<l}],$$ 其中 $\mathcal{E}_r$ 表示流 $r$ 的因果卷积扩展。在块的第一层,当前部分源不存在,并在检索求和与 softmax 分母中均被省略。 下面将所得设计与标准残差累积和 Block AttnRes 进行比较。 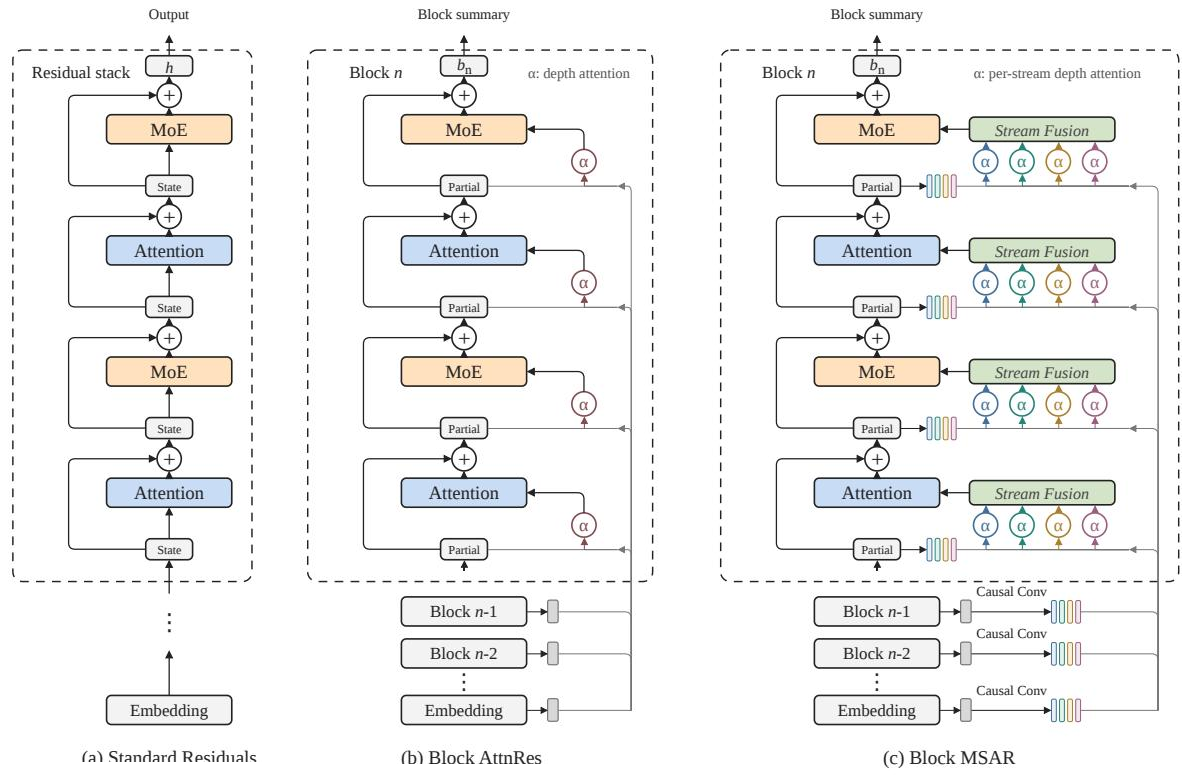 标准残差连接保持单一累积残差流。Block AttnRes 在块级摘要上进行注意力检索,但使用单流源。Block MSAR 则先将每个块级源扩展为多个上下文相关流,再应用逐流深度注意力,然后将检索到的流融合为目标层输入。 作者进一步针对大规模训练进行了高效设计。由于扩展流是单流块摘要的确定性函数,Block MSAR 仅存储和通信单流摘要。与存储所有扩展流相比,这减少了持久源存储和流水线通信。由于一个块内的所有目标层共享相同的已完成摘要,计算被拆分为两个阶段。首先,将块内所有目标层的可学习伪查询与已完成源批量组织,以计算逐流检索结果和 softmax 统计量。其次,每个层通过在线 softmax 合并其当前部分贡献。因果卷积扩展和之后的深度注意力被融合到单个 kernel 中,避免扩展源流的中间写入。只有最终的多流检索状态被实际物化用于流融合。 # 实验 实验在 18B 和 28B 规模下预训练 DeepSeekMoE 风格的 Transformer,将 MSAR 与 mHC、AttnRes 以及普通残差基线进行比较,同时通过 10B 规模消融实验测试关键设计选择。在两个主要规模下,MSAR 在通用、代码/数学和中文基准上均始终优于所有基线,扩展律分析显示其损失-计算权衡更好。消融实验表明,MSAR 的优势来自其特定的残差设计,上下文源扩展和自适应融合均有贡献,并且两到四个流配合大约八个块能够获得大部分收益。 在所评估的 18B 和 28B MoE 设置中,MSAR 在每个基准上都取得了最佳下游得分,超过 Vanilla、mHC 和 AttnRes。最大提升相对于 Vanilla 残差基线,同时在两个规模下相对于 mHC 和 AttnRes 也有明显改进。随着模型规模增大,下游优势保持一致。MSAR 在 18B 和 28B 两个规模的全部评估基准上均取得最高性能。相对于 Vanilla,MSAR 在 18B 将平均下游得分提高约 8 个点,在 28B 也提高近 8 个点。在 MMLU、ARC-C 和 BBH 等代表性任务上,MSAR 扩展了相对 AttnRes 的增益。18B 设置下相对 AttnRes 的幅度大于 28B 设置,但整体领先趋势保持一致。 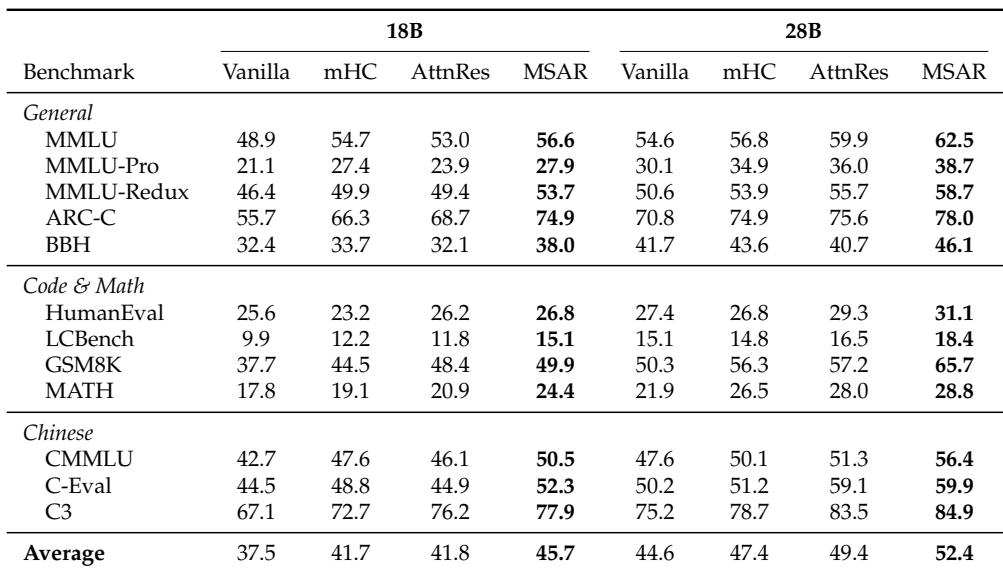 在 10B MoE 模型上的消融实验显示,在测试的残差架构中,MSAR 达到最低的 Pile 损失,优于 vanilla、mHC、AttnRes 以及 AttnRes 加 mHC 的直接混合方案。其优势并非仅仅来自组合先前方法,上下文源扩展和自适应融合都有贡献,其中源扩展的作用更大。两个流已能捕捉大部分增益,而超过大约八个块的更细深度划分收益递减。MSAR 在所有比较变体中达到最低损失,优于独立基线和混合基线。移除卷积源扩展带来的损失退化比用均值聚合替代自适应融合更严重。四个流是实用的默认选择,因为两个流已捕捉大部分改进,八个流增益很小。 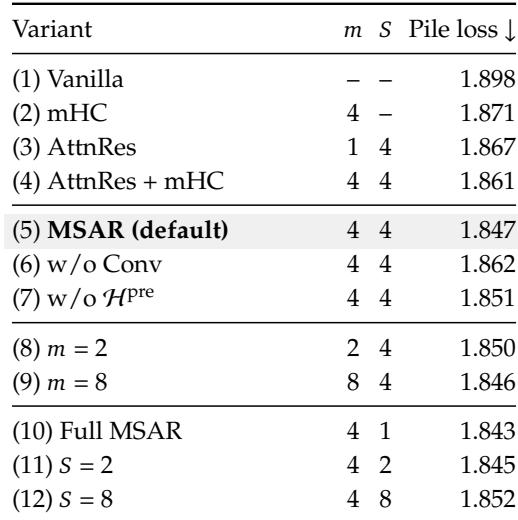 实验在 18B 和 28B MoE 设置下,在下游基准上评估 MSAR 与 Vanilla、mHC 和 AttnRes 残差架构,并使用 10B MoE 模型基于 Pile 损失进一步对设计进行消融。MSAR 在两个规模的全部基准上均取得最佳下游性能,相对基线具有一致增益,且在 18B 下相对 AttnRes 的幅度更大。消融显示,MSAR 在独立基线和混合基线中取得最低 Pile 损失,其收益并非仅仅是先前方法的组合:上下文源扩展的贡献大于自适应融合,两个流捕捉大部分增益,超过大约八个块的更细划分收益递减。