Command Palette
Search for a command to run...
超越领域路由监督:面向多教师同策略蒸馏的跨教师守护
超越领域路由监督:面向多教师同策略蒸馏的跨教师守护
摘要
多教师同策略蒸馏(MOPD)通过将领域特定数据路由到专门教师,并在学生生成的轨迹上施加密集的 token 级监督来整合各教师能力,从而扩展了同策略蒸馏(OPD)。然而,领域路由仅区分了不同领域的监督来源;来自所有领域的更新仍然作用于共享参数。当教师在响应风格和领域专长上差异显著时,单独使用有效的监督在联合优化中仍可能导致持续的梯度冲突和能力退化。为应对这一挑战,我们提出了面向 MOPD 的跨教师守护(ROAD MOPD),该方法在同一学生轨迹上引入未被路由的教师作为辅助跨领域评判器,并通过 token 级贡献分配和梯度更新来协调多教师监督。具体而言,跨教师引导的贡献分配利用教师间的一致性来增强教师共同支持的 token 级修正,并削弱相互冲突的信号;预防性多教师梯度投影使用来自同一轨迹的辅助梯度来约束可能冲突的更新,并自适应地控制投影强度以保留目标领域学习信号。实验表明,ROAD MOPD 缓解了弱势领域的退化,在高冲突场景下提升超过 5 个百分点,并在低冲突和三领域设置下改善了整体性能。
一句话总结
来自南京大学和京东的研究者提出了用于多教师同策略蒸馏的跨教师防护方法(ROAD MOPD),该方法引入非路由教师作为辅助跨域评判者,并通过token级信用分配和预防性多教师梯度投影来协调多教师监督,缓解了劣势域的性能下降,在高冲突场景下提升超过5个百分点,并改善了低冲突和三域场景下的性能。
核心贡献
- 本文提出ROAD MOPD,该方法在同一学生轨迹上使用非路由教师作为辅助跨域评判者,并通过token级信用分配和梯度更新来协调多教师监督。
- 该方法引入跨教师引导的信用分配,以加强教师共同支持的token级修正并衰减冲突信号,同时引入预防性多教师梯度投影,在自适应保留目标域学习信号的同时约束冲突更新。
- 实验表明,与标准MOPD和梯度冲突校正基线相比,ROAD MOPD缓解了劣势域的退化,在高冲突场景下提升超过5个百分点,并改善了低冲突和三域场景下的整体性能。
引言
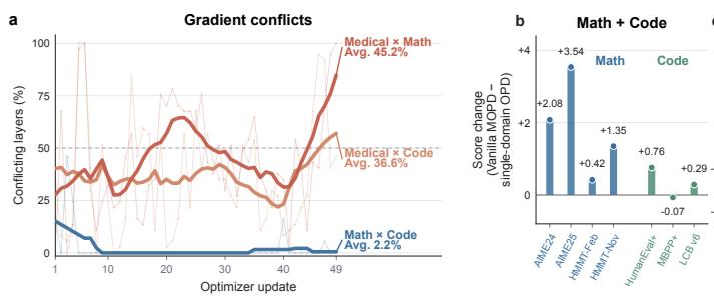
大语言模型后训练的强化学习通常依赖结果级奖励,这类奖励对中间推理步骤几乎没有直接反馈,导致信用分配困难。同策略蒸馏通过强教师在学生生成轨迹上提供密集的token级监督来解决这一问题,多教师同策略蒸馏则通过将每个域样本路由到其专属教师来扩展这一思路。然而,仅靠域路由无法协调来自不同域的更新如何影响共享参数,在医学与数学或代码等高冲突组合中,可能产生大范围的梯度冲突和不对称的性能退化。作者提出ROAD MOPD,该方法在同一学生轨迹上使用非路由教师作为跨域评判者。它将基于教师一致性的token级加权与预防性梯度投影相结合,在抑制冲突更新的同时保留路由教师的域专属学习信号。
方法
多域教师同策略蒸馏
作者围绕学生策略πθ、一组教师策略πT和提示分布D来形式化学习问题。对于提示x∼D,学生采样响应y=(y1,…,yT)并维护前缀ht=(x,y<t)。标准同策略蒸馏最小化序列级反向KL目标
LOPD(θ;πT,D)=Ex∼DDKL(πθ(⋅∣x)πT(⋅∣x)).遵循先前工作,该目标被表述为带KL惩罚的相对奖励最大化,KL惩罚针对冻结参考策略πref。在奖励缩放λ>0下,最大化目标为
Jλ(θ)=Eθ[λlogπref(y∣x)πT(y∣x)−DKL(πθ(⋅∣x)πref(⋅∣x))],其中Eθ对x∼D和y∼πθ(⋅∣x)求平均。设置λ=1恢复标准同策略蒸馏,0<λ<1衰减教师信号,λ>1放大教师信号。冻结参考πref提供共享基线,而非额外的教师。
对于K个域-教师对{(Dd,πTd)}d=1K,多域同策略蒸馏目标将每个提示路由到其对应的域教师,并最小化
LMOPD(θ)=K1d=1∑KLOPD(θ;πTd,Dd).对于固定目标域d,路由教师记为Tr=Td,来自辅助域的教师记为Ta。两个教师和冻结参考在教师强制下对相同学生生成的token进行评分,无需额外rollout。它们的token级对数概率表示为ℓtr、ℓta和ℓtref。
跨教师引导的信用分配
固定的全局λ对每个token应用相同的奖励缩放,即使轨迹中可能包含可迁移的推理模式和域专属修正。仅靠路由教师无法对这些修正提供跨域检验。为解决这一问题,作者在同一学生生成的前缀上查询辅助教师,并利用其反馈调整路由教师的token级奖励。辅助教师不被用作解决目标域任务的监督者;其相对偏好仅作为兼容性信号。
路由教师与辅助教师之间的token级一致性相对于共享冻结参考来衡量:
st=routed-teacher evidencetanh(τℓtr−ℓtref)×auxiliary-teacher evidencetanh(τℓta−ℓtref),st∈[−1,1].正的st表示两个教师相对于参考偏好相同的修正方向。负的st表示偏好相反,接近−1的值对应强烈的跨教师分歧。当任一教师几乎没有提供超出参考的证据时,该分数趋近于零。
该一致性用逐token系数替代全局奖励缩放:
λt=clip(1+ρgst,λmin,λmax),其中ρg>0控制调制强度。当st>0时,路由教师的相对奖励在两个教师共同支持的token上得到加强。当st<0时,奖励被衰减,分歧越强衰减越大。当st=0时,该方法退化为标准同策略蒸馏,裁剪同时限制了放大和衰减。
对于采样token yt和比较策略q,k1对数比估计器为
k1,t(πθ∥q)=logπθ(yt∣ht)−logq(yt∣ht).调制后的信号
λt(ℓtr−ℓtref)−k1,t(πθ∥πref)被裁剪并分离,作为PPO风格替代token损失ℓd,i,tagi(θ)中的优势函数。梯度流经策略重要性比率,而非优势函数。当使用多个辅助教师时,它们与路由教师的逐token一致性分数在奖励调制前取平均。
预防性多教师梯度投影
token级一致性并不保证兼容的参数更新,因为token监督信号通过共享参数聚合。因此,作者将梯度校正形式化为一个约束优化问题:在保留目标梯度范数最小比例的同时,最小化与辅助教师在同一轨迹上的冲突。
首先,目标域梯度从一致性调制损失中计算:
gd=∇θLdagr.为了构造辅助梯度,将路由教师替换为辅助教师并禁用一致性调制。令ℓd→a,i,tOPD表示所得普通token级同策略蒸馏损失。辅助损失采用与目标损失相同的响应级归约:
Ld→a′=∣Bd∣1i∈Bd∑Ti1t=1∑Tiℓd→a,i,tOPD,gd′=∇θLd→a′.两个损失使用相同的已存储域d轨迹。因此,gd′反映辅助教师对当前行为的偏好,而非其在辅助域数据上的训练梯度。
校正后的梯度针对每个可训练参数张量分别优化。令g和g′表示gd和gd′的非零切片,令v表示候选校正梯度。对于预期的张量级步长−ηv,辅助损失的一阶变化为−η⟨v,g′⟩。负内积⟨g,g′⟩<0表示局部冲突;否则保留g。对于冲突对,候选被限制在g与其到正交于g′的超平面的全投影之间的线段上:
gfull=g−∥g′∥22⟨g,g′⟩g′,S(g,g′)=conv{g,gfull}.该限制保留正交于g′的分量,仅移除冲突分量,直至全投影。全投影消除局部冲突,但当两个梯度强烈对立时可能几乎消去g。因此,校正梯度在范数保留下限m∈(0,1]下最小化剩余冲突:
g=v∈S(g,g′)argmin−⟨v,g′⟩subject to∥v∥22≥m2∥g∥22.所得解可写成部分投影:
g=g−α⋆∥g′∥22⟨g,g′⟩g′,α⋆∈[0,1].这里α⋆是被移除冲突分量的比例。当满足范数下限时,使用α⋆=1的全投影;否则,在下限允许范围内尽可能多地移除冲突。对于非冲突对,α⋆=0。这些是关于同一轨迹辅助损失的局部陈述,而非优化器步进后辅助域性能的保证。梯度范数可忽略的张量保持不变,辅助梯度从不作为单独的优化器更新应用。对于多个辅助教师,投影在相对于原始目标梯度的共享范数保留下限下依次应用。
作者将这种预防性投影与PCGrad等事后梯度手术方法进行对比。这里,辅助教师评估当前目标域轨迹,并为该更新专门构造梯度约束,在约束潜在不兼容修正的同时保留目标域学习信号。
总体目标与训练
该框架使用序列均值聚合:token损失先在每个响应内取平均,再跨响应取平均,最后跨域取平均。辅助损失使用相同的归约方式,但仅指导梯度校正,因此整体蒸馏目标仅包含目标域损失:
Loverall(θ)=K1d=1∑K∣Bd∣1i∈Bd∑Ti1t=1∑Tiℓd,i,tagr(θ).在预防性梯度投影之后,仅对投影后的目标域梯度取平均,使用与整体目标中相同的域权重。所得更新方向
gupdate=K1d=1∑Kgd经过全局裁剪,并用于一步AdamW优化器更新。
实验
评估涵盖代码、数学和医学基准,使用由多个域教师训练的Qwen3-4B和Qwen3-1.7B学生模型,将ROAD MOPD与多个多域策略蒸馏基线进行比较。ROAD MOPD在数学-医学和代码-医学配对中始终取得最佳双域平均值,恢复了医学准确率,同时保持或提升另一域的收益,并且也推广到低冲突和三域设置。进一步分析表明,跨教师分歧与梯度冲突相关,预防性投影优于事后PCGrad校正,且信用分配和梯度保护两个组件均对联合性能有贡献。
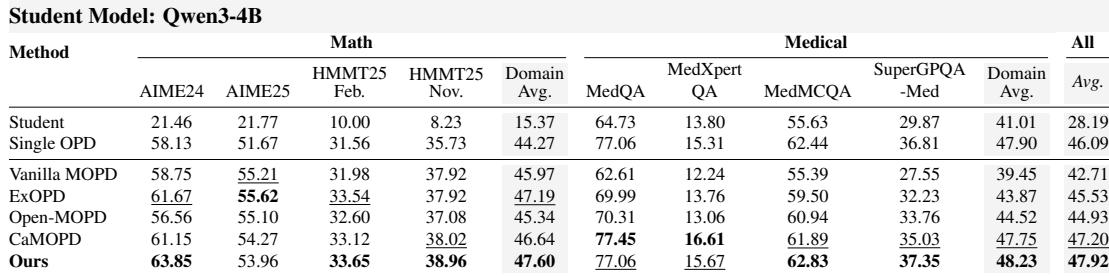
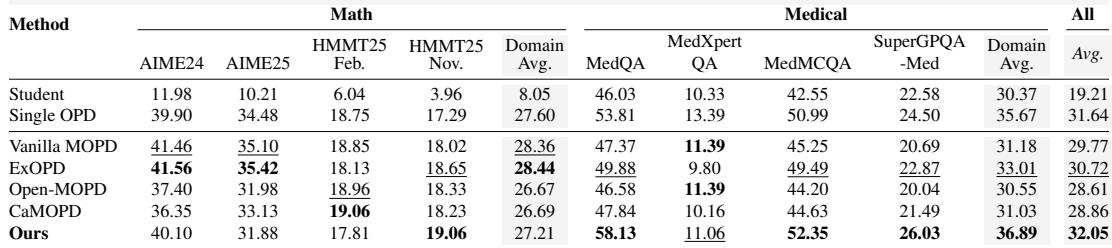
ROAD MOPD在4B和1.7B学生模型的配对域设置中,在所有多域方法中取得最高双域平均值,且在每种情况下均超越最强基线。在4B学生模型上,它恢复医学准确率至接近或高于单域参考水平,同时提升配对的数学或代码域。在1.7B学生模型上,它超越单域医学参考,且其更大的医学收益弥补了数学或代码分数的轻微下降,改善了整体权衡。ROAD MOPD在所有配对域和学生规模设置中取得最佳整体双域平均值,且相对最强多域基线保持一致的领先幅度。Vanilla MOPD将医学准确率降至初始学生以下,而ROAD MOPD将医学性能恢复至接近或高于单域参考,并在较大学生模型设置中引领配对的数学或代码域。在较小学生模型设置中,ROAD MOPD超越单域医学参考,并以显著更强的医学收益弥补较小的数学或代码差距。
ROAD MOPD在低冲突的数学×代码设置下改善了Qwen3-4B的联合性能。在比较多域方法中,它取得最佳代码平均值和第二佳数学平均值,其更大的代码收益弥补了较小的数学差距,从而产生所报告的最高整体平均值。ROAD MOPD在比较多域方法中取得最佳代码平均值和第二佳数学平均值。相对于ExOPD,该方法的代码优势大于其数学劣势,因此取得所报告的最高整体平均值。
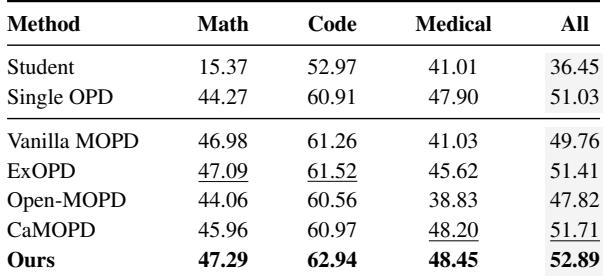
在涵盖数学、代码和医学任务的三域评估中,所提方法在每个域中取得最高平均准确率和最高整体均值。它在所有三个域上均超越单教师OPD基线,并整体超越最强多域基线。结果表明这是均衡的收益,而非牺牲一个域换取另一个域。所提方法在数学、代码和医学域平均值上领先所有比较方法。其整体均值超出次优方法超过一个百分点,并在每个域上均超越单教师OPD基线。
消融实验表明,在两种双域设置中,移除信用分配或梯度保护都会降低域平均准确率,其中信用分配移除导致数学和代码下降最大,梯度保护移除导致医学下降最大。用全投影替代自适应保留也会降低双域均值,尽管在一种设置中域级略有提升。完整的ROAD MOPD方法在两个域配对中均取得最高等权双域平均值。移除信用分配会降低各域准确率,其中数学和代码下降尤为明显。移除梯度保护会降低医学准确率,尤其在代码-医学设置中。自适应保留相比全投影产生更好的双域平均值,即使全投影在一种配对中改善了医学。完整方法在两个评估的域配对中记录了最佳双域平均值。
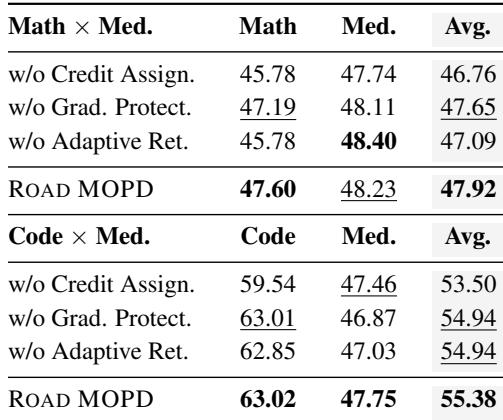
在使用4B和1.7B学生模型的配对域和三域评估中,ROAD MOPD始终取得最佳整体域平均值,恢复或超越单域医学性能,同时提升数学和代码。在低冲突的数学和代码设置中,它通过更强的代码收益整体领先,在三域设置中,它在所有域上取得均衡收益。消融实验确认信用分配、梯度保护和自适应保留各自对该方法的双域性能均有贡献。