Command Palette
Search for a command to run...
EmbodiedCLBench:评估自进化具身智能体的持续学习
EmbodiedCLBench:评估自进化具身智能体的持续学习
Jie Huang Yanan Chen Ruixun Liu Kaichen He Xinyi He Rui Huang Zilong Zheng Zhenliang Zhang Yiwu Zhong
摘要
持续学习要求模型积累过往经验并将其迁移到新任务中。尽管持续学习已有大量研究,现有工作仍主要局限于非具身场景,尚未扩展到具身环境。为弥补这一空白,我们提出了 EmbodiedCLBench,这是首个在具身仿真环境中评估自进化智能体持续学习能力的基准。该基准以组合泛化为核心评估原则,评估智能体是否能够先从基础任务中学习,再重组已获得的技能以解决复杂且未见的高级任务。基于 EmbodiedCLBench,我们在多个智能体框架和学习方法上开展了大量实验,揭示了一致的局限性及独特行为。结果表明,虽然高级任务在零样本设定下几乎无法解决,但来自基础任务的经验能够带来稳定提升;即使任务复杂度增加,这种经验收益仍保持稳定。然而,这种提升并未随学习样本数量相应增长,当前智能体无法从额外经验中提取有意义的信息。总体而言,我们的发现表明持续学习是一项基础但尚未被充分探索的能力,我们的基准为在具身环境中设计有效的自进化智能体提供了宝贵资源。代码与数据集可在 https://pku-value-lab.github.io/EmbodiedCLBench-homepage 获取。
一句话总结
北京大学、BIGAI 等机构的研究人员提出了 EmbodiedCLBench,这是首个用于评估自进化 agent 持续学习的具身仿真基准。该基准采用组合泛化来测试 agent 能否重组基础任务技能以解决未见的高级任务。在多个 agent 框架和学习方法上的实验表明,基础任务经验带来一致但样本效率较低的提升,为具身持续学习提供了资源。
核心贡献
- 提出了 EmbodiedCLBench,作为首个用于评估自进化 agent 持续学习的具身仿真基准,其组合泛化被组织为原子动作、基础任务和高级任务。
- 在多个 agent 框架和学习方法上的实验表明,来自基础任务的经验相比零样本执行能持续提升未见高级任务的表现,且这种提升在任务复杂度增加时保持稳定。
- 该基准还表明,当前 agent 并未随着额外学习样本的增加而扩大这些收益,同时公开的代码和数据集支持具身环境中持续学习的进一步研究。
引言
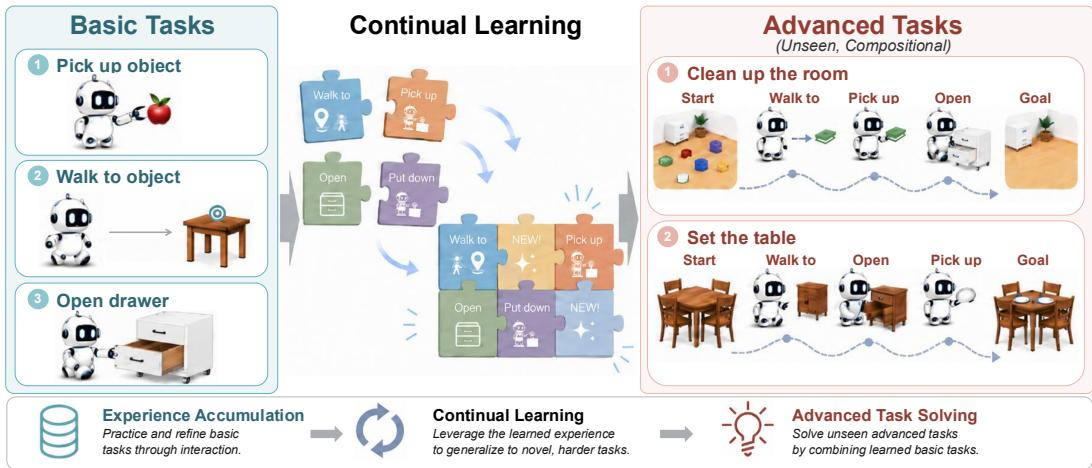
自进化 agent 需要持续学习,以便在不同任务之间积累经验并迁移技能,这对于在复杂且不可预测的物理环境中运行的具身智能尤为重要。先前的持续学习基准主要关注非具身的数字或符号环境,而现有的具身 AI 基准虽然评估感知、导航、操作和规划,但并未专门衡量持续学习。这导致在评估具身 agent 是否能够将先前经验复用于未见任务方面存在空白。作者提出了 EmbodiedCLBench,这是首个用于评估自进化 agent 持续学习的具身仿真基准,并使用组合泛化作为组织任务、评估协议以及从基础任务到高级任务技能迁移的原则性方法。
数据集
作者构建 EmbodiedCLBench,作为评估具身 agent 组合泛化的基准。构建过程包括四个阶段:环境搭建、任务生成、图构建和评估协议。
-
来源与平台
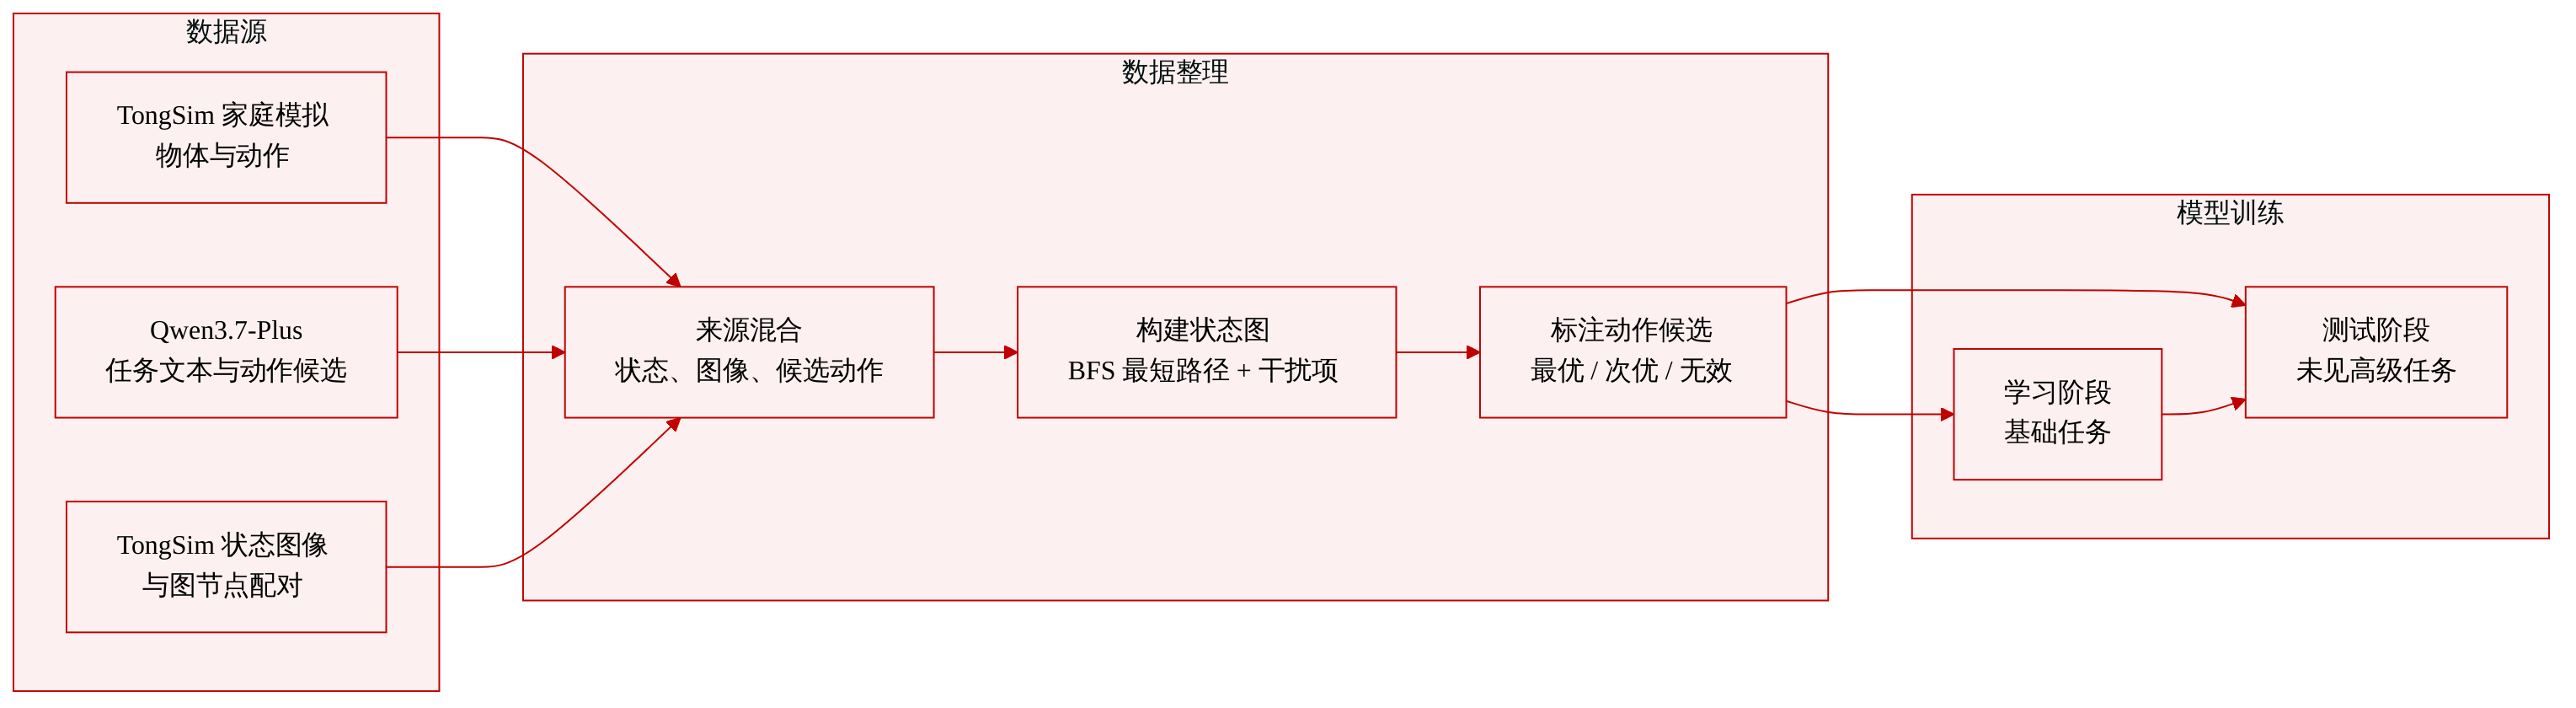
- 该基准使用 TongSim,一个家庭仿真平台,采用其闭源版本。
- TongSim 提供杯子、盘子、柜子、灯具和电器等可交互物体。
- 它支持可执行动作,例如走到、看向、拿起、放下、打开、关闭和打开开关。
- 任务描述和动作候选由 Qwen3.7-Plus 生成,并经过人工验证以确保正确性。
- 与图节点配对的图像从 TongSim 状态中捕获。
-
数据集组成
- 数据围绕原子动作、基础任务和高级任务进行组织。
- 原子动作是单物体交互,例如拿起杯子。
- 基础任务将少量原子动作组合成实用的家务操作。
- 高级任务比基础任务组合更多原子动作。
- 所提供的节选未说明具体任务数量或数据集规模;设计强调物体-动作组合的多样性。
-
图构建与处理
- 每个图节点表示一个唯一的环境状态,并与一张图像和一组动作候选配对。
- 每个可执行动作候选对应一条边,该边确定性地转移到下一个状态。
- 对于每个任务,定义初始状态和目标状态,并使用广度优先搜索寻找最短路径。
- 通过扩展偏离最短路径的替代可执行动作来创建干扰路径。
- 动作候选被分为最优动作、次优但可执行的动作,以及在当前状态下无法执行的无效动作。
-
数据使用方式
- 评估分为学习阶段和测试阶段。
- 在学习阶段,agent 完成基础任务以积累经验。
- 在测试阶段,agent 尝试未见的高级任务。
- 基础任务作为自进化 agent 的记忆和测试时学习数据。
- 评估是交互式且多轮的:agent 收到任务描述和初始图像,选择一个动作,转移到新状态,并收到带有更新候选的新图像。
- 评估持续进行,直到 agent 到达目标或耗尽步骤预算。
- 基于图的设置支持离线、确定性和可复现的评估,而无需运行仿真器。
方法
作者提出了一个用于构建 EmbodiedCLBench 的结构化流水线,包括四个连续阶段:环境搭建、任务生成、图构建和评估协议。
整体构建流水线如下图所示。
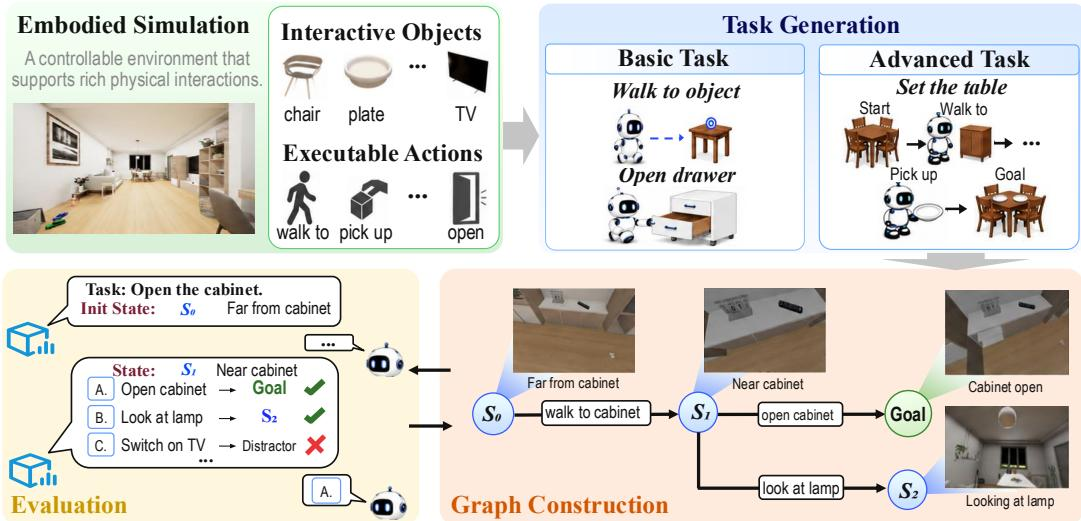
在任务生成阶段,作者通过组合泛化将持续学习评估具体化。系统将原子动作定义为与物体的单次交互,例如拿起某个物品。这些原子动作随后被组合成两个层次的任务。基础任务将少量原子动作组合成简单的家务操作。高级任务整合多个基础任务中的要素,形成更复杂、未见过的组合任务。这种层次化设计可以评估 agent 是否能够重组先前掌握的技能,以解决新问题,而无需从零开始学习。
在任务生成之后,作者实现了一个图构建模块,以支持离线且可复现的评估。由于底层仿真环境是闭源的,在线仿真并不现实。因此,任务过程被建模为状态转移图。图中的每个节点表示一个唯一的环境状态,并与第一人称视角图像和一组动作候选配对。每个可执行候选对应一条有向边,该边确定性地将 agent 转移到下一个状态。为了构建图,系统为给定任务定义初始状态和目标状态,并使用广度优先搜索算法确定它们之间的最短路径。此外,通过从最短路径上的节点扩展替代可执行动作来生成干扰路径,从而创建可执行但次优的轨迹,以实现稳健评估。
在评估协议中,agent 观察当前状态,并从提供的候选中选择一个动作。根据所选动作,agent 转移到预先计算图中对应的下一个节点。这种基于图的方法支持并行离线评估、通过图分支灵活控制任务复杂度,以及通过将每个决策与标注轨迹进行比对来进行细粒度行为分析。
实验
该基准通过仿真家务任务中的组合泛化来评估持续学习,比较零样本 agent 与在尝试未见高级任务之前从基础任务轨迹或简洁技能摘要中学习的 agent。结果表明,先前经验能够持续从简单任务迁移到高级任务,相比较弱的零样本表现大幅提高了成功率。进一步分析表明,这种收益在组合复杂度增加时保持稳定,主要来自单个学习样本之后,而不是随着样本增加而扩大;它使决策更倾向于最优动作并远离无效动作,并且在不同步骤预算下持续存在。
在基础任务上,agent 取得了中等的零样本成功率,但在高级任务上的零样本表现要低得多。上下文学习和技能学习都提高了不同框架和模型下高级任务的成功率,表明基础任务经验能够迁移到未见的高级任务。错误分析显示,这种提升伴随着更少的无效动作和更多的最优动作。基础任务上的零样本成功率中等,但在高级任务上急剧下降。上下文学习和技能学习都提高了不同框架和模型下高级任务的表现,两种方法均未始终优于对方。
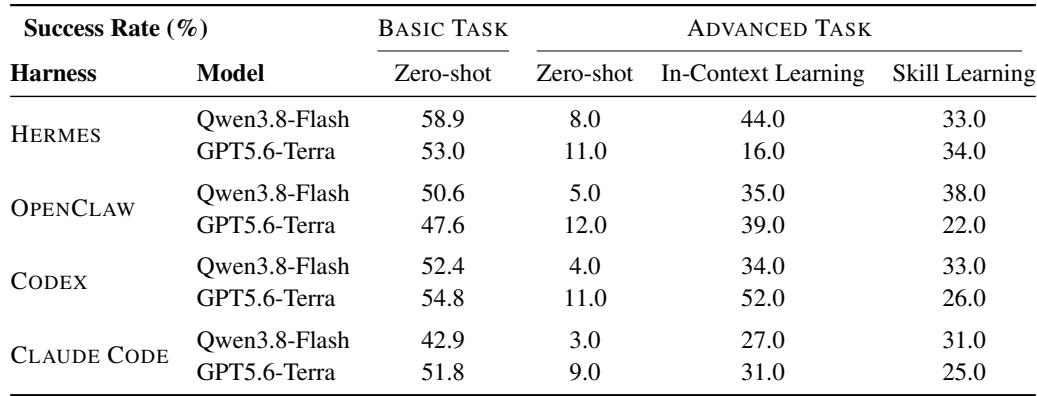
实验在多个框架和模型上评估了 agent 在基础任务和高级任务上的表现。在基础任务上,agent 取得了中等的零样本成功率,但在高级任务上的表现要低得多。上下文学习和技能学习都提高了高级任务的成功率,表明基础任务经验能够迁移到未见的高级任务;错误分析显示,这些收益伴随着更少的无效动作和更多的最优动作。两种方法均未始终优于对方。