Command Palette
Search for a command to run...
Reflex
Reflex
Taoyang Jia Weikai Huang Linxin Song Jared Darlington Jieyu Zhao Yue Wang Jiafei Duan Zhongzheng Ren Ranjay Krishna
摘要
人类能够毫不费力地对世界作出反应:他们能熟练地回击网球、接住下落的杯子、避让经过的手推车,或在卡车卸货时接传抛来的箱子。这些日常动作需要预测运动目标,并在大约一秒内用全身作出反射式响应。这种视觉反应式全身控制对人形机器人仍然具有挑战性,因为机器人必须(1)协调全身控制,(2)实时响应物体动力学,以及(3)将感知建立于第一人称视觉之上。我们将接住抛来的箱子作为一项代表性任务来研究,它同时要求上述三种能力;现有系统通常只覆盖其中一部分,并依赖末端执行器、动作捕捉或标记物体。我们提出 Reflex,一个三阶段框架,该框架逐阶段学习这些能力,并通过物体动力学的紧凑表示将它们连接起来。首先,基于状态的策略通过强化学习学会全身接住箱子。其次,该策略学习从延迟且不完整的观测中推断运动箱子的动力学。第三,第一人称 RGB-D 编码器学习直接从视觉观测中恢复该动力学表示,同时保持全身控制器固定。这种分解为每种能力提供了直接训练信号,并使视觉学习的可扩展性显著提高。在仿真中,Reflex 基于第一人称 RGB-D 实现 85.7% 的接住箱子成功率,而在获得箱子的特权观测时为 87.9%。时间视觉历史至关重要:移除它会使居中和横向偏移投掷的成功率分别下降 36.5和39.8个百分点。在真实的 Unitree G1 上,Reflex 在 2.5米和5米处接住人类抛出的箱子的成功率分别为 65% 和 40%,达到人类接箱者在相同距离下成功率的 76% 和 59%。
一句话总结
来自华盛顿大学、斯坦福大学、南加州大学等机构的研究者提出 Reflex,一个用于视觉反应式全身接物的三阶段框架,分别训练强化学习控制器、动力学推断模块和自我中心 RGB-D 编码器,同时保持控制器冻结,仿真成功率为 85.7%,在真实 Unitree G1 上 2.5m 距离的接物成功率为 65%。
核心贡献
- Reflex 是一个用于人形机器人接箱的三阶段框架,学习全身控制、物体动力学推断和自我中心 RGB-D 感知,并通过紧凑的物体动力学表示将它们连接起来。
- 该方法首先训练基于状态的强化学习策略,用于 29 自由度全身接物,然后从延迟且不完整的观测中学习推断移动箱体的动力学,最后训练自我中心 RGB-D 编码器,在保持全身控制器固定的情况下,从视觉历史和相机自身运动恢复这一动力学表示。
- 在仿真中,Reflex 基于自我中心 RGB-D 的接物成功率为 85.7%,而使用特权箱体观测为 87.9%;去掉时序视觉历史后,居中投掷和横向偏移投掷的成功率分别下降 35.6 和 39.8 个百分点。在真实 Unitree G1 上,Reflex 对人类投掷箱体在 2.5 m 和 5 m 距离的接物成功率分别为 65% 和 40%,达到人类接物者成功率的 76% 和 59%。
引言
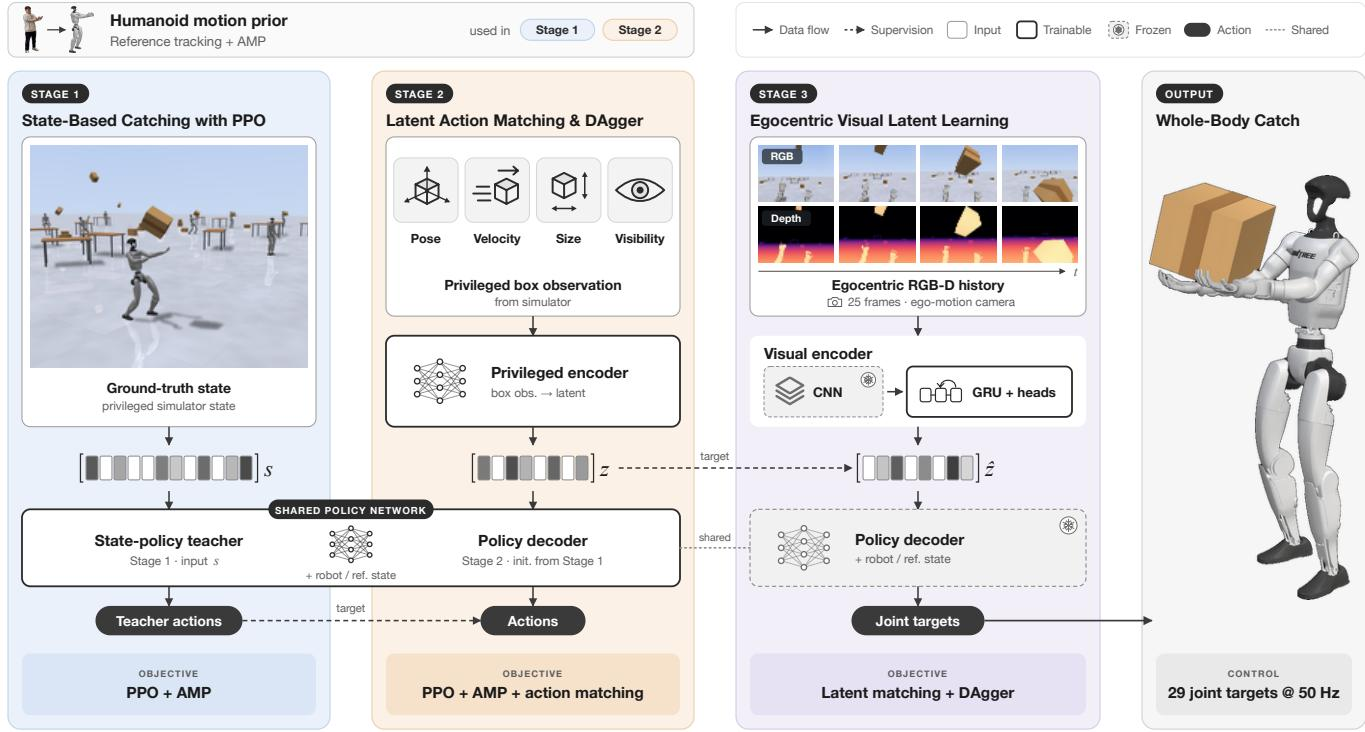
作者将在人形机器人上接住人类投掷的箱体作为一项具有代表性的视觉反应式全身控制任务进行研究。这一能力之所以重要,是因为机器人必须预测快速移动物体的去向,决定如何迎接或避开它,并在接触前协调手臂、躯干、脚和平衡,通常只有约一秒时间,且只能使用机载传感。先前工作只解决了部分问题:机械臂从固定或轮式底座上接物,而人形机器人接物系统通常依赖运动捕捉或反光标记,而不是机载视觉。因此,全身控制、快速物体动力学预测和自我中心视觉接地很少在真实人形机器人上结合。作者提出 Reflex,一个三阶段框架,利用强化学习和人类运动先验从特权仿真中学习全身接物,从延迟且不完整的观测中学习移动箱体动力学的潜在表示,然后训练视觉模型从自我中心 RGB-D 历史和相机自身运动恢复该潜在表示,同时保持全身控制器固定。
方法
作者将部署策略分解为视觉感知函数 Vψ 和全身控制函数 πθ。给定 K 帧自我中心 RGB-D 观测历史和相机自身运动,Vψ 预测一个八维物体动力学潜在变量。控制器将该潜在变量与机器人和参考观测 rt∈R160 结合,生成归一化的 29 自由度动作:
zt=Vψ(It−K+1:t,et−K+1:t),at=πθ(rt,zt).动作转换为名义关节位置目标:qtnom=q0+s⊙at,其中 q0 是名义关节构型,s 包含各关节动作缩放。为避免联合端到端训练的计算开销和优化困难,作者将学习组织为三个独立阶段。
阶段 1 通过使用近端策略优化(PPO)从箱体状态学习全身控制,分离出运动技能。基于状态的接物策略 πstate 使用 170 维观测进行训练,该观测将机器人输入与十个箱体状态通道结合。Actor 是一个多层感知机,产生 29 个输出。接物目标包括接近塑形、保持塑形和持续接住奖励,并通过跟踪重定向的人类参考运动和对抗运动先验(AMP)进行引导。训练后,教师策略被冻结,为下一阶段提供动作监督。
阶段 2 通过将延迟、部分观测到的箱体观测压缩为潜在表示来学习物体动力学。特权编码器 Eϕ 将 26 通道箱体观测 pt 映射到 8 维潜在变量 zt=Eϕ(pt)。编码器处理延迟窗口中最新的可见样本。初始化通过行为克隆完成,以匹配教师动作:
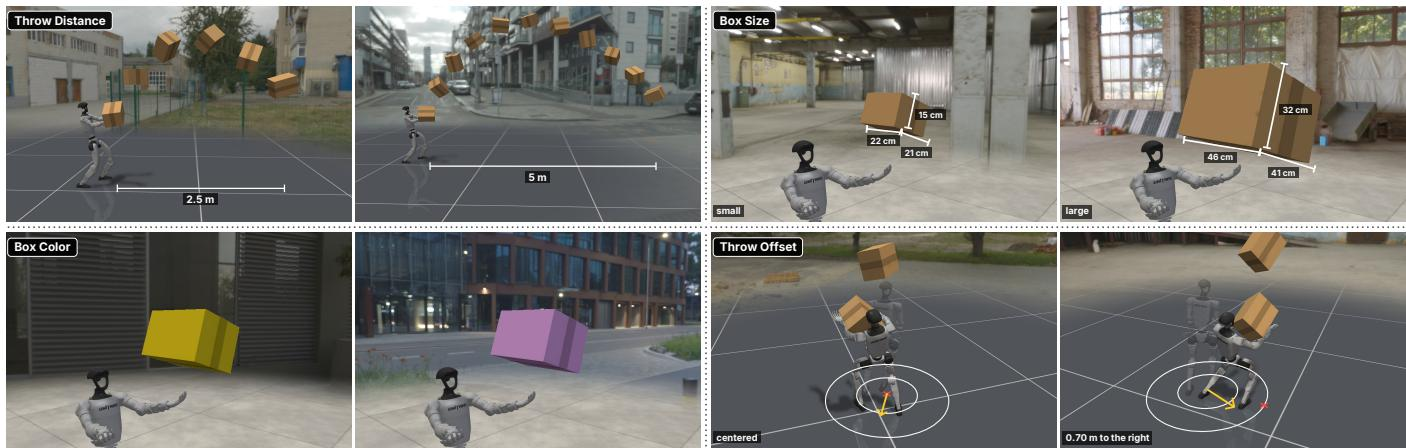
LBC=EDA[wtvisπθ(rt,Eϕ(pt))−atT22].在动作匹配和 DAgger 式数据聚合之后,PPO 联合优化特权编码器和完整解码器。训练中加入随机化的投掷距离、箱体尺寸、颜色和落点,以确保在不同工况下的鲁棒性。
阶段 3 通过来自 RGB-D 和自身运动历史的监督回归,将动力学潜在变量接地到自我中心视觉,同时保持控制器固定。视觉编码器 Vψ 使用历史长度 K=25。卷积神经网络预测箱体定位热图,固定的几何层从该热图形成 8 维特征向量。门控循环单元(GRU)处理这些特征以及自身运动向量,以推断物体运动。训练分两步进行。首先,使用高斯目标训练 CNN 和热图头。其次,训练 GRU 预测动力学潜在变量以及辅助箱体位置和速度。时序训练目标为:
LV=EDV[ωt(ℓz(t)+λauxℓstate(t))]其中 ℓz(t) 测量归一化潜在误差,ℓstate(t) 测量辅助状态误差。第二个 DAgger 式过程聚合来自视觉控制器推演的数据以细化 GRU。
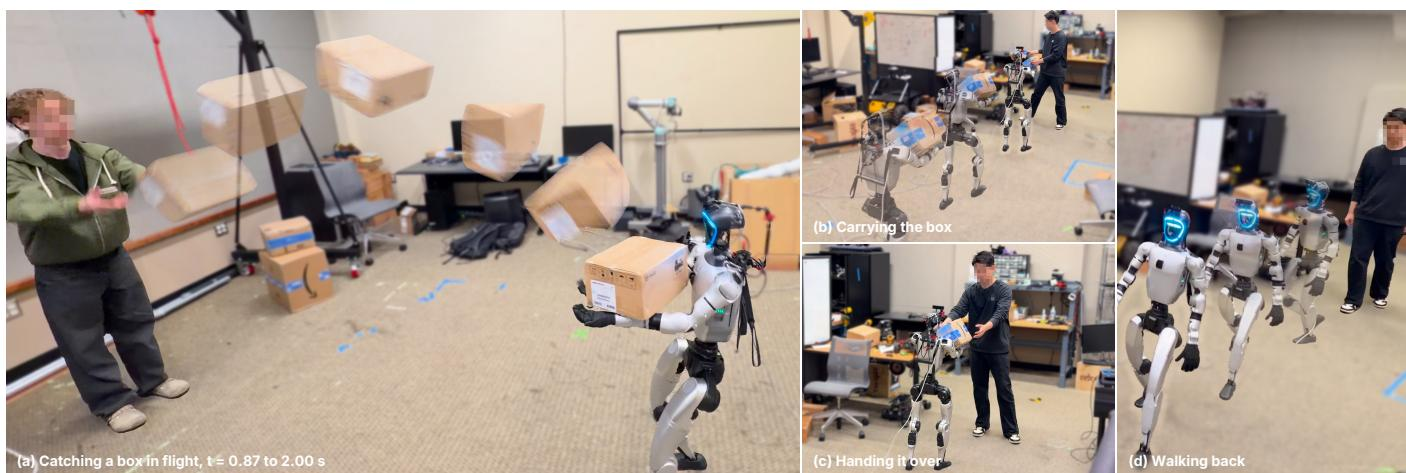
下游搬运和交接模块将接物策略连接到预训练的运动控制器。一旦建立稳定的握持,监督器就转移指令权限,将增益和观测切换到行走控制器。参考动作先保持当前姿态,然后过渡到站立怀抱姿态以进行行走和交接,并通过视觉人体检测识别接收者。
实验
实验在仿真和真实 Unitree G1 人形机器人上评估 Reflex,使用拦截、接住保持和接住后稳定性分别定义成功标准,并与特权状态输入、消融实验和人类接物者进行比较。全身消融表明任务奖励和运动先验至关重要;物体动力学实验表明行为克隆初始化和延迟随机化改善了潜在预测和鲁棒性;视觉接地实验表明时序历史和自身运动线索很重要,而颜色增强降低了外观敏感性。总体而言,视觉控制在仿真中保留了大部分特权接物性能,机器人在较短距离上接近人类成功率,但远距离视觉接地和分布外箱体尺寸仍是主要限制。
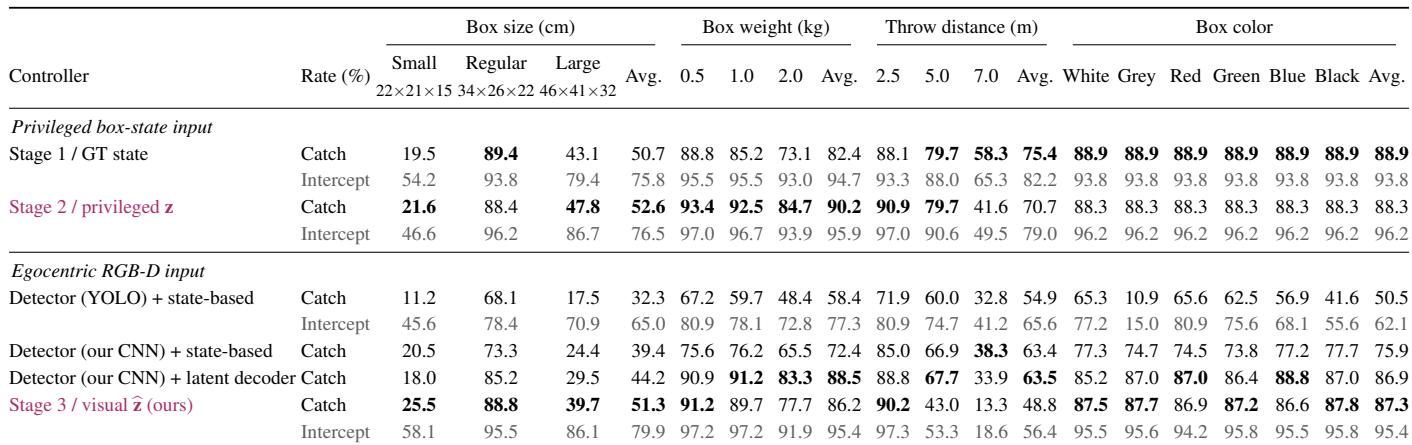
在特权箱体状态输入下,常规箱体尺寸和较轻重量时成功率最高,而小箱体、更重箱体和更长投掷距离会降低接住和拦截成功率。拦截率始终高于接住率,箱体颜色不影响特权策略。在视觉训练范围内,视觉潜在控制优于使用相同检测器的检测加滤波方法。常规训练箱体尺寸是最强条件,小箱体最难,大箱体居中。更重箱体和更长投掷距离会降低成功率,最长距离导致最大下降。在相同特权状态输入下,拦截始终比接住更频繁。箱体颜色不改变特权策略性能,所有测试颜色下成功率相同。使用相同检测器时,在视觉训练范围内,视觉潜在控制优于检测加滤波。
真实机器人接物者在常规箱体、中等箱体重量和 2.5 m 投掷距离下表现最佳。小箱体或大箱体、最重箱体和更长投掷距离会降低成功率。人类参考接住率始终更高,机器人在 2.5 m 处达到人类成功率的约四分之三,在 5 m 处略高于一半。箱体尺寸对机器人影响很大,常规箱体获得最高接住率,小箱体导致最大下降;人类成功率在各尺寸间变化较小。在箱体重量方面,机器人成功率在 1 kg 时达到峰值,在 2 kg 时下降,而人类接住率保持相对平稳。投掷距离使机器人的成功率从 2.5 m 到 7 m 急剧下降,人类表现也有所下降但仍更高。在 2.5 m 和 5 m 处,机器人分别达到人类成功率的 76% 和 59%。
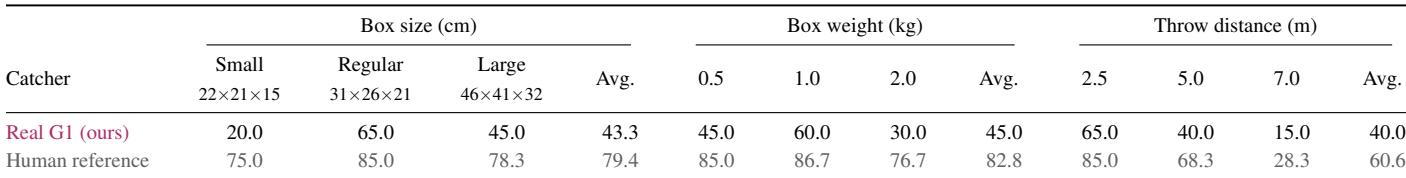
特权箱体状态实验验证了常规箱体尺寸和较轻重量可获得最高成功率,而小箱体、重箱体和更长投掷距离会降低接住和拦截;拦截率始终高于接住率,箱体颜色没有影响。视觉潜在控制在视觉训练范围内也优于使用相同检测器的检测加滤波方法。真实机器人测试确认了这些趋势,在常规箱体、中等重量和 2.5 m 投掷下表现最佳,而小箱体或大箱体、最重重量和更长距离会降低成功率。与人类参考接住相比,机器人在 2.5 m 处达到人类成功率的约四分之三,在 5 m 处略高于一半。