Command Palette
Search for a command to run...
SOFTWAREGYM:通过多样化合成软件环境扩展计算机使用智能体训练
SOFTWAREGYM:通过多样化合成软件环境扩展计算机使用智能体训练
Tian Jin Wenhao Wang Jing Kang Haoting Shi Rui Ye Yijun Lu Siheng Chen
摘要
计算机使用智能体(CUA)正在快速发展,但大规模合成多样且可靠的软件环境仍然具有挑战性。原生应用环境需要大量的构建与集成工作,这限制了应用覆盖范围,并增加了面向特定应用过拟合的风险。浏览器托管环境提供的交互深度和工作流复杂度有限。这些局限促使我们提出 SoftwareGym,一个自动合成 GUI 软件环境的流水线,能够生成多样化界面、可执行功能以及经过运行时验证的行为。该流水线生成结构多样的设计,将其实现为可运行的应用,并通过 GUI 评估与迭代修复确保功能可靠性。借助 SoftwareGym,我们在 12 个类别中合成了 182 个应用,平均 GUI 任务通过率达到 91.5%。我们构建了 SoftwareGym-Bench,一个涵盖相同 12 个类别的 120 项任务评测套件,并使用从这些环境中收集的轨迹进行 CUA 训练。所得模型在严格域外 OSWorld 基准上将 Pass@3 从 41.39% 提升至 56.97%,并在 SoftwareGym-Bench 上达到 40.0%。这些结果表明,合成软件环境有潜力作为可扩展且可迁移的监督信号用于 CUA 训练。
一句话总结
上海交通大学和浙江大学的研究人员提出了 SoftwareGym,这是一个自动化流水线,通过迭代式 GUI 评估与修复来合成多样化、可运行的 GUI 软件环境,并验证其运行时行为;该流水线生成了覆盖十二个类别的 182 个应用,平均 GUI 任务通过率为 91.5%;构建了同样覆盖十二个类别的 120 任务 SoftwareGym-Bench 评估集;并产出了一个 computer-use agent,在严格域外的 OSWorld 基准上将 Pass@3 从 41.39% 提升至 56.97%,并在 SoftwareGym-Bench 上达到 40.0%。
核心贡献
- 本文引入了 SoftwareGym,这是一个自动化设计-实现-评估流水线,可合成结构多样的独立桌面应用,并通过 GUI 评估与迭代修复来保证功能可靠性,在十二个类别的 182 个应用上实现了 91.5% 的平均 GUI 任务通过率。
- 发布的软件库包含十二个类别的 182 个可运行应用,而 SoftwareGym-Bench 提供了同样覆盖十二个类别的专门 120 任务测试集。
- 仅在这些合成环境的轨迹上训练,不使用任何 OSWorld 应用数据,即可将 OSWorld 上的 Pass@3 从 41.39% 提升到 56.97%,并在 SoftwareGym-Bench 上达到 40.0%。
引言
训练 computer-use agent 需要来自可执行软件环境的交互数据,这些环境需具备多样性、真实性和可靠性。此前的方法无法同时满足这些需求:原生桌面与移动应用保留了真实状态和复杂工作流,但集成成本高,并存在特定应用过拟合的风险;而浏览器托管环境易于扩展,但其共享的网页基础限制了交互深度和工作流复杂度。作者提出了 SoftwareGym,这是一个自动化设计-实现-评估流水线,可合成独立桌面应用,具备可控的功能规格、多样化的界面与交互设计,并采用源代码级与 GUI 相结合的双重验证。该流水线生成了十二个类别的 182 个可运行应用,平均 GUI 任务通过率为 91.5%;从这些应用收集的轨迹在不使用任何 OSWorld 应用、任务或轨迹进行训练的情况下,将 agent 的 OSWorld Pass@3 从 41.39% 提升到 56.97%。
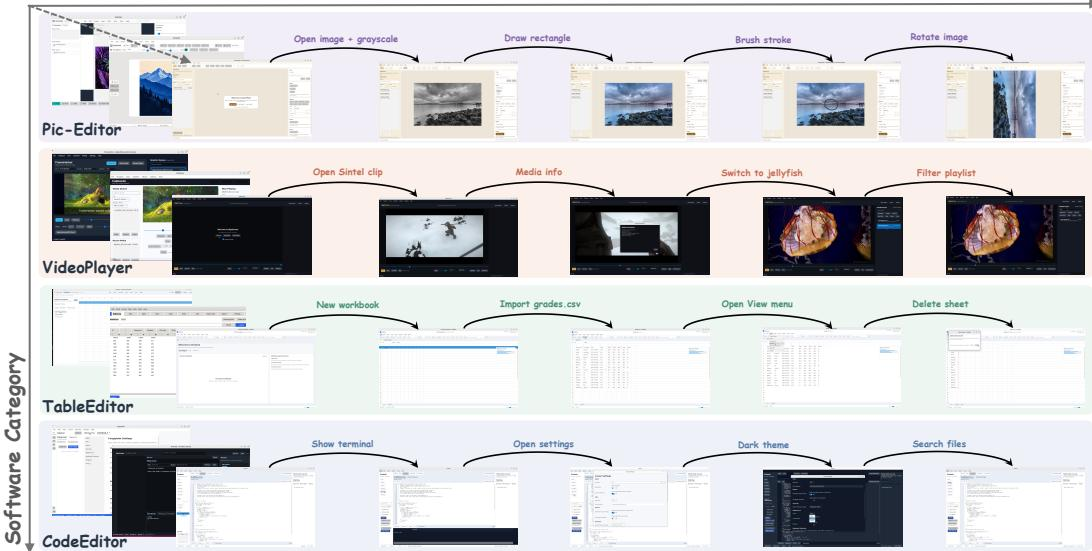
数据集
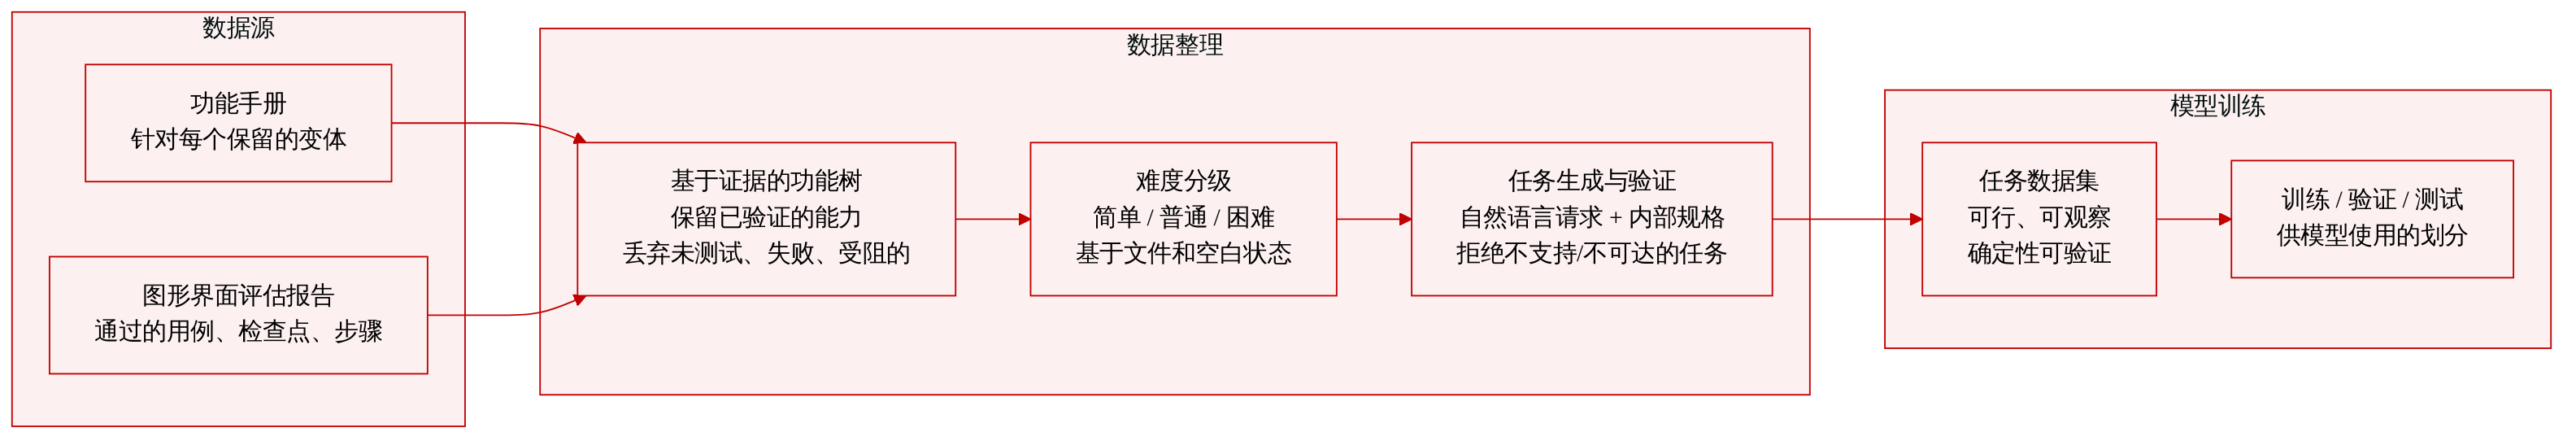
- 构成与来源:该数据集由基于保留下来的软件变体构建的合成 GUI 任务组成。来源材料包括每个变体在实现阶段生成的功能手册,以及其 GUI 评估报告,后者标明了在实际运行应用中已经验证过的能力。
- 能力过滤:流水线构造一棵基于证据的功能树。只有当一个能力引用了通过的用例、检查点或交互步骤时,才被标记为支持。未测试功能、失败功能和被阻断路径都会被排除。每个树的叶节点记录能力、支持状态、GUI 入口点、约束条件、可观察状态和评估证据。
- 难度子集与任务类型:任务被划分为简单、正常和困难三个级别。简单任务具有一个主要目标,组合程度有限。正常任务将相关对象或操作与必要依赖组合在一起。困难任务构成多阶段工作流,每个阶段都建立下一阶段所需的状态。每个难度级别包含两种任务类型:基于文件的任务,从已有输入文件开始;空状态任务,从应用的默认 GUI 状态开始。不相关或重复的动作不能仅为了增加难度而添加。
- 任务生成与模式:每个计划的工作流都会转换为一个自然语言用户请求和一个内部评估规范。面向用户的请求隐藏坐标、详细操作路径、能力标识符和评估机制。内部规范记录初始状态、结果标准、过程标准和预期最终状态。确定性验证会拒绝不支持的能力、不一致的初始状态、不兼容的资产和不可达的最终状态。
- 论文中的使用:生成的自然语言任务具有可行、可观察且可确定性验证的需求。本节不规定具体的子集大小、训练划分或数据混合比例;而是描述任务数据集的构建与过滤方式。
方法
作者提出了 SoftwareGym,这是一个用于合成多样、可靠且可执行的应用以及相应 GUI 任务的流水线。整体框架分为三个主要阶段:设计、实现和评估。
参见框架图
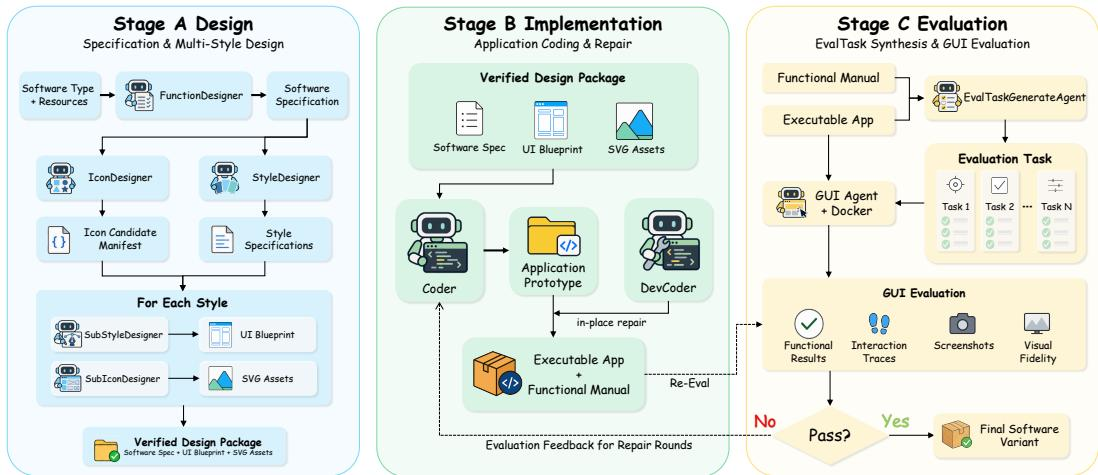
在阶段 A,软件设计环节生成丰富的功能规格和不同的界面。给定一个软件类型和支持资源,FunctionDesigner 通过四步工作流扩展初始描述。它建立功能基线,用领域特定的专业功能扩展模块,将这些功能连接成完整的用户工作流,并将每个功能作为实现与评估契约记录在软件规范中。随后,StyleDesigner 生成多个不同的 UI 蓝图,以不同的界面设计实现相同的功能。为确保结构独特性,系统计算归一化布局树之间的成对树编辑距离,并重新生成低于预定义阈值的蓝图。同时,IconDesigner 推导出与样式无关的图标候选清单,而 SubIconDesigner 将其渲染为特定样式的 SVG 资产。这些组件被编译成一个验证设计包,包含软件规范、UI 蓝图和 SVG 资产。
在阶段 B,实现环节将每个验证设计包转化为可运行的应用。Coder 使用该包完成完整的 Avalonia 应用,包括其结构、视觉系统、图标和功能。然后,DevCoder 根据功能手册审查实现,检查命令绑定、应用逻辑和持久化,并修复任何缺失或不完整的实现。
在阶段 C,评估环节独立测试运行中的应用。EvalTaskGenerateAgent 从经源代码验证的功能手册生成评估用例。GUI Agent 通过鼠标和键盘操作执行这些用例,并记录交互轨迹和失败位置。功能通过率计算为 Pfunc=Npass/Nall,其中 Npass 是通过的任务数,Nall 是生成用例的总数。如果应用失败,评估反馈会返回到实现阶段进行原地修复。此外,归一化的视觉保真度分数确保实现修复保持预期的界面结构。通过所有用例并保持设计保真度的应用进入最终软件库。
软件变体通过验证后,系统进入任务合成阶段,将已验证的功能转换为可执行的 GUI 任务。
如下图所示:
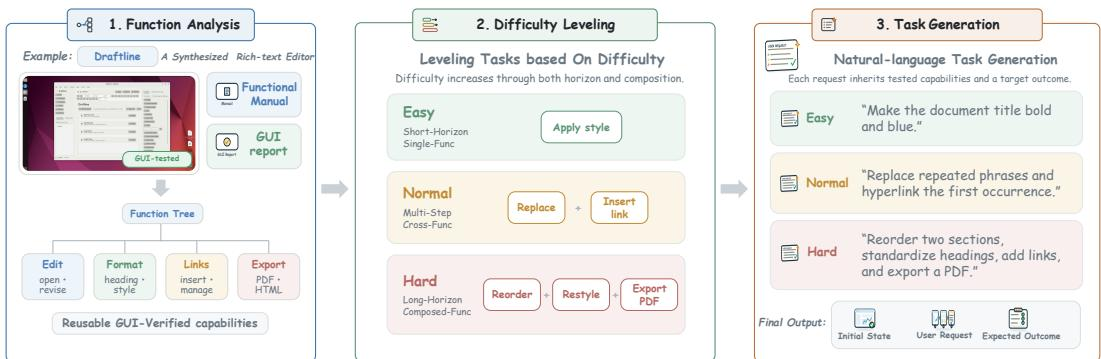
任务合成包括三个步骤:功能分析、难度分级和任务生成。首先,功能分析识别通过 GUI 交互验证的应用能力。它提取功能手册,并使用 GUI 评估报告构建基于证据的功能树。只有当一个能力引用了通过的用例或交互步骤时,才被标记为支持,从而防止任务生成依赖未经测试的功能。
接下来,难度分级通过已验证能力之间的依赖关系控制任务复杂度。任务被分为三个难度等级:简单、正常和困难。简单任务涉及一个主要目标,功能组合有限。正常任务将相关对象或操作与必要的依赖关系相结合。困难任务构成多阶段工作流,每个阶段为下一阶段建立所需的状态。每个难度等级都包括基于文件的任务,从已有输入文件开始,以及空状态任务,从默认 GUI 状态开始。
最后,任务生成将每个计划的工作流转换为自然用户请求和可执行的评估规范。它根据手册、已通过的 GUI 证据和状态依赖关系验证所选能力。生成的面向用户的请求描述一个单一的用户目标,不暴露坐标或详细操作路径,而内部任务规范记录初始状态、结果标准和预期最终状态。确定性验证确保生成的自然语言任务保持可行、可观察且可确定性验证。
实验
实验评估了 SoftwareGym,这是一个合成具有受控视觉风格的应用、实现这些应用并使用 GUI 引导测试进行迭代修复的流水线。仅在 SoftwareGym 轨迹上训练的 9B 模型将 OSWorld Pass@3 从 41.39% 提升到 56.97%,将 SoftwareGym-Bench Pass@3 从 25.8% 提升到 40.0%,显示出可迁移的域外收益和域内收益。该库提供十二个类别的 182 个可运行应用,评估引导修复将平均 GUI 通过率从 54.9% 提升到 91.5%,同时消融实验证实样式设计增加了结构多样性,GUI 反馈对于可靠修复至关重要。
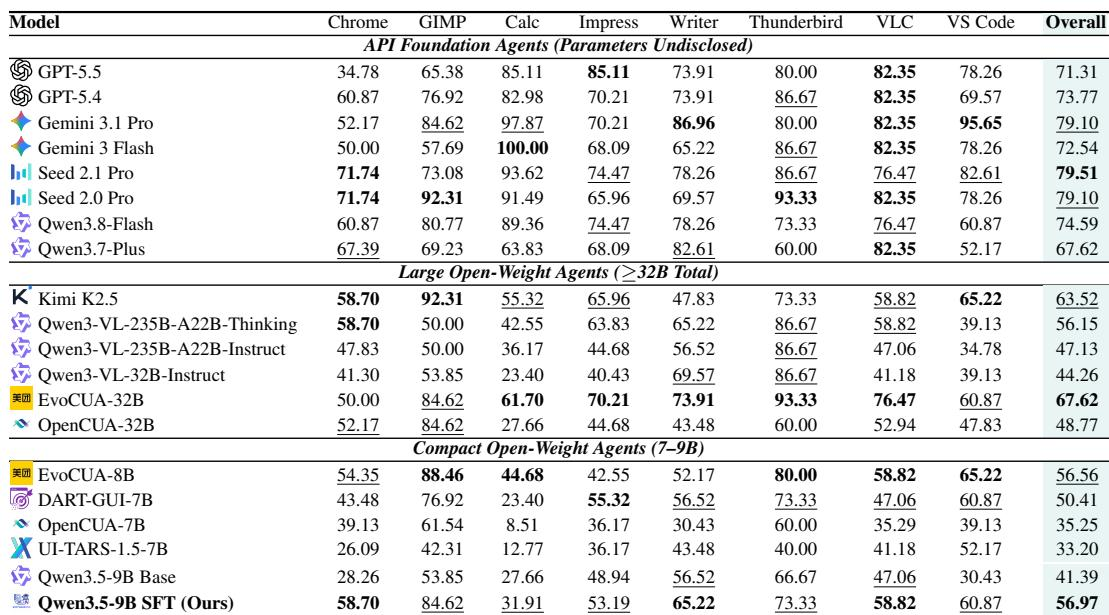
在 OSWorld 上,API 基础 agent 表现出与应用相关的性能,多个模型在 Calc 和 VLC 上的得分远高于 Chrome,Gemini 3.1 Pro 和 Seed 模型整体领先,而 GPT-5.5 落后。所引用的分析报告指出,仅使用 SoftwareGym 的监督改善了所有评估的 OSWorld 领域,并在没有任何 OSWorld 训练数据的情况下大幅提高了整体 Pass@3。在 API 基础 agent 中,Gemini 3.1 Pro 和 Seed 2.1 Pro 取得了领先的整体 OSWorld 得分,而 GPT-5.5 在该组中整体得分最低。仅使用 SoftwareGym 的监督可迁移到所有评估的 OSWorld 领域,并在不使用 OSWorld 训练数据的情况下将整体 Pass@3 从 41.39% 提升到 56.97%。
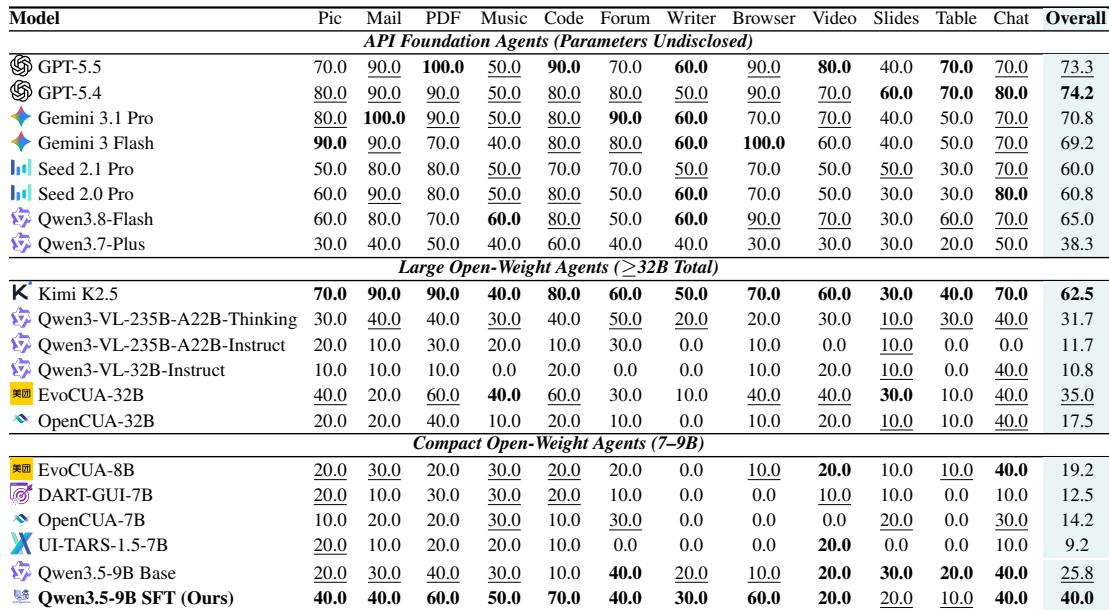
在 SoftwareGym-Bench 上,API 基础 agent 表现出不均衡的领域性能,GPT-5.4 和 GPT-5.5 整体领先,Seed 模型落后。涉及邮件和浏览器交互的任务通常表现更强,而音乐和幻灯片仍较弱。相关分析指出,SoftwareGym 监督将紧凑的 9B 模型提升到 40.0% 的整体水平,超过 Qwen3.7-Plus 和多个更大的专用 CUA。在 API 基础 agent 中,GPT-5.4 和 GPT-5.5 取得了最高的整体通过率,而 Seed 2.0 Pro 和 Seed 2.1 Pro 整体排名最低。在所列模型中,邮件和浏览器类别的表现通常最强,音乐和幻灯片类别最弱。SoftwareGym 监督使相同的 9B 基础模型提升了超过 14 个百分点,并在紧凑规模上产生了有竞争力的域内结果。
不同的训练软件来源对 OSWorld 和 SoftwareGym-Bench 的性能影响不均衡。仅在 SoftwareGym 应用上训练在多个单独的 OSWorld 应用上具有竞争力,但在整体 OSWorld 上低于仅在 OSWorld 数据上训练。在 SoftwareGym 数据中加入 OSWorld 轨迹改善了 SoftwareGym-Bench 结果,而整体 OSWorld 性能仍略低于仅使用 OSWorld 的设置。仅使用 SoftwareGym 的训练在 Chrome 和 VS Code 上优于仅使用 OSWorld 的训练,但在 Calc、Impress、Writer 和 VLC 上表现不佳,导致整体 OSWorld pass@3 较低。将 OSWorld 和 SoftwareGym 轨迹相结合,使 SoftwareGym-Bench 从 40.0% 提高到 47.5%,而整体 OSWorld 与仅使用 OSWorld 的训练相比从 61.48% 下降到 58.61%。

这些实验评估了 API 基础 agent 在 OSWorld 和 SoftwareGym-Bench 上的表现,并考察训练软件来源的迁移效果。在 OSWorld 上,性能因应用而异,Gemini 3.1 Pro 和 Seed 模型总体领先,GPT-5.5 落后,而 SoftwareGym 监督在不使用 OSWorld 训练数据的情况下改善了所有 OSWorld 领域。在 SoftwareGym-Bench 上,GPT-5.4 和 GPT-5.5 领先,Seed 模型落后,而 SoftwareGym 监督帮助紧凑的 9B 模型超越较大的 agent,尤其是在邮件和浏览器任务中。训练来源的比较表明,仅使用 SoftwareGym 的训练在 OSWorld 应用上的迁移不均衡,而加入 OSWorld 数据可以改善 SoftwareGym-Bench,但与仅使用 OSWorld 的训练相比,整体 OSWorld 略有下降。