Command Palette
Search for a command to run...
DIFFUSIONART:高效、稳定且可扩展的扩散模型强化
DIFFUSIONART:高效、稳定且可扩展的扩散模型强化
Zhenglin Wan Jiayu Chen Zhengfeiyang Zhang Pengfei Zhou Wangbo Zhao Fangyuan Kong Pengfei Wan Kun Gai Yang You
摘要
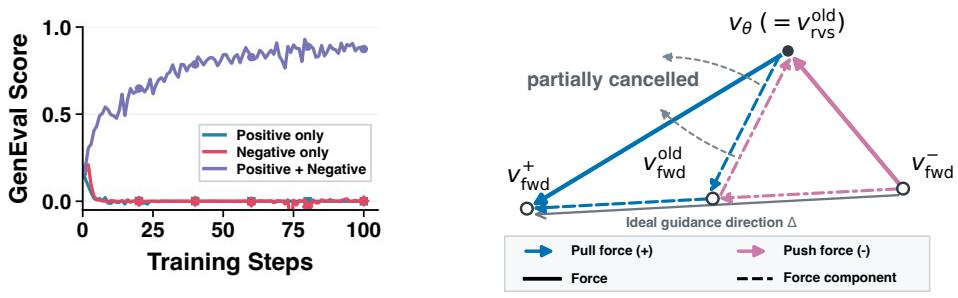
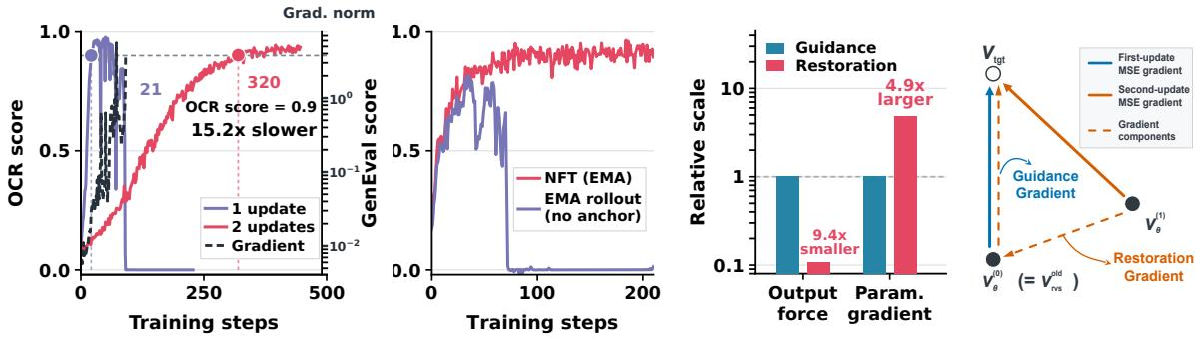
在线强化学习(RL)通过黑盒奖励微调扩散模型,但反向过程方法(如 Flow-GRPO)因信用分配不佳而在效率上受限;前向过程方法(如 DiffusionNFT)虽然高效,但若缺乏经过仔细调参的指数移动平均(EMA)离线策略训练则不稳定。我们表明,NFT 风格目标中包含一个隐藏的前向-反向一致性力,正负样本联合训练仅能部分抵消该力;EMA 通过恢复(restoration)而非离线策略 rollout 来稳定训练。我们提出 DiffusionART(Diffusion Reinforcement with Aggregation-First Reward Tilting),该方法将每个提示(prompt)的奖励聚合为反向过程状态共享的奖励改进方向,从构造上消除一致性力,并加入一个信任域掩码的第二次更新,以在无需 EMA 调参的情况下实现漂移自适应恢复。它无需可微奖励模型,在每个提示样本数较少时仍然有效,并支持成对奖励模型(DiffusionART-Pairwise)。在图像和视频生成任务中,DiffusionART 无需按任务调参即可高效且稳定地训练。特别是在 HunyuanVideo-13B 上,使用等权重视觉质量与运动质量奖励时,DiffusionART 达到 DiffusionNFT 和 Flow-GRPO-Fast 的后期平均奖励水平,所用 GPU 小时数分别减少 12.02× 和 11.72×,同时平均训练奖励分别提高 28.8% 和 53.0%。
一句话总结
新加坡国立大学 HPC-AI 实验室、Kling AI 与香港科技大学(HKUST)提出 DiffusionART,该方法将每个提示的奖励聚合为反向过程状态共享的奖励改进方向,从构造上消除了该一致性力,并加入带信任域掩码的第二更新,用于漂移自适应恢复,无需 EMA 调参,从而实现高效稳定的图像和视频生成。在 HunyuanVideo-13B 上,该方法以分别少 12.02 倍和 11.72 倍的 GPU 小时数达到了 DiffusionNFT 和 Flow-GRPO-Fast 的后期平均奖励水平,同时平均训练奖励分别高出 28.8% 和 53.0%。
核心贡献
- 论文表明,NFT 式前向过程目标包含一种隐藏的前向-反向一致性力,联合正负训练只能部分抵消该力,而 EMA 稳定机制通过恢复而非离策略 rollout 发挥作用。
- 该方法引入 DiffusionART,将每个提示的奖励聚合为反向过程状态共享的奖励改进方向,从构造上消除一致性力,并加入带信任域掩码的第二更新,用于漂移自适应恢复,无需 EMA 调参或可微奖励模型。
- 论文还针对成对奖励模型提出 DiffusionART-Pairwise,并报告了图像和视频生成上的高效稳定训练。在 HunyuanVideo-13B 上,DiffusionART 以少 12.02 倍和 11.72 倍的 GPU 小时数达到 DiffusionNFT 和 Flow-GRPO-Fast 的平均奖励水平,同时平均训练奖励分别提高 28.8% 和 53.0%。
引言
奖励引导微调对现代图像和视频扩散模型及流模型很重要,因为标准训练优化的是噪声或速度回归,而不是视觉质量、运动质量或人类偏好等下游指标。在线扩散强化学习可以使用完整生成样本的黑盒奖励,但面临信用分配问题,因为输出级反馈必须传递到许多去噪状态。此前的在线方法存在明显权衡:Flow-GRPO 等反向过程方法需要 ODE 到 SDE 的转换,并受噪声轨迹级信用分配影响;而 DiffusionNFT 等前向过程方法虽然高效,但若没有联合正负训练和任务调优的 EMA rollout 策略,则不稳定。作者将 NFT 式不稳定诊断为隐藏的前向-反向一致性力,联合训练只能部分抵消该力,而 EMA 通过恢复而非离策略 rollout 来实现稳定。他们的贡献 DiffusionART 采用聚合优先的奖励倾斜,为反向过程状态分配共享的奖励改进方向,并添加信任域恢复更新,从构造上消除有害力,避免针对每个任务的 EMA 调参,同时保持高效稳定的奖励提升。
方法
作者首先考察了 NFT 式前向过程训练中的稳定机制,特别是联合正负训练和离策略指数移动平均(EMA)。他们揭示,尽管理想的正负引导方向是共线的,但隐藏的前向-反向一致性力会破坏各个分支的稳定性。联合训练只能跨样本部分抵消该力,而无法在每个状态上完全抵消,从而留下可能阻碍优化的残余。
为了分离 EMA 的稳定机制,作者分析了损失分解,并证明 EMA 对滞后参考策略提供显式恢复。这种恢复抵消了残余一致性力。然而,依赖 EMA 需要对恢复调度进行任务特定调参:恢复太少会有崩溃风险,恢复太多则会减慢奖励提升。
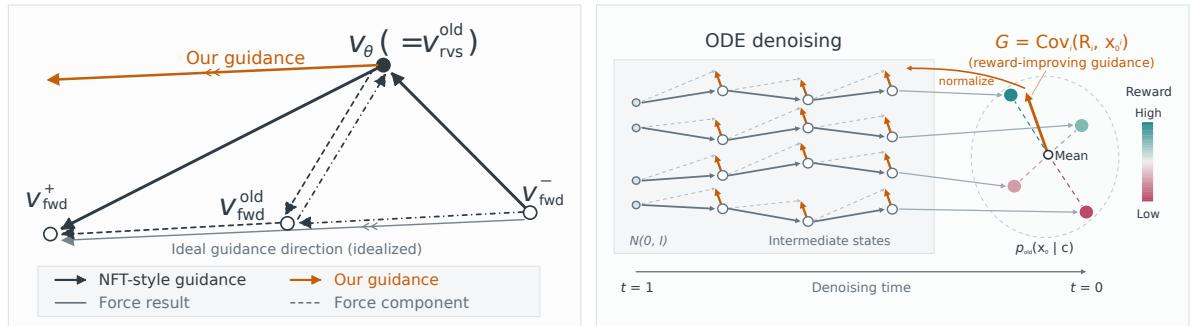
为了解决 NFT 式训练的局限性,作者提出了 DiffusionART,它结合了前向过程回归的高效性与反向过程 rollout 的稳定性。
NFT 中的一致性力来源于其回归目标由前向速度构建,而前向速度不同于反向采样场。DiffusionART 通过将每个提示的端点和奖励聚合为共享的奖励改进方向 G(c) 来避免这一问题。作者从 K 个 rollout 端点计算奖励-端点协方差,并对其归一化以获得 G(c):
Cov(R,x0∣c)=K1i=1∑K(Ri−Rˉc)(x0(i)−xˉ0,c),G(c)=RMS(Cov)Cov该归一化引导被应用于该提示的每个反向 rollout 状态。通过冻结目标 vtgtART(st)=vθ(0)(st)+G(c),每个状态都获得显式的奖励改进方向,而不含 NFT 一致性项。
作者没有调参 EMA 调度,而是实现了漂移自适应恢复机制:将每个 rollout 批次拆分为两个不相交的小批量,并分别施加一次均方误差更新。两次更新均使用冻结目标 vtgtART。第一次更新施加引导 G(c)。第二次更新将原始引导与朝初始速度场 vθ(0) 的恢复项 −d(st) 结合,其中 d(st) 是当前位移。这确保恢复随每个状态的漂移增大而增强,抵消较大位移,同时在漂移较小时让引导保持主导,从而无需任务特定的 EMA 调参。
为了防止单个 rollout 批次内策略变化过大,作者引入信任域掩码。由于常微分方程转移是确定性的,他们定义参考高斯转移来计算用于衡量漂移的 KL 代理:
m(st)=2Dσref2(t)∥μ(st,vθ(st))−μ(st,vθ(0)(st))∥22该掩码通过检查位移 d(st) 与第二次更新下降方向 G(c)−d(st) 是否具有正内积来识别过度向外漂移,若漂移超过阈值则掩码该更新。
对于缺乏客观正确性标准的视觉输出,作者扩展该框架以支持在线配对偏好反馈。他们将 K 个端点划分为不相交的配对,分配胜者或败者标签,并在协方差和训练流程中用这些标签替代标量奖励。
实验
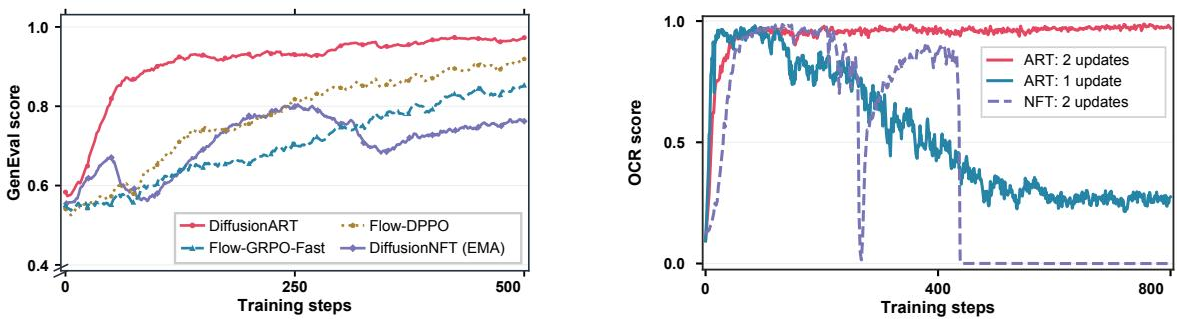
实验在文本到图像、文本到视频和图像到视频生成任务上评估 DiffusionART,并在 LoRA 和全模型微调下与 Flow-GRPO、DanceGRPO 和 DiffusionNFT 等基线进行比较。DiffusionART 持续获得更快的奖励提升和更高的训练效率,同时避免了一些基线中出现的不稳定或崩溃,并能有效扩展到更大模型。消融实验表明,其协方差引导、恢复更新和信任域掩码有助于长期稳定性,而配对反馈和较小分组规模在视频任务中仍然有效。
配对反馈取得的最终 VQ 接近标量反馈,将组大小从 8 减少到 2 可以保持最终 VQ,同时大幅降低计算量。较小分组使用的 rollout 视频和训练样本约为原来的四分之一,但仍能达到不低于较大分组的最终 VQ。这表明在该设置下,每个提示一个配对足以实现稳定且计算高效的优化。在相同步数预算下,最小配对组的最终 VQ 达到或略高于较大配对组。将组大小从 8 减少到 2 可降低 GPU 小时数约 3.4 倍,同时保持可比的 VQ。每个提示使用 8 个样本的标量反馈在本评估中取得最高 VQ,但需要最多 GPU 小时数。
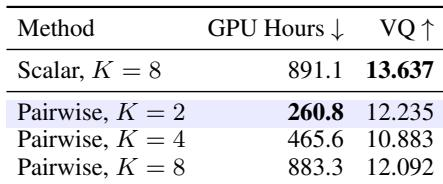
配对反馈达到的最终视频质量接近标量反馈,将配对组大小从 8 减少到 2 仍能保持最终视频质量,同时使用的 rollout 视频和训练样本约为原来的四分之一。在相同步数预算下,最小配对组达到或略超较大配对组,这表明每个提示一个配对已足以实现稳定且计算高效的优化。将组大小从 8 减少到 2 可降低 GPU 小时数约 3.4 倍,且不影响视频质量。每个提示使用 8 个样本的标量反馈在该评估中取得最高视频质量,但需要最多计算量。