Command Palette
Search for a command to run...
AgentGarten:面向持续进化智能体的代码世界
AgentGarten:面向持续进化智能体的代码世界
摘要
交互式虚拟世界使智能体能够通过探索和交互进行学习。智能体所能学到的内容受限于其训练所处的环境;这些环境必须具备保真性,即状态、规则和动力学保持一致,并且必须具备真实感,即观测遵循真实世界的视觉分布。在多样化世界中同时实现这两点仍是一个瓶颈。我们提出了 AgentGarten,一个将模拟器和游戏引擎与共享神经渲染器相结合以构建实时交互式环境的框架。其模拟后端维护持久的世界状态并执行程序定义的交互规则,而渲染器则根据通过通用接口导出的结构化条件生成视觉观测。为了构建神经渲染器,我们将预训练视频模型适配到几何条件,使用我们提出的 Adversarial Forcing 对其进行蒸馏,并优化推理以实现实时交互。Adversarial Forcing 通过精确回放使历史预填充可微分,从而后续预测的损失会更新渲染器对先前观测的编码方式,并加入真实数据对抗监督以提升视觉质量。在 AgentGarten 中,智能体通过视觉观测感知世界,实时与之交互,并通过将每一轮经验蒸馏为行动手册(playbook),供后续智能体继承和完善。我们的实证研究表明学习效率大幅提升,智能体仅需 4 轮即可完成学习,而传统强化学习对应方法需要数百万轮。由于新世界可以以代码形式编写并通过同一接口渲染,环境能够在数量和难度上与智能体同步扩展,这朝着智能体通过交互式经验持续进化迈出了一步。
一句话总结
MirroS、清华大学和北京大学的研究人员提出了 AgentGarten,这是一个将模拟器和游戏引擎与共享神经渲染器相结合以构建实时交互环境的框架,它使用 Adversarial Forcing 和真实数据对抗监督来适配预训练视频模型,并使 agent 仅通过四轮学习,而传统强化学习对应方法需要数百万轮。
核心贡献
- AgentGarten 将模拟器或游戏引擎后端与共享神经渲染器相结合,构建实时交互环境;后端维护持久世界状态和程序定义的交互规则,渲染器则将通过公共接口导出的结构化条件转换为视觉观测。
- Adversarial Forcing 将预训练视频模型适配到几何条件,通过精确重放使历史预填充可微分,使后续预测损失能够更新先前观测的编码方式,并加入真实数据对抗监督以改善视觉质量。
- 实证研究表明,agent 将每轮经验提炼为行动手册,后续 agent 会继承并改进这些行动手册;agent 仅通过 4 轮学习,而传统强化学习对应方法需要数百万轮。在捉迷藏中,第 4 轮出现掩体,第 10 轮出现坡道通行;同一流程在另外四个世界中改善了结果。
引言
作者的目标是满足可扩展训练环境的需求,使 agent 能够在其中从动作和视觉观测的长轨迹中学习。此类环境必须保留过去动作的后果,同时允许布局、物体和任务规则的变化。先前的模拟器和游戏引擎提供显式、可检查的状态和可编程规则,但扩展其视觉多样性代价高昂,因为这需要新的 3D 资产和渲染管线。相反,视频世界模型合成丰富的观测,但其任务相关状态和转移规则仍然是隐式的,难以检查、编辑或测试。作者提出了 AgentGarten,这是一个将可编程场景程序与共享实时神经渲染器结合在一起的框架。每个场景在模拟器或游戏引擎中运行,维护持久状态并执行交互规则,渲染器则将结构化引擎条件转换为视觉观测。为使该渲染器在长时间 rollout 中保持交互性,他们将预训练的双向视频模型适配为块因果生成,并用 Adversarial Forcing 进行蒸馏,使用精确重放获取历史梯度,以及精确对抗正则化方案,以保持长 rollout 的视觉质量。
数据集
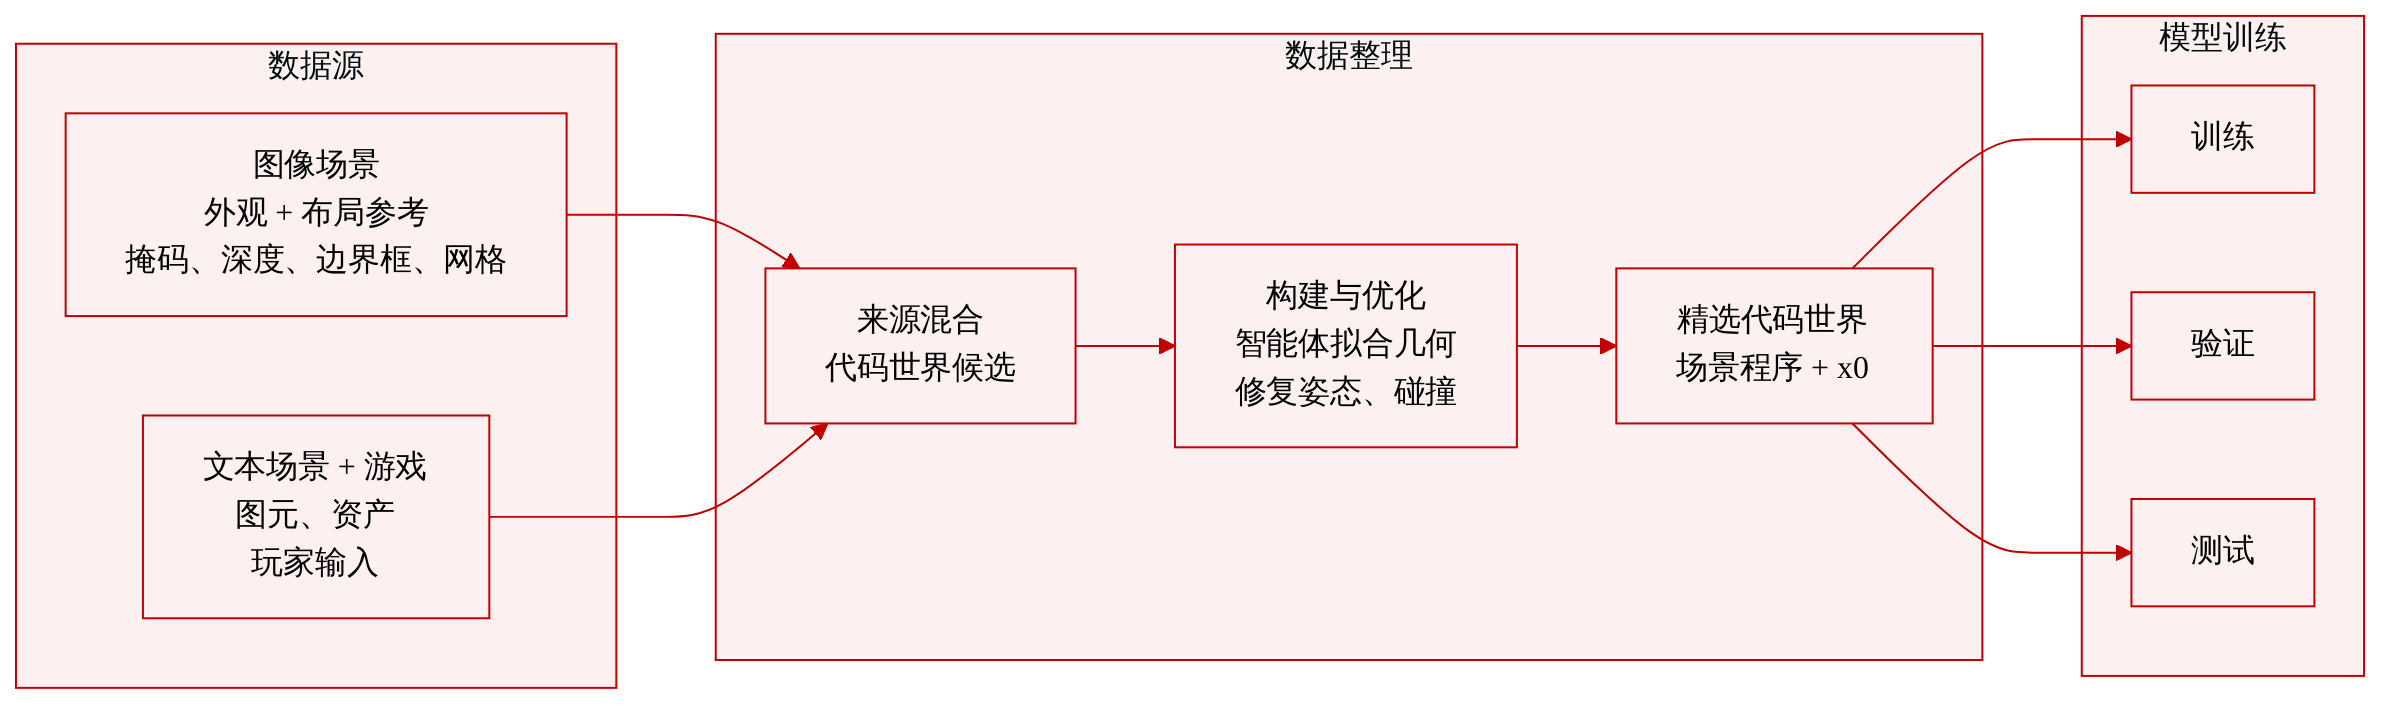
作者描述了一个由可执行的“代码世界”组成的数据集,而不是固定的图像或视频集合。每个代码世界将一个可执行场景程序与一个外观参考 x0 配对,场景程序仅存储布局、轮廓、遮挡和运动动力学所需的粗糙几何信息。
-
来源与组成
- 来自图像的代码世界: 单张输入图像同时用作外观参考 x0 和布局参考。感知模型和生成模型提取实例掩码、单目深度、相机内参、3D 边界框和物体网格。
- 来自文本的代码世界: 编码 agent 直接根据几何基元和引擎资产编写场景程序。图像编辑模型将初始渲染转换为 x0,同时保持场景布局。
- 环境库: 集合包含导航、操作、工具使用和多 agent 交互场景。
- 交互式浏览器游戏: 作者添加了保龄球、点球大战和板条箱翻越谜题。玩家通过键盘、鼠标或游戏手柄输入推进代码世界,渲染流是唯一视图。
-
处理与细化
- 对于基于图像的场景,编码 agent 将提取出的资产拟合到估计的几何结构上,将未观察到的区域补全为合理的空间扩展,并绑定物理属性和交互规则。
- 对于基于文本的场景,初始渲染通过保持布局的图像编辑转换为 x0。
- 两种模态都使用交互式细化循环:agent 评估来自多个探针相机的 rollout,检查引擎验证查询中的接触、碰撞间隙和遮挡情况,并修复错误姿态、不支撑的结构或模糊运动。
-
模式与使用
- 每个代码世界由一个可执行场景程序和一个外观参考 x0 组成。
- 不同的场景程序和兼容引擎与共享渲染器一起组成代码世界。
- 由于状态演化是显式的,记录的 rollout 可以被重放并重新渲染,包括在不改变已发生事件的前提下从不同相机或不同视觉风格重新拍摄。
-
统计与划分
- 所提供的摘录未报告确切的子集大小、源数据集数量、过滤阈值、训练/评估划分比例、混合比例或裁剪细节。
方法
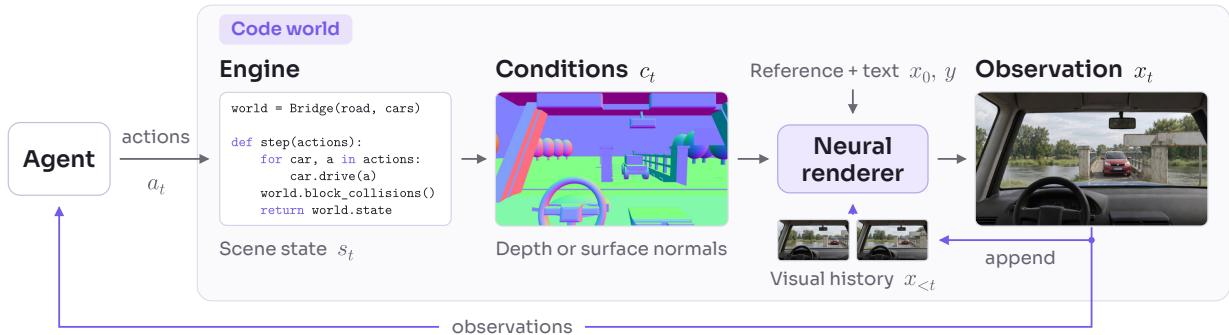
作者将代码世界形式化为场景程序、执行引擎和神经渲染器的组合。程序指定场景和交互规则。令 st 表示场景状态,πt 表示相机姿态,at 表示动作。引擎更新状态并捕获结构化条件 ct:
(st+1,πt+1)=fp(st,πt,at),ct=hp(st,πt)给定外观参考 x0 和文本描述 y,神经渲染器根据视觉历史 x<t 生成观测 xt:
xt=Rθ(x<t,c≤t,x0,y)这种分离确保渲染误差不会在状态中累积,从而允许在改变外观或相机的情况下渲染记录的状态轨迹,而不改变底层事件。
交互图如下所示:
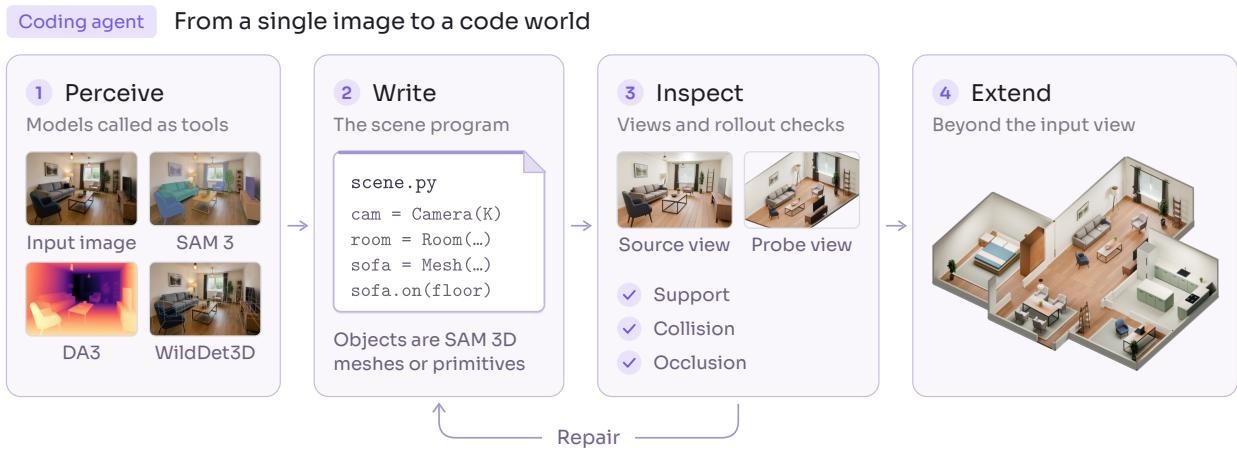
为构建这些环境,编码 agent 从单张图像或文本描述构建代码世界。从图像构建时,输入同时作为外观参考和参考布局。感知模型和生成模型将可见内容提升为实例掩码、单目深度、相机内参和物体网格。agent 编写场景程序,将这些资产拟合到估计的几何结构上,并通过交互式反馈循环细化场景。它评估来自多个探针相机的测试 rollout,并在部署前迭代修复错误姿态、不支撑的结构或模糊运动。
从单张图像构建代码世界的过程如下图所示:
作者训练一个几何条件化的自回归视频模型来实现神经渲染器。骨干网络将理解塔和生成塔分开。冻结的理解塔将文本描述编码为每层的键和值,供生成塔使用。深度和表面法线等几何条件被编码后与 RGB tokens 沿序列维度拼接,进行联合注意力。这保持了几何对齐,同时允许跨 token 交互,而不引入像素对齐的归纳偏置。
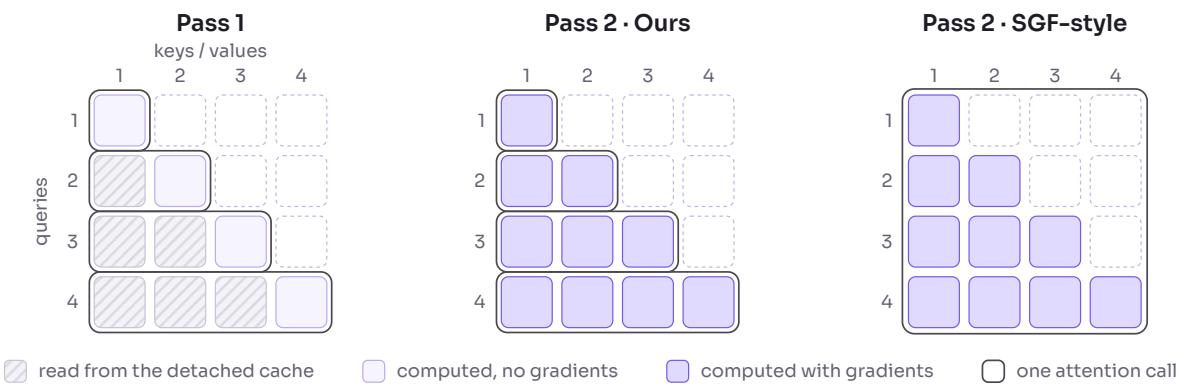
最终训练阶段 Adversarial Forcing 将 teacher-forced 模型蒸馏为在其自身 rollout 上训练的少步渲染器。它结合了与双向 teacher 的分布匹配、精确历史梯度重放和真实数据对抗训练。为了在避免完全可微分 rollout 内存开销的情况下,让后续损失更新历史编码计算,作者引入了精确重放。该方法使用两次传递将 rollout 和梯度传播解耦。一次无梯度 rollout 记录每个块的输入和干净输出,一次可微分重放按特定可见性模式重新计算历史和预测。
精确重放的块级注意力掩码如下图所示:
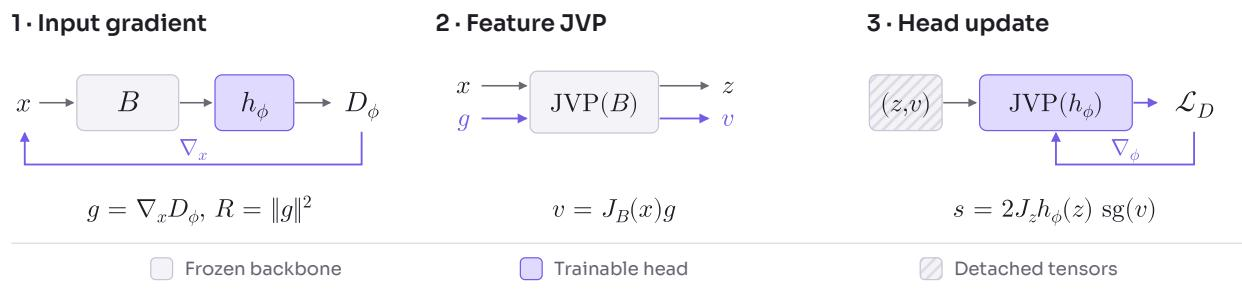
在对抗训练中,一个可训练头将来自冻结 teacher 骨干网络的中间特征聚合为判别器 logit。为了在不通过融合注意力核进行双重反向传播的情况下,用 R1 和 R2 惩罚正则化判别器,作者计算精确惩罚及其精确的头参数梯度。他们使用向量-雅可比积获得梯度,并使用雅可比-向量积在冻结骨干网络中向前传递方向,避免物化完整雅可比矩阵。
精确 R1/R2 正则化的计算流程如下图所示:
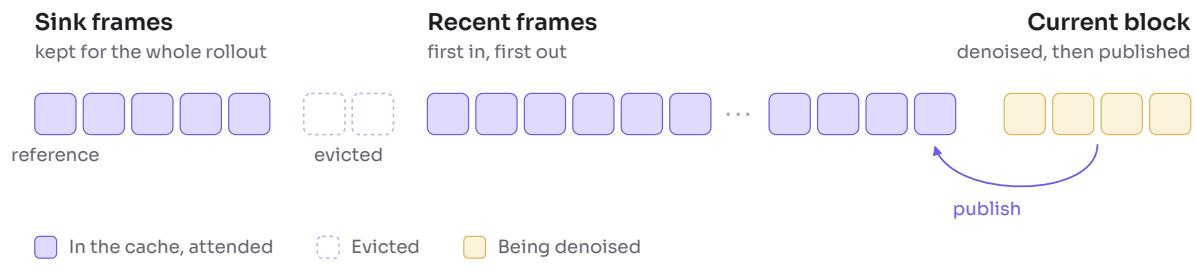
在交互循环中进行持续推理时,渲染器使用有界 key-value 缓存。缓存维护一个永久 sink 前缀,其中包含外观参考,以及一个近期历史的滑动窗口。当新块完成去噪并发布到缓存时,旧帧被逐出。该结构通过顶部对齐的旋转位置重映射支持超过训练时域的 rollout,在几何跟踪真实模拟时间线的同时保持相对时间距离。
推理缓存的结构如下图所示:
实验
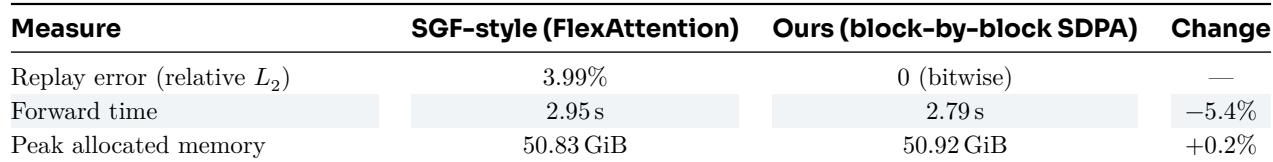
实验在一台 NVIDIA H100 GPU 上评估视觉质量、重放准确度和推理吞吐量,采用 BF16 计算、480×832 输出、四帧 latent 块和四步采样器。Adversarial Forcing 在长 rollout 中保持自然纹理和细节,而 Self Forcing 会产生重复模式并丢失细节;逐块 SDPA 重放与缓存 rollout 逐位一致,且比缓存 rollout 略快,而 FlexAttention 重放会引入少量误差。该渲染器实现实时 480×832 视频生成,agent 实验表明,基于神经渲染第一人称观测的闭环 grounding 让捉迷藏 agent 能在几轮内发展出掩体和坡道策略,并在另外四个世界中持续改进。
在相同的模型和硬件设置下测量了重放准确度和开销。逐块 SDPA 重放与缓存 rollout 逐位一致,而全序列 FlexAttention 重放会引入少量相对误差。逐块方法还略微缩短了前向时间,峰值内存几乎无变化。逐块 SDPA 重放与缓存 rollout 完全一致。全序列 FlexAttention 重放增加了 3.99% 的相对 L2 误差。用逐块 SDPA 替代 FlexAttention 使前向时间降低 5.4%,而峰值内存仅变化 0.2%。
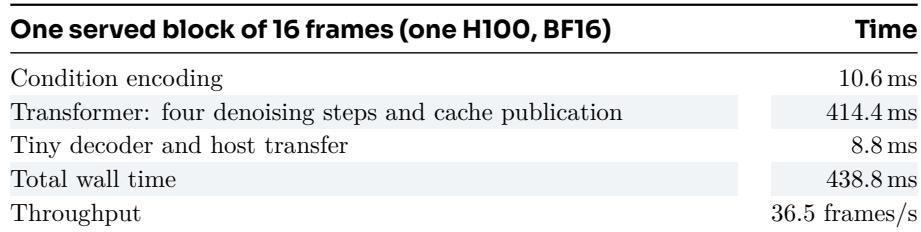
在满载缓存的稳态下,对于包含十六帧的已服务块,transformer 阶段主导推理开销,而条件编码和解码只增加少量开销。渲染器在单块 NVIDIA H100 GPU 上持续超过每秒 35 帧,tiny decoder 在 10 ms 内完成。transformer 阶段涵盖四个去噪步骤和缓存发布,几乎占用了全部已服务块延迟。条件编码和带主机传输的 tiny decoder 对总墙钟时间贡献较小。在单个 H100 上,480x832 视频的稳态吞吐量超过每秒 35 帧。
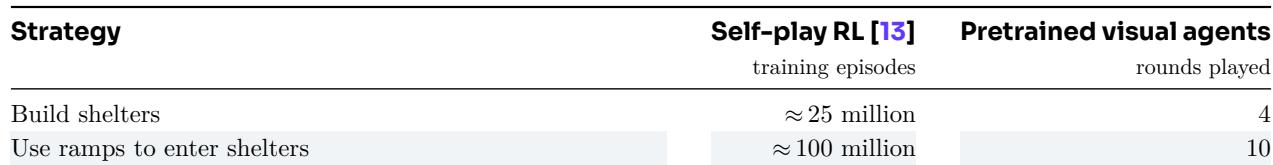
实验跟踪了捉迷藏中两个物理工具使用里程碑:建造掩体和使用坡道进入掩体。预训练视觉 agent 在仅通过实时神经渲染器感知并更新编写好的行动手册的情况下,在少数几轮内就达到两个里程碑;而从头开始的自博弈强化学习需要数百万个训练 episode。该对比强调的是将一般常识先验快速 grounding 到闭环物理执行,而不是直接的样本效率比值。预训练 agent 只经过几轮就出现掩体建造和坡道使用,而自博弈强化学习需要数千万到数亿个 episode。预训练 agent 仅从第一人称神经渲染观测中就达到了这些工具使用里程碑,没有物体坐标或特权世界状态,并改进了策略,例如在首次尝试失败后将坡道重新移到更靠近墙的位置。
大多数世界在轮次间都有明显改进。伴侣犬的参与度上升并稳定在最高观测水平;过桥时间大幅下降;放牧从只圈住三只羊进步到在后来的每一轮都圈住全部四只羊;采石场装载机从早期一轮零得分恢复到在最后一轮完成大部分任务。伴侣犬的参与度从第一轮起就有所改善,并以最高记录分数结束。过桥 agent 完成了每一轮,并在轮次间大幅缩短过桥时间。放牧搭档仅在第一轮未能圈住全部四只羊,之后每一轮都圈住了全部四只羊。采石场装载机早期表现不稳定,但在最后一轮大幅改善,清除了岩石、运送了一块岩石,并在时限内停好车。
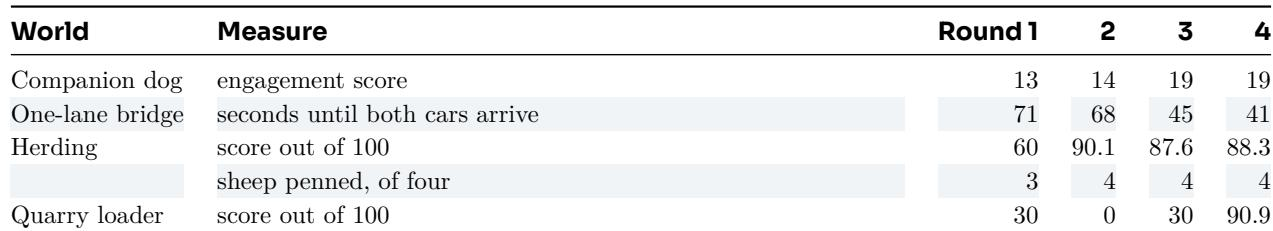
实验在多个层面评估了交互式视频生成和具身 agent 流水线。逐块 SDPA 重放方案与缓存 rollout 完全一致,同时略微缩短前向时间且内存几乎不变;与之不同,全序列 FlexAttention 重放会引入数值误差。在稳态下,渲染器在单个 H100 上维持实时视频生成,transformer 阶段主导开销,而条件编码和解码仍然较小。预训练视觉 agent 仅通过数轮渲染出的第一人称观测就达到了物理工具使用里程碑,而自博弈强化学习需要大规模训练。在多个模拟世界中,agent 通常在轮次间有所改进,包括更稳定的放牧、更快的过桥和更好的采石场装载。