Command Palette
Search for a command to run...
具有细粒度具身交互的多智能体自我中心世界模型
具有细粒度具身交互的多智能体自我中心世界模型
Dahyun Chung Siyoon Jin Hyunwook Choi Honggyu An Junyoung Seo Hyunsung Kim Seung Wook Kim Seungryong Kim
摘要
自我中心世界模型以智能体动作为条件预测第一人称观测,但大多数研究仅关注单个智能体。现实具身场景通常涉及多个在共享环境中行动并交互的智能体。现有多智能体世界模型依赖移动、相机控制或离散指令等粗粒度动作,导致细粒度具身交互尚未得到充分探索。我们将多智能体自我中心世界建模形式化为:多个智能体在共享世界中通过细粒度动作进行交互,并同步生成各自的自我中心流。这要求跨视角动作一致性、共享环境一致性,以及交互引发状态更新的一致传播。我们提出多智能体自我中心世界模型(ME-World),该方法在共享 token 序列中联合去噪多个自我中心流,以所有智能体的目标视角位姿为条件生成每个流,并通过共享环境记忆约束生成过程。我们在真实与合成多智能体数据上训练和评估模型,并引入了面向环境一致性、更新一致性和身份一致性的共享世界一致性指标。实验表明,与现有方法相比,ME-World 在共享世界一致性、动作控制、身份保持和视频质量方面均有提升。
一句话总结
KAIST AI 的研究人员提出了 Multi-agent Egocentric World Model (ME-World),该模型在共享 token 序列中联合去噪多个 egocentric 流,将每个流以所有 agents 的目标视角位姿为条件,并利用共享环境记忆锚定生成,从而在共享世界一致性、动作控制、身份保持和视频质量方面优于现有 multi-agent world model。
核心贡献
- 该论文将 embodied multi-agent world modeling 引入为多个 agents 在共享世界中通过细粒度动作交互时同步 egocentric 流生成。
- 该论文提出了 ME-World,该模型在共享 token 序列中联合去噪多个 ego 流,将每个流以所有 agents 的目标视角位姿为条件,并利用共享环境记忆锚定生成。
- 该论文构建了真实和合成 multi-agent benchmark,并提供环境、更新和身份的共享世界一致性指标;实验表明 ME-World 在共享世界一致性、动作控制、身份保持和视频质量上优于现有方法。
引言
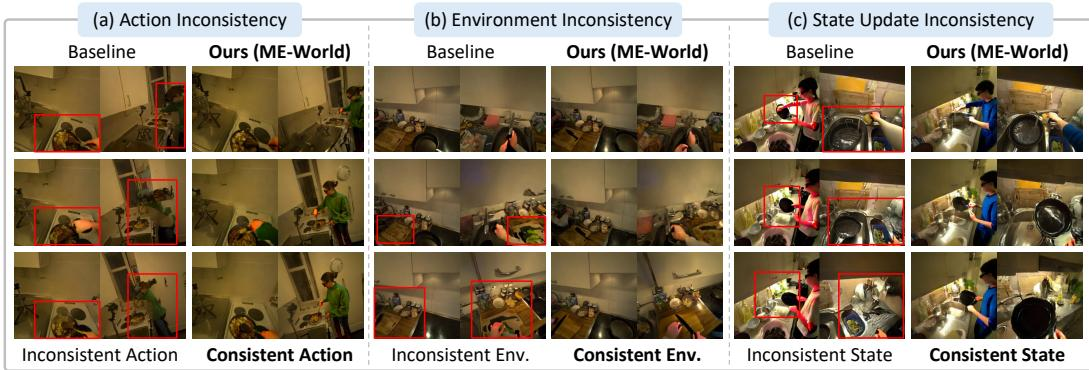
视频 world model 使 agents 能够根据自身动作预测未来观测,近期的 egocentric 方法将这一思想扩展到第一人称 embodied 流。在 multi-agent 场景中,先前工作通常假设单一 embodied ego,或将动作抽象为低维控制,这忽略了细粒度身体、手部和头部运动同时作为第一人称控制和跨视角可观测行为的双重作用。这限制了保持跨视角动作同步、共享环境一致以及交互引起的物体或状态变化在所有视角间对齐的能力。作者提出 ME-World,这是一种 multi-agent egocentric world model,它在共享 token 序列中联合去噪所有 ego 流,以共享动作为条件,并以共享环境记忆和共同锚点参考为生成基础。作者还结合真实和合成 multi-ego 数据,并提出共享世界一致性指标,用于评估生成流是否表示同一个演化的共享世界。
方法
作者处理具身 multi-agent world modeling 的挑战,其中多个 agents 在共享且不断演化的环境中行动和交互,同时从各自的 egocentric 视角观察环境。给定 N agents 的未来具身动作序列、文本提示、初始 ego 帧和观察历史,目标是生成所有 agents 的未来 ego 流。每个生成流必须遵循其对应动作序列,同时与共享环境和世界状态保持全局一致。对于第 n 个 agent,未来 ego 流和动作序列分别记为 X(n)={xt(n)}t=1T 和 A(n)={at(n)}t=1T。所有 agents 的观察历史被汇总到共享 observation-history pool E 中。完整条件信号定义为 C={E,A(1:N),P(1:N),x0(1:N)}。为确保生成流在共享环境和交互引起的状态变化上保持一致,该框架通过联合 multi-agent generation 耦合 ego 流,通过共享动作条件化进行引导,并通过共享环境记忆进行锚定。
如下图所示:
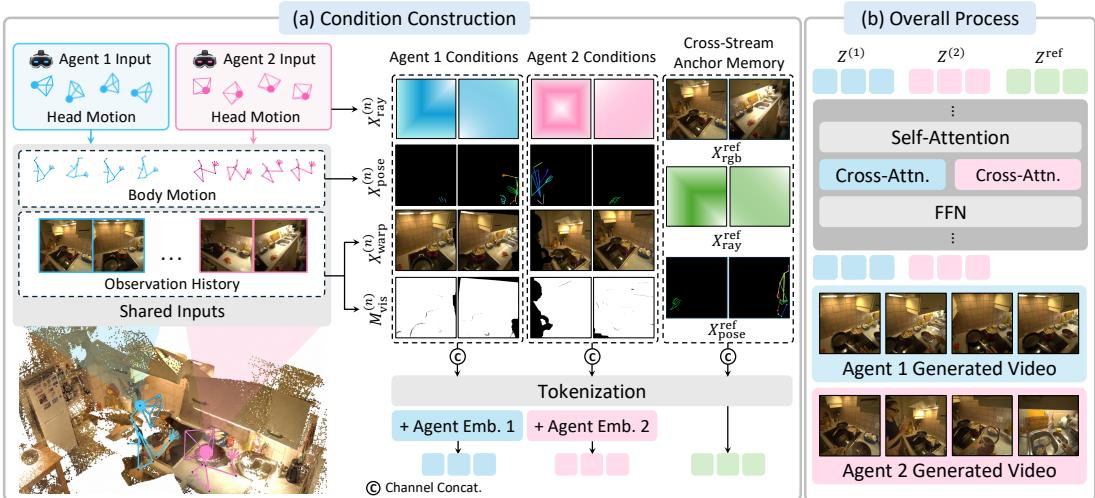
联合 Multi-Agent Generation
由于 agents 在同一环境中交互,其 ego 流本质上相互依赖。模型不是独立生成每个流,而是在单个预训练 video diffusion transformer 中联合去噪其 latent 序列。该方法通过 self-attention 实现跨流信息交换,确保所有流作为同一共享世界互为信息的观测而演化。形式上,模型学习联合条件分布 pθ(X(1),…,X(N)∣C)。
使用冻结 video VAE,每个 ego 流 X(n) 被编码为 latent 序列 Z(n)。在去噪过程中,所有 agents 在 timestep τ 的 noisy latent 沿 token 维度拼接:
Zτgen=[Zτ(1);…;Zτ(N)].Transformer 使用 self-attention 处理该联合序列。为保持空间和时间对齐,作者对所有流应用相同的 rotary positional embedding,将它们的时空位置对齐到公共位置框架。作者通过向第 n 个 agent 的 tokens 添加可学习 agent embedding e(n) 来区分各流。对于文本条件,每个流使用单独的 cross-attention 路径,使每个 agent 能够遵循自己的 prompt P(n),同时通过联合 self-attention 共享视觉信息。
共享动作条件化
联合 generation 使信息交换成为可能,但模型需要明确指导每个 agent 应如何移动和交互。仅以每个流自身私有动作作为条件的朴素方法会导致跨视角 embodied 交互渲染不一致。为解决此问题,作者实现了共享动作条件化,以所有 agents 的运动引导每个 ego 流。
对于第 n 个 agent,第 t 帧的动作分解为身体运动 at,body(n) 和头部运动 at,head(n)。身体运动编码为 self-action skeleton map,捕获 ego 可见的手部和手臂运动。头部运动用 Plucker ray maps 表示,提供对由相机射线诱导的几何编码。
为构造第 n 个 agent 的共享动作条件,定义姿态条件序列 Xpose(n)。在每一帧,该序列使用 agent 的 self-action skeleton map、其他 agents 的 3D body 姿态以及相对相机几何渲染到目标图像平面上。该统一姿态条件同时表示 agent 自身运动和其他 agents 在其 ego 视角中可见的运动。对于头部运动,收集 Plucker ray maps Xray(n) 并在共享规范坐标系中表示,使相机轨迹在流之间具有几何可比性。编码后的姿态和 ray 特征沿通道维度与 noisy latent Zτ(n) 拼接,用于联合去噪。
共享环境记忆
虽然共享动作条件化使 agent 运动变得明确,但它没有定义周围世界的布局或外观。作者从汇总的 observation history E 中引入共享环境记忆,以提供公共参考。该记忆通过两条互补路径集成。
流对齐几何记忆路径将相关观测变换为目标视角条件。对于每个目标流,选择对目标视图提供最大有效覆盖的历史图像 Xhist,并根据目标 ray 条件 Xray(n) 进行 warping。投影期间屏蔽动态 agent 区域,以避免传递过时姿态。该 warping 产生 warped RGB condition Xwarp(n) 和可见性 mask Mvis(n),它们被编码并与 noisy latent 拼接,以直接在去噪时利用对齐的场景证据。
跨流锚点记忆路径通过以原始未 warped 形式保留选定历史图像作为共享场景参考来补充。作者贪心地选择 K 个历史观测以最大化目标视图覆盖。这些选定观测被编码为参考特征 Zref={zrefk}k=1K,并沿 token 维度附加到联合去噪序列。输入到 transformer 的扩展联合序列变为:
Zτjoint=[Zτgen;Zref],使所有 ego 流都能 attend 到相同的锚点,从而将它们锚定到同一环境。
训练目标
作者使用 rectified flow 对预训练模型进行微调。令 Z0gen=[Z0(1);…;Z0(N)] 表示所有 agents 的干净 latent,ϵgen=[ϵ(1);…;ϵ(N)],其中 ϵ(n)∼N(0,I)。对于 τ∼U(0,1),noisy latent 构造为 Zτgen=(1−τ)Z0gen+τϵgen。模型 fθ 通过最小化 flow matching loss 训练:
LFM=EZ0,ϵ,τ,C[fθ(Zτjoint,τ,C)−(ϵgen−Z0gen)22].实验
该论文在真实和合成 multi-agent egocentric benchmark 上评估 ME-World,使用针对未见环境区域、状态更新和 counterpart 身份的共享世界一致性指标,以及相机控制、动作控制和视频质量指标。与 multi-view、single-ego、general world 和 adapted multi-agent baseline 的比较表明,现有方法在跨视角环境和交互一致性方面存在困难,而 ME-World 实现最强的一致性、动作控制和视觉质量。消融实验证实,联合 multi-agent generation 耦合 ego 流,共享动作条件化对齐 embodied 行为,共享环境记忆将背景锚定到共同演化的世界。
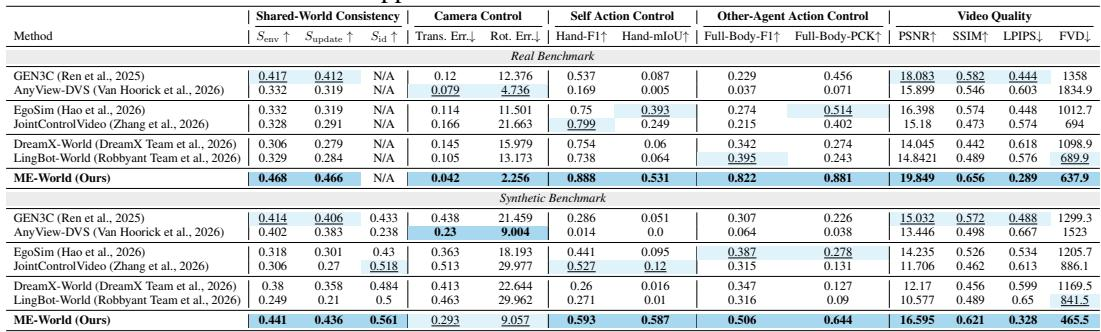
在真实 benchmark 上,现有方法在共享世界一致性、相机控制、动作控制和视频质量之间表现出权衡:multi-view baseline 仍可能产生不一致场景和动作伪影,single-ego 模型缺乏 other-agent 条件,general world model 常常无法保持 ego 流对齐。在合成 benchmark 上,baseline 往往出现身份漂移和跨 ego 视角动作不匹配。ME-World 实现更强的共享世界一致性,并改善相机控制、self-agent 和 other-agent 动作控制以及视频质量。现有真实 benchmark 方法在共享世界一致性和动作对齐方面落后,multi-view baseline 即使使用参考 ego 流仍显示模糊或重影动作。Single-ego world model 表现出较弱的 other-agent 动作控制,而 general world model 常常无法在 ego 流之间保持一致的环境和交互结果。在合成数据上,baseline 通常会丢失 counterpart 身份并产生不一致交互,而 ME-World 保持身份并实现更强的相机控制、动作控制和视频质量。
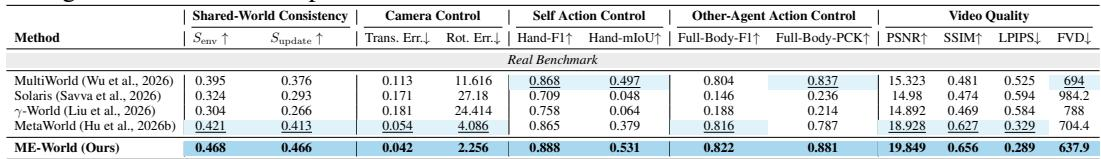
在 multi-agent world model 的受控真实 benchmark 比较中,ME-World 在共享世界一致性、相机控制、self-agent 和 other-agent 动作控制以及视频质量上均优于所有 baseline。MetaWorld 是最强 baseline,尤其在共享世界一致性和视频质量方面,而 Solaris 和 γ-World 在一致性和细粒度动作控制上下降更大。MultiWorld 保持相对较强的动作控制,但整体仍落后于 ME-World。ME-World 在所有比较方法中取得最佳共享世界一致性、相机控制、self-agent 和 other-agent 动作控制以及视频质量。在 adapted baseline 中,MetaWorld 表现出最强的共享世界一致性和视频质量,而 Solaris 和 γ-World 在共享世界一致性和细粒度动作控制上明显退化。
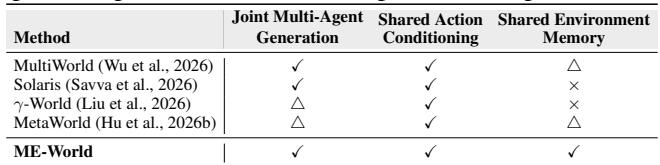
Adapted 架构的差异主要在于如何处理联合 multi-agent generation 和共享环境记忆。ME-World 是唯一包含联合 multi-agent generation、共享动作条件化和共享环境记忆显式对应模块的方法。这种完整组合与其在共享世界一致性、动作控制和视频质量方面的优势一致。ME-World 是唯一明确支持联合 multi-agent generation、共享动作条件化和共享环境记忆的 adapted 架构。MultiWorld 和 MetaWorld 用方法特定组件替换共享环境记忆,而 Solaris 和 γ-World 缺少显式的共享环境记忆模块。这些架构差异与 ME-World 相对于 adapted multi-agent baseline 更强的共享世界一致性、动作控制和视频质量一致。
仅对基础模型进行微调仍会产生不合理的 multi-agent ego 未来,共享世界一致性和动作控制较弱。添加 self-hand pose 和 history warping 在相机控制、动作指标和视频质量方面带来最大提升,而 joint generation 和共享动作条件化进一步改善 multi-view 一致性和动作对齐。共享动作变体在评估行中取得最强的共享世界一致性和全身动作控制。Off-the-shelf 和 fine-tuned Cosmos-Predict2.5 baseline 表现出较弱的共享世界一致性以及较差的 multi-agent 动作和视频质量。Self-hand pose 加 history warping 在相机控制、手部和全身动作指标以及视频质量方面带来最大改进。Joint generation 进一步改善共享世界一致性和视觉质量,共享动作条件化带来最佳的全身动作对齐和共享世界一致性。据报告,共享环境记忆将流锚定到共同演化的世界,从而解决背景不一致问题。
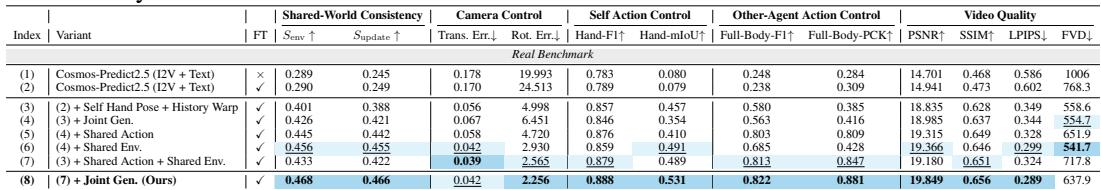
实验在真实和合成 benchmark 上评估 multi-agent world model,比较 adapted 架构,并对 ME-World 的组件进行消融。在两个 benchmark 上,现有 baseline 表现出跨视角不一致、other-agent 条件较弱、身份漂移和交互不匹配等权衡,而 ME-World 始终实现更强的共享世界一致性、相机与动作控制以及视频质量。架构比较表明 ME-World 是唯一具有显式联合 multi-agent generation、共享动作条件化和共享环境记忆的方法,消融实验显示 hand-pose 和 history warping 提供最大的控制收益,joint generation 和共享动作条件化进一步改善 multi-view 一致性和动作对齐。