Command Palette
Search for a command to run...
TokenRouter:一种面向 Token 级 LLM 路由的高效服务系统
TokenRouter:一种面向 Token 级 LLM 路由的高效服务系统
Tianyu Fu Tengxuan Liu Ruoxi Wang Yixin Dong Yi Ge Yichen You Yu Wang
摘要
大语言模型(LLM)路由将推理工作分配到不同模型上,推进了 LLM 服务的成本—质量帕累托前沿。虽然会话级或查询级的粗粒度路由已在生产系统中被广泛采用,但近期算法研究表明,细粒度的 Token 级路由能够带来显著的效率和质量收益。然而,为 Token 级路由推理提供高效服务对现有系统构成了重大挑战。现有系统建立在单 LLM 假设之上,在 Token 级路由下面临严重的步调失步和频繁的批次准入延迟,同时还给开发者带来很高的实现复杂度。为了解决这些挑战,我们设计了 TokenRouter,一个面向 Token 级路由 LLM 推理的高效且开发者友好的服务系统。TokenRouter 遵循“以请求为中心的编程、以模型为中心的执行”原则:开发者从单个请求的视角描述路由逻辑,而运行时为每个 LLM 启动一个子服务器并异步分发请求。每个子服务器采用延迟批处理调度器,其最优超参数由系统的数学吞吐模型推导得出。在多种路由算法、工作负载和模型对上,TokenRouter 的解码吞吐量比现有系统高出 2.01–64.15 倍,大幅提升了 Token 级 LLM 路由的服务效率。我们的代码可在 https://github.com/thu-nics/TokenRouter 获取。
一句话总结
清华大学和卡内基梅隆大学的研究者提出 TokenRouter,这是一种面向 token 级 LLM 路由的高效服务系统,采用以请求为中心的编程和以模型为中心的执行,将请求异步分发到每个模型对应的子服务器;每个子服务器使用延迟批处理调度器,其最优超参数来源于数学吞吐量模型,实现的解码吞吐量比现有系统高 2.01 到 64.15 倍。
核心贡献
- TokenRouter 是一个面向 token 级 LLM 路由的服务系统,提供以请求为中心的 route-send-receive 编程接口,以及以模型为中心的运行时,为每个模型设置一个子服务器用于异步请求分发。
- 它贡献了一个解耦三循环执行设计,并带有 handoff-resume 机制,用于解决协作 LLM 之间的步进不同步问题,同时提供一个延迟批处理调度器,其最优超参数由基于吞吐量的数学模型推导得出。
- 在多种路由算法、工作负载和模型对上的实验表明,TokenRouter 实现的解码吞吐量比现有实现高 2.01 到 64.15 倍。
引言
大语言模型在规模、专长、延迟和成本方面差异很大,服务系统越来越多地在模型之间路由请求,以改善成本与质量的权衡。先前路由大多是会话级或查询级的粗粒度路由,因此响应由单个模型生成;token 级路由可以利用响应内部的难度变化,使互补模型协作,但当前服务系统假设同步单模型解码。这使得 token 级路由因步进不同步、批次准入延迟和实现复杂性而效率低下。作者提出 TokenRouter,该系统将以请求为中心的 route-send-receive 编程接口与以模型为中心的异步执行分离,并通过延迟批处理降低准入延迟。它提供了可直接替换的服务器接口,实现的解码吞吐量比现有实现高 2.01 到 64.15 倍。
方法
作者介绍了 TokenRouter,这是一个设计用于支持多种 token 级路由算法,同时保持其实现简单直观的系统。编程接口的核心依赖于顺序式的以请求为中心的编程原则。该接口不要求开发者考虑底层批处理、调度或异步执行,而是允许开发者通过追踪单个请求如何在协作的大语言模型之间移动来描述路由算法。请求的生命周期遵循以下顺序:receive、decode、route、send、peer receive、peer decode 等。
为实现这一点,开发者只需填写三个组件:route、send 和 receive。route 函数在每一步解码后被调用,根据前向计算结果为每个请求确定目标索引。目标为 0 表示请求继续在本地执行,非零目标指向某个 peer 模型。send 函数在请求被委派时触发,返回一条定制消息,其中携带请求 ID、peer 模型尚未见过的 tokens 后缀以及状态字段。receive 函数将传入的 peer 请求转换为本地请求格式,以便接收方模型继续解码。
TokenRouter 的系统设计组织为以模型为中心的运行时。如下图所示,运行时由位于单一外部接口后面的多个子服务器组成。每个子服务器承载一个候选 LLM,并拥有一个调度器、一个带有私有 KV-cache 池的 LLM runner,以及三个用户定义的函数。子服务器独立推进,并通过 peer 请求进行通信。在外部,TokenRouter 暴露单一的服务器接口,使其可以替代现有单 LLM 服务器。
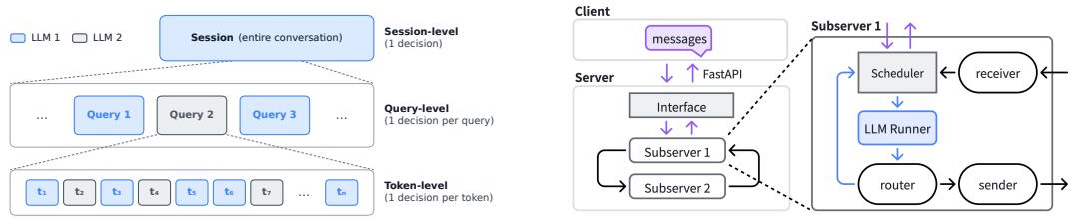
为解决 token 级路由中固有的步进不同步挑战,作者实现了解耦三循环执行和 handoff-resume 机制。标准服务器通常具有客户端-服务器循环和解码循环。TokenRouter 增加了第三个解耦循环,即模型间循环,用于在子服务器之间发送和接收 peer 请求。这允许被路由的请求离开本地批次,并在 peer 请求返回时恢复执行,同时剩余的本地请求继续执行。对于 handoff 和 resume 机制,系统引入了 pending 状态。调度器跳过处于 pending 状态的请求,但保留其服务状态。恢复时,状态切换为 running 或 finished,并追加新 tokens,从而将模型间转换的开销降低到几乎只是追加 tokens。
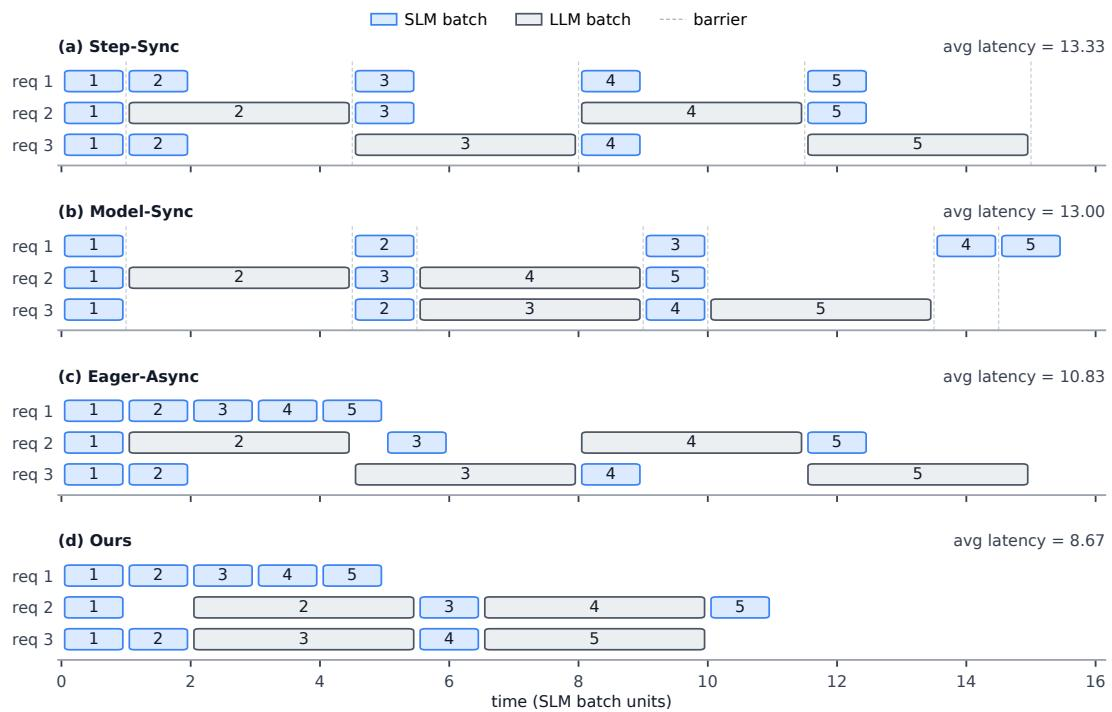
虽然异步执行消除了子服务器之间的同步,但每个子服务器仍需要调度策略来处理稀疏且不规则的路由 tokens 到达。作者将批次准入延迟定义为请求到达与其执行开始之间的等待时间。在急切异步调度下,如果子服务器在任何 peer 请求到达时立即启动新的解码步骤,那么在正在进行的批次期间到达的请求必须等到该步骤结束才能被准入,从而导致批次碎片化。
为减少该准入延迟,作者提出了延迟批处理调度器。其核心思想是等待一个短暂且受控的时间间隔,使更多针对同一模型的请求可以一起执行。调度器缓存接收到的请求,仅当缓冲区大小达到阈值 B 时才启动一个批次。如下图所示,这种方法使后到达的请求能够以少得多的等待时间被准入,从而降低平均批次准入延迟。
为确定吞吐量最优的延迟批处理阈值 B∗,作者将路由过程建模为离散时间马尔可夫链。给定 token 级路由算法、并发度 N、路由概率 P,以及每个 LLM 的每步解码延迟 Li,该模型推导出吞吐量关于 B 的函数,并搜索最大化吞吐量的阈值。这平衡了如下权衡:B 太小会导致较大的批次准入延迟,而 B 太大则会使请求滞留在队列中。
实验
评估将 TokenRouter 与五种 token 级路由算法在三种工作负载和两个基线条件下进行比较,使用 Qwen3 小模型和大模型对。TokenRouter 持续提高服务效率,在更长输出下保持吞吐量,并在原始设置下优于官方实现。消融实验表明,工程优化、异步执行和延迟批处理贡献了大部分收益,并且这些收益在不同模型对和并行化选择下持续存在。最后,TokenRouter 将 token 级路由推向更好的吞吐量-准确率帕累托前沿,使其与查询级路由具有竞争力。
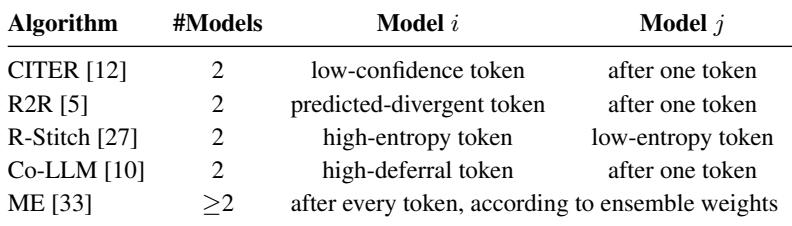
所评估的 token 级路由算法使用不同的路由信号,但都可以通过共同的 route 函数表达。CITER、R2R 和 Co-LLM 遵循非对称模式,其中一个模型在不确定 tokens 上调用另一个模型,并在生成一个 token 后返回控制权。R-Stitch 在两个模型之间使用基于熵的对称切换,而 ME 支持两个以上模型,并在每个 token 之后根据集成权重重新选择下一个模型。CITER、R2R 和 Co-LLM 使用由低置信度、预测分歧或高推迟 tokens 触发的非对称交接,并在一个 token 后返回控制权。R-Stitch 基于 token 熵进行对称切换,而 ME 将路由推广到多个模型,并通过集成权重在每个 token 之后进行选择。
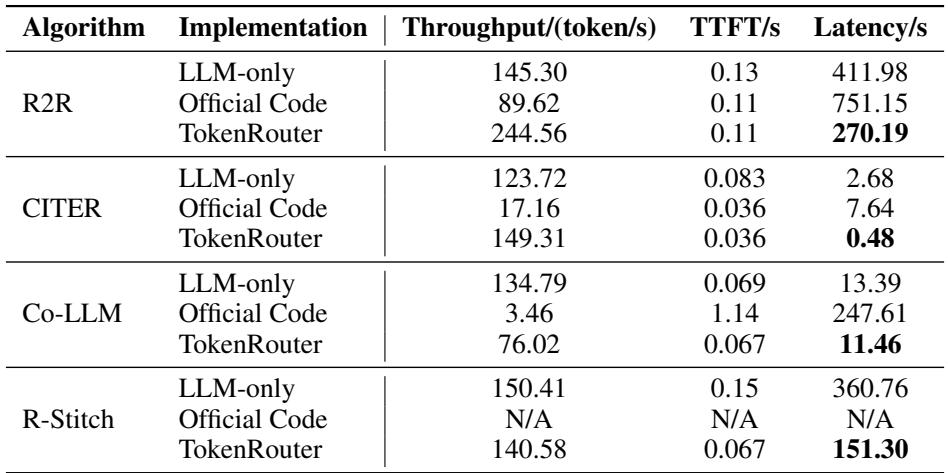
在并发度为 4 时,TokenRouter 优于官方 R2R 和 CITER 实现,提高了吞吐量并降低了端到端延迟,同时保持了相似的 time-to-first-token。在所评估的原始 token 级路由设置中,报告的吞吐量提升范围达到 2.73 到 21.97 倍,延迟降低范围达到 2.78 到 21.61 倍。对于 R2R,TokenRouter 的吞吐量提高了一倍以上,端到端延迟比官方实现降低约三分之二,而 TTFT 保持不变。对于 CITER,TokenRouter 保持 TTFT 完全相同,同时将端到端延迟从秒级降低到半秒以下,并将吞吐量比官方代码提高近九倍。
在所评估的小语言模型和大语言模型对中,TokenRouter 始终提供比官方 R2R 实现更高的吞吐量。提升范围约为 2 倍到 3.2 倍,其中最大增益出现在最小的模型对上,并且随着模型规模增大,增益仍然显著。这些结果表明这些优化在不同模型规模下广泛有效。在所有测试的 SLM-LLM 对中,TokenRouter 实现的吞吐量比 R2R 高 1.99 倍到 3.21 倍。最大吞吐量增益出现在 0.6B SLM 与 8B LLM 配对时,即使是最小增益也接近将吞吐量翻倍。
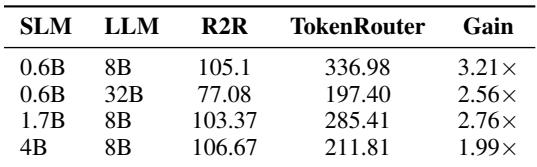
实验比较了可以通过共同 route 函数表达的 token 级路由策略,包括非对称交接方法、基于熵的对称切换以及多模型集成路由。与官方 R2R 和 CITER 实现的评估对比表明,TokenRouter 大幅提高吞吐量并降低端到端延迟,同时保持 time-to-first-token 相似。在多个小语言模型和大语言模型对中,TokenRouter 始终保持对 R2R 的吞吐量优势,其中在最小测试模型对上的优势最大。总体而言,结果验证了这些优化在路由模式和模型规模上广泛有效。