Command Palette
Search for a command to run...
SuperNav:面向任意场景任意任务的智能体导航系统
SuperNav:面向任意场景任意任务的智能体导航系统
Jinkai Zhang Jingyi Xu Yuanhong Yu Jiarui Guo Ruizhen Hu Hujun Bao Xiaowei Zhou Sida Peng
摘要
通用服务机器人需要能够在陌生环境中处理多样化人类请求的导航系统,兼具任务通用性与场景通用性。一些现有方法对多模态大语言模型(MLLM)进行微调以预测导航动作,使其行为依赖于导航训练数据的覆盖范围,并可能限制对新请求和新环境的泛化能力。我们的核心思路是让 MLLM 专注于解释请求、理解场景和做出决策,同时保留其通用能力,并将运动执行委托给导航工具。为实现这一思路,我们提出了 SuperNav,在不对 MLLM 进行导航特定微调的情况下,为预训练 MLLM 配备专用智能体框架。该框架通过导航技能(Navigation Skills)、面向智能体的物理交互工具(agent-oriented Tools)以及任务进度和上下文管理来支持这些决策。统一的视觉点接口(visual-point interface)将决策与运动连接起来,使模型能够直接在图像中指定目的地,并根据执行反馈修正其决策。这些组件共同支持在不同任务要求和环境下的持续导航。SuperNav 在实例级、多目标和需求驱动任务上优于四个被评估的基线方法。在 HM3D 上的类别级评估以及在真实四足机器人上的部署进一步证明了其跨环境的适用性。项目主页:https://zju3dv.github.io/SuperNav/
一句话总结
浙江大学、深圳大学与 Causa Robotics 提出 SuperNav,一种 Agent 式导航系统,为预训练 MLLM 配备专用支撑框架、Navigation Skills、面向 Agent 的工具以及统一的视觉点接口,在没有导航专用微调的情况下实现任务通用和场景通用的导航,在实例级、多目标和需求驱动任务上优于四个基线方法,并通过类别级 HM3D 评估和真实四足机器人部署证明了适用性。
核心贡献
- 本文提出 SuperNav,一个导航支撑框架,使预训练多模态大语言模型能够在没有导航专用微调的情况下解释请求、理解场景并做出导航决策,同时将运动执行交给外部工具。
- 该方法引入面向 Agent 的工具和可选的 Navigation Skills,并辅以任务进度跟踪和上下文管理,使用统一的视觉点接口在图像中指定目的地,并根据执行反馈修正决策。
- 实验结果表明,SuperNav 在实例级、多目标和需求驱动导航上优于四个被评估的基线方法,HM3D 上的类别级评估以及真实四足机器人上的部署提供了进一步证据。
引言
通用服务机器人需要能够在陌生环境中处理多样请求的导航能力,从寻找特定物体、访问多个目标,到满足诸如寻找休息场所等抽象需求。这些变化改变了机器人解释目标、探索、跟踪进度以及决定何时停止的方式,因此任务通用性和场景通用性对实际部署都很重要。
先前工作存在局限。模块化的零样本导航系统使用预训练视觉语言模型来衡量语义相关性,但任务特定逻辑仍然决定探索如何过渡到确认以及执行何时结束。改变请求类型通常需要改变工作流程。端到端导航方法在导航数据上微调视觉语言模型,但迁移效果取决于训练覆盖范围,并且在新的视觉外观、空间布局和交互条件下经常失效。
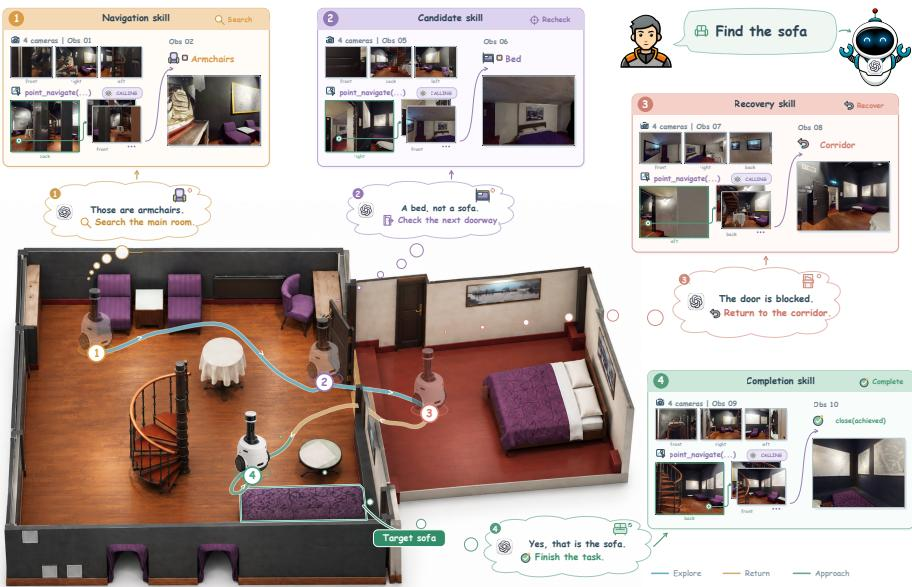
作者提出 SuperNav,一个 Agent 支撑框架,使预训练多模态大语言模型能够在不进行导航专用微调的情况下指导导航。MLLM 解释请求、理解视觉观察并推理动作,而该支撑框架提供观察、运动和任务管理工具、可选导航技能、进度跟踪和上下文管理。统一的视觉点接口让 MLLM 能够直接在图像中指定目的地,导航工具执行运动并返回反馈。作者在类别级、实例级、多目标和需求驱动导航以及真实机器人部署上评估了 SuperNav,并报告了相对于动作预测基线的显著改进。
方法
作者提出 SuperNav,一个将预训练多模态大语言模型(MLLM)与导航专用支撑框架相结合的系统,用以构建具身导航 Agent。该架构在从特定目标到高层需求的多样请求中维持决策和行动。MLLM 负责解释和决策,而支撑框架通过连续的 Agent 循环组织执行和上下文。在此框架内,面向 Agent 的工具提供用于观察、运动和状态管理的可调用操作,导航技能为搜索、验证和恢复提供程序化指导。
如下图所示:
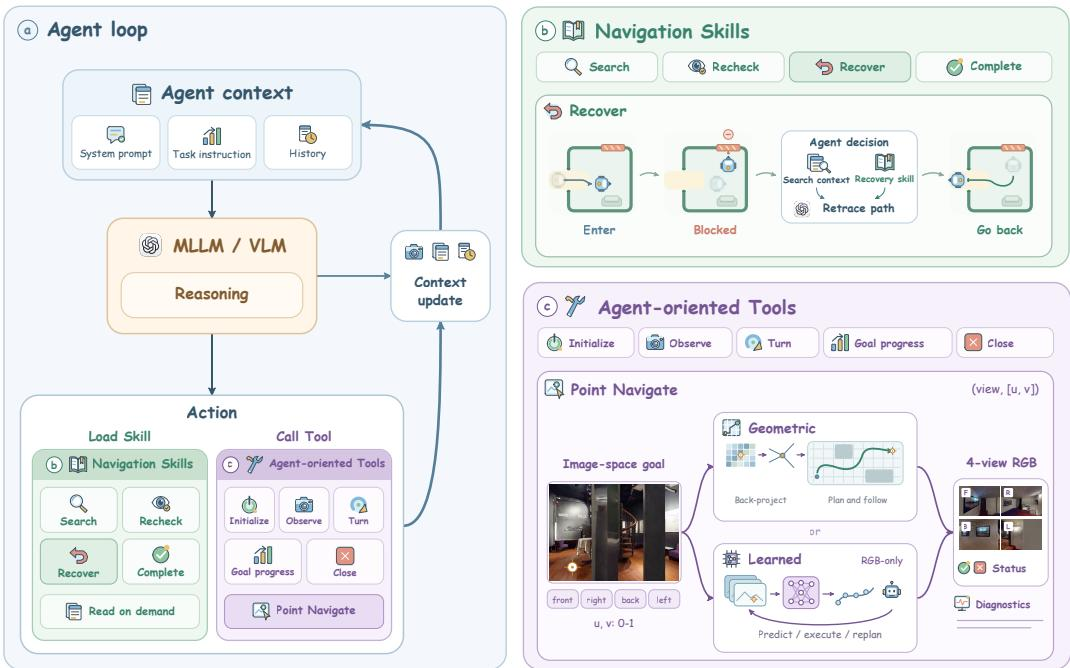
Agent 循环通过将请求、视觉观察和交互历史组织为连续导航过程来协调这些能力。初始化时,系统打开会话并返回首个观察结果,使 MLLM 能够解释请求目标和完成条件。在后续每一步,模型利用当前上下文和任务进度选择操作,例如观察、移动、更新目标状态或读取相关技能指导。这些工具的返回值和检索到的指令更新下一步决策的上下文,使执行反馈能够动态调整计划。
为管理长时程执行,该支撑框架维护待完成和已完成项目的目标记录,同时保留文本交互历史,其中包括已检查区域、候选线索和失败尝试。为控制不断增长的图像上下文,系统采用仅媒体剪枝策略。图像一旦被处理并被新观察取代,就从后续请求中移除其媒体负载,同时保留文本历史、任务状态和图像路径。必要时,MLLM 仍可从工作区请求较早的图像。最后,MLLM 判断请求是否已满足或执行是否受阻,并选择终止工具记录结果并关闭会话。
面向 Agent 的工具将 MLLM 的导航决策与环境可执行操作连接起来。该工具套件包括初始化、观察、转向、视觉点导航、目标进度管理和终止。核心的观察与运动接口将视觉目的地与更新的观察结果和执行反馈配对。一次观察返回四张 RGB 图像,分别标注为机器人朝向的前、右、后、左。这些标注使 MLLM 能够将候选目标或通道与特定视图关联起来,并使用 PointNav 函数选择目的地:
PointNav(d,[u,v]),u,v∈[0,1]其中 d 标识视图,u,v 是归一化的水平和垂直坐标。该工具在内部执行运动,并返回新的四视图图像、执行状态和简要诊断信息。
该视觉点接口将目的地选择与执行机制分离,支持可互换的运动后端。几何后端,即 Geo-based Executor,使用深度、相机标定和位姿将所选点与环境位置关联,然后规划并沿路径行进。学习后端,即 Learned Executor,将目的地图像目标替换为参考观察中的标记点。它从所选图像点对和近期 RGB 观察中预测局部位移增量与停止信号,并在单次工具调用内反复执行短预测运动段。两个后端都接受视觉目的地,并返回带有执行反馈的观察结果,确保 Agent 保持一致的决策工作流。
导航技能将可复用的导航经验组织为 MLLM 可按需读取的程序化指导。每个技能都结构化为一个 Markdown 包,描述适用情形、需要检查的证据、推荐步骤以及关联参考。该技能包包含一个主导航技能、后端专属工具使用说明,以及用于探索、恢复和入口搜索的参考。支撑框架暴露技能名称和描述,使 MLLM 能够发现相关包并将其指令加载到决策上下文中。
这些指导针对三类反复出现的决策:在哪里搜索、如何恢复以及何时结束。搜索指导提示 MLLM 记录已检查区域和可见开口,为后续探索保留备选路径。恢复指导建议在运动失败后更换点或路线,在候选目标难以检查时后退,或在玻璃阻挡进入时寻找入口。完成指导要求先检查候选外观、请求关系和周围上下文,再记录已验证目标。这些技能通过进入上下文影响决策,但不会以程序化方式强制规定动作序列,最终操作选择仍由 MLLM 根据当前请求和反馈决定。
实验
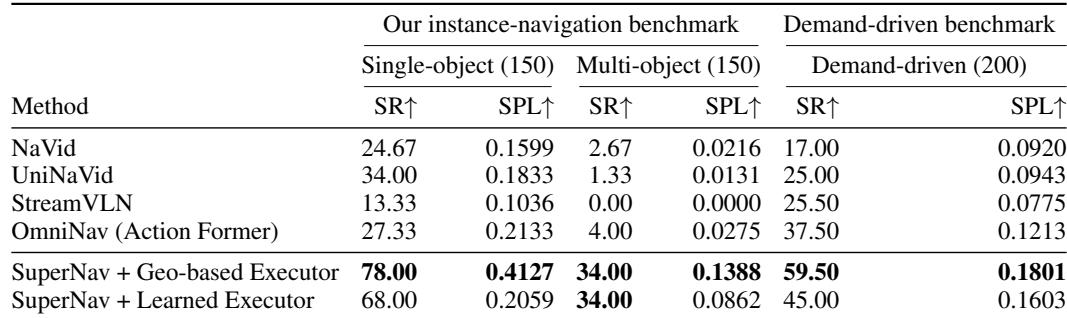
SuperNav 使用 GPT-5.6 Terra 以及 Geo-based Executor 或 Learned Executor 进行评估,覆盖 Habitat-GS 实例导航、AI2-THOR 需求驱动导航、HM3D 类别导航、支撑框架消融和真实世界部署,并与 NaVid、UniNaVid、StreamVLN 和 OmniNav 进行比较。该框架在多目标和推断目标任务上优于基线,Geo-based Executor 通常能保持成功率,同时比 Learned Executor 产生更高效的路径。消融研究表明 Navigation Skills 特别重要,外部 grounding 不优于直接选点,更换决策模型可提高成功率和路径效率,而真实世界测试显示路径修正和目标切换。
使用 Geo-based Executor 的 SuperNav 在单目标、多目标和需求驱动导航中领先所有被评估方法,尤其在单目标任务中提升很大。有序多目标导航对所有方法来说仍然困难,成功率相对于单目标结果大幅下降。需求驱动导航在成功率和路径效率上都明显优于基线,但长序列仍然具有挑战性。使用 Geo-based Executor 的 SuperNav 在每个报告的基准设置中都取得了最佳成功率和路径效率。单目标成功率是相关最强基线的两倍以上,而所有方法的多目标性能都大幅下降。在需求驱动导航中,使用 Geo-based Executor 的 SuperNav 在成功率和 SPL 上以较大优势超过最佳基线。
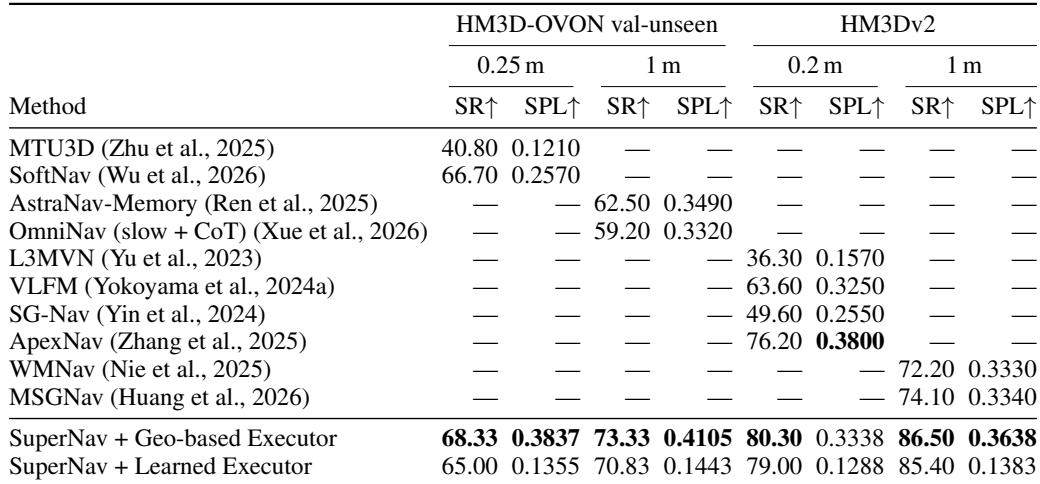
在 HM3D-OVON val-unseen 上,SoftNav 在成功率和 SPL 上均领先所列外部方法,而 MTU3D 则明显更低。在 HM3Dv2 比较中,AstraNav-Memory 在相同阈值下,成功率和路径效率都略优于 OmniNav。随附文本报告称,Learned Executor 保留了 Geo-based Executor 的大部分成功率,但牺牲了路径效率,而 Geo-based Executor 与这些已发表基线相比仍具有竞争力。SoftNav 在所列外部结果中取得了最高的 HM3D-OVON val-unseen 成功率和 SPL,MTU3D 明显更低。AstraNav-Memory 在共享的 HM3Dv2 阈值上,成功率和 SPL 略优于 OmniNav。Learned Executor 保留了 Geo-based Executor 的大部分成功率,但路径效率较低,而 Geo-based Executor 与已发表方法相比具有竞争力。
使用 Geo-based Executor 的消融实验表明,移除导航技能对成功率的降低幅度大于将接口限制为前视图,尤其是在更严格的距离阈值下。完整 SuperNav 支撑框架总体表现最佳,用 Astra medium 决策模型替代 Terra high 可同时提高成功率和路径效率。移除导航技能对成功率的降低幅度大于仅前视图交互,差距在更严格的 0.25 m 阈值下最大。完整 SuperNav 配置在两个距离阈值下都取得最高的成功率和 SPL。在保持支撑框架不变的情况下,用 Astra medium 决策模型替代 Terra high 可同时提高成功率和 SPL。外部 grounding 并未优于 Agent 的直接选点。
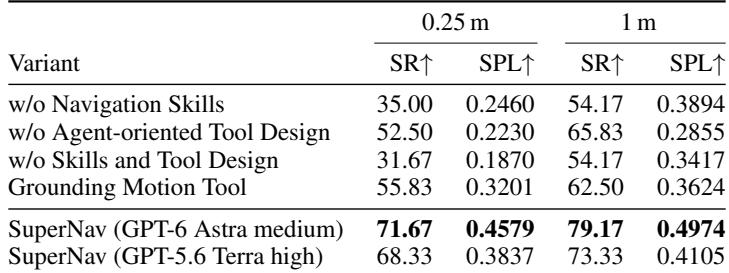
实验使用 Geo-based Executor 在单目标、多目标和需求驱动导航中评估 SuperNav,并在 HM3D-OVON 和 HM3Dv2 基准上与外部方法进行比较。使用 Geo-based Executor 的 SuperNav 在成功率和路径效率上持续领先,单目标成功率是相关最强基线的两倍以上,而有序多目标导航对所有方法来说仍然困难。在外部比较中,SoftNav 在 HM3D-OVON 结果中领先,AstraNav-Memory 在 HM3Dv2 上略优于 OmniNav,而 Learned Executor 保留了 Geo-based Executor 的大部分成功率,但路径效率较低。消融实验表明,移除导航技能对成功率的损害大于仅前视图交互,完整配置表现最佳,用 Astra medium 决策模型替代 Terra high 可同时提高成功率和路径效率。