Command Palette
Search for a command to run...
Long-WAM:扩展世界-动作模型的上下文规模
Long-WAM:扩展世界-动作模型的上下文规模
摘要
实时机器人控制需要足够的视觉历史来推断运动和任务进展,但处理这些历史可能会延迟动作。我们提出了 Long-WAM,一个用于在实时控制约束下扩展因果世界-动作模型上下文的模型-系统框架。我们的核心发现是,能够访问历史并不等同于真正使用历史:当视频基础模型以自回归(AR)方式预训练时,更长的历史会带来更大的收益。我们首先在没有动作标签的条件下,从机器人和第一视角视频中学习因果预测,随后在世界-动作适配过程中保留这种历史到未来的结构。在 RoboCasa GR-1 上,将上下文从 0.0秒增加到 19.2秒后,成功率从 63.3% 提升至 78.7%,而双向预训练初始化没有带来净收益;机器人领域 AR 预训练进一步提高了 GR-1 和 LIBERO-Long 上的峰值成功率。Long-WAM 还在 LIBERO-Long、RoboTwin 2.0 和 DOMINO 上取得了对比方法中的最佳结果。流式观测编码、异步执行和硬件专用加速使得能够部署到 RTX 5090、DGX Spark 和 Jetson AGX Thor 上,同时不丢弃未来预测;在 RTX 5090 上,每个动作块(包括未来视频潜变量预测)耗时 107.4 ms。在 Unitree G1 和 YAM 上的实时部署支持动态和长时程操作,包括在动态杯子堆叠任务上取得 95% 成功率,而 π_{0.5} 和 Fast-WAM 在 20次试验中均未成功。作为一种记忆信息引导的执行器,Long-WAM 还能在复合任务中与高层规划形成互补。
一句话总结
NVIDIA、MIT、HKU 和 UCSD 提出 Long-WAM,一种模型-系统框架,通过使用自回归预训练视频基础并保留历史到未来结构,在实时控制约束下扩展因果世界-动作模型的上下文;该框架将 RoboCasa GR-1 成功率从 63.3% 提升到 78.7%,在 LIBERO-Long、RoboTwin 2.0 和 DOMINO 上取得对比方法中的最佳结果,并可部署到 RTX 5090、DGX Spark 和 Jetson AGX Thor 上,在动态杯子堆叠任务中达到 95% 成功率,而 π0.5 和 Fast-WAM 在 20 次试验中均未成功。
核心贡献
- Long-WAM 是一种模型-系统框架,通过先在没有动作标签的情况下从机器人和第一视角视频中学习因果预测,随后在世界-动作适应过程中保留这种历史到未来结构,从而在实时控制约束下扩展因果世界-动作模型的上下文。
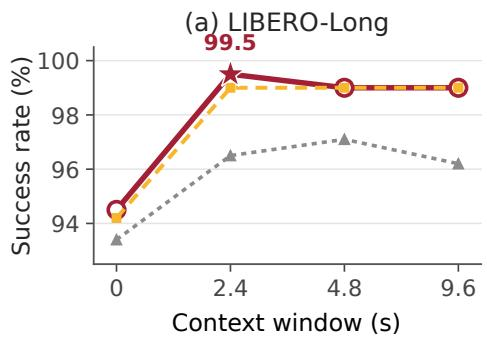
- 核心发现是,拥有历史信息并不等于利用历史信息:更长的观测历史主要只在视频基础经过自回归预训练时才会提升成功率。在 RoboCasa GR-1 上,将上下文从 0.0 秒增加到 19.2 秒会使成功率从 63.3% 提升到 78.7%,而双向预训练初始化没有净增益;机器人领域 AR 预训练还进一步提高了 GR-1 和 LIBERO-Long 上的峰值成功率。
- Long-WAM 通过流式观测编码、异步执行和硬件特定加速,支持在 RTX 5090、DGX Spark 和 Jetson AGX Thor 上实时部署;在 RTX 5090 上,包括未来视频潜变量预测在内,每个动作块耗时 107.4 ms。Long-WAM 在 LIBERO-Long、RoboTwin 2.0 和 DOMINO 上取得对比方法中的最佳结果,在 Unitree G1 上的动态杯子堆叠任务中达到 95% 成功率,在超过 40 秒的 YAM 任务中达到 81.7% 成功率,并在与 GPT-6 Astra 配合时将 RoboCasa365 成功率从 31.4% 提高到 54.4%。
引言
快速的机器人控制依赖于理解时序场景变化,因为单张图像无法指定运动或交互进展。世界-动作模型将视频预测引入闭环控制,使视觉历史成为自然的条件信号,但更长的历史可能会延迟它本应改善的响应。近期 WAM 通过缓存或检索提供记忆,然而拥有历史信息并不等于学会从中预测,双向视频预训练可能不会带来可扩展的控制收益。作者提出 Long-WAM,这是一种模型与系统框架,先学习自回归视频预测,再在保留因果历史到未来结构的同时适应动作生成。其关键发现是,更长的视觉上下文主要只在视频基础经过自回归预训练时改善控制;作者还联合设计了异步执行、流式观测编码和边缘设备量化,以在实时约束下保持这些收益。
数据集
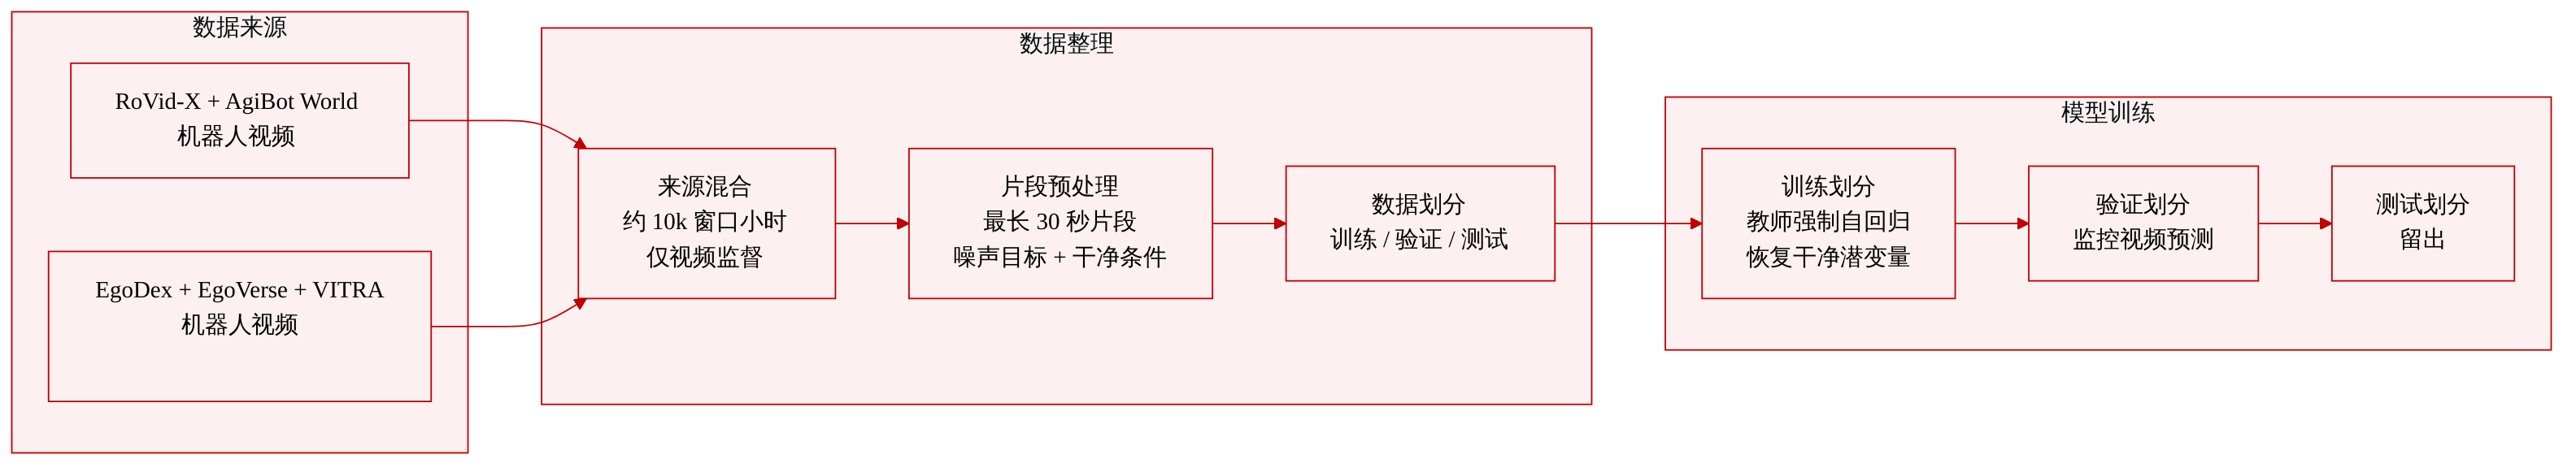
- 组成与来源: 数据集包含约 10,000 窗口等效小时的机器人视频,来自五个来源:RoVid-X、AgiBot World、EgoDex、EgoVerse 和 VITRA。
- 监督与具身覆盖: 预训练仅使用视频监督,因此数据可以组合多种机器人具身,而无需共享动作空间。
- 时序格式与规模: 模型从 LongLive-2.0 的 16 秒 AR 检查点初始化,然后在最长 30 秒的机器人视频序列上训练,使其接触更长的运动和交互历史。
- 处理与使用: 每个机器人视频序列用于自回归视频生成。目标块被加噪,每个噪声块根据其真实前缀进行监督。条件图像保持干净且不参与损失,目标是从噪声输入中恢复原始干净潜变量。
- 子集细节与过滤: 该摘录未指定各个子集大小、过滤规则或五个来源之间的混合比例,具体数据统计参见附录 B.1。
- 在模型中的角色: 给定一张图像和一个语言提示,预训练模型预测连贯的机器人运动和物体交互,为下游动作适应提供预测先验。
方法
作者首先通过长序列自回归视频预训练建立预测基础,具体为 LongLive2.0-Robot。该阶段使模型接触到最长 30 秒的扩展运动和交互历史。模型采用 teacher-forcing 形式,从干净的条件图像和语言提示中学习预测连贯的机器人运动和物体交互。噪声输入和 teacher-forcing 目标定义为:
xiσi=(1−σi)zˉi+σiϵˉi,σi∈[0,1] LTF−AR=E[w(σi)∥vθ(xiσi,σi∣h<i,c)−(ϵˉi−zi)∥22].这里,σi 是采样噪声水平,vθ 是视频速度预测器,恢复目标保留原始 zi,以教会模型纠正类似 rollout 的错误。
为了将这种预测基础迁移到动作生成,作者采用因果到因果的世界-动作适应方法。通过非对称接口耦合视频专家和动作专家:视频查询只读取自身及更早的视觉块,而动作查询读取观测历史、部分去噪的未来以及整个噪声动作块。这样既保留了预训练的因果视觉依赖,又使动作基于过去和预期的交互。
如下图所示:
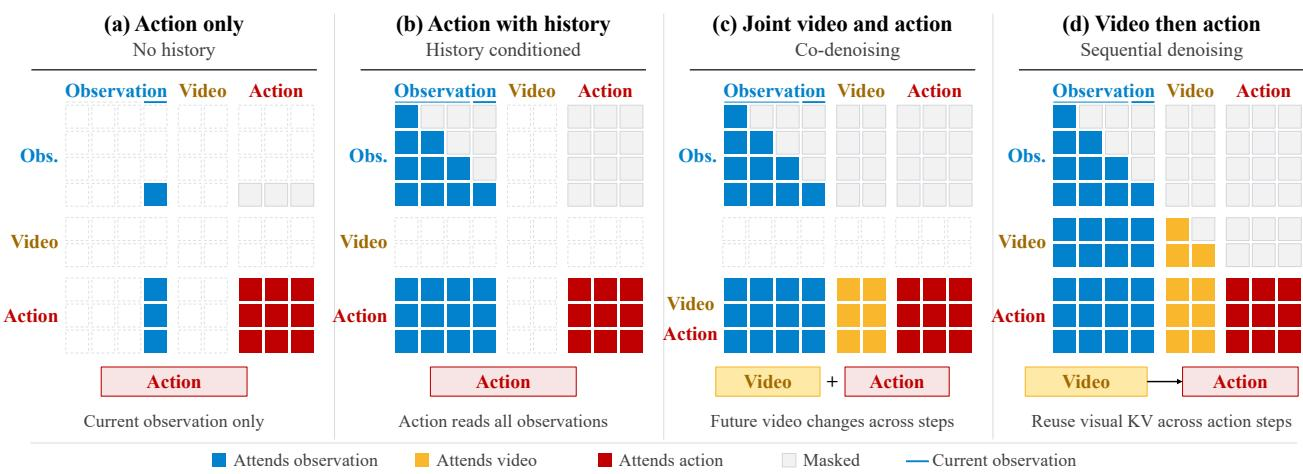
在控制步 t 做出决策时,令 Zt− 表示观测到的视频潜变量,qt 表示机器人状态,c 表示语言指令,At=at:t+H−1 表示 H 步动作块。视频专家将 Kv 个未来潜变量步 Zt+ 预测到噪声水平 σ⋆∈(0,1),然后将其联合视觉缓存 Kt 提供给动作专家:
Zt+=Rolloutθ,σ⋆(ϵv∣Zt−,c,qt),Kt=Prefillθ(Zt−,Zt+;c,qt,σ⋆),At=Denoiseψ(ϵa∣Kt,c,qt).这种先预测后行动的模式被称为逆动力学建模。训练使用两轮前向:先以干净历史为条件进行视频流匹配,再以历史和正向加噪的真实未来为条件进行动作流匹配。第二轮将视觉缓存分离,确保动作损失只更新动作专家和本体感受适配器。加权目标为 L=λvLvideo+λaLaction。
为了支持实时部署,作者协同设计了异步执行和边缘加速。异步调度使模型推理与机器人执行重叠。在决策 tk 处,预测块 Atk 的名义步长为 S,重叠为 O=R−S 步。在交接时,控制器丢弃已经过去的 prefix,并执行新块的对齐 suffix。为了满足更短重叠带来的更紧交接截止时间,流式因果 VAE 编码会在推理触发之前处理输入的帧组。
参见框架图:
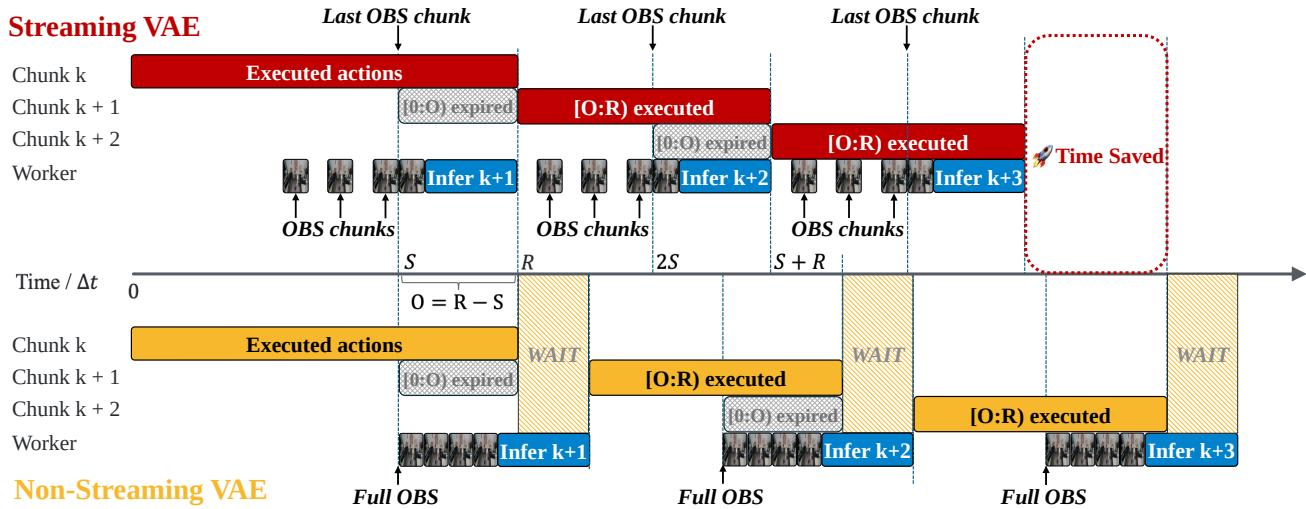
交接截止时间受到 Tready≤OΔt=(R−S)Δt 的约束,其中 Δt 是控制间隔。流式 VAE 避免了全窗口编码的重复等待,从而允许更晚触发和更短重叠,同时保留最新观测。
本地推理在边缘设备上加速,以支持短重叠执行,同时保留视觉想象。
如下图所示:
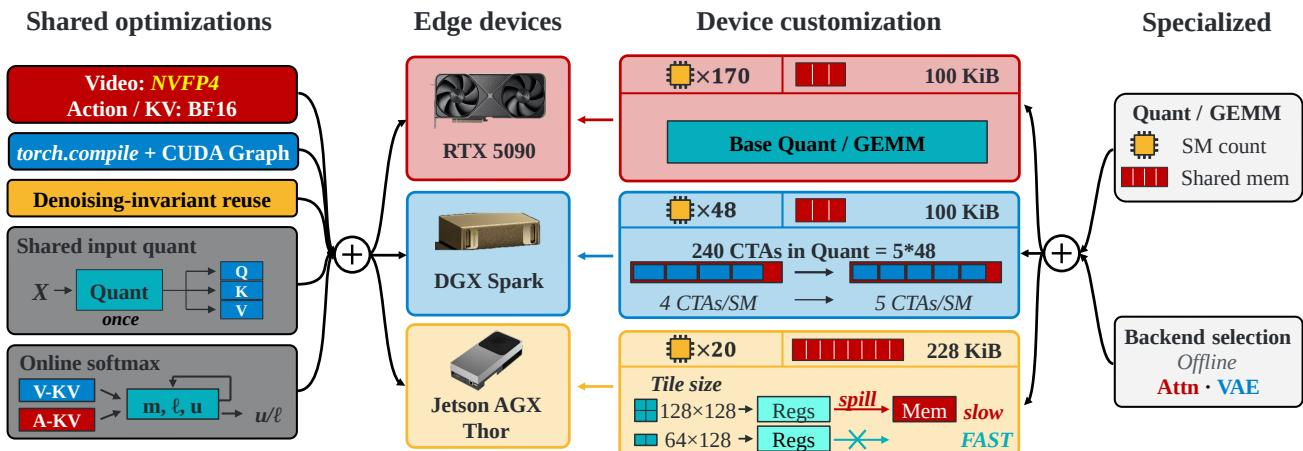
共享优化包括在生成和 KV prefill 期间对视频专家线性层使用 W4A4 NVFP4,而动作计算和 KV 存储保持 BF16,以维持控制精度。NVFP4 与 CUDA Graph 重放和 PyTorch 编译结合,以减少启动开销。系统还在每次推理调用中复用去噪不变的文本和状态 KV、观测视频 KV 以及 FP32 RoPE 表。共享输入量化对 Q、K、V 投影的输入进行一次量化,并在不同 GEMM 中复用量化后的激活。此外,对分离的视频和动作 KV 缓冲区的注意力使用在线 softmax 与共享归一化进行合并:
m=max(mv,ma),Attn=emv−mℓv+ema−mℓaemv−muv+ema−mua.设备特定的调优会调整 tile 大小、每个 block 的 warps 和流水线阶段,以在 RTX 5090、DGX Spark 和 Jetson AGX Thor 等平台上平衡可移植性与硬件效率。
实验
论文在 LIBERO、RoboTwin 2.0、DOMINO 和 RoboCasa GR-1 等仿真基准上评估了 Long-WAM(一种以视频预测为条件的动作去噪策略),并在 Unitree G1 和 YAM 机械臂上进行了真实机器人测试。结果表明,Long-WAM 在长时程和动态操作基准上领先,而消融实验表明,更长的视觉上下文、自回归机器人视频预训练和 IDM 视频-动作去噪策略都对性能提升有贡献。加入高层规划器进一步提高了组合任务和未见任务的成功率;真实世界试验展示了在移动传送带上的持续抓取和可靠的长时程操作。效率优化将 RTX 5090 上的推理延迟降低到约 107 ms,同时基本保持成功率并支持异步执行。
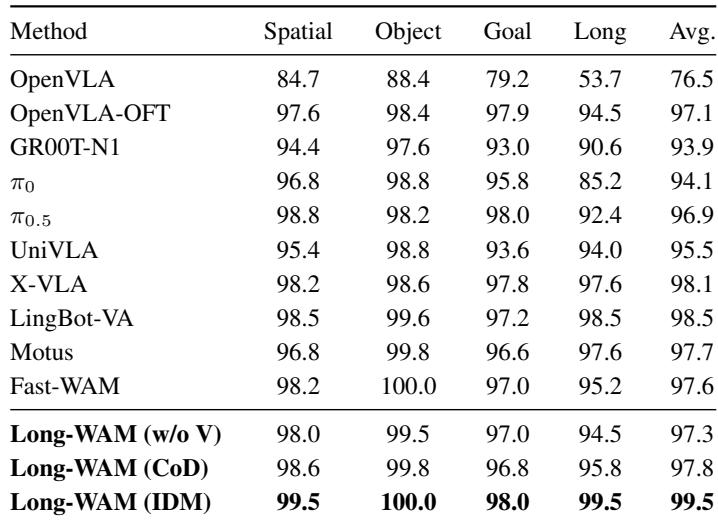
在 LIBERO 上,采用逆动力学建模的 Long-WAM 在已报告方法中取得了最高的平均成功率和最高的长时程成功率。其在 long 划分上的优势最大:在动作去噪之前进行未来视频预测,优于省略未来视频预测以及视频-动作联合去噪。OpenVLA-OFT 和 X-VLA 等强基线相比 OpenVLA 有显著提升,但仍低于 Long-WAM。Long-WAM (IDM) 在 LIBERO 平均成功率上领先,并在长时程划分上表现最佳。逆动力学建模的最大收益出现在长任务上,以明显优势超过无未来视频去噪和联合视频-动作去噪。OpenVLA 在长时程成功率上最弱,而 OpenVLA-OFT 和 X-VLA 是最强的基线替代方案。
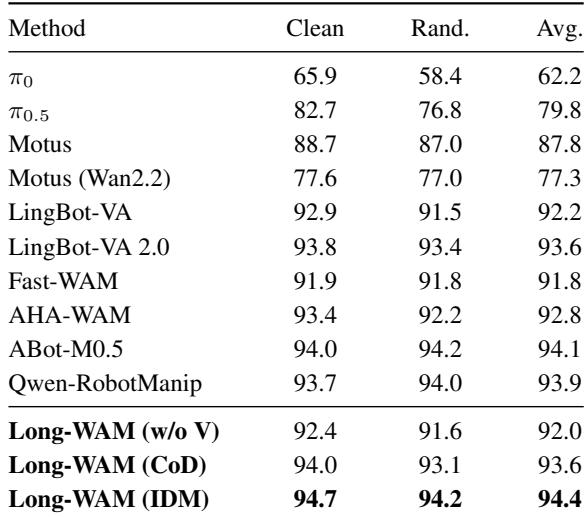
在 RoboTwin 2.0 上,采用 IDM 的 Long-WAM 总体领先,取得了最高的平均成功率和 clean 成功率,并追平了最佳 randomized 分数。它相比 LingBot-VA 2.0 有小幅优势,相比 Fast-WAM 和早期基线的优势更明显。Long-WAM (IDM) 在 RoboTwin 2.0 上取得了最高的平均成功率和 clean 成功率,并在最佳 randomized 分数上并列第一。其平均成功率领先 LingBot-VA 2.0 0.8 个百分点,并进一步领先 Fast-WAM、Motus 和 π 基线。
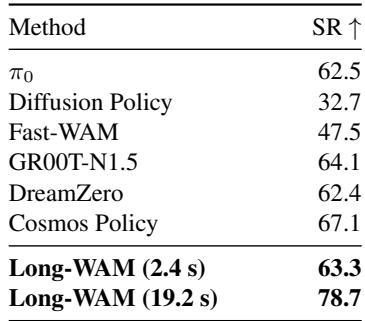
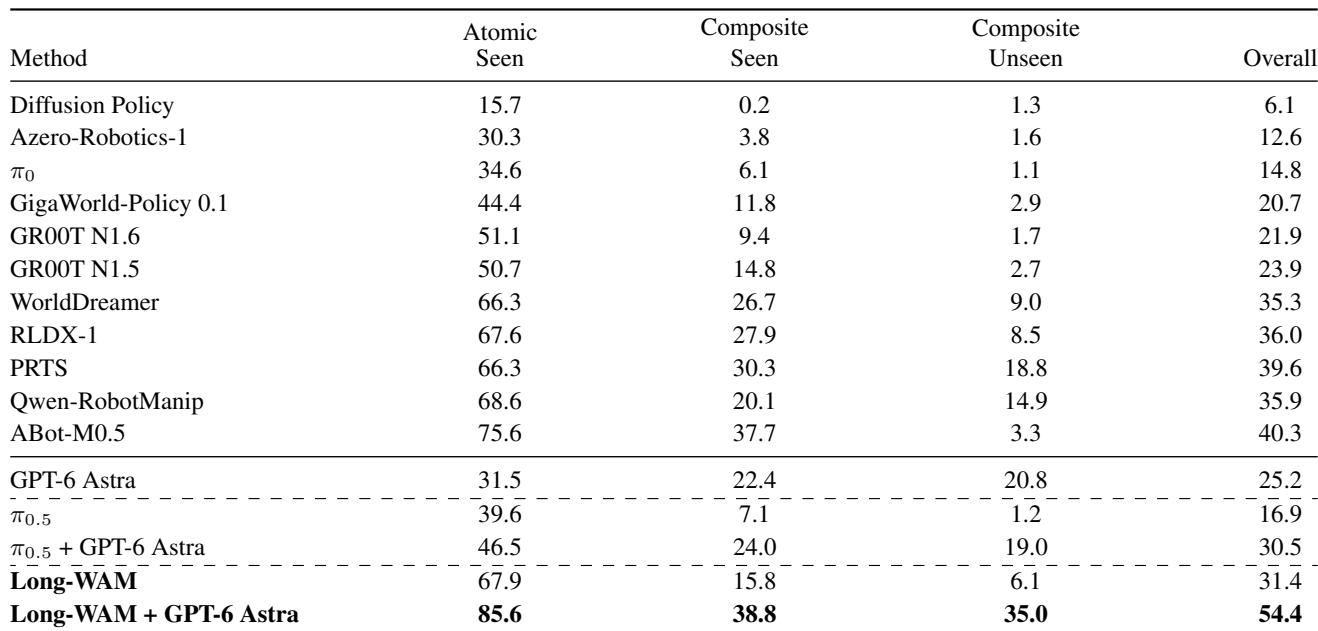
在 RoboCasa365 组合基准上,具有 2.4 秒上下文的 Long-WAM 成功率处于 60% 出头,远高于 Diffusion Policy 和 Fast-WAM,略低于最佳报告方法 Cosmos Policy。使用 GPT-6 Astra 进行规划器增强给 Long-WAM 带来的整体收益大于 π0.5 层级结构,表明对于更长时程的组合任务,执行质量与高层规划相互补充。Long-WAM 以较大优势超过 Diffusion Policy 和 Fast-WAM,并与最强基线具有竞争力,仅落后 Cosmos Policy 几个百分点。加入高层规划器对 Long-WAM 的提升大于 π0.5 层级结构,支持规划与执行之间的分工。
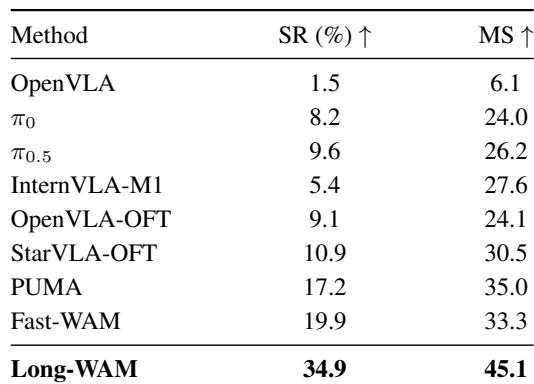
在 DOMINO 上经过动态数据微调后,Long-WAM 在已报告方法中取得了最高的成功率和操作得分。其成功率几乎是最佳列出基线的两倍,操作得分也大幅领先。大多数其他模型仍远远落后,表明该基准的难度较高。Long-WAM 在动态数据微调后以 34.9% 的成功率和 45.1 的操作得分领先。Long-WAM 比最强的成功率基线高 15.0 个百分点,比最强的操作得分基线高 10.1 个百分点。列出的基线成功率低得多,大多集中在个位数到百分之十几的区间。
在 RoboCasa365 上,单独的 Long-WAM 提供了很强的原子任务执行能力,并在原子成功率上超过单独的 GPT-6 Astra 和列出的参考策略。在不进一步训练策略的情况下加入高层规划器,可显著提高 composite-seen 和 composite-unseen 成功率,使整体性能远高于最强参考基线。仅使用较短的 15 步执行时,组合成功率低得多,因此规划似乎是未见组合泛化的关键因素。单独的 Long-WAM 是强大的执行基础:其 atomic-seen 成功率明显高于单独的 GPT-6 Astra;在没有规划器的情况下更频繁地进行 15 步查询,也几乎缩小了与层级系统的差距。规划器增强使 composite-seen 成功率提高了一倍以上,并使 composite-unseen 成功率提高了五倍以上,而仅使用 15 步控制在两个组合划分上仍接近或低于 11%。经过规划器增强的策略在已报告方法中达到最高整体成功率,以较大优势超过最强参考基线。
评估覆盖 LIBERO、RoboTwin 2.0、RoboCasa365 和 DOMINO,包括长时程操作、双臂控制、组合泛化和动态数据微调。采用逆动力学建模的 Long-WAM 持续领先或具有竞争力,在长时程和组合任务上收益最大。动作去噪前的未来视频预测和规划器增强改善了执行能力和未见组合泛化,而动态数据微调显著提升了 Long-WAM 在 DOMINO 上相对基线的表现。总体而言,Long-WAM 在大多数设置下优于或追平最强的已报告基线。