Command Palette
Search for a command to run...
Recursive Game Creator:一种面向体验的智能体产品级游戏开发框架
Recursive Game Creator:一种面向体验的智能体产品级游戏开发框架
Jiajun Chen Haoyu Wu Mingda Jia Xihui Liu
摘要
近年来,游戏设计智能体在生成可玩游戏方面取得了显著进展。然而,程序正确并不能保证玩家获得愉悦的体验。我们提出了 Recursive Game Creator,这是一个面向体验的开发框架,旨在将智能体游戏开发从粗糙的游戏原型推进为具有娱乐性的游戏。Recursive Game Creator 围绕四个组件组织递归式开发:设计器(Designer)、构建器(Builder)、玩家(Player)和评审器(Reviewer)。设计器将用户指令和评审器反馈转化为详细计划。构建器将这些计划转化为候选游戏。编码原生的 Player 通过编程接口创建并执行可复用策略,以高效收集多样化的游戏轨迹,从而缓解基于 GUI 的收集速度缓慢所导致的评估偏差。评审器使用精心设计的基于轨迹的指标来引出玩家偏好,并结合视觉证据与显式文本偏好,依据游戏特定标准对游戏进行评估。最后,评审器接受更好的版本,并为下一轮提供改进评审,从而闭合递归循环。我们的方法在 GameCraft-Bench 上取得了 77.89 的最先进整体性能。在 GameASG-Bench 上,它实现了 53.2% 的严格任务成功率,比同模型基线提高了 34.1%,并在所比较的方法中获得了最高的平均运行时检查通过率 93.4%。用户研究表明其具有更长的游玩时间和更高的评分。代码即将发布。
一句话总结
香港大学 HKU MMLab 与深圳 Loop Area Institute 的研究人员提出 Recursive Game Creator,这是一种以体验为导向的 agentic 框架,通过 Designer、Builder、coding-native Player 和 Reviewer 组件迭代优化游戏,在 GameCraft-Bench 上取得 77.89 的当前最优总分,并在 GameASG-Bench 上取得 53.2% 的严格任务成功率,且在对比方法中拥有最高的平均运行时检查通过率 93.4%。
核心贡献
- 本文介绍 Recursive Game Creator,这是一种以体验为导向的递归框架,协调 Designer、Builder、Player 和 Reviewer,将粗略的游戏原型演化为更具娱乐性的游戏。
- coding-native Player 通过编程式接口创建并执行可复用策略,高效收集多样化的游戏轨迹,并减少因缓慢的基于 GUI 的游玩方式所带来的评估偏差。
- Reviewer 使用基于轨迹的指标来归纳玩家偏好,整合视觉证据与显式文本偏好,并选择更优版本,同时为下一轮生成改进评审;评估显示在 GameCraft-Bench 上取得 77.89 分总分,在 GameASG-Bench 上取得 53.2% 的严格任务成功率,相较同模型基线提升 34.1%,并拥有最高的平均运行时检查通过率 93.4%。
引言
作者针对 agentic 游戏开发中的一个关键空白:coding agents 可以生成可运行的游戏,但成功执行并不能衡量游戏玩法是否具有吸引力、节奏是否恰当、逻辑是否连贯或响应是否及时。先前的迭代工作流通常依赖 GUI 驱动的测试,这种方式可能遗漏结构化状态、合法动作、事件和进度信号,而视觉决策会引入延迟并限制频繁、细粒度的评估。作者提出 Recursive Game Creator,这是一种以体验为导向的递归框架,模拟游戏工作室中 Designer、Builder、Coding-Native Player 和 Experience-Oriented Reviewer 等角色。该框架收集编程式游戏轨迹,执行针对具体游戏的体验评审,并将基于偏好的反馈转化为多轮游戏优化,在 GameCraft-Bench 和 GameASG-Bench 上取得当前最优结果。
方法
Recursive Game Creator:闭环体验优化框架
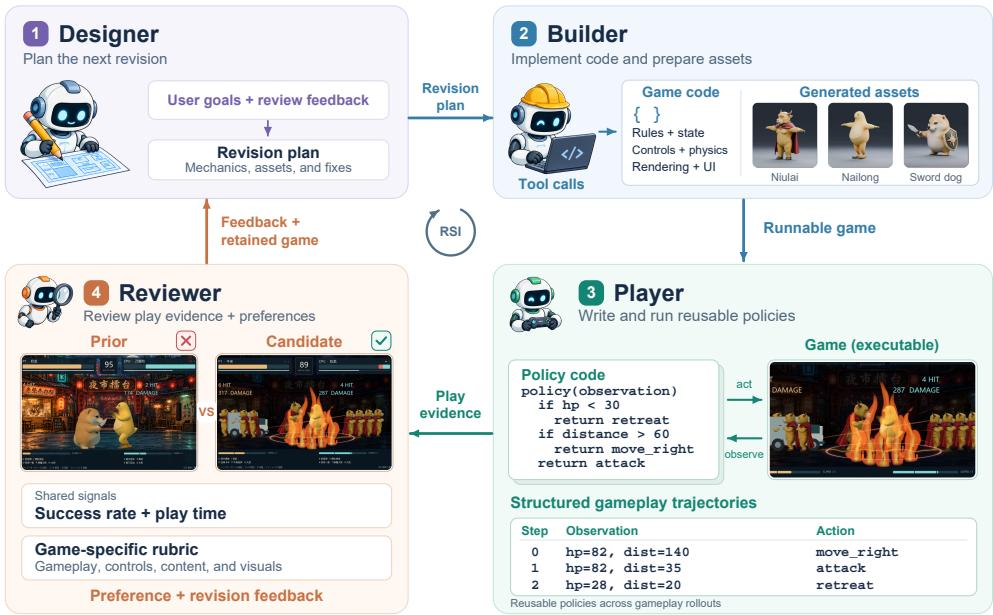
作者将 Recursive Game Creator 作为一个闭环系统,连接游戏构建、基于策略的游玩、体验评估与迭代优化。该循环由四个协作角色组成:Designer、Builder、Player 和 Reviewer。Designer 将用户需求与先前评估反馈转换为结构化计划。Builder 将该计划实现为可玩的候选版本。Player 针对候选版本执行基于代码的策略,以收集行为轨迹和视觉记录。随后 Reviewer 根据体验标准评估这些轨迹和观察结果,其发现用于指导下一轮设计计划。
Designer 与 Builder
Designer 将用户简述扩展为具体规格,涵盖核心游玩循环、机制、进程与难度、视觉方向以及制作优先级。它结合当前游戏状态、近期反馈与用户需求,生成如下形式的计划:
Pt=Design(U,Gt,Ht−1)=(ht,Δt,At,Xt),其中 U 表示用户简述,Gt 表示当前游戏,Ht−1 表示可用的近期反馈。假设 ht 说明了预期的体验改进及其依据。变更规格 Δt 描述了具体的修改内容以及需要保留的优点。验收目标 At 定义了目标场景、玩家输入和可观察的结果。资源请求 Xt 列出了所需的生产资源。这种表示方式将体验目标转化为实现决策和可测试的目标。
Builder 继承 Designer 的计划,并根据游戏机制、交互需求、视觉方向和资源需求选择实现工具。实现过程从可玩的草稿推进到集成的候选版本:
Zt=Draft(Gt,Δt),Xt∗=Generate(Xt;Zt),Ct=Integrate(Zt,Xt∗),其中 Zt 表示草稿,Xt 表示请求的资源,Xt∗ 包含框架实际生成的资源,Ct 表示集成的候选版本。在草稿阶段,Builder 实现核心循环和计划的变更,在需要时使用占位符。随后生成的资源被集成并在游玩场景中进行检查,包括它们与碰撞、动画和交互区域的相互作用。有针对性的自检与配置的项目检查相互配合,作为 Player 后续收集的更广泛游玩证据的补充。该工作流明确将资源生产与游戏内验证联系起来,因为仅生成资源本身并不能证明对游玩的改进。
Coding-Native Player
Player 构建可执行的游戏策略,并将策略生成与重复交互分离。每个策略读取游戏暴露的状态并选择有效动作,从而无需在每一步都依赖语言模型响应或视觉解释即可实现基于状态的控制。对于第 t 轮的候选版本 Ct,策略 πt,k 通过以下方式产生轨迹 τt,k:
τt,k=Rollout(Ct,πt,k),Et={(τt,k,Vt,k)}k=1K,其中 Vt,k 表示可用的视觉记录,证据集 Et 包含来自 K 次 rollout 的记录。
策略构建首先读取状态模式、可用动作和测试目标。Player 编写一个策略,观察状态、选择动作并重复执行,直到任务结束或达到 rollout 预算。策略通过游戏的编程式接口或命令行接口运行,rollout 请求作为执行任务分发,从而可以使用重复试验和独立的游戏实例。Player 检查结果和执行失败情况,在必要时修改策略代码。对话式响应不会替代实际执行 rollout。
不同策略在策略风格、技能水平、探索程度和风险容忍度上有所不同。一种策略可能倾向于快速推进,而另一种策略则探索可选内容。产生的轨迹记录暴露的状态、动作、事件、进度、经过时间和终止结果。并行或重复执行在已知策略设置下提供多次尝试和失败案例。策略和观察设置随每条轨迹一并记录,以便对不同游戏版本之间的比较保持可控。
这些轨迹支持对完成度、难度、探索内容和失败或停滞点的估计。直接访问状态和事件避免了从每一帧渲染画面中重建这些变量。轻量级执行和并行采样使重复试验成为可能,多样的策略可以发现单一策略遗漏的失败情况。总测试成本包括策略生成、修复、执行和评审。代理策略提供了多样化的测试行为,但作者指出它们并不能代表完整的人类玩家群体。人类轨迹和显式反馈为个体偏好提供了额外证据。
Experience-Oriented Reviewer
Reviewer 将行为轨迹、视觉观察和用户输入整合为体验评估和可执行的修改反馈。其输入与被评估的游戏版本以及策略或玩家会话相关联,评估过程中保持观察到的行为、推断的偏好和显式用户请求之间的区分。
Player 提供来自不同技能和策略的多个轨迹。Reviewer 使用这些证据来估计成功率,并检查游玩在哪里结束或卡住。目标不是尽可能高的成功率,而是适合目标玩家的难度水平。过于容易的成功可能缺乏挑战性,而反复失败可能导致挫败感。比较不同策略之间的结果有助于评估进度是否可达以及更强的游玩是否得到回报。对于版本比较,策略设置和观察访问必须保持一致。
相同的轨迹记录了游玩时间。Reviewer 将运行时间与进度、探索内容以及停止原因结合起来进行考察。这有助于区分内容丰富多样的长时间游玩与在同一地点卡住的长时间游玩。成功率和游玩时间支持对难度和可玩性的更广泛评估,但两者都仍然是对所测试策略的度量。仅凭代理游玩时间不能反映人类的兴趣或乐趣。
Reviewer 还使用针对具体游戏的评估标准。它从共享的评估维度出发,例如控制响应性、内容丰富度、叙事或进程节奏、视觉一致性以及对探索或重玩的支持。然后它将这些维度实例化为适合游戏类型和预期体验的标准。例如,竞速游戏可能需要清晰的赛道引导、灵敏的转向和可见的碰撞反馈,而视觉小说可能需要连贯的对话和后果可辨的选择。Reviewer 检查规则、视觉线索和观察到的游玩之间的一致性,并说明优势、劣势和权衡,而不是对互不相关的标准进行简单平均。
视觉证据与快速控制循环分开处理。Reviewer 获取渲染游戏画面的采样截图和可用录像,并在不查看源代码或版本顺序的情况下,将它们与游玩报告一起进行审查。轨迹显示了策略在哪里成功、失败或停止推进,而渲染画面显示了玩家在那些时刻能够看到的内容。Reviewer 使用这些证据来评估文本可读性、视觉风格和动作反馈。每条观察均与其游戏版本、策略和回放相关联,Reviewer 将发生了什么与可能导致其原因分开。一次失败的转向可能反映出控制不佳、提示不清或策略薄弱。当原因不确定时,反馈会指出哪些进一步证据有助于解决该问题。
Reviewer 将轨迹模式、视觉发现和显式用户输入转化为结构化的偏好记录。该记录描述了期望的体验、支持证据、偏好是推断的还是用户陈述的,以及相应的修改优先级。例如,倾向于探索可选区域可能表明对发现感兴趣,而用户要求降低战斗强度的请求则提供了明确的难度目标。这些观察为设计假设提供信息,而不是仅凭游玩时间来建立偏好。
在版本比较与保留方面,Reviewer 使用相同的共享信号和针对具体游戏的标准,将候选版本与保留的游戏进行比较。它检查变更是否解决了先前的修改目标,以及是否引入了新问题。输出为 A/B 偏好、平局或无法判断,并附有原因和证据路径。反馈说明了问题、可能的原因、对游玩的影响以及带有后续检查的修改目标。然后框架将 Reviewer 的判断映射回游戏版本,并选择要保留的产物。
实验
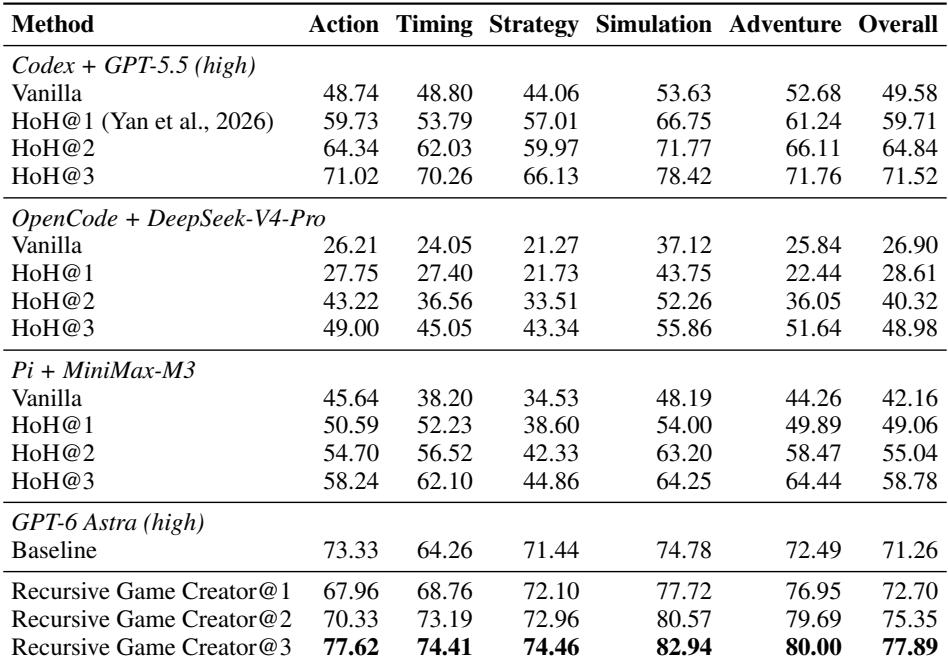
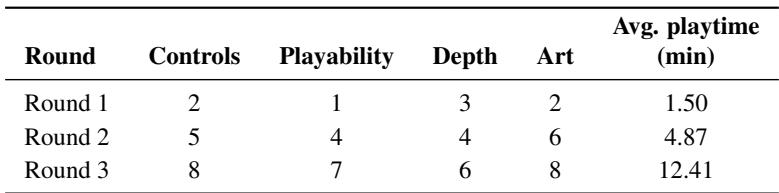
评估覆盖针对完整 Godot 游戏的 GameCraft-Bench、针对需求合规性的 GameASG-Bench、定性多轮分析、player rollout 覆盖率,以及关于以体验为导向的定制化的用户研究。Recursive Game Creator 在三个优化轮次中提高了整体游戏质量,优于同模型基线和最强报告基线,在全部五个质量类别上均有所提升。定性示例显示,修改扩展了内容并澄清了动作类、视觉小说类和竞技场类游戏中的游戏状态、可用动作和反馈。用户研究报告了操控、可玩性、深度和美术方面的明显改善,以及平均游玩时间的增加。
递归方法将 GameCraft-Bench 总分从第一轮优化提升至第三轮,从略高于同模型基线提高到明显领先所有已报告基线。所有五个评估类别均有所改善,其中动作类游戏的相对提升最大,但需要更多轮次才能超过基线动作得分。迭代基线也随着额外轮次而改善,但其最终得分仍低于递归方法的最终结果。递归优化在多轮次中提高了整体质量,所有五个游戏类别在三个轮次中均有所提升。动作类显示出最大的类别改进,尽管其早期轮次低于同模型基线,但在最后一轮超过该基线。最终总分超过最强报告基线,而多轮基线也随着额外优化轮次而改善。
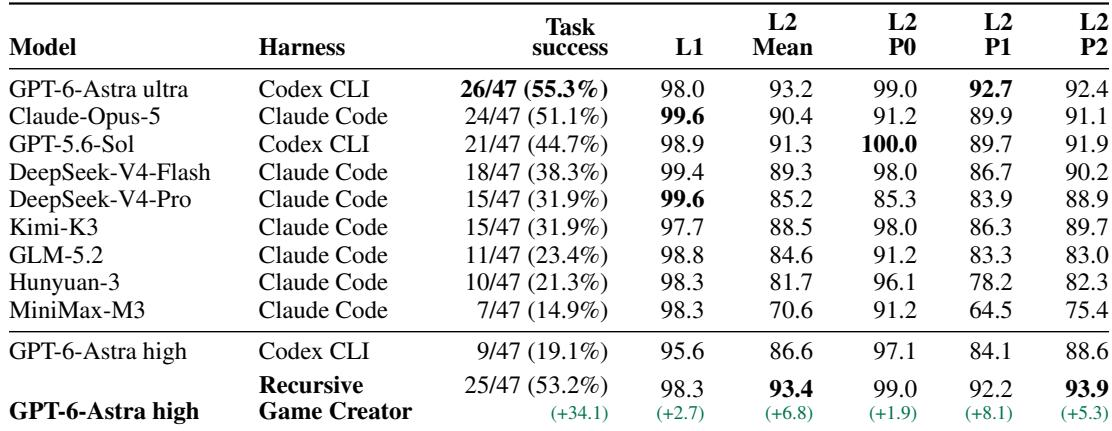
GameASG-Bench 将源代码检查与基于浏览器的游戏玩法检查分开,L1 源代码通过率在各系统中保持较高,而 L2 游戏玩法通过率差异较大。Recursive Game Creator 完成了 47 个任务中的 25 个,在任务成功率上略低于最佳基线,但在平均 L2 和扩展功能通过率上高于所有报告的配置。排名较低的基线在 L2 表现上逐渐减弱,特别是在必需和扩展游戏玩法检查方面。Recursive Game Creator 在报告配置中实现了最高的平均 L2 和 L2 P2 通过率,任务成功率仅次于领先基线。在各基线中,随着 L2 P1 和 L2 P2 通过率的下降,任务成功率大幅下降,而 L1 源代码得分始终保持较高。启动和界面检查总体上表现良好,最佳任务成功基线和 Recursive Game Creator 在 L2 P0 上均达到 99.0%。
在各优化轮次中,专家对操控、可玩性、深度和美术的评分均有所提高,其中操控和美术从低分提升至高分。平均游玩时间也从不到两分钟增加到超过十二分钟,表明可玩内容更加充实。改进涵盖交互、内容和呈现方面。操控、可玩性和美术在各轮次中提升最大,而深度的提升相对温和。平均游玩时间从不到两分钟增加到超过十二分钟,与评分改善相平行。
实验在三个互补设置中评估了递归优化。在 GameCraft-Bench 中,递归优化在各轮次中提高总分并超过所有报告基线,全部五个游戏类别均改善,动作类游戏在后期增幅最大。在 GameASG-Bench 中,源代码检查在各系统中保持较强,而游戏玩法检查差异更大;Recursive Game Creator 在任务成功率上略落后于最佳基线,但在 L2 和扩展功能通过率上领先,启动和界面检查总体稳健。专家评分进一步表明,递归优化改善了操控、可玩性、深度和美术,而平均游玩时间从不到两分钟增加到超过十二分钟,表明可玩内容更加充实。