Command Palette
Search for a command to run...
重新思考跨分词器的在线策略蒸馏:从对齐覆盖到监督可靠性
重新思考跨分词器的在线策略蒸馏:从对齐覆盖到监督可靠性
Bingxi Hou Guochao Jiang Guofeng Quan Weiqing Li Wenfeng Feng Guohua Liu Yuewei Zhang
摘要
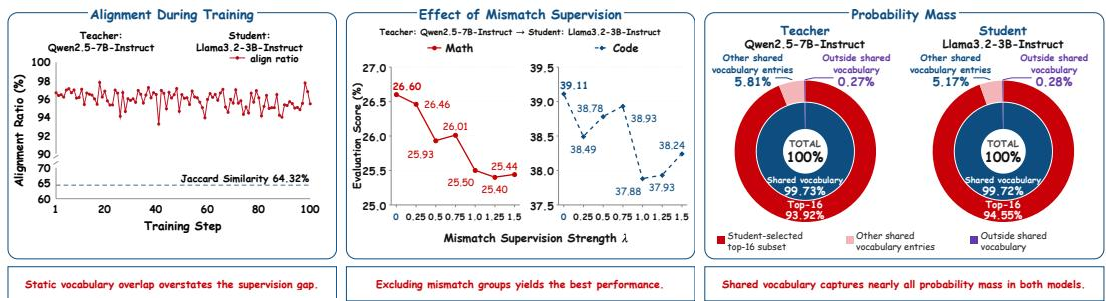
在线策略蒸馏(OPD)利用教师反馈在学生自身生成的内容上训练学生模型。当分词器不同时,比较教师与学生的预测需要在序列和词表两个层面进行对齐。本文考察了扩大这种对齐覆盖范围是否能够改善学习。在数学推理和代码生成任务的三对异构教师-学生组合中,尽管词表差异显著,严格的 1:1 对齐组已经覆盖了学生生成的大部分 token。对蒸馏前从学生模型采样的响应进行统计,平均而言,共享词表在严格对齐的位置上几乎保留了教师和学生的全部概率质量。将逆向 KL 限制到每个严格位置上由学生选出的共享词表 top-16 子集,可以达到与完整共享词表 OPD 相当的准确率,并优于所评估的跨分词器基线。在不匹配组中对 span 对数概率添加均方误差监督可以实现完整的监督覆盖,但准确率反而下降。在仅使用严格损失训练得到的检查点处,span 梯度与严格梯度之间呈现较弱或负的方向一致性,并且其幅度相对严格梯度不断增大。这些诊断结果或许有助于解释加入 span 监督后准确率下降的原因。我们的发现促使研究重心从最大化对齐覆盖转向优先考虑监督可靠性:严格位置上的紧凑监督可能比引入弱对齐或冲突训练信号的更广泛覆盖更有效。
一句话总结
阿里云计算的研究人员表明,在跨 tokenizer 的 on-policy 蒸馏中,严格 1:1 对齐组已经覆盖了大多数学生生成的 token,并且在严格位置将反向 KL 限制到学生选择的 top-16 共享词汇子集,可以达到与完整共享词汇 OPD 相当的效果,同时优于基线;而加入 span MSE 监督会降低准确率,这促使研究重点从最大化对齐覆盖率转向优先保证监督可靠性。
核心贡献
- 本文分析了跨 tokenizer on-policy 蒸馏在数学推理和代码生成任务中的对齐覆盖率,表明严格 1:1 对齐组覆盖了大多数学生生成的 token,并且在严格位置保留了教师和学生几乎全部的概率质量,尽管存在词汇不匹配。
- 本文证明,在严格位置将反向 KL 蒸馏限制到学生选择的共享词汇 top-16 子集,可以达到与完整共享词汇蒸馏相当的准确率,同时优于所评估的跨 tokenizer 基线。
- 研究表明,在 mismatch 组上添加 span log-probability MSE 监督会降低下游准确率,其梯度诊断显示其与严格梯度的方向一致性较弱或为负,并且相对幅度随训练增大,这促使研究重点从最大化对齐覆盖率转向优先保证监督可靠性。
引言
On-policy 蒸馏利用教师反馈,在语言模型自身生成的响应上训练学生模型,这之所以重要,是因为它使学生模型在学生实际访问的状态上与教师偏好对齐。当学生和教师使用不同 tokenizer 时,同一响应可能具有不同的 token 边界和不同词汇表上的下一个 token 分布,因此跨 tokenizer 蒸馏必须同时处理序列级和词汇级对齐。此前的方法,如 rank matching、learned mappings、likelihood matching、byte-level outputs 和 multi-token grouping,旨在恢复更多监督,但它们通常强调对齐覆盖率,而没有充分检验新增监督是否对学习有用。作者考察了严格的跨 tokenizer 蒸馏,并发现严格对齐已经覆盖了大多数学生生成的 token,尽管静态词汇差距很大;并且一个紧凑的学生选择 top-k 共享词汇子集保留了几乎全部蒸馏收益。相比之下,为未匹配 span 添加 span log-probability MSE 虽然实现了完全覆盖,却降低了准确率,这促使研究重点从对齐覆盖率转向监督可靠性。
方法
On-Policy 蒸馏(OPD)通过从学生模型自身采样轨迹,并在学生实际访问的前缀上将学生分布与教师模型分布对齐来训练学生语言模型。该过程可视为一个稠密 KL 约束的强化学习设置,其中教师分布引入 token 级奖励。在共享 tokenizer 下,OPD 最小化以下目标:
LOPD(θ)=Ex∼D,y∼πθ(⋅∣x)[i=1∑LKL(πθ(⋅∣x,y<i)∥πT(⋅∣x,y<i))].当将该方法推广到不同模型家族且 tokenizer 不同时,同一文本可能被赋予不同的 token 边界和词汇表条目。因此,跨 tokenizer OPD 必须同时考虑序列级和词汇级对齐。作者采用 token 组对齐,使用两个模型的 tokenizer 对解码后的学生响应进行评分和对齐。得到的学生和教师响应 token 序列分别记为 y=(y1,…,yL) 和 v=(v1,…,vn)。通过保留两个序列共有的 token 偏移,响应被划分为成对的对齐 token 组:
S(y)={(Srθ,SrT)}r=1R.这些组分为严格 1:1 组和 mismatch 组;严格 1:1 组中一个学生 token 和一个教师 token 跨越相同区间,mismatch 组需要至少一侧的多个 token 来构建相同 span。
为了对齐预测,作者通过匹配底层 token 来确定共享词汇表 V∩=Vθ∩VT。对于严格 1:1 组,学生和教师分布被限制并在该共享词汇表上重新归一化。严格跨 tokenizer 目标随后对严格对齐位置的反向 KL 散度求和:
L1:1(θ)=Ex∼D,y∼πθ(⋅∣x)r∈A1:1(y)∑KL(πˉθ(⋅∣x,y<ir)∥πˉT(⋅∣x,v<jr)).如下图所示,对该跨 tokenizer 方法的诊断评估表明,训练期间严格对齐率保持较高,共享词汇表捕获了两个模型几乎全部的概率质量,并且排除 mismatch 组可获得最佳性能。
为了评估其余 mismatch 组的学习价值,作者引入了 span 监督。对于每个 mismatch 组,分别计算学生和教师对观测 token 路径的概率。使用 log-probability 形式下的均方误差损失,在这些 mismatch 组上匹配这些概率:
Lspan(θ)=Ex∼D,y∼πθ(⋅∣x)r∈Amis(y)∑(logqθ(r)−logqT(r))2.总训练损失将严格目标与 span 监督按权重因子 λ 组合:
Lλ(θ)=L1:1(θ)+λLspan(θ).如下图所示,mismatch 权重对不同教师-学生对的完整平均准确率的影响表明,仅使用严格监督时性能最好。
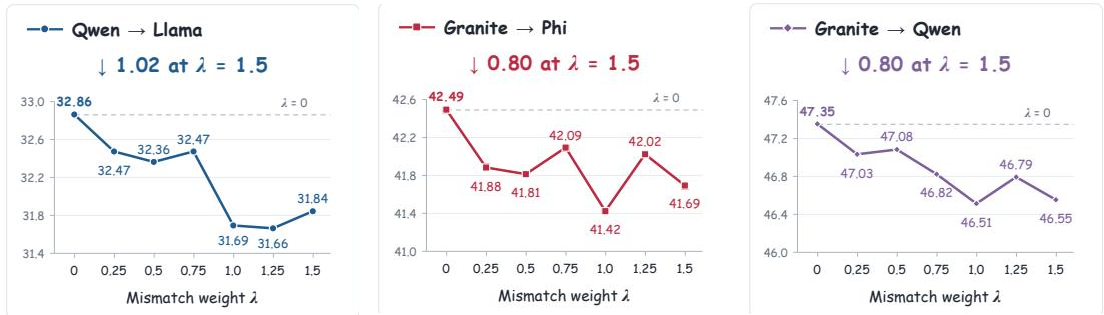
通过改变 λ,作者在保持完全监督覆盖率的同时控制 span 损失的影响。然而,实验结果表明,为 mismatch 组添加 span 监督往往会在测试的权重范围内降低下游准确率,这证实严格匹配保留了最有用的监督。
实验
实验在三个教师-学生对上研究跨 tokenizer 知识蒸馏,使用一个数学和代码提示的共享池,并在数学和代码基准上进行下游评估。实验验证了在学生生成轨迹上严格 token 对齐覆盖大多数位置,尽管静态词汇不匹配很大;而为剩余 mismatch 组添加 span 监督会持续损害准确率。共享词汇表保留了几乎全部预测概率质量,在较小的学生选择 top-k 子集上进行蒸馏保留了严格监督的大部分收益,同时优于四个基线。梯度诊断显示,span 损失梯度与严格损失梯度的一致性较差,并且相对幅度在训练过程中增大,这有助于解释完全覆盖的负面效果。
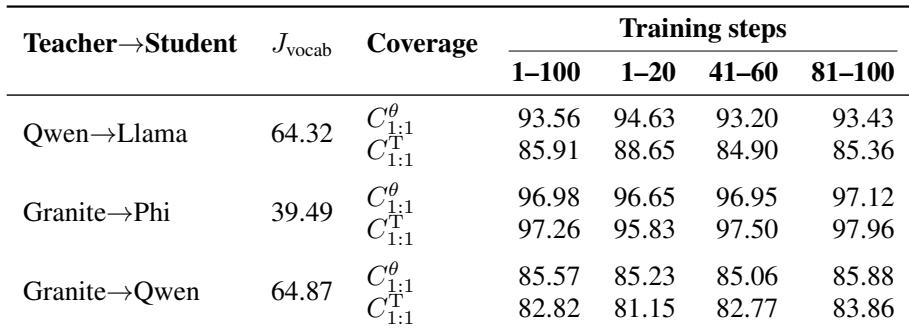
学生轨迹上的严格 token 覆盖率在所评估的模型对中保持较高,即使静态词汇重叠差异显著。静态词汇 Jaccard 重叠最低的模型对,在两种 tokenizer 下也具有最高的严格覆盖率。覆盖率在训练窗口之间保持稳定,表明较大的静态词汇不匹配可以与大多数位置的严格对齐并存。严格的 student 和 teacher token 覆盖率在所有模型对中保持较高,尽管静态词汇重叠范围约为 39% 到 65%。Granite 到 Phi 的静态词汇 Jaccard 重叠最低,但在两种 tokenizer 下严格覆盖率最高。在每个模型对内,严格覆盖率在不同训练窗口间变化很小,student token 最多变化 1.43 个百分点,teacher token 最多变化 3.75 个百分点。
严格全词汇蒸馏在所有三个跨 tokenizer 对上一致地提升了数学和完整平均准确率,优于基线替代方法和基础模型,其中 Granite-to-Qwen 的完整平均提升最大。代码准确率较为混合,但严格全词汇仍达到或接近最佳。紧凑的学生选择子集几乎保留了严格全词汇的全部学习收益。严格全监督在每个教师-学生对上的数学和完整平均准确率均领先于所有基线替代方法。学生选择 top-k 子集几乎保留了全部严格全蒸馏收益,并且更大的子集没有带来持续进一步的提升。
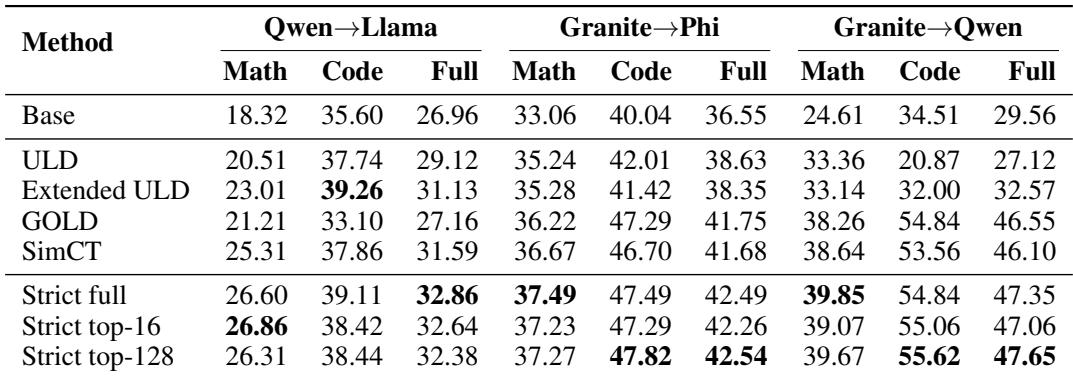
该评估考察了多个教师-学生对上的跨 tokenizer 蒸馏,测量 token 覆盖率和下游准确率。严格 token 覆盖率在各模型对之间保持较高,即使静态词汇重叠差异显著,表明词汇不匹配并不妨碍紧密的序列对齐。严格全词汇蒸馏一致地提升了数学和完整平均准确率,优于基线,其中 Granite-to-Qwen 的完整平均提升最大,而代码准确率较为混合。紧凑的学生选择子集几乎保留了这一严格蒸馏收益,使用更大的子集没有持续优势。