Command Palette
Search for a command to run...
VisionWeave:将弹性视觉表示编织作为 MLLMs 的原生能力
VisionWeave:将弹性视觉表示编织作为 MLLMs 的原生能力
摘要
多模态大语言模型已成为视觉理解的主导范式,但将输入编码为密集、固定大小的 patch token 会带来显著成本。然而,视觉信息分布并不均匀:一些区域需要细粒度细节,而其他区域可以采用紧凑表示。下采样会牺牲这些细节,而现有的 token 剪枝和自适应方法在内容自适应粒度、任务泛化以及与现代 MLLMs 和服务基础设施的集成方面仍然存在局限。克服这些局限需要基础模型端到端地学习在何处、以何种粒度分配视觉表示,我们将这种原生能力称为弹性视觉表示编织。我们提出了 VisionWeave,通过大规模训练在前沿级 MLLMs 中建立这一能力。该方法结合两个组件:一个门控空间池化器在共享的 MRoPE 坐标中,在原生细粒度表示旁构建粗粒度表示;一个粒度路由器学习其内容自适应分配。仅通过自蒸馏,我们在 Qwen3.5-4B 上验证了这一能力,并将其扩展到 Qwen3.8-27B,总计算量超过 30K A100 GPU 小时。基于 Qwen3.8-27B,VisionWeave 根据视觉内容自适应调整 token 节省量,在八个基准上平均节省 43.0% 的 token,同时保留 98.9% 的原生性能;相比之下,固定 50% 节省目标的 token 剪枝基线仅保留 88% 的性能。大量评估证实了在多样化任务、分辨率和视频帧上均具有稳健的效率-质量权衡。在部署到 SGLang 服务引擎上时,我们的方法实现了 2.30× 的端到端吞吐量提升,同时将平均 TTFT 降低 54.4%,平均 TPOT 降低 60.6%。我们相信,这些结果共同表明弹性视觉表示编织是下一代多模态基础模型中一项有前景的能力,能够根据信息内容原生地调节计算开销。我们的 SGLang 代码和其他细节将在 https://github.com/FFY0/VisionWeave 提供。
一句话总结
中国科学技术大学、Alibaba Token Hub 及其他关联机构的研究人员提出 VisionWeave,该方法通过门控空间池化器和由自蒸馏训练的粒度路由器,将弹性视觉表示编织作为 MLLM 的一项原生能力进行学习,在 Qwen3.8-27B 上节省 43.0% 的 token,同时保留 98.9% 的原生性能,并在 SGLang 服务引擎上获得 2.30× 的端到端吞吐量提升。
核心贡献
- VisionWeave 将弹性视觉表示编织确立为 MLLM 的一项原生能力,其方式是在共享 MRoPE 坐标内,将用于粗粒度表示的门控空间池化器与用于内容自适应分配的粒度路由器相结合。
- 该方法仅通过自蒸馏端到端地学习自适应视觉 token 分配,在 Qwen3.5-4B 上验证,并扩展到 Qwen3.8-27B,使用超过 30K A100 GPU 小时。
- 在 Qwen3.8-27B 上,VisionWeave 在八个基准上平均节省 43.0% 的视觉 token,同时保留 98.9% 的原生性能;在 SGLang 服务中,端到端吞吐量提升 2.30 倍,平均 TTFT 降低 54.4%,平均 TPOT 降低 60.6%。
引言
多模态大语言模型(MLLM)目前是视觉理解任务的主流方法,但处理高分辨率图像和长视频序列会生成非常长的视觉 token 序列,从而增加计算和内存成本。先前关于视觉下采样的工作牺牲了细粒度细节,而视觉 token 剪枝和合并方法通常存在训练与推理不匹配、丢失任务特定信息、在信息密集或 grounding 任务上性能下降,并且难以与 SGLang、vLLM 等现代服务引擎集成。现有内容自适应方法如 ViCO 使用 tile 级分辨率分配,这对于细节丰富区域和低信息区域交错出现的情况过于粗糙,并且与 Qwen、Kimi 等原生分辨率 MLLM 架构不匹配。作者提出了 VisionWeave,该方法使 MLLM 能够原生使用弹性视觉表示,通过门控空间池化器和粒度路由器自适应地编织细粒度 token 与学习到的粗粒度 token。VisionWeave 在 Qwen3.5-4B 上通过自蒸馏训练,并扩展到 Qwen3.8-27B,实现了内容自适应的 token 节省,同时保持接近原生的性能,并将这些节省转化为 SGLang 中约 2 倍的服务吞吐量。
方法
作者通过两个互补组件实现弹性视觉表示编织:门控空间池化器和粒度路由器,二者共同在多模态大语言模型中实现原生弹性视觉处理。
门控空间池化器构建学习到的粗粒度表示,作为对原生细粒度 token 的补充。它将 Vision Transformer(ViT)patch 特征的每个 2×2 邻域映射为单个池化特征。对于每个邻域,四个 patch 特征通过可学习的层归一化进行归一化,并聚合为共享全局上下文。随后,门控机制从 patch 特征及其上下文计算逐通道分数,接着由价值网络细化每个特征。最终池化输出是这些细化特征的门控和。该设计提供了有利起点,因为将最后几层零初始化会使池化器退化为对归一化 patch 特征进行平均池化。
为了确定每个空间块的粒度,粒度路由器在多个深度探测中间 ViT 特征。它为每个空间块使用一个可学习查询状态,该状态从共享可学习向量初始化。每个查询按顺序探测 ViT 的特定深度,首先利用局部交叉注意力块关注该空间块自身的 patch 特征,随后利用全局交叉注意力块融合来自整个帧的信息。两种注意力机制均使用残差连接和层归一化。最后,线性头将归一化查询状态映射为 logits,得到使用粗粒度表示的概率。在推理期间,如果该概率超过阈值,则使用粗粒度 token;否则保留原生细粒度 token。
作者通过三阶段自蒸馏过程发展这种弹性视觉编织能力。在第一阶段,即粗粒度自蒸馏阶段,路由被旁路,池化器在所有块上使用粗粒度表示进行训练。模型的原生前向传播作为教师,通过 Kullback-Leibler 散度目标提供输出分布监督。
在第二阶段,即软混合自蒸馏阶段,粒度路由器使用可微分的软混合替代方案进行训练,以替代硬路由。作者分别对特征方向和幅度进行插值,以防止范数差异对混合产生偏差。加入逐样本平衡损失以鼓励目标粗路由比例,防止较大输入主导估计。
第三阶段在推理时使用的硬路由混合粒度序列上执行混合粒度自蒸馏。路由器头包含一个离线校准的标量粗路由偏置,学生模型按照与推理时相同的选择方式和位置嵌入坐标收集视觉 token。
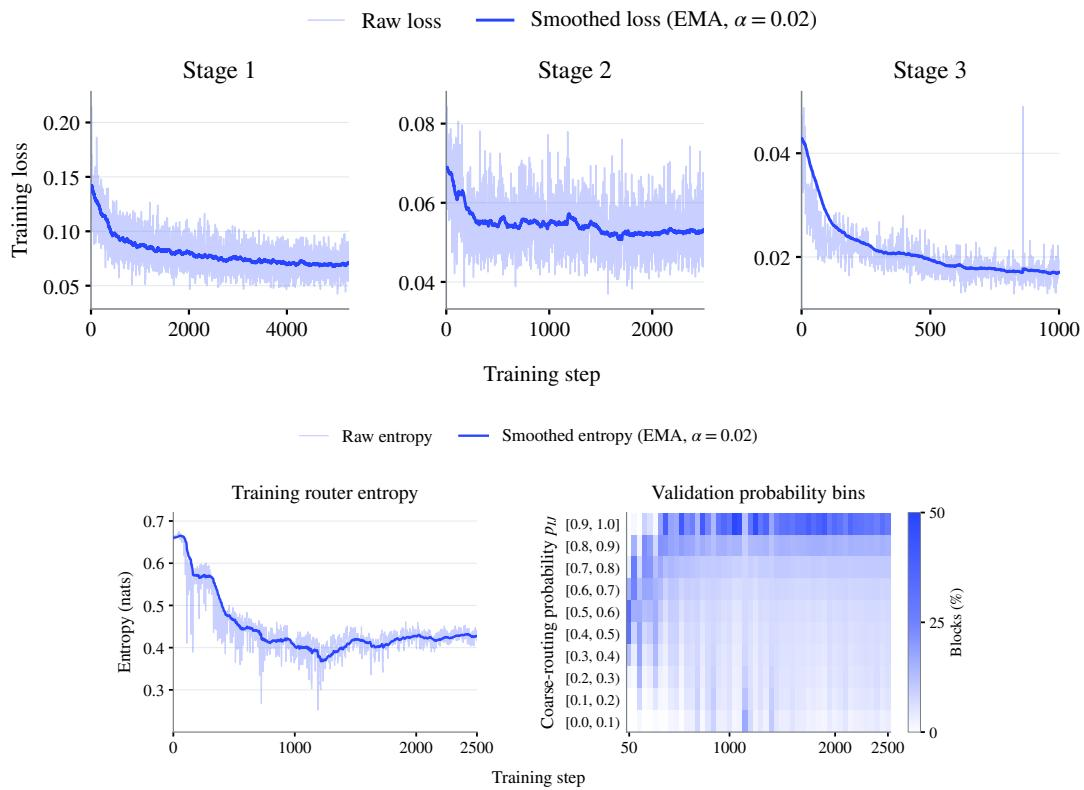
这三阶段过程的训练动态揭示了粒度决策随时间的发展方式。如下图所示,训练损失在三个阶段中稳步下降。在软混合阶段,路由器平均熵显著下降,表明分配决策越来越明确。此外,验证概率分布显示出明显偏移,具有高粗路由概率的块比例达到可观水平,证明模型能够有效学习内容自适应粒度分配。
实验
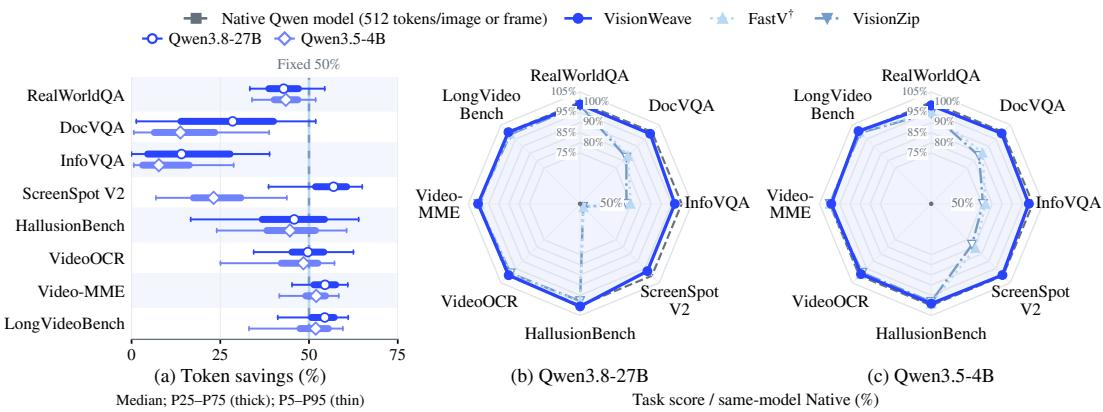
评估在八个基准上验证了 VisionWeave,覆盖自然图像、文档、GUI grounding、幻觉和视频理解,并与启发式 token 合并和剪枝基线进行比较,同时使用 SGLang 进行服务测试。VisionWeave 通过内容自适应 token 节省保持接近原生的质量,并在不同空间分辨率和视频帧预算下表现出稳定的效率与质量权衡,而固定节省基线在 grounding 和信息密集任务上会急剧退化。服务实验表明端到端吞吐量更高、延迟更低,推理时阈值调整允许在无需重新训练的情况下进行质量与成本控制。消融实验确认门控空间池化器和学习到的粒度分配起重要作用,视觉分析显示该方法保持空间覆盖,而非丢弃任务关键 token。
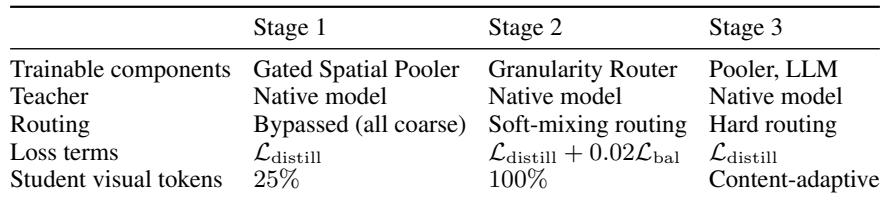
弹性视觉处理分三阶段训练:首先在旁路所有路由的情况下训练门控空间池化器学习粗粒度表示,然后使用软混合和平衡损失训练粒度路由器,最后使用硬内容自适应路由训练池化器和 LLM。该课程使学生视觉 token 从固定的 25% 经过全量 token 转变到内容自适应分配。消融实验显示,在高 token 节省下,学习到的池化器优于 pixel-unshuffle 投影器,打乱路由分数会降低性能,表明内容相关粒度分配很重要。三阶段过程从仅粗粒度池化发展到软混合路由,最后到具有可训练池化器、路由器和 LLM 组件的硬内容自适应路由。消融实验显示门控空间池化器在高 token 节省下优于 pixel-unshuffle 投影器,打乱学习到的路由分数会降低性能,表明内容相关分配很重要。
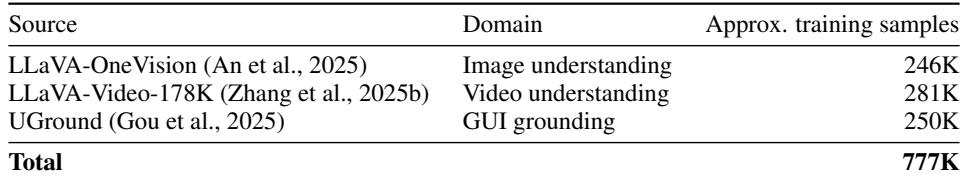
Qwen3.8-27B 的训练混合包含约 0.78 百万个样本,涵盖图像理解、视频理解和 GUI grounding。三个领域的贡献几乎均衡,视频理解是最大来源,图像理解是最小来源。三个训练阶段在序列打包前均使用相同混合。图像理解、视频理解和 GUI grounding 各约占总训练样本的三分之一。视频理解贡献最大份额,图像理解贡献最小份额。三个训练阶段共享相同的数据组成。
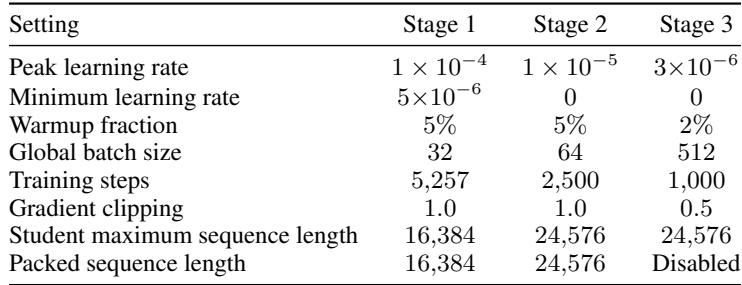
Qwen3.8-27B 训练经历三个阶段,峰值学习率逐步降低,第一阶段后最小学习率为零,全局批量大小更大。第一阶段使用最多训练步数和较短的学生最大序列长度,后续阶段使用更长序列和更少步数。后续阶段使用更低峰值学习率和零最小学习率,表明优化更保守。全局批量大小跨阶段增加而训练步数减少,从多次小批量更新转变为更少次大批量更新。
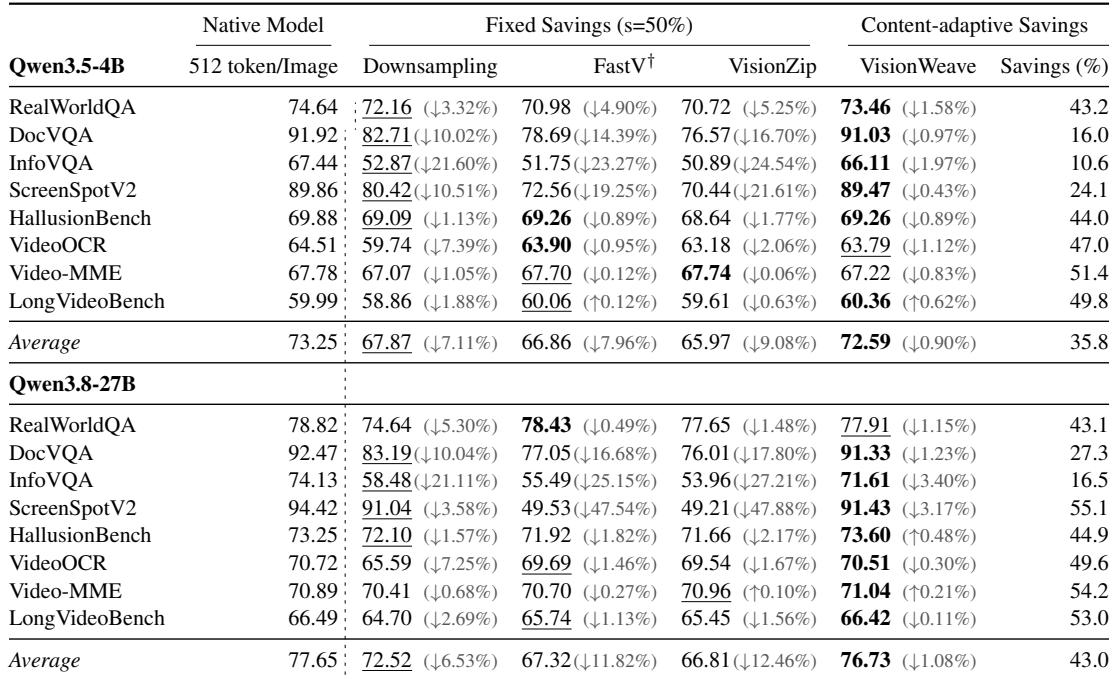
VisionWeave 提供内容自适应 token 节省,同时保持质量接近原生模型。文档和 grounding 任务获得更保守的节省,准确率仅小幅下降,而视频任务允许更高节省且损失最小。固定节省基线即使数据集级节省相当,在信息密集和 grounding 基准上也退化更明显。VisionWeave 在两种模型规模的各个基准上将平均性能损失限制在约百分之一。token 节省是内容自适应的,在视频基准上降低更多,在文档和 grounding 任务上降低更保守。FastV 和 VisionZip 在 ScreenSpotV2 和 DocVQA 上出现急剧下降,而 VisionWeave 通过根据输入需求调整 token 分配来保持质量。
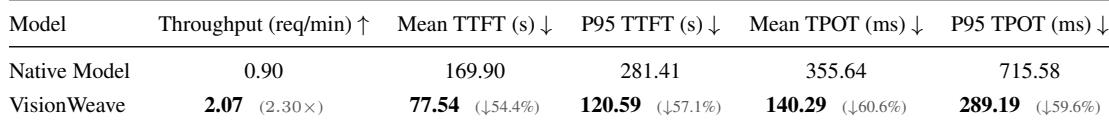
在长视频服务负载下,VisionWeave 相对于原生模型吞吐量提升超过一倍,同时降低平均和尾部指标延迟。每 token 生成时间的改善尤其显著,尾部延迟也大幅下降,表明服务容量更高、响应性更好。在相同的双 GPU 服务设置下,VisionWeave 相对原生模型实现 2.30 倍端到端吞吐量加速。P95 首 token 时间降低 57.1%,P95 每输出 token 时间降低 59.6%。平均 TTFT 和平均 TPOT 也下降超过一半,其中平均 TPOT 改善 60.6%。
实验评估了 VisionWeave 的三阶段训练流程,该流程从粗粒度池化到软混合路由,再到硬内容自适应路由;消融实验显示,学习到的内容相关 token 分配优于固定投影器和打乱路由的基线。实验还记录了涵盖图像、视频和 GUI grounding 的均衡多模态训练混合,以及后期阶段更低学习率和更大批量的渐进式优化计划。基准结果表明,内容自适应 token 节省在文档、grounding 和视频任务上保持质量,而固定节省基线在信息密集输入上退化更明显。服务评估也显示长视频工作负载的吞吐量和延迟有显著改善。