Command Palette
Search for a command to run...
TRACE:用于 MoE 语言模型 FP4 强化学习的 Rollout 引导量化感知训练
TRACE:用于 MoE 语言模型 FP4 强化学习的 Rollout 引导量化感知训练
摘要
对大型语言模型(LLM)进行后训练阶段的强化学习(RL)在 rollout 生成过程中会带来大量计算和内存开销,这促使采用低精度 rollout 以实现高效 RL 训练。然而,现有 FP4 RL 方法存在一个关键局限:它们主要分别优化训练路径和 rollout 路径上的量化精度,而不是直接减小两条量化执行路径之间的差异。本文提出 TRACE(Train-Rollout Quantization Alignment via Compact GuidancE),一个用于混合专家(MoE)语言模型 RL 训练的 FP4 量化框架,以解决现有 FP4 RL 方法的上述局限。TRACE 采用 rollout 引导的量化感知训练,利用 rollout 侧的量化结果来指导训练侧的 FP4 舍入决策,从而直接减小训练与 rollout 之间的差异。此外,TRACE 采用一种高效的量化信息缓存方案,选择性保留来自更深层的尾数和缩放信息,以减少 rollout 引导带来的存储和通信开销。我们在四个大规模 MoE 语言模型上评估 TRACE,涵盖推理、代码生成和长时程 RL 任务。实验结果表明,TRACE 能够支持 FP4 权重/激活与 FP4 KV-cache 的联合 rollout,其 RL 性能与 BF16 rollout 相当,同时 rollout 速度最高提升 5.4 倍;与对 BF16 训练策略进行事后 FP4 量化相比,TRACE 还取得了较强的最终 FP4 性能。
一句话总结
来自 Alibaba Token Hub、阿里巴巴集团和俄亥俄州立大学的研究者提出 TRACE,一种用于 Mixture-of-Experts 语言模型强化学习训练的 FP4 量化框架,该框架使用 rollout 引导的量化感知训练来对齐训练与 rollout 的舍入决策,并有选择地缓存更深层的尾数和缩放信息,从而实现 FP4 权重/激活和 FP4 KV-cache 联合 rollout,最高可获得 5.4× 加速,并达到与 BF16 相当的 RL 性能。
核心贡献
- TRACE 是一种用于 Mixture-of-Experts 语言模型强化学习训练的 FP4 量化框架,它利用 rollout 侧的量化结果来指导训练侧的 FP4 舍入决策,直接减少训练与 rollout 之间的差异,而不是独立地优化每条路径上的量化精度。
- TRACE 采用一种量化信息缓存方案,该方案有选择地保留来自更深层的尾数和缩放信息,以减少 rollout 引导带来的存储与通信开销。
- 在四个大规模 MoE 语言模型(Qwen3.5-35B-A3B、Qwen3.5-122B-A10B、Qwen3.8-Flash-Next、Qwen3.8-2.4T-A95B)上的推理、代码和长周期 RL 任务评估表明,TRACE 支持 FP4 权重/激活和 FP4 KV-cache 联合 rollout,性能与 BF16 rollout 相当,相对 BF16 rollout 获得最高 5.4× 的 rollout 加速,并且最终 FP4 性能优于对 BF16 训练策略做事后 FP4 量化的结果。
引言
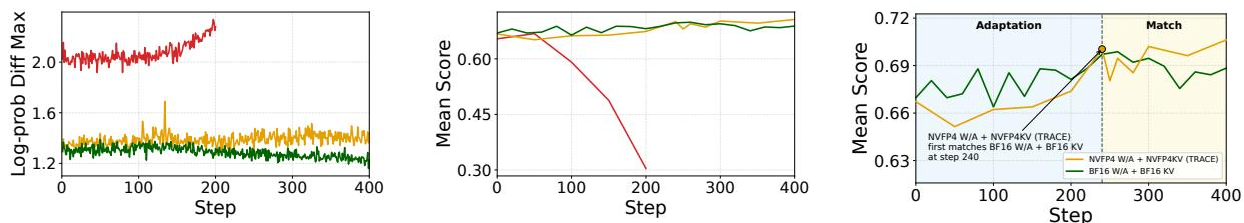
强化学习已成为提升大语言模型推理与代码能力的关键后训练方法,但 rollout 生成的算力开销很大。激进的 FP4 量化可以降低 rollout 成本,但其较粗的数值空间会造成训练与 rollout 策略不匹配,这对 Mixture-of-Experts 模型尤其成问题,因为微小差异可能改变专家路由并破坏训练稳定性。现有 FP4 RL 方法主要独立地提升每条路径的量化精度,但并未直接减少量化后训练路径与 rollout 路径之间的差异。作者提出 TRACE,一种用于 MoE 强化学习训练的 FP4 量化框架,它利用 rollout 侧的量化结果来指导训练侧 FP4 舍入,并且仅缓存选定的更深层尾数和缩放信息,以限制存储和通信开销。
方法
作者提出 TRACE,一种 FP4 量化框架,用于 Mixture-of-Experts (MoE) 语言模型的高效强化学习 (RL) 训练。TRACE 的核心目标是直接对齐 rollout 生成阶段和后续训练阶段所使用的量化计算路径。
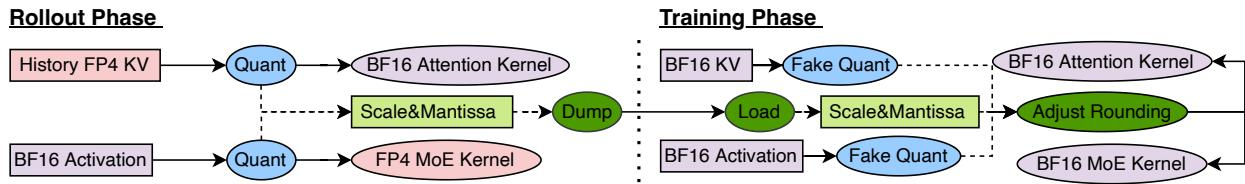
在高层次上,该框架分为两个阶段。在 rollout 生成阶段,TRACE 记录 FP4 路由专家激活和 FP4 Key-Value (KV) 状态的量化结果。在随后的量化感知训练 (QAT) 阶段,这些记录的 rollout 侧信息被用于指导相应的训练侧舍入决策。为降低传输这些引导信息带来的大量开销,TRACE 采用一种高效的量化信息缓存方案,仅保留选定更深层中的尾数和缩放信息。
Rollout 引导的量化感知训练
低精度 rollout 会在训练路径与 rollout 执行路径之间引入数值差异。简单地将标准 FP4 QAT(在前向传播中应用伪量化,而反向传播仍为 BF16)与 FP4 rollout 生成相结合,可能导致显著的策略分化。作者将成对激活的局部训练-rollout 差异刻画为:
Dact=QFP4train(Xtrain)−QFP4rollout(Xrollout)F现有方法通常试图通过相对高精度表示独立提升每条路径的量化精度来间接缓解这种差异。然而,最小化单路径量化误差并不一定能够最小化跨路径差异。
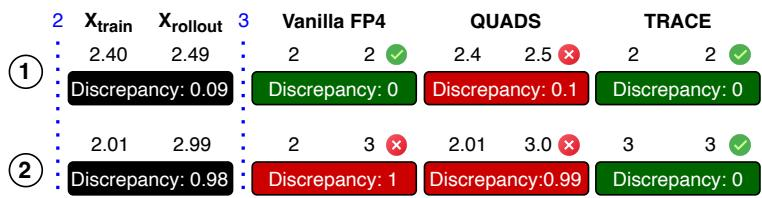
如上述示例所示,QUADS 等方法能够降低单路径量化误差,但实际上可能增大训练与 rollout 之间的差异。例如,在第一个示例中,QUADS 重构 rollout 激活以降低自身误差,但这将训练值与 rollout 值之间的差异从 0 增大到 0.1。
该差异的主要来源是,BF16 训练激活与 rollout 激活之间的微小差异,在舍入到不同 FP4 码字时会被显著放大。
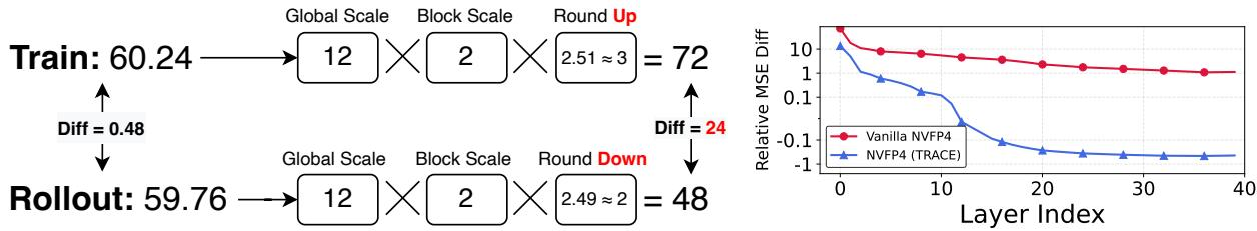
左图展示了 BF16 中原始 0.48 的差异(60.24 与 59.76)如何在 FP4 量化后被放大到 24(72 与 48),原因是归一化值落在舍入边界的相反两侧。右图进一步量化了这一现象,表明与所提方法相比,vanilla NVFP4 在各模型层上引入了显著的额外差异。
为解决该问题,TRACE 使用 rollout 侧的量化结果来指导训练侧舍入。对于捕获的训练侧激活,令 {q−,q+} 表示在 rollout 侧缩放下的两个相邻归一化 FP4 码字,并令 qrollout 表示对应 rollout 侧激活产生的确切 FP4 码字。TRACE 不采用标准就近舍入 (RTN),而是选择:
qTRACE=argq∈{q−,q+}min∣q−qrollout∣通过这种构造,可保证 ∣qTRACE−qrollout∣≤∣qRTN−qrollout∣,从而在不增大局部量化差异的情况下,有效减少由不一致 FP4 舍入导致的不必要放大。
仅尾数的训练-Rollout 通信
虽然 rollout 引导的 QAT 能有效减少差异,但保留完整的 rollout 侧量化信息会带来巨大的数据搬运开销。
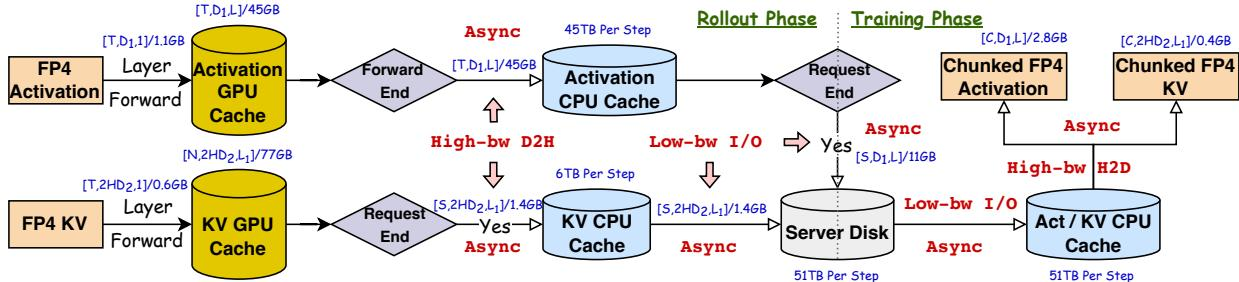
该图展示了数据通信流水线。激活侧和 KV 侧的量化记录遵循不同的收集路径:激活引导信息被写入临时 GPU 缓冲区并异步卸载,而 KV 状态从持久缓存中收集。对于 Qwen3.5-35B-A3B 这样的模型,一个具有 4,096 条轨迹的 RL step 可能生成高达 51 TB 的 rollout 侧量化信息。传输和存储如此规模的数据会造成严重瓶颈,远超典型 RL step 的挂钟时间。
为解决这一问题,TRACE 仅传输确定所需训练侧舍入方向所必需的 rollout 侧量化信息。
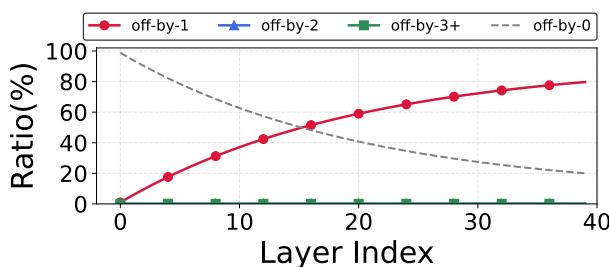
作者观察到,在各层不匹配的量化值中,超过 99% 的训练结果与 rollout 结果仅相差一个相邻的 FP4 码本条目(off-by-1)。由于这些量化值绝大多数在 FP4 码本中相邻,训练侧激活结合 rollout 缩放能够强有力地约束候选码字。因此,没有必要传输完整的量化值。
TRACE 进一步观察到,朝向较低 FP4 码字的舍入校正主要发生在较深层。基于此,该框架仅传输模型后一半层的尾数和缩放信息。在 rollout 生成期间,这些紧凑信息被缓存并传输到训练引擎,以重建紧凑的 rollout 侧参考,从而大幅降低存储和通信开销,同时保持对齐效果。
实验
实验评估了 TRACE,一种在 MoE 语言模型 RL rollout 期间联合应用 FP4 权重和 KV-cache 量化的 rollout 引导量化方法,并将其与 QAT、QaRL、QUADS、score centering、MXFP4 以及训练后量化基线在多个 Qwen 模型的推理、代码和长周期任务上进行比较。TRACE 始终达到 BF16 rollout 性能,并通过减少训练与 rollout 差异优于基线,从而稳定 RL 训练,并使策略适应低精度执行。效率和消融研究表明,这一收益伴随有限的吞吐量和训练开销,可扩展到 microscaling FP4 格式,并且只需要来自更深层的紧凑量化元数据;进一步比较证实 TRACE 比 score centering 和事后 FP4 量化更有效。
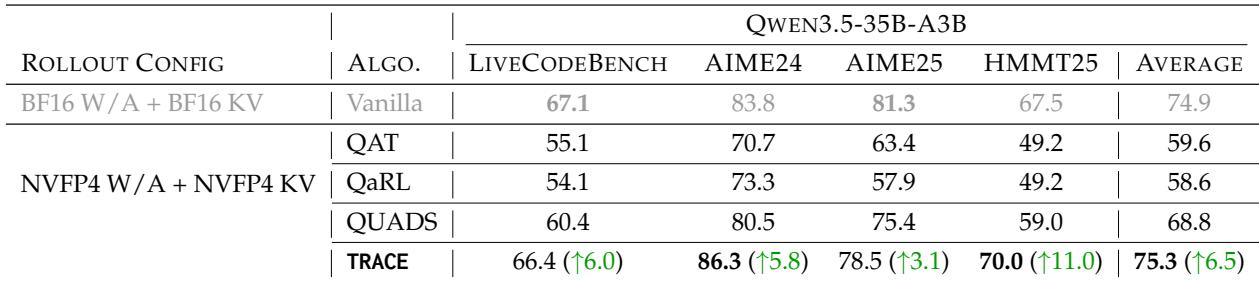
在 Qwen3.5-35B-A3B 上采用 NVFP4 权重、激活和 KV cache 联合 rollout 时,TRACE 在所有四个推理基准上均优于 QAT、QaRL 和 QUADS。它将平均分数提升到最佳 FP4 基线之上,并达到 BF16 rollout 性能,其中在 HMMT25 上提升尤其大。结果表明,TRACE 恢复了 FP4 量化造成的大部分性能损失。TRACE 是唯一在这些推理任务上达到 BF16 rollout 平均水平的 FP4 方法。相对最强基线的最大提升出现在 HMMT25 上,TRACE 约提高了 11 分。与 QAT、QaRL 和 QUADS 相比,TRACE 在所有评估基准上取得了最高的平均性能。
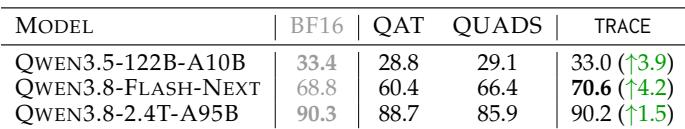
在三个更大规模的 MoE 模型上,在相同 FP4 rollout 配置下,TRACE 始终优于 QAT 和 QUADS。它在代码和长周期基准上达到 BF16 水平性能,代码任务提升最大,长周期模型上也有较小的正向提升。TRACE 在三个模型上消除了与 BF16 的大部分差距,并在 Qwen3.8-Flash-Next 上略高于 BF16。在面向代码的模型上,TRACE 相对最强 FP4 基线提高约 4 分,而长周期任务提升较小。QUADS 在长周期模型上表现不如 QAT,而 TRACE 仍超过这两个低精度基线。
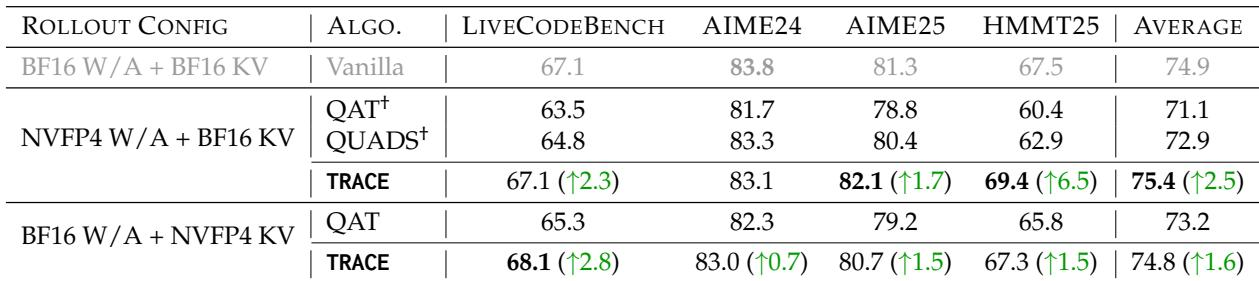
仅对权重做 NVFP4 量化并保留 BF16 KV cache,会降低 QAT 和 QUADS 基线在推理基准上的平均性能,而 TRACE 恢复了这一损失并略高于 BF16 基线。仅对 KV cache 做 NVFP4 量化并保留 BF16 权重,也会降低 QAT 基线,但 TRACE 几乎消除了与全 BF16 rollout 的差距。最大恢复发生在仅权重量化的 HMMT25 上。在 NVFP4 权重加 BF16 KV 的条件下,TRACE 的平均性能高于所列最强基线并超过 BF16 vanilla rollout。在 BF16 权重加 NVFP4 KV 的条件下,TRACE 在所有四个基准上均优于 QAT,并接近 BF16 vanilla 平均水平。TRACE 在仅权重消融中的最大单基准提升出现在 HMMT25 上,显著优于 QAT 和 QUADS。
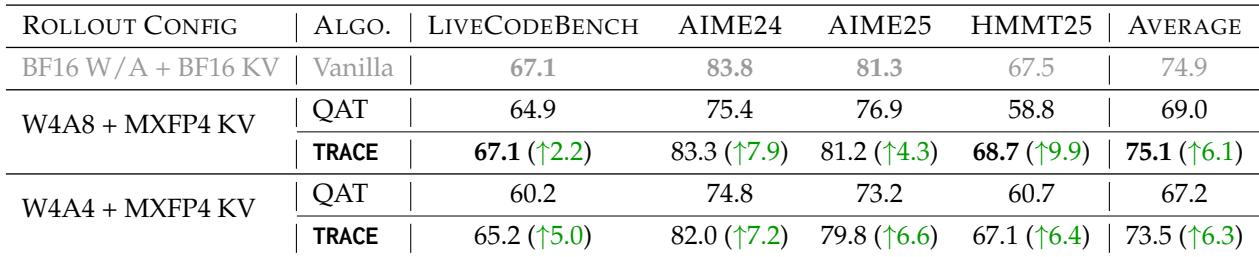
在推理 RL 任务上的 MXFP4 rollout 配置中,TRACE 始终优于 QAT。在 W4A8 MXFP4 且 FP4 KV cache 条件下,TRACE 几乎达到 BF16 rollout 基线;在更激进的 W4A4 MXFP4 设置下,它仍恢复了大部分性能差距。提升出现在所有评估基准上。在 W4A8 MXFP4 且 FP4 KV cache 条件下,TRACE 将平均分数从 69.0 提高到 75.1,接近 74.9 的 BF16 基线。W4A4 MXFP4 配置对 QAT 更难,但 TRACE 仍将平均分数从 67.2 提高到 73.5。TRACE 在 W4A8 MXFP4 设置下的 HMMT25 和 AIME24 上表现出最大的相对 QAT 提升。
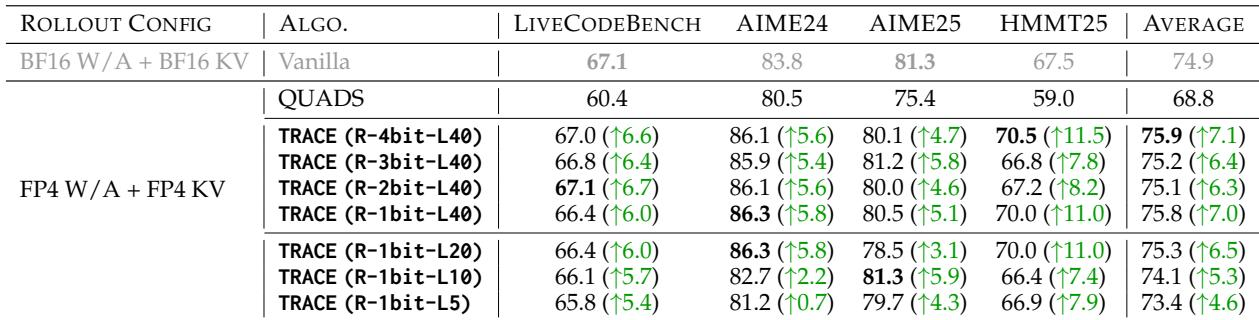
在 Qwen3.5-35B-A3B 上的推理 RL 任务模块化敏感性研究表明,在 FP4 权重/激活和 FP4 KV cache 联合量化下,TRACE 始终恢复大部分 BF16 rollout 性能,而 QUADS 基线大幅下降。在所有 40 层上保留单个尾数位的量化信息可获得最强的平均水平之一,接近最佳多位变体;将信息限制在后 20 层只会导致小幅下降。进一步将层覆盖范围减少到 10 或 5 层,会导致平均推理性能出现更明显但温和的下降。所有 TRACE FP4 配置均比 QUADS FP4 基线平均提高约六到七分,并接近 BF16 rollout 平均水平。在所有 40 层上保留紧凑的单个尾数位,其表现几乎与更强的多位变体一样好;仅使用后 20 层则导致微弱下降。将保留的 rollout 量化信息减少到最后 10 或 5 层会进一步降低平均性能,但仍远高于 FP4 QUADS 基线。
这些实验在联合 FP4 权重、激活和 KV cache 量化、单独权重和 KV cache 消融、MXFP4 rollout 设置以及对保留量化信息的敏感性等方面评估了 TRACE,覆盖推理和代码基准。TRACE 始终恢复大部分因低精度 rollout 而损失的性能,经常达到或略超过 BF16 基线,并在不同模型规模上优于 QAT、QaRL 和 QUADS。在 HMMT25 等具有挑战性的推理任务以及面向代码的模型上提升尤其大,并且跨所有层或后部分层保留量化信息在很大程度上保留了这一优势。