Command Palette
Search for a command to run...
H-JEPA:用于视觉规划的分层世界模型的端到端学习
H-JEPA:用于视觉规划的分层世界模型的端到端学习
Wancong Zhang Basile Terver Michael Rabbat Yann LeCun Randall Balestriero
摘要
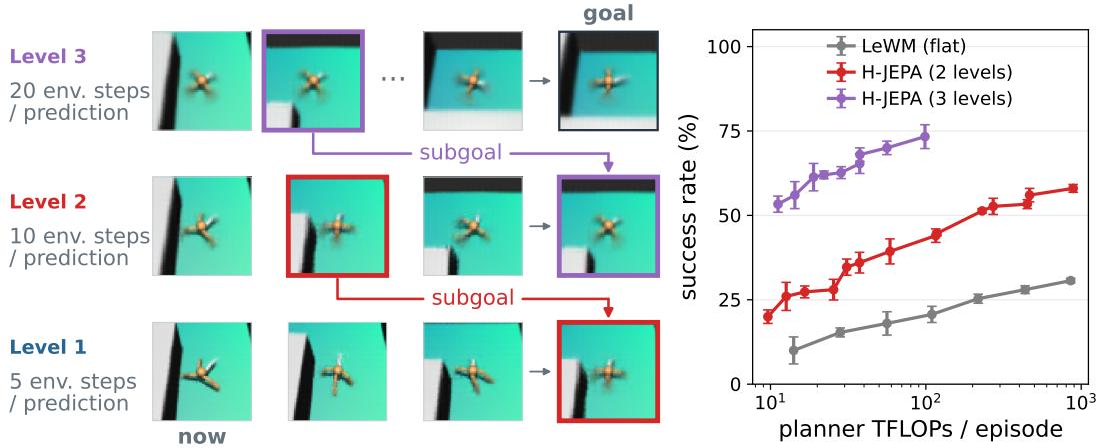
使用潜在世界模型进行长时程规划需要跨时间尺度和抽象层级进行推理。现有的任务无关 JEPA 世界模型在单一潜在空间中预测和规划,通常处于单一时间尺度。我们提出 H-JEPA,一种训练层次化动作条件 JEPA 的端到端方法,其中每一层在其自身学习的潜在空间中预测更远的未来。规划自顶向下进行:顶层优化朝向目标的进展,每一层的预测成为其下方规划器的子目标。当数据中的因素以分离的时间尺度演化时,较高层会舍弃快速、不可预测的细节,而保留较慢的任务相关状态。在四个模拟导航和操作环境中,分层规划优于扁平 JEPA;在 Visual AntMaze 中,三层层次结构将成功率从 18% 提升至 73%,且使用更少的规划计算。消融实验将这些增益归因于时间分解和更高层的目标表示。结合逆动力学监督,该方法扩展到来自 DROID 的多样化真实机器人视频,其中层次结构在较低规划计算下提高了离线规划的保真度。
一句话总结
H-JEPA由纽约大学、Advanced Machine Intelligence、INRIA Paris和布朗大学的研究人员开发,提出了一种端到端的训练方法,用于训练层级化的动作条件JEPA世界模型,其中每一层在其自身的潜在空间中进行更远距离的预测,从而实现带子目标的自顶向下规划;在Visual AntMaze上,三层层级结构将成功率从18%提升至73%,同时减少了规划器计算量,并且通过逆动力学监督,该方法可扩展到真实机器人DROID视频。
核心贡献
- 提出了H-JEPA,一种用于层级化动作条件JEPA世界模型的端到端训练方法,其中每一层在其自身潜在空间中以逐步增长的时间步长和更高的抽象层次进行预测,且不依赖奖励或重建目标。
- 证明了层级化规划在四个模拟导航和操作环境中优于平面JEPA基线;在Visual AntMaze上,三层层级结构将成功率从18%提升至73%,且使用更少的规划器计算量。
- 识别了这些增益背后的两种互补机制:将任务按时间分解为更短的子目标,以及更高层的目标表示在更抽象的空间中评估进展;添加逆动力学项可将该方法扩展到来自DROID的多样化真实机器人视频,在更低的规划器计算量下提升离线规划保真度。
引言
世界模型使agent能够从经验中学习环境动态,从而进行预测和规划,近期的联合嵌入预测架构(JEPA)通过预测未来潜在状态而非像素或奖励来实现这一点。然而,这些模型通常在单一潜在空间和单一时间尺度上运行,这带来了两个问题:长时域预测需要大量细粒度的展开步骤,导致误差累积并扩大动作搜索空间;同时,共享的潜在空间必须同时捕捉低层动态并支持抽象目标匹配,当目标是概念性的(如到达某个位置)而非状态特定时,后者往往难以实现。先前的层级化方法要么在无规划的情况下重建像素,要么依赖奖励驱动的任务特定策略;最接近的任务无关模型HWM在多个时域上进行规划,但仍使用单一潜在空间,因此无法在更高抽象层次上匹配目标。
作者提出了H-JEPA,一种层级化JEPA架构,其中每一层在其自身潜在空间中预测未来状态,使用逐步变粗的时间步长和更抽象的表征,且不依赖奖励或重建目标。其主要贡献包括:一种用于层级化JEPA模型的端到端训练方法,证明了更高层会丢弃不可预测的快速细节而保留较慢的可预测状态,以及层级化规划在更低计算量下优于单层规划的证据,因为它能够在更抽象的空间中进行目标评分并将长时域任务分解为更简单的子问题。作者还展示了添加逆动力学项可将该方法扩展到来自DROID的真实机器人操作数据,其中场景、光照和物体在不同片段间发生变化,尽管存在这种变异性,仍能提升离线规划保真度。
数据集
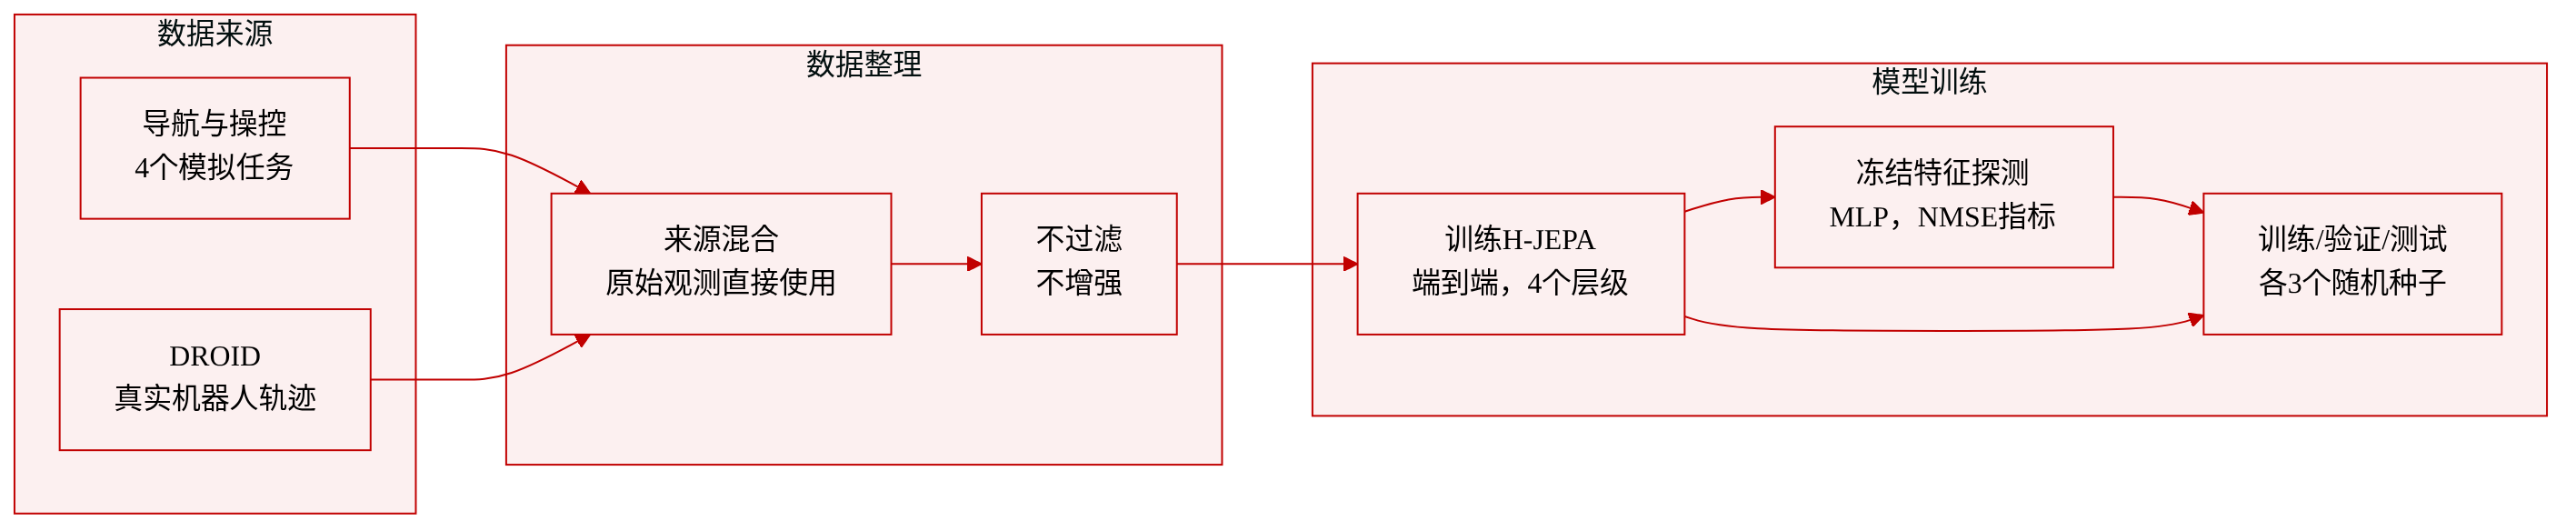
作者在多个涵盖导航和操作任务的环境中评估其层级化模型H-JEPA。数据集组成及使用方式如下:
-
环境与来源
- 导航:FourRoomDistractors,将一个受控agent与一个平滑移动但随机瞬移的干扰物配对;Visual AntMaze,一个四足机器人在迷宫中导航。
- 操作:Push-T(推动T形块)和OGBench Cube(拾取并放置立方体)。
- 真实世界扩展:DROID,一个真实机器人操作轨迹数据集,用于额外评估(§4.3)。
-
训练设置与数据处理
- 模型以端到端方式训练,最多包含四个层级。
- 第1层JEPA使用ViT-Tiny编码器,带有[CLS]token以全局汇总每张图像,外加一个因果transformer预测器。该单层模型作为平面基线。
- 更高层JEPA使用两层MLP编码器和因果transformer预测器。
- 在每一更高层,步长sℓ=2和窗口wℓ=1意味着该层的一个预测步骤跨越的环境时间步数是下一层的两倍。
- 同一环境中的所有层级共享相同的SIGReg系数。
- 未提及显式的数据增强或过滤;数据集按原样使用。
-
评估协议(探针中的数据使用)
- 作者在每个层的冻结表征上训练两层MLP探针。
- 报告方差归一化MSE(NMSE),对实体的各维度取平均。NMSE接近1表示预测边际均值,接近0表示准确恢复。
- 结果为三个训练种子下的均值±标准误。
- 像素解码为事后解码器的定性示例。
-
数据集统计与观察模式
- 更高层丢弃快速变化特征而保留慢速特征。例如,在AntMaze中,身体状态(关节)随深度增加而可恢复性降低,而全局位置保持准确。在FourRoom中,干扰物位置的可恢复性降低,因为更长的预测时域常常跨越随机瞬移。
- 论文将第2层的逐实体探针误差与训练数据中的“实体频率差距”联系起来:即最快和最慢变化状态分量的频谱质心之比。
- 更大的频率差距与第2层快速实体信息损失更大相关,而慢速实体的可恢复性保持接近第1层的水平。
- 这种选择性抽象出现在AntMaze、Humanoid和FourRoom中,但不出现在操作数据集(Push-T、OGBench Cube)中,后者的频率差距较小。
- 差距测量详见§F.2。
-
额外处理说明
- 论文未描述这些数据集的裁剪策略或手动元数据构建;输入为原始观测(导航/操作用的图像,以及DROID的轨迹数据)。
- 模型的层级化抽象源于编码器和预测器的联合优化,其中预测误差梯度鼓励每层仅保留在其自身时间尺度上可预测的特征。
方法
H-JEPA从观测和动作的轨迹中学习层级化的潜在预测模型。该层级在时间上是分层的:第1层在最细粒度的观测流上运行,而每一更高层以更粗的步长消费下一层产生的潜在状态。由此形成一个JEPA世界模型堆栈,其中每一层都有自己的观测编码器、动作编码器和潜在预测器。所有层都从过去的潜在状态和动作预测未来的潜在状态。
设ot表示观测,at表示从ot到ot+1转移的动作块。第一层将观测(可选地连同本体感觉状态)编码为潜在状态zt(1)=E(1)(ot),并将动作块编码为at(1)=A(1)(at)。更高层以组合方式构建:状态和动作编码器都对下一层的潜在状态进行时间窗口池化。
每一层ℓ>1有两个时间超参数。步长sℓ是子采样因子:上层时间t映射到下层时间t⋅sℓ,因此相邻上层状态相隔sℓ个下层步骤。窗口大小wℓ是每个上层状态汇总的下层步骤数。两者相互独立:sℓ决定每个窗口推进多远,wℓ决定其跨度多大。
以a:b表示索引a,…,b−1(共b−a个),第ℓ层的状态和动作嵌入为:
zt(ℓ)=E(ℓ)(zt⋅sℓ:t⋅sℓ+wℓ(ℓ−1)),at(ℓ)=A(ℓ)(at⋅sℓ+wℓ−1:(t+1)⋅sℓ+wℓ−1(ℓ−1)).状态编码器E(ℓ)将wℓ步的下层窗口池化为一个抽象状态。动作编码器A(ℓ)则聚合sℓ个下层动作嵌入,与wℓ无关,因此at(ℓ)覆盖从锚定zt(ℓ)的状态到下一个上层状态zt+1(ℓ)的完整转移。所有实验使用wℓ=1,因此上层状态编码器是逐点式的。
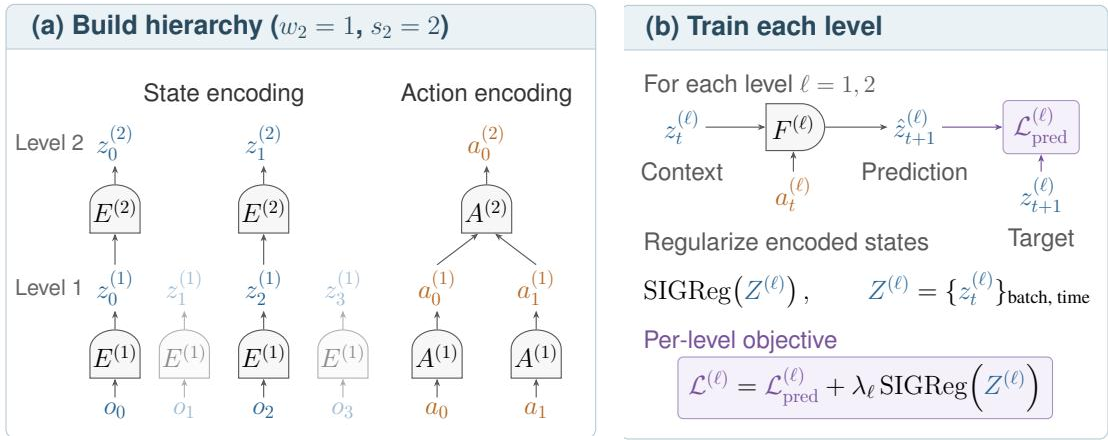
每一层在其自身潜在空间中作为JEPA训练。给定cℓ个潜在状态的上下文(zt−cℓ+1(ℓ),…,zt(ℓ))及相应的动作嵌入,预测器F(ℓ)预测未来潜在状态。单步训练使用教师强制的潜在预测损失:
Lpred(ℓ)=cℓ1τ=1∑cℓF(ℓ)(z<τ(ℓ),a<τ(ℓ))−zτ+1(ℓ)22.每层损失还包括SIGReg,一种草图化正态性正则化器,通过鼓励各向同性高斯嵌入分布来防止坍缩。设Z(ℓ)∈Rn×D收集n个宽度为D的第ℓ层嵌入,在批和时间上展平。第ℓ层的总体目标是:
L(ℓ)=Lpred(ℓ)+λℓSIGReg(Z(ℓ)).H-JEPA通过所学层级进行自顶向下规划。当前和目标的观测在每一层ℓ被编码,得到初始潜在状态{z0(ℓ)}ℓ=1L和目标潜在状态{g(ℓ)}ℓ=1L,其中L为层数。顶层提出到达目标的粗略计划。每一较低层向上一层预测轨迹提供的子目标进行规划,将计划细化为更细尺度的转移,直到第1层产生原始动作。顶层规划器优化宏动作以最小化其最终预测状态与目标之间的距离:
a0:HL−1(L),∗=arga0:HL−1(L)minz^HL(L)−g(L)22.在每一层ℓ,预测状态(z^1(ℓ),…,z^Hℓ(ℓ))=Roll(ℓ)(z0(ℓ),a0:Hℓ−1(ℓ))通过对候选动作序列从z0(ℓ)自回归应用预测器F(ℓ)获得,其中时域Hℓ以第ℓ层的步数衡量。上标*表示优化后的动作及其预测状态。
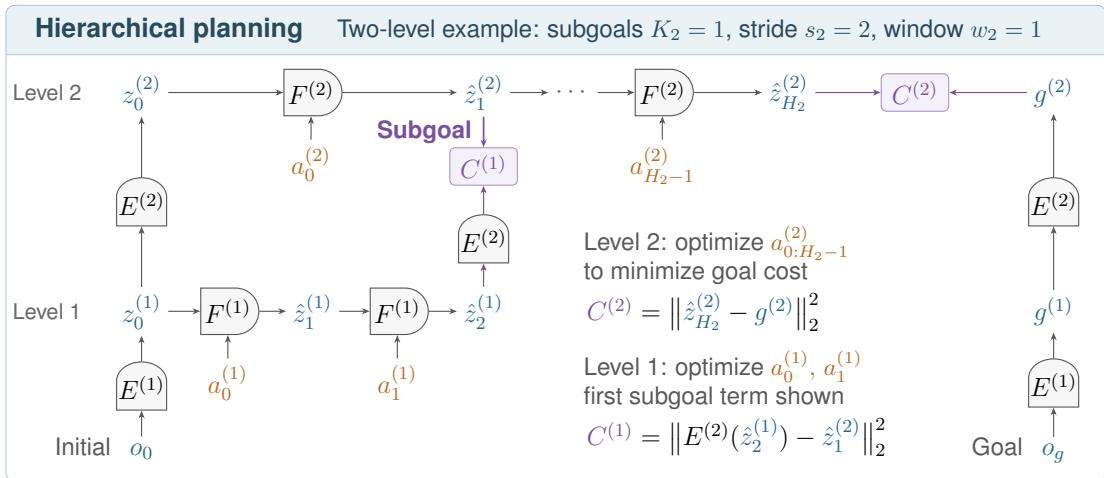
对于每一较低层ℓ<L,来自上一层的优化展开(z^1(ℓ+1),∗,…,z^Hℓ+1(ℓ+1),∗)提供子目标。较低层优化其动作,以将其自身预测状态与这些子目标匹配,预测状态由E(ℓ+1)编码到上层潜在空间。
论文首先选择要匹配的子目标数量1≤Kℓ+1≤Hℓ+1,然后设置较低层的时域以覆盖相应的编码器窗口。给定上层步长sℓ+1和窗口大小wℓ+1,需要Hℓ=Kℓ+1sℓ+1+wℓ+1−1。编码后的预测为:
z~i(ℓ+1)=E(ℓ+1)(z^isℓ+1:isℓ+1+wℓ+1(ℓ)),i=1,…,Kℓ+1.每个z~i(ℓ+1)在时间和潜在空间上与上层子目标对齐。较低层求解:
a0:Hℓ−1(ℓ),∗=arga0:Hℓ−1(ℓ)min[z~Kℓ+1(ℓ+1)−z^Kℓ+1(ℓ+1),∗22+βi=1∑Kℓ+1−1z~i(ℓ+1)−z^i(ℓ+1),∗22],其中β≥0为每个中间子目标相对于最终目标的权重。闭环规划使用Kℓ+1=1,仅匹配第一个预测子目标;开环规划使用Kℓ+1=Hℓ+1,其中β=0仅匹配最终预测,β>0同时匹配中间子目标。
论文通过梯度下降优化每一层的动作序列。第1层返回用于环境中执行的原始动作。在闭环控制中,论文执行一个动作前缀,编码新观测,并重复层级化规划,直到环境步数的评估预算耗尽。
实验
实验在导航和操作任务中评估了层级化JEPA(H-JEPA)模型,包括真实机器人DROID数据。学习层级化抽象表明,更高层会丢弃快速变化特征而保留慢速特征,但这种选择性抽象仅在实体频率差距较大时出现,而非在差距较小的操作数据集中出现。在规划方面,H-JEPA相较于平面基线和单一潜在空间的层级化模型改善了成功-计算量权衡,增益归因于更有信息量的抽象代价几何形状和将任务时间分解为更简单的子目标。在DROID的多样化场景中,添加逆动力学损失对于避免慢速特征坍缩是必要的,之后H-JEPA在更低的规划预算下优于平面和层级化基线。
在AntMaze上,将原生第1层规划代价替换为同一H-JEPA模型中更高层潜在空间计算的代价,在模型深度上持续提升平面规划成功率,最大的增益出现在原生空间规划最弱的场景。同时将搜索按时间分解的层级化规划,其成功率显著高于任何仅改变代价的变体,表明代价几何和时间抽象都对规划性能有贡献。对于每个测试的多层H-JEPA,至少有一个上层代价相对原生第1层代价提升了成功率。最优的投影第1层规划器在每个测试深度上都超过了独立的LeWM基线的平均成功率。仅改变代价的增益在原生第1层规划表现不佳时最大。同时改变代价和时间分解的层级化规划明显优于仅改变代价的变体。
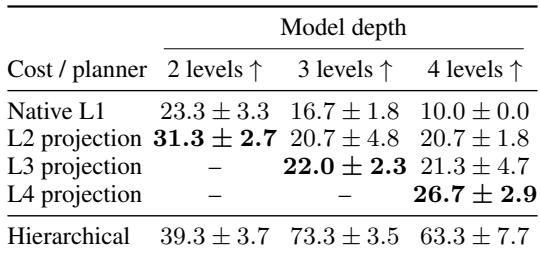
在AntMaze上,对不同规划配置的H-JEPA模型进行评估表明,使用更高层潜在代价而非原生第1层代价能持续提升平面规划成功率,最大的改进出现在原生规划困难的场景。额外按时间分解搜索的层级化规划优于所有仅改变代价的变体,确认了代价几何和时间抽象都很重要。对于每个测试的多层H-JEPA,至少有一个上层代价相对基线提升了成功率,且最优的投影第1层规划器在所有测试深度上都超过了独立的LeWM基线。总体而言,仅修改代价在原生规划最弱时产生最大增益,而完整的层级化规划产生最强结果。