Command Palette
Search for a command to run...
优化优化器:语言模型发现更快的分子弛豫
优化优化器:语言模型发现更快的分子弛豫
Artem Tsypin Vladimir Deshchenya Kuzma Khrabrov Denis Potapov Maxim Radchenko Artur Kadurin Michael G. Medvedev
摘要
几何优化是许多量子化学工作流中的主要成本:每个优化步骤需要一次力计算,而在密度泛函水平上,该计算主导了墙钟时间。该领域的研究已经产生了广泛的优化方法,我们要探究语言模型能否通过自动研究改进其中最好的方法。智能体重写优化器本身以最小化力调用次数,并受到两个准入门控的约束;这两个门控会拒绝过早停止以及无法泛化到未见分子的改进。从目前可用的最快开源优化器 Sella 出发,搜索生成了 AutoSella,一个由两个优化器组成的家族。两者在留出分子基准和搜索期间未使用的势能上,相对于 Sella 均一致地减少了力调用次数。最值得注意的是,在 r2SCAN-3c DFT 水平上,最佳变体仅需 Sella 40.2–77.2% 的力调用次数即可实现相同的能量降低,尽管该智能体未使用任何 DFT 梯度。
一句话总结
来自 AXXX、ITMO 大学和 N. D. Zelinsky 有机化学研究所的研究人员提出 AutoSella,这是一个由语言模型发现的家族,包含两种分子几何优化器,它改写 Sella 以在准入门控下最小化力调用次数,这些门控拒绝过早停止和无法泛化的改进;在 r2SCAN-3c DFT 级别,它仅需要 Sella 40.2% 至 77.2% 的力调用次数,同时达到相同的能量降低。
核心贡献
- 一个面向分子几何优化的自动研究循环,允许 agent 改写优化器以减少力调用次数,并带有准入门控,拒绝过早停止以及无法泛化到未见分子的改进。
- 从 Sella 出发,搜索产生 AutoSella-F 和 AutoSella-A;AutoSella-F 在留出分子基准和未见势能上实现一致的力调用减少,在 r2SCAN-3c DFT 级别仅使用 Sella 40.2% 到 77.2% 的力调用次数,同时达到相同的能量降低,且搜索过程中不使用 DFT 梯度。
- 消融实验将 AutoSella-F 的节省归因于改进的曲率模型和坐标、对不连通片段的显式处理,以及重用先前梯度信息并考虑几何变化的 Hessian 更新;代码公开于 https://github.com/vdeshchenya/autosella。
引言
分子几何优化是计算化学中的核心任务,其在 DFT 级别的成本主要由原子间力评估决定,因此减少优化器步数会直接减少实际耗时。此前工作依赖数十年来的手工设计,涉及拟牛顿更新、坐标系统和 Hessian 模型,但进一步改进很困难,因为候选优化器可能对训练分子过拟合或过早停止。作者应用一个自动研究循环,使用 LLM 生成的代码编辑来演化 Sella,即其基准中最快的优化器,并使用廉价的 GFN2-xTB 评估以及泛化门和有效性门。该过程从两个独立的 LLM 驱动运行中产生 AutoSella-F 和 AutoSella-A;AutoSella-F 可迁移到未见分子和 r2SCAN-3c DFT,比 Sella 少需要约 23% 到 60% 的力调用次数,同时达到相等或更好的能量恢复。
数据集
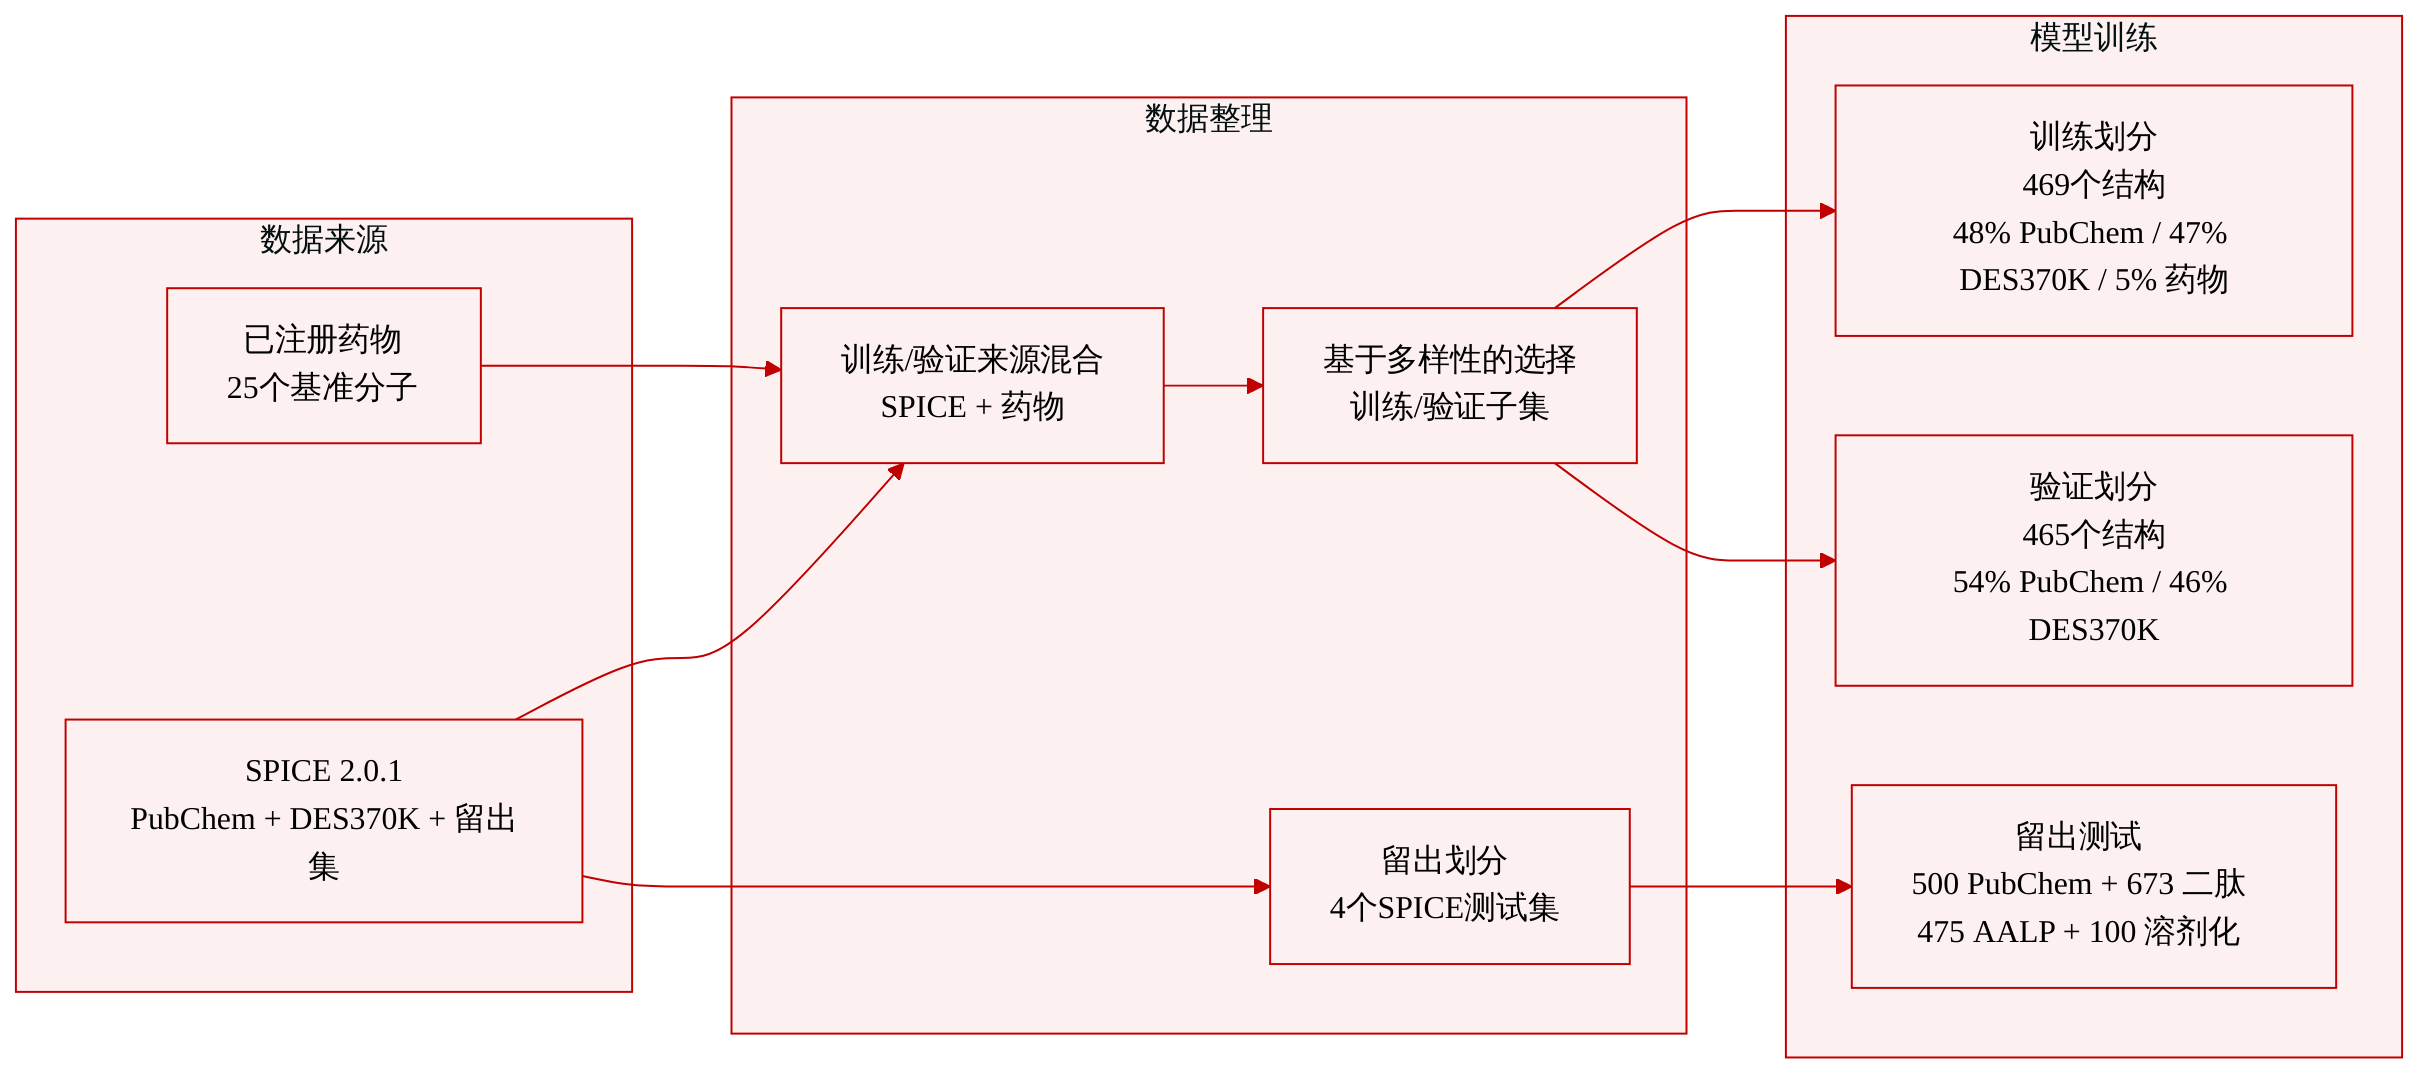
本文关注药物设计中的分子几何优化。作者使用 SPICE 2.0.1 作为训练、验证和评估结构的主要来源。
数据集组成和来源:
- 训练集:225 个类药 PubChem 分子、219 个 DES370K 二聚体和 25 个来自已发表优化器基准的已注册药物,共 469 个结构。
- 验证集:250 个类药 PubChem 分子和 215 个 DES370K 二聚体,共 465 个结构。
- 评估使用四个留出集:
- 500 个分布外 PubChem 分子
- 673 个二肽结构
- 475 个氨基酸-配体对体系
- 100 个溶剂化 PubChem 体系
关键子集细节:
- PubChem 子集:类药分子,用于训练、验证和分布外单分子测试集。
- DES370K 子集:二聚体,用于改善非共价相互作用上的优化成本;用于训练和验证。
- 已注册药物:来自已发表优化器基准的 25 个结构,加入训练。
- 二肽:单分子体系,测试向另一化学领域的迁移。
- 氨基酸-配体对:非共价接触体系,超出训练中使用的少量 DES370K 二聚体。
- 溶剂化 PubChem:复杂多片段体系,其中类药溶质与周围水分子一起弛豫。
处理和使用:
- 作者使用基于多样性的选择来挑选用于训练和验证的 PubChem 分子和 DES370K 二聚体。
- 按数量计,训练混合约为 48% PubChem、47% DES370K 和 5% 已注册药物。
- 按数量计,验证混合约为 54% PubChem 和 46% DES370K。
- 所给章节未描述裁剪或元数据构建细节;详细的数据准备流程见附录 A。
方法
作者应用自动研究范式来自动化分子几何优化器的设计。核心目标是最小化达到固定收敛标准所需的原子间力评估次数,并在 GFN2-xTB 级别评估。收敛由五标准高斯式测试决定,涉及能量变化、梯度范数和位移阈值。优化成本用每分子相对力调用比(Cper-mol)量化,弛豫深度用平均相对能量恢复比(rˉ)衡量。
为启动演化程序搜索,作者选择 Sella 2.5.0 作为基线,此前已验证它在 27 种现代优化器配置中所需力调用次数最少。代码库被整合到一个可编辑文件中,以便自动修改。自动研究循环的运作方式是让 agent 反复提出并应用对该文件的编辑,然后在固定基准上自动评估。
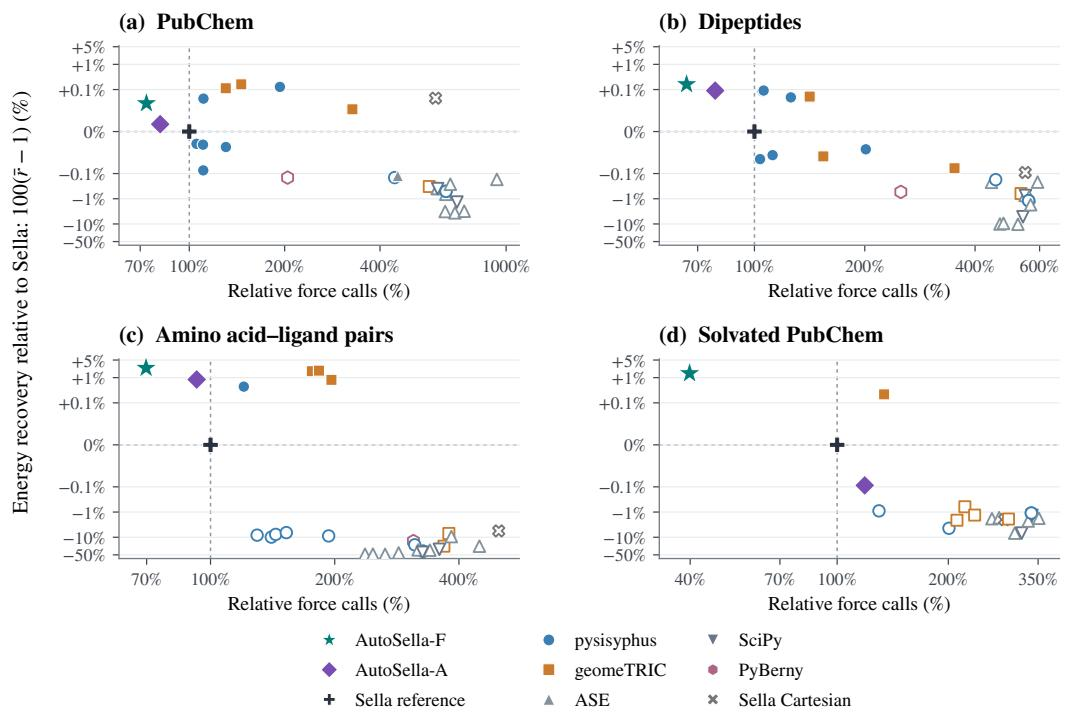
作者利用一个综合基准,在类药分子、二聚体和溶剂化体系等多种化学领域中评估基线和演化后的优化器。如下图所示,演化得到的 AutoSella 变体在所有测试集上显著降低了相对力调用,同时保持或超过了参考优化器的能量恢复。
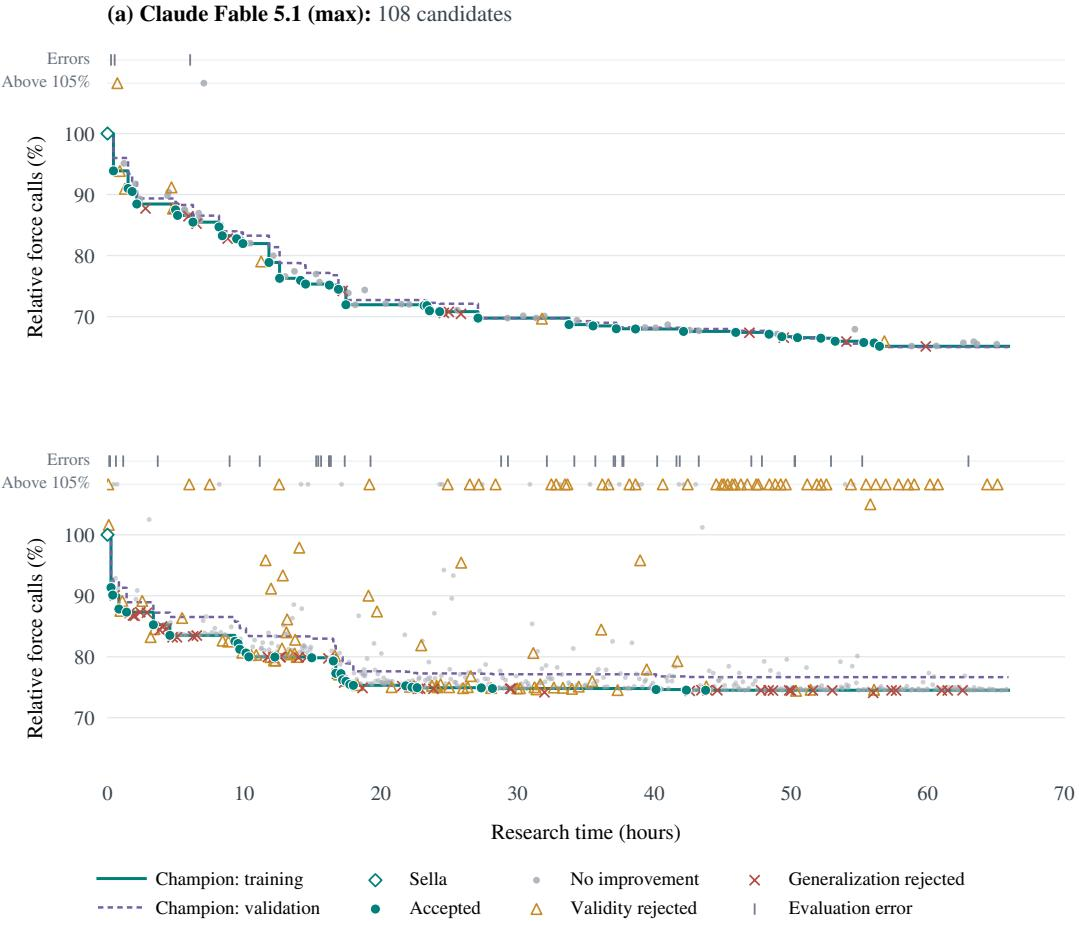
在每次迭代中,agent 编辑算法文件并提交更改。随后评估器在训练划分上对候选进行评分,返回相对力调用和能量恢复。关键的是,agent 会收到每个分子的表格,详列每个结构的相对力调用、能量差和收敛状态。这种细粒度反馈使 agent 能够提出有化学依据的假设,并针对特定的分子机制。该循环使用两个不同的大语言模型 agent 独立执行了 66 个活跃研究小时。
为确保稳健改进并防止 agent 利用收敛标准,作者实现了严格的双门过滤工作流。首先,候选必须通过训练集上的有效性门。这要求平均能量恢复至少为 1(rˉ≥1),无评估错误,并且力调用成本严格低于当前冠军一个小幅度,以滤除数值噪声。如果候选通过这一初步检查,则进入泛化门。在此,它在留出验证划分上评估,必须满足完全相同的性能和稳定性要求,才能取代冠军。这种双门机制有效防止对训练集过拟合,并确保任何被接受的优化确实能泛化到未见分子。
自动研究循环的进展和准入门控的影响在训练动态中得到清楚展示。下图描绘了相对力调用随活跃研究时间的变化,突出有效性和泛化门如何过滤掉次优候选和评估错误,从而稳步改进冠军优化器。
实验
评估在四个留出分子数据集上测试 AutoSella 优化器,涵盖 GFN2-xTB,以及未见的 GFN-FF 和 r2SCAN-3c 势能。AutoSella-F 持续降低力调用成本,同时匹配或改善能量恢复,包括在 DFT 下节省可按比例降低总成本;而 AutoSella-A 在复杂溶剂化 PubChem 体系上泛化较不可靠。对自动研究过程的分析显示,两个 LLM agent 以不同的节奏工作,但都提出、测试、诊断和修复想法;消融实验突出模型 Hessian 和片段处理是增益的关键贡献因素。
在 GFN2-xTB 上评估的留出数据集中,AutoSella-F 每个分子使用的力调用次数少于基线,同时达到可比或更低的最终能量。AutoSella-A 也相对基线降低力调用成本,但节省幅度较小,并在某些分子集上出现偶发优化错误。两个变体在所有报告块中的能量恢复比都高于 1,表明成本降低并非以牺牲能量保真度为代价。AutoSella-F 是每个报告基准块中最廉价的方法,其每分子相对力调用成本始终低于基线。两个 AutoSella 变体的平均能量恢复比都高于 1,意味着它们平均收敛到至少与基线一样低的最终能量。AutoSella-F 在报告的测试集和二肽优化中没有优化错误,而 AutoSella-A 在两个数据集上记录了少量错误。
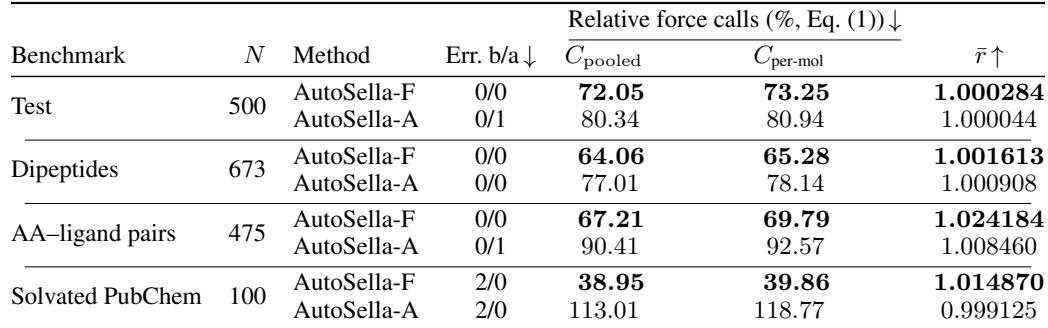
在 GFN-FF 基准上,AutoSella-F 始终需要比 AutoSella-A 更少的力调用,且两个演化优化器都保持在原始 Sella 基线以下。AutoSella-F 还将能量恢复保持在接近或略高于基线的水平,而 AutoSella-A 在氨基酸-配体对上恢复略低。报告的 DFT 迁移结果支持相同模式:AutoSella-F 节省大,而 AutoSella-A 在溶剂化多片段体系上泛化有限。在 GFN-FF 测试集、二肽和氨基酸-配体对基准中,AutoSella-F 使用的基线力调用比例小于 AutoSella-A。在 GFN-FF 上,AutoSella-F 将平均能量恢复保持在等于或高于基线的水平,而 AutoSella-A 在氨基酸-配体对上略低于基线。在 DFT 迁移结果中,AutoSella-F 在溶剂化 PubChem 上取得最大节省,使用不到 Sella 一半的力调用,同时恢复略多能量;而 AutoSella-A 需要比基线更多的力调用,且恢复更少能量。
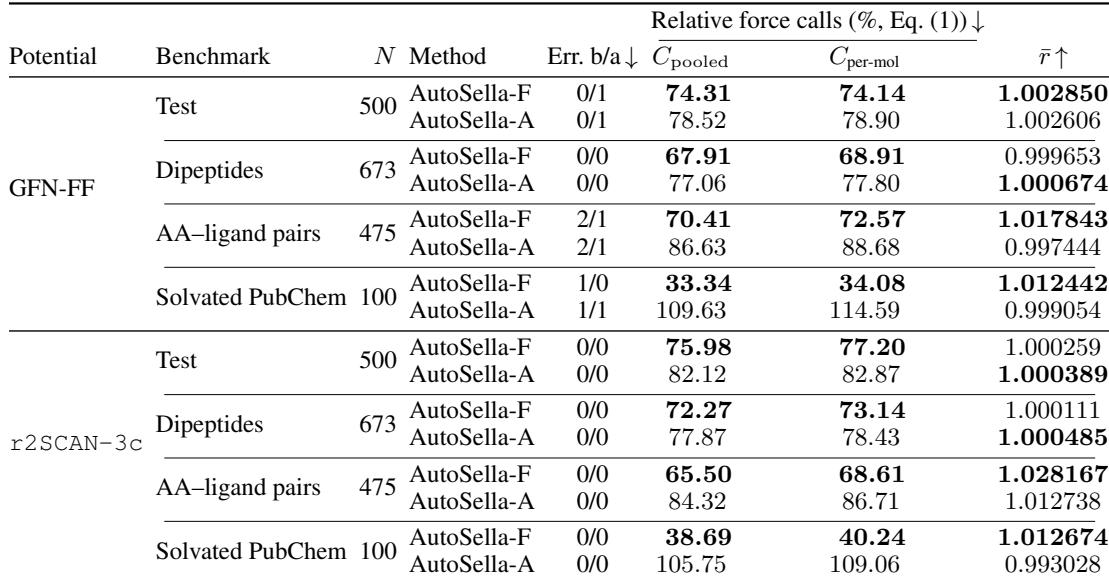
实验在 GFN2-xTB、GFN-FF 和迁移 DFT 基准上,评估两个演化优化器 AutoSella-F 和 AutoSella-A 与 Sella 基线的对比。AutoSella-F 始终每个分子需要更少的力调用,同时保持可比或更好的最终能量,并且在报告的优化中没有错误。AutoSella-A 在某些设置中也降低成本,但节省较小,在特定氨基酸和溶剂化多片段体系上出现偶发优化错误,且能量恢复略低。