Command Palette
Search for a command to run...
Kandinsky 6.0 Video:用于同步视频与音频生成的基础模型
Kandinsky 6.0 Video:用于同步视频与音频生成的基础模型
摘要
我们提出了 Kandinsky 6.0 Video,这是一组用于同步文本到音视频生成的基础扩散模型,包含 Kandinsky 6.0 Video Lite(3B 参数)和 Kandinsky 6.0 Video Pro(29B 参数)。两种模型均可在文本到音视频(T2AV)和图像到音视频(I2AV)模式下生成 5 秒视频片段及同步的 44 kHz 音频,包括唇形同步;内置超分辨率模型将输出分辨率提升至全高清(1920×1080)。在 Kandinsky 5.0 的视频生成能力基础上,Kandinsky 6.0 Video 采用双流 CrossDiT 架构,通过双向交叉注意力连接预训练视频流和新训练的音频流,以实现时间与语义对齐。我们的持续预训练策略首先在大规模音频语料上从零训练音频流,然后在成对音视频数据上联合训练两个流,同时保持单模态保真度;预训练之后进行监督微调、基于强化学习的后训练和蒸馏。在并排人工评估中,Kandinsky 6.0 Video Pro 明显优于其前代 Kandinsky 5.0 Video Pro,并与领先的音视频生成模型保持竞争力,尤其在语音质量方面。为了加速多媒体生成领域的开放研究与部署,我们在 MIT 许可证下发布代码、模型检查点和 diffusers 集成。
一句话总结
Kandinsky Lab 推出了 Kandinsky 6.0 Video,这是一个基础扩散模型系列,包含 3B 参数的 Lite 和 29B 参数的 Pro 两种版本,用于同步的文生音频视频和图生音频视频生成,采用双流 CrossDiT 架构和双向交叉注意力,并通过持续预训练和基于强化学习的后训练,在 MIT 许可证下提供全高清输出。
核心贡献
- 本文提出了 Kandinsky 6.0 Video,包含 Kandinsky 6.0 Video Lite(3B 参数)和 Kandinsky 6.0 Video Pro(29B 参数),用于同步的文生音频视频和图生音频视频生成,支持 5 秒片段、44 kHz 音频、唇形同步以及通过潜在空间超分辨率实现全高清 1920×1080 输出。
- 模型采用双流 CrossDiT 架构,通过双向交叉注意力连接预训练的视频流和从零开始训练的音频流,训练流程包括持续音频预训练、音频视频联合预训练、合并为模型汤(model soup)的有监督微调、基于 OmniNFT 改进的强化学习,以及两阶段蒸馏至 10 次函数评估。
- Kandinsky 6.0 Video Pro 超越了 Kandinsky 5.0 Video Pro,在视觉和语音质量上优于 LTX 2.5,在 VABench 的语音质量、音频美学、对齐、唇形同步、去同步化和视觉真实感等指标上取得评估模型中的最佳成绩,并将生成语音的词错误率降低了 47%;代码、检查点和 diffusers 集成均以 MIT 许可证发布。
引言
扩散模型和流匹配已成为图像与视频生成的主流方法,但将其扩展到同步的文生音频视频生成难度显著更高,因为这要求跨模态的语义、时间和情感一致性。Veo 3.1、Sora 2 和 Wan 2.6 等闭源商业系统实现了强大的统一音视频合成,但其源代码不可获取,而开源模型在片段时长、分辨率和同步准确性方面仍然落后。作者提出了 Kandinsky 6.0 Video,这是一个开放基础模型系列,包含 Lite 和 Pro 两种版本,可生成带同步 44 kHz 音频的 5 秒片段,采用双流 CrossDiT 架构、持续预训练和多阶段后训练流程,用于文生音频视频和图生音频视频生成。
数据集
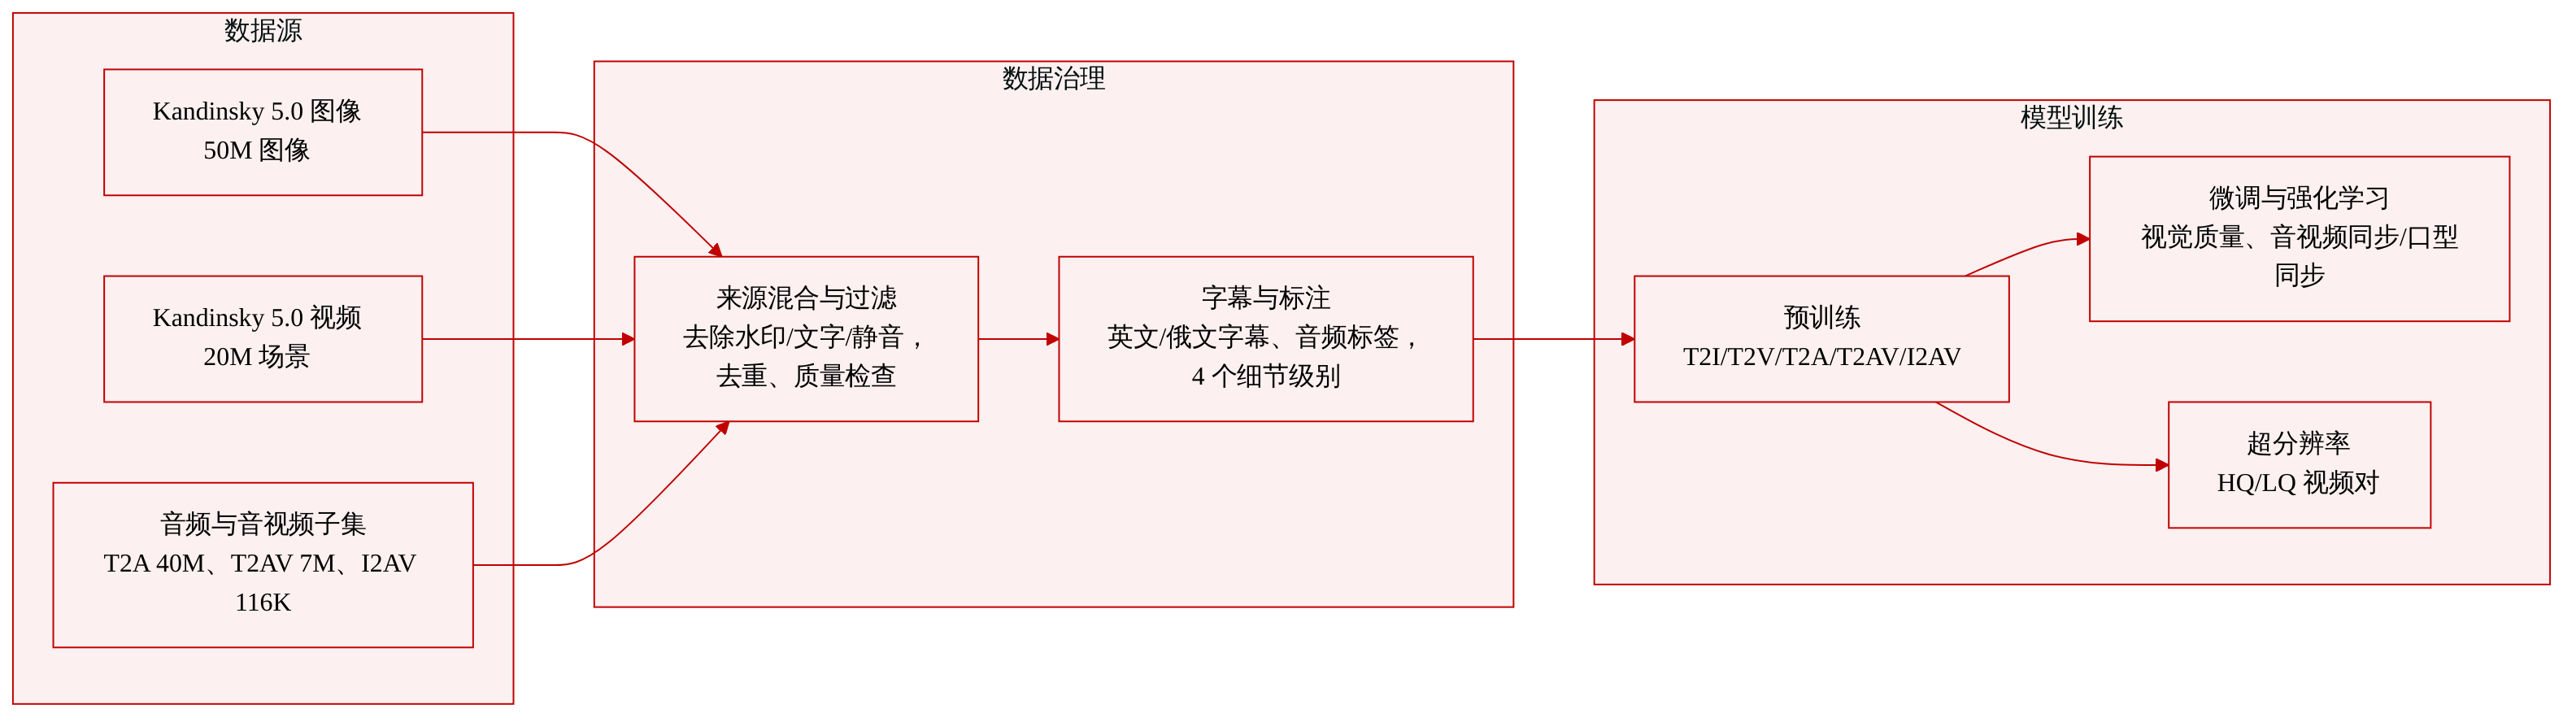
作者为 Kandinsky 6.0 Video 构建了多个数据集,大部分来源于此前的 Kandinsky 5.0 数据集。数据覆盖预训练、有监督微调、强化学习、超分辨率和文化感知生成。
预训练数据集
-
文生图,T2I: 从 Kandinsky 5.0 数据集中选取 5000 万张图像,并使用新的标注器重新标注。
- 筛选继承了 Kandinsky 5.0 的流程:去除水印和文字密集场景,应用感知去重,使用 YOLOv8 和基于 CLIP 的分类器平衡物体与场景类别,使用 TOPIQ 和 Q-Align 分数保证技术与美学质量,并通过 SAM 2 复杂度筛选保留视觉丰富的构图。
- 标注由 Qwen3-235B-A22B 以俄语和英语生成,再由 Qwen3-30B-A3B 改写为四个细节级别:长、中、短和最短。
-
文生视频,T2V: 从 Kandinsky 5.0 T2V 数据集中选取 2000 万个视频场景并重新标注。
- 额外筛选会移除帧率非标准或由 TransNetV2 检测到场景切换的片段。
- 属性包括稳定的单场景片段、标准化帧率、无内部场景切换、无水印或文字密集场景、感知去重、DOVER 和 Q-Align 质量检查、基于 YOLOv8 和 CLIP 的类别平衡、基于 VideoMAE 的相机与物体运动多样性,以及基于 MS-SSIM 的结构动态筛选。
- 标注使用与 T2I 相同的 Qwen3-235B-A22B 和 Qwen3-30B-A3B 流程,并清理引导性短语和非英语、非俄语字符。
-
文生音频,T2A: 从 Kandinsky 5.0 视频中提取 4000 万条 5 到 20 秒的音频轨道。
- 静音、损坏或低质量的轨道被剔除。
- 每条轨道由 Qwen3-30B-A3B 标注,描述声音、音乐、语音和环境声学信息。
- 用于在音频视频联合训练之前引导音频模态。
-
文生音频视频,T2AV: 从 Kandinsky 5.0 视频数据集中提取 700 万个音频视频片段。
- 筛选针对音频质量、有意义的音视频对应关系和唇形同步适宜性。
- 音频质量筛选会移除静音、损坏或低质量的音频,保留具有足够动态范围、低削波和适当幅度的片段。
- 唇形同步和同步筛选使用来自 VABench 的唇形同步对齐分数、LSA 和 Desync 指标。包含人物的片段要求 LSA 至少为 5 分中的 3 分。包含音视频事件的片段要求 Desync 低于 1 分中的 0.1。没有可见面部的片段不要求唇形同步,约占 T2AV 数据集的 25%。
- 视觉质量沿用 T2V 的筛选器:DOVER、Q-Align、CRAFT、YOLOv8 和基于 CLIP 的分类器。
- 标注结合了
<S>...<E>内的 Gemma-4-E4B-it 语音转录、<AUDCAP>...<ENDAUDCAP>内的 Qwen3-30B-A3B 音频描述,以及 Qwen3.5-35B-A3B 生成的统一视觉与音频标注。
-
图生音频视频,I2AV: 从 Kandinsky 5.0 视频数据集中选取 116,000 个样本。
- 每个样本将起始帧(视频场景的第一帧)与描述该帧及预期音视频延续内容的组合标注配对。
- 标注采用两阶段本地流程:音频描述由 Gemma-4-E4B-it 和 Qwen3-Omni-30B-A3B 生成,再与相机运动标签结合并传给 Qwen3.5-35B-A3B 生成统一的视频与音频标注。标注被改写为四个细节级别。
- 起始帧通过 Qwen3-VL-Embedding-2B 质量嵌入、PyIQA 无参考图像质量指标、基于拉普拉斯方差的模糊检测,以及 Qwen3-VL-8B-Instruct 的语义检查进行筛选,确保起始帧清晰且非动作中间状态。
有监督微调数据集
- 作者构建了两个 SFT 数据集:一个用于纯视频任务,另一个用于音视频任务。
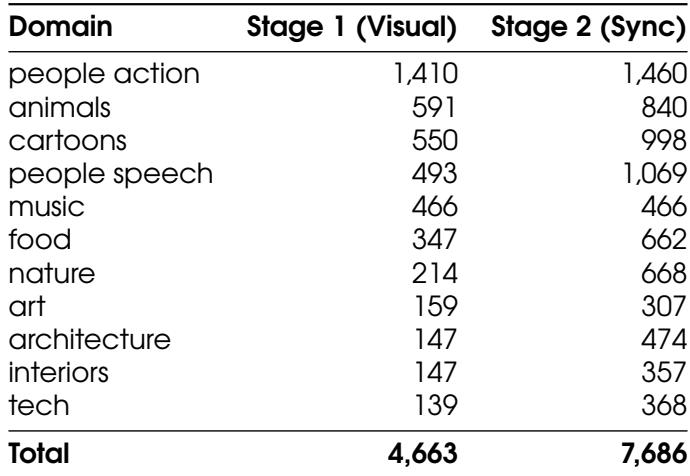
- 两者使用表 1 中相同的 11 个领域分类体系,并遵循共同流程:
- 使用 DOVER、Q-Align、CRAFT 和运动动态模型进行技术筛选;音频使用 Meta Audiobox Aesthetics 筛选,并移除静音或损坏的轨道。
- 使用 Qwen2.5-VL-32B-Instruct 视觉嵌入和 Qwen3-Omni-30B-A3B 音频嵌入,将数据分类到人物动作、动物、卡通、人物语音、音乐、食物、自然、艺术、建筑、室内和科技等 11 个领域。
- 由技术筛选员和摄影专家进行两阶段专家评估。
- 通过 Gemma-4-E4B-it、Qwen3-Omni-30B-A3B 和 Qwen3.5-35B-A3B 进行标注,包含运动分类标签和四个细节级别。
- 第一阶段包含 4,663 个场景,主要用于视觉质量增强。第二阶段包含 7,686 个场景,增加语音和音乐内容以改善音视频同步和唇形同步。
强化学习数据集
- RL 数据集包含 2,984 个从 SFT 数据集中精选的片段。
- 每个样本都有英语和俄语的 T2AV 专用标注。
- 所有样本均包含带有
<AUDCAP>...<ENDAUDCAP>标记的音频标注。 - 提供预计算的文本嵌入以支持高效在线训练。
- 用于具有逐提示 rollout 和多目标奖励的在线 RL。
超分辨率数据集
- 超分辨率数据集包含来自三个来源的 150,000 个独立片段:
- 100,000 个多样化高分辨率 4K 视频片段。
- 约 35,000 个来自 Kandinsky 5.0 T2V 数据集的高分辨率片段,经过伪影筛选和 Q-Align 质量筛选选出。
- 15,000 个合成相机运动片段,通过沿采样的相机轨迹移动空间裁剪区域,从 Aesthetic-4K 高分辨率图像生成。
- 质量筛选检查压缩伪影、平滑渐变中的可见条带、Q-Align 分数,以及针对 4K 数据集的独立波纹检测器。
- 裁剪准备提取 512×768、512×512 或 768×512 像素的空间裁剪。裁剪位置使用中心裁剪、随机裁剪、基于光流的选择或高细节区域选择。暗色边框被排除。
- 通过的裁剪成为 HQ 目标,退化后的对应版本成为 LQ 输入。两者都用 K-VAE 编码并存储为成对的视频潜在表示。
- 使用两种退化流程:一种采用 Real-ESRGAN 风格流程,包含模糊、缩放、噪声、JPEG 压缩和视频压缩;另一种采用 CreativeVR 风格时间退化流程,包含空间网格扭曲、方向性运动模糊、相邻帧混合、丢帧插值以及时空下采样。
俄罗斯文化代码数据集
- 俄罗斯文化代码数据集包含 120 万张图像和 530,000 个视频场景。
- 该数据集旨在呈现俄罗斯文化元素,如信仰、语言、历史记忆、自然、建筑和其他具有文化意义的方面。
- 样本带有准确的物体名称和全面的场景描述。
- 该数据集在 T2V 预训练期间使用,并在联合 T2AV 训练期间通过图像注入,同时提供英语和俄语标注。
使用摘要
- 预训练使用 T2I、T2V、T2A、T2AV 和 I2AV 数据集来引导图像、视频、音频、联合音频视频以及以图像为条件的音频视频生成。
- 有监督微调使用两个 SFT 数据集进行两阶段流程:首先针对视觉质量,然后针对音视频同步和唇形同步。
- RL 数据集在 SFT 之后用于在线强化学习。
- 超分辨率数据集用于构建超分辨率训练的 HQ/LQ 配对。
- 所提供的摘录中未报告这些数据集的明确混合比例。
方法
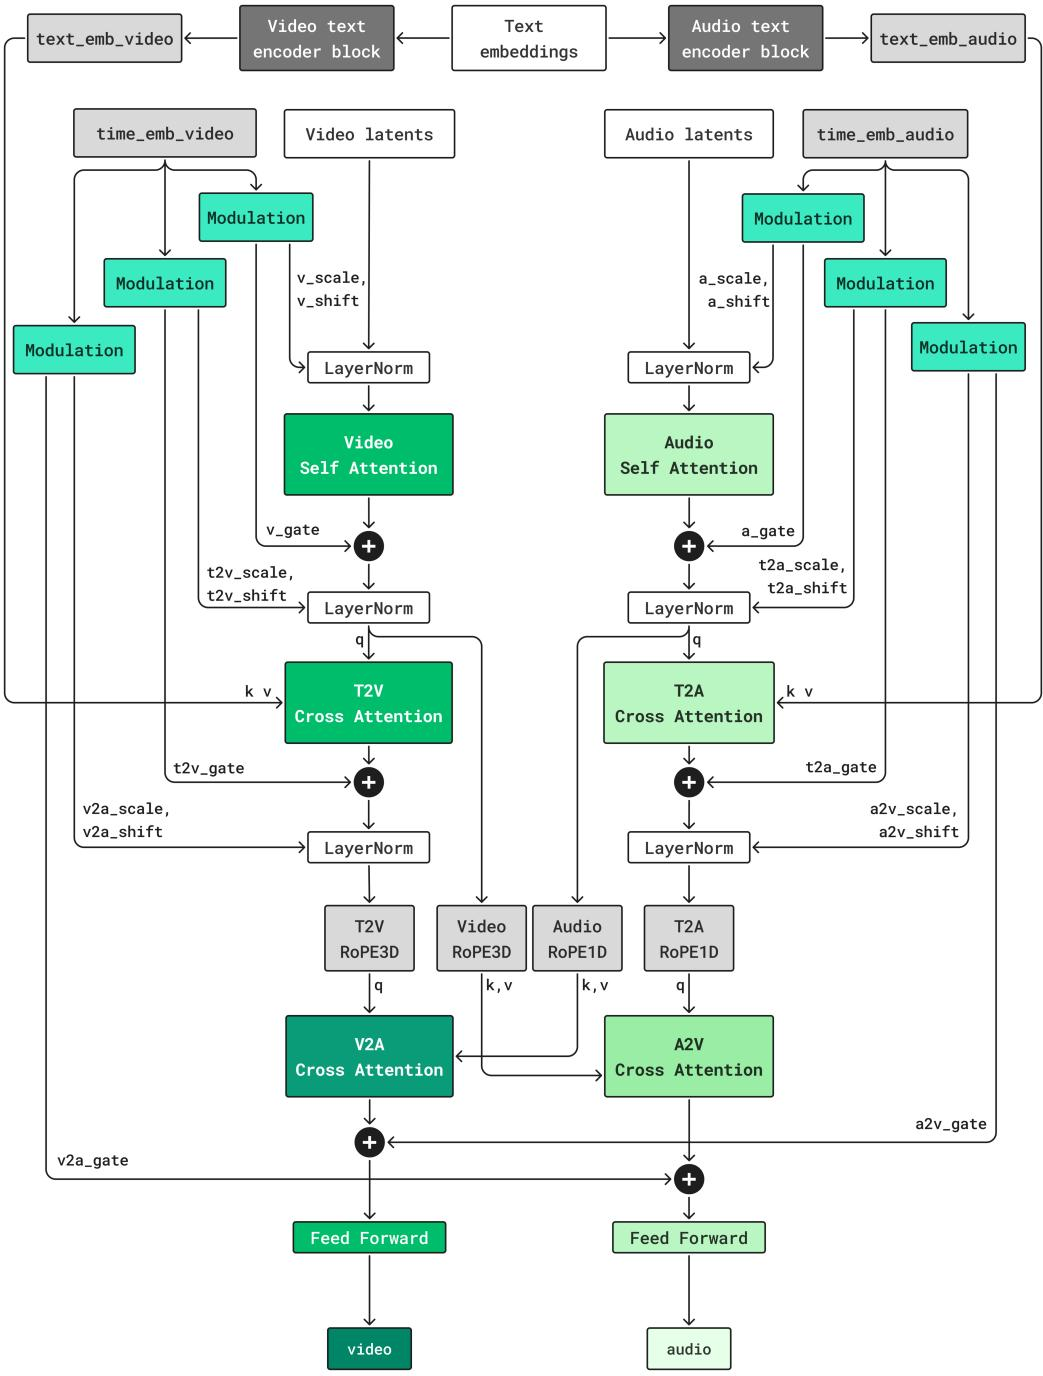
作者围绕双流 CrossDiT 架构设计了 Kandinsky 6.0 Video,同时处理视频和音频模态。模型包含视频和音频的非对称 DiT 主干,通过逐块双向交叉注意力连接。
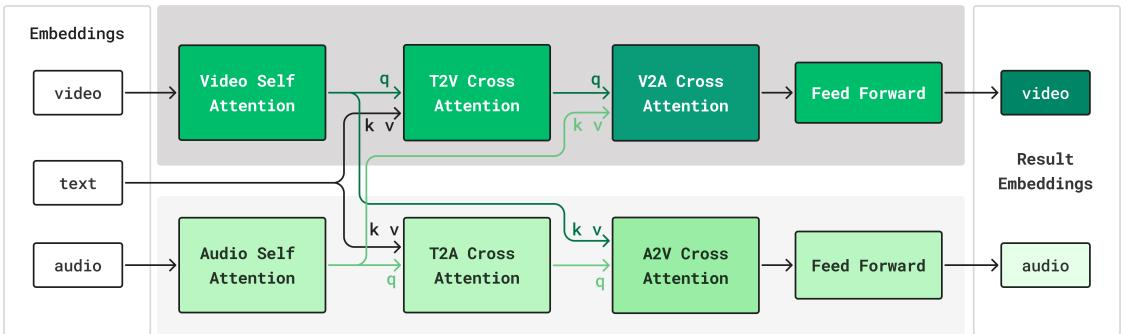
每个流继承上一代的架构,但在隐藏维度和前馈维度上有所不同。视频流使用以帧编号为索引的 3D 旋转位置嵌入(RoPE),而音频流使用基于时间位置的 1D RoPE。
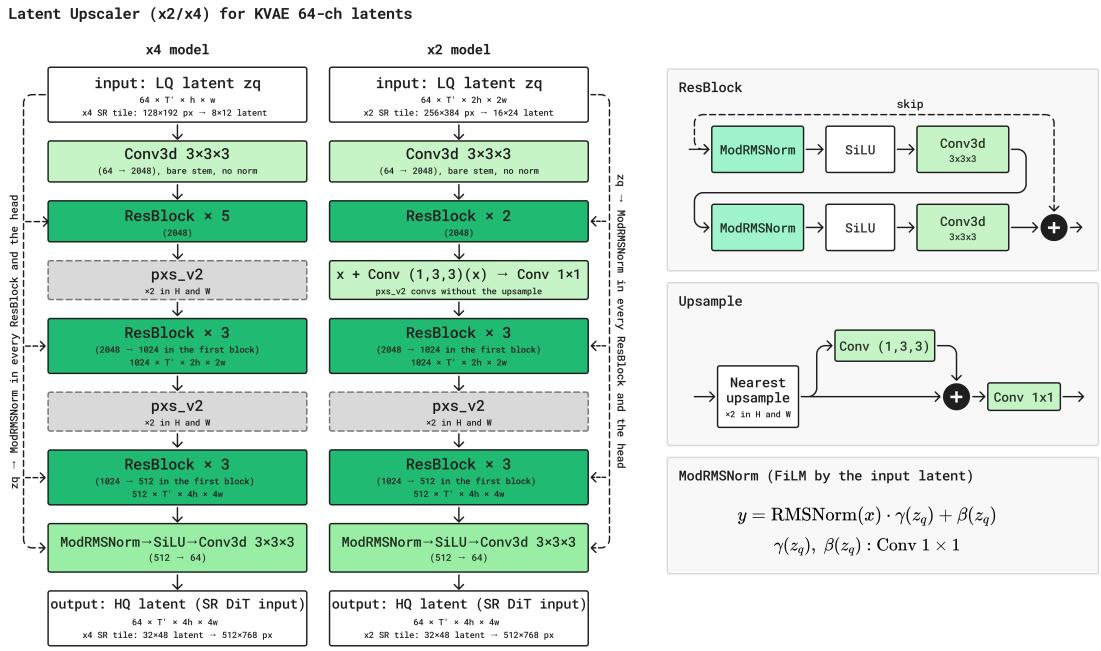
为实现全高清输出,作者采用在视频自编码器潜在空间中运行的独立超分辨率流程。该流程包含一个潜在上采样器(LU)和一个超分辨率扩散 Transformer(SR-DiT)。SR-DiT 是一个无文本模型,以噪声潜在表示、HQ 锚点张量和二值掩码为输入,预测流匹配速度。
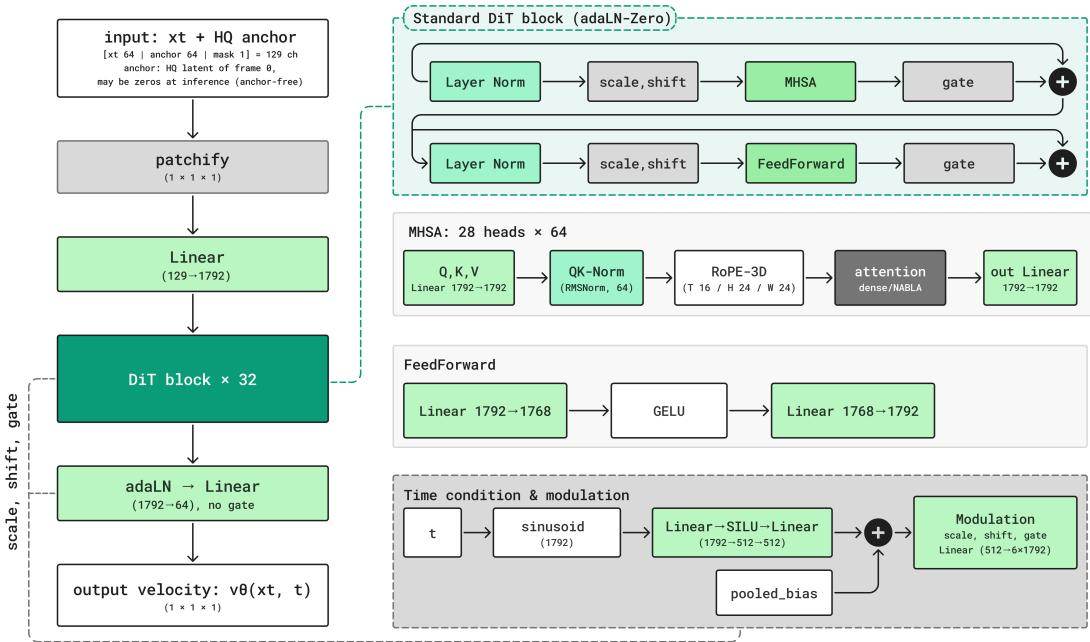
潜在上采样器直接在潜在空间中将低质量潜在表示提升到 SR-DiT 的工作分辨率,避免了像素空间解码和重新编码。它基于 K-VAE 解码器几何结构,设有独立的 ×2 和 ×4 上采样分支。
训练过程采用顺序多阶段方法。
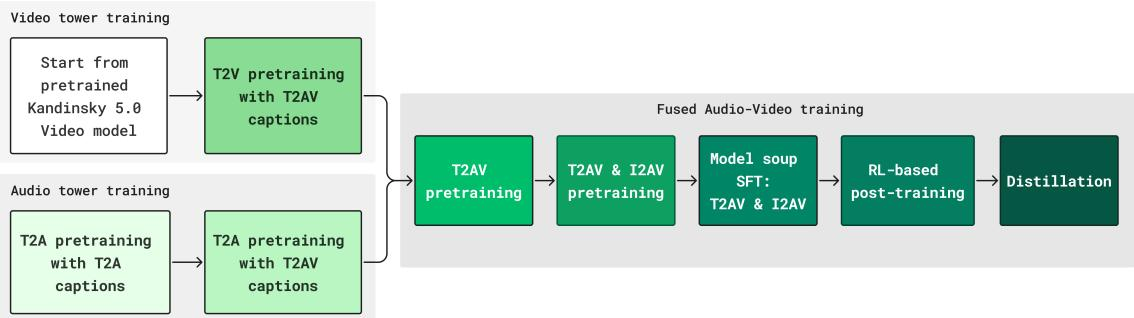
预训练从分别训练视频流和音频流开始。视频流从之前的检查点初始化,音频流从零开始训练。随后两者融合,并在文生音频视频和图生音频视频模式下联合训练。预训练之后,模型在 11 个领域上进行有监督微调,以增强视觉质量和音视频同步,最终通过均匀权重平均形成模型汤。随后应用基于改进 OmniNFT 方法的强化学习后训练,以优化各模态优势和唇形同步准确性。最后,使用 π-Flow 进行轨迹压缩蒸馏,并使用 Sim-LADD 进行对抗性细化蒸馏,以恢复高频细节。
实验
实验通过正则化与强化学习后训练研究、超分辨率和潜在上采样器验证、消费级 GPU 优化测试、基准对比以及大规模人工并排评估来验证 Kandinsky 6.0 Video 模型。正则化和 RL 阶段相比有监督微调改善了语音可懂度和音视频对齐,而蒸馏保持了模型质量。超分辨率通过互补的无参考质量和时间诊断以及人工审查进行评估,基于卸载的部署可扩展到消费级 GPU,除 NF4 文本编码器量化外仅存在舍入级别的差异。人工和基准结果显示模型竞争力参差不齐:模型在语音和同步方面表现强劲,但在视觉保真度和一般音频质量方面,若干竞品处于领先地位。
SFT 数据集在不同领域间分布不均,人物动作在两个阶段中都占主导地位,而自然领域起始规模最小。除音乐外,第二阶段同步数据在每个列出的领域中都大于第一阶段,其中自然、人物语音、卡通和食物的相对增长尤为显著。音乐在两个阶段之间保持不变。人物动作是两个阶段中最大的领域,而自然在第一阶段的数量最少。自然在第二阶段急剧增长,超过音乐并接近食物级别的数据量。音乐是唯一一个样本数量在第一阶段和第二阶段保持不变的领域。人物语音、卡通、食物和自然的第二阶段样本量显著多于第一阶段。
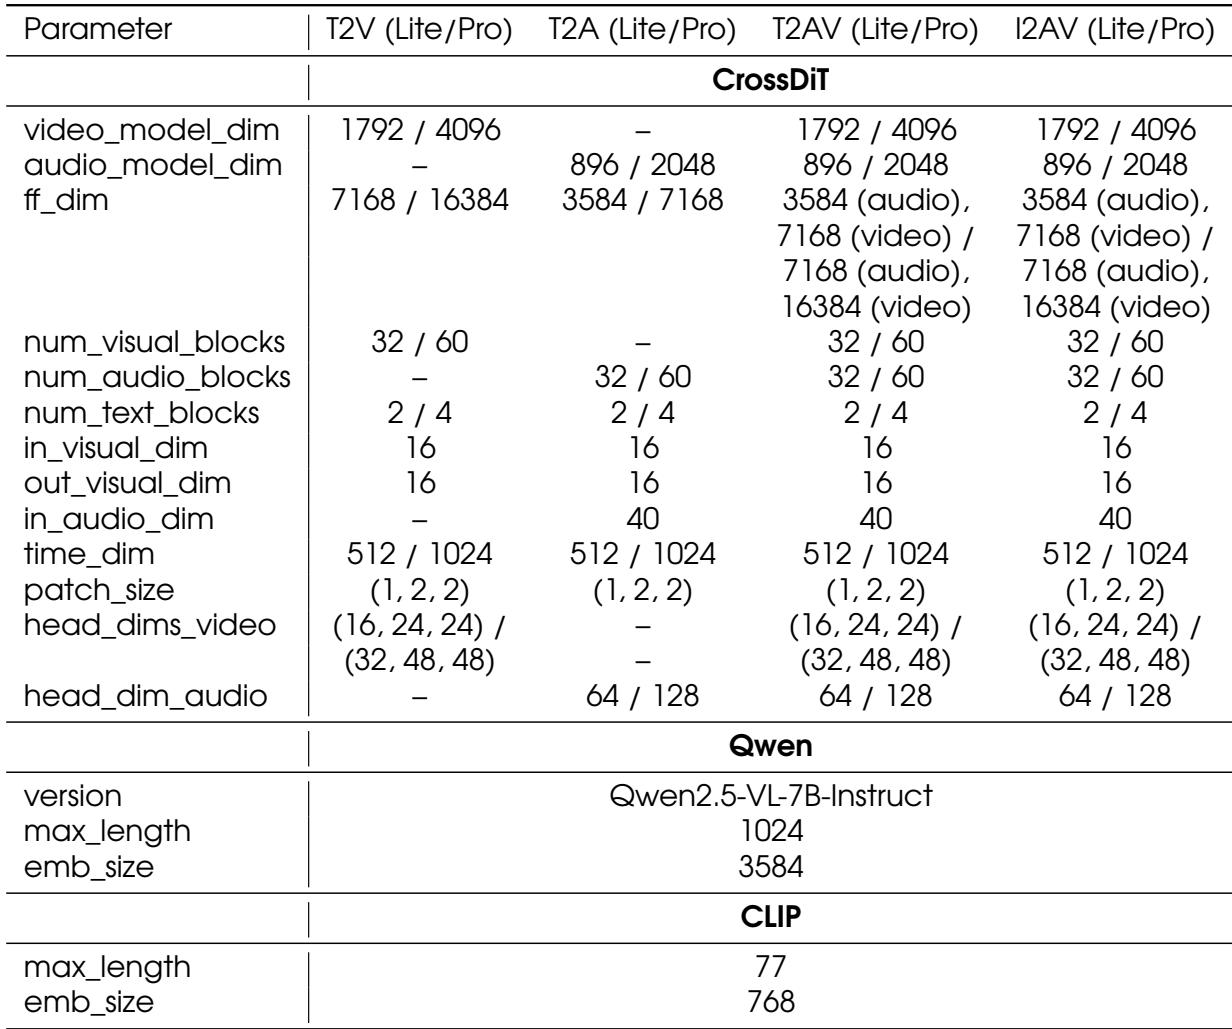
Kandinsky 6.0 Video 使用双流 CrossDiT,具有独立的视觉和音频主干。Pro 配置在隐藏宽度、前馈维度、视觉和音频深度以及文本深度上均持续大于 Lite。模态特定的预训练阶段不使用另一个流,而联合和图生音频视频阶段则以相同的逐模态维度和块数配置视觉流和音频流。与 Lite 相比,Pro 使用更宽的视频和音频模型维度、更宽的前馈层以及更深的视觉和音频堆栈。对于给定模型规模,文本编码器块数在所有训练阶段保持不变。纯视频训练仅包含视觉流参数,纯音频训练仅包含音频流参数;联合阶段包含两个流。一旦视觉流或音频流存在,其模型维度和块数在纯视频、纯音频、联合和图生音频视频阶段都保持不变。
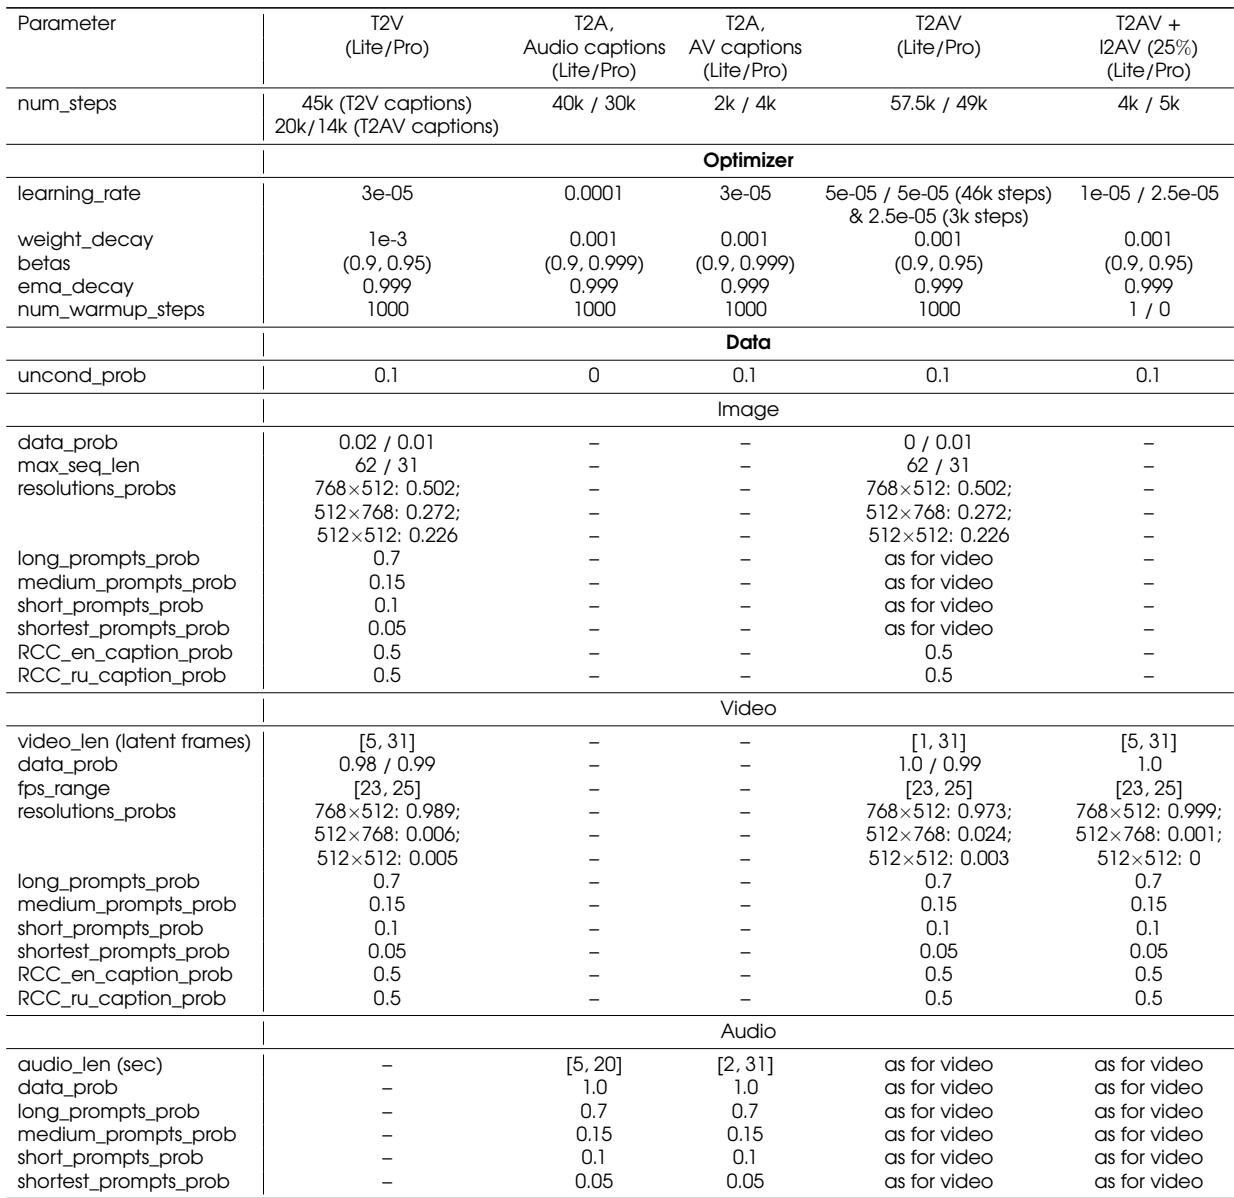
Kandinsky 6.0 Video Lite 和 Pro 的持续预训练方案从分别的文生视频和文生音频阶段过渡到更长的联合文生音频视频阶段,随后是包含图生音频视频样本的短混合阶段。超参数按阶段变化:音频标注训练使用更高的学习率和不同的优化器 beta 计划,而最终混合阶段使用更低的学习率。Lite 和 Pro 的主要差异在于各阶段的步数,权重衰减和 EMA 衰减等正则化设置相同。音频标注上的文生音频预训练使用比其他阶段更高的学习率,以及与文生视频和联合阶段不同的优化器 beta 计划。联合文生音频视频阶段是最长的阶段,而最终的图生音频视频混合阶段短得多,使用更低的学习率,并且几乎取消了预热。Lite 使用更多的联合训练步数,但音频视频标注和最终混合阶段的步数少于 Pro,而权重衰减和 EMA 衰减在各阶段保持不变。
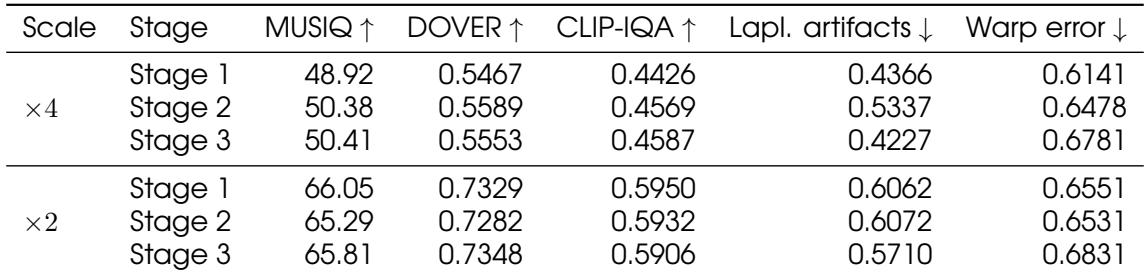
验证指标显示了 SR-DiT 在空间质量和时间一致性之间随阶段变化的权衡。在 ×4 下,后期阶段改善了无参考图像和视频质量分数,蒸馏降低了拉普拉斯伪影,但扭曲误差在各阶段间增加。在 ×2 下,阶段间变化较小,蒸馏同样降低了伪影,同时产生了最高的扭曲误差。在 ×4 下,NABLA 微调改善了 MUSIQ、DOVER 和 CLIP-IQA,但增加了拉普拉斯伪影和扭曲误差;随后的 π-Flow 蒸馏将拉普拉斯伪影降至低于第一阶段的水平,而扭曲误差继续上升。在 ×2 下,空间质量指标在各阶段保持接近,蒸馏阶段实现了最低的拉普拉斯伪影和最高的 DOVER,但扭曲误差也最高。
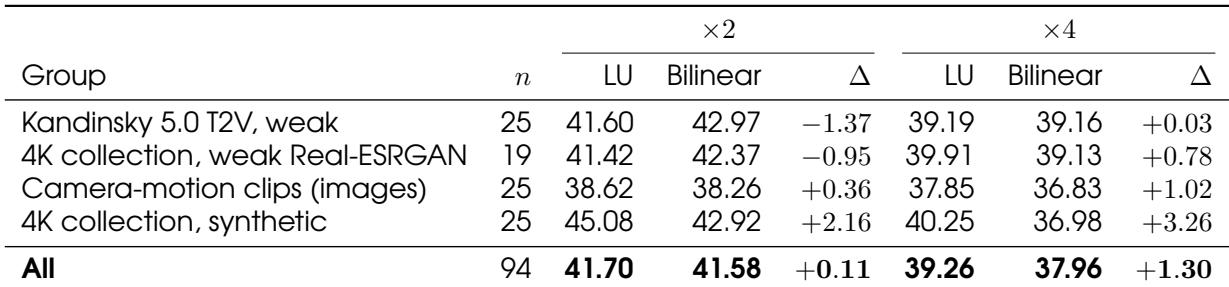
将潜在上采样器与双线性像素空间上采样进行对比,使用逐片段平均 PSNR。总体而言,上采样器在 ×2 下略微改善了 PSNR,在 ×4 下改善更明显,主要由合成 4K 和相机运动片段驱动。对于弱源片段,×2 的结果可能偏向双线性,但 ×4 的结果为中性或正向。汇总所有验证片段后,上采样器在两个尺度上都优于双线性,在 ×4 下的收益远大于 ×2。上采样器对合成 4K 和相机运动内容帮助最大,而 ×2 下的弱源片段可能偏向双线性。
实验在数据、架构、训练和超分辨率等组件上验证了 Kandinsky 6.0 Video 流程。第二阶段同步数据扩展了大多数领域,音乐保持不变,人物动作仍然占主导地位,分阶段训练方案从分别的视频和音频预训练过渡到更长的联合音频视频阶段,随后是短的低学习率混合阶段。模型配置对比确认 Pro 持续比 Lite 更宽更深,逐模态维度保持稳定,而超分辨率评估显示了质量权衡:后期阶段改善了空间和无参考分数,但增加了扭曲误差,潜在上采样器在更高放大倍数以及合成 4K 和相机运动内容上收益最大。