Command Palette
Search for a command to run...
EVISKILL:将技能演化扎根于可重放证据
EVISKILL:将技能演化扎根于可重放证据
Yan Zhou Yili Wang Yiwei Dai Qinggang Zhang Xin Wang
摘要
持续技能演化使 LLM 智能体能够从交互经验中积累并精炼可复用的程序性知识,而无需更新模型参数。其有效性不仅取决于确定要改变什么,还取决于为何某项改变是合理的,以及它何时应成为持久性指导。然而,现有经验驱动方法可能会丢失支持编辑的行为证据和任务上下文。此外,全局验证结果对其组成变更的判断并不完整:局部有依据的修正可能随被拒绝的修订一同被丢弃,而证据可能需要进一步经验才能促成有用的更新。为此,我们提出了 EVISKILL,一个证据驱动的框架,它将执行观察组织为可重放证据卡(Replayable Evidence Cards),并生成与其支持上下文显式关联的编辑。定向重放通过重新执行来验证这些编辑,并为纠正提供反馈。在多个训练周期中,EVISKILL 保留证据并临时保留有依据的编辑以供进一步精炼,同时由全局验证决定其是否纳入最终技能。在 3 个交互式基准和 6 个 LLM 骨干上的实验验证了该方法的有效性。我们的代码和实现细节可在 https://github.com/Zhouyaner/eviskill 获取。
一句话总结
吉林大学的研究人员提出 EVISKILL,一种证据驱动的 LLM 技能持续演进框架,该框架将执行观察存储为可重放证据卡,合成与支持上下文明确关联的编辑,通过定向重放验证这些编辑,并在全局验证将其纳入最终技能之前临时保留受支持的编辑以供进一步细化,其有效性在三个交互基准和六种 LLM 骨干上得到验证。
核心贡献
- EVISKILL 是一种证据驱动的技能演进框架,将执行观察组织为可重放证据卡,并将技能编辑关联到其支持的行为上下文。
- 重放引导的编辑验证通过重新执行来检验编辑是否产生预期行为效果,而跨 epoch 证据传播即使在整体修订被拒绝时也会保留并细化受支持的编辑。
- 在六种 LLM 骨干上的三个交互基准实验显示相对于强技能演进基线的持续改进,分析表明基于证据的重放会过滤不支持的修订,跨 epoch 传播使先前证据能够支持持续细化。
引言
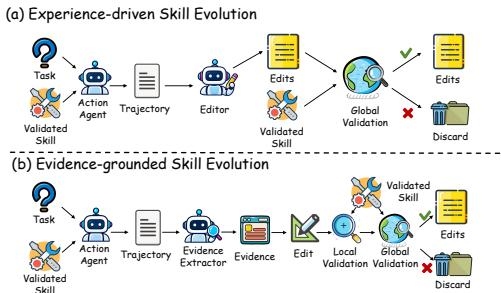
LLM agents 越来越多地处理工具使用、网页导航和长时程决策等交互任务,其中可复用的外部技能在不改变模型参数的情况下提供程序性指导。先前基于经验的技能演进方法直接从执行轨迹中提取更新,但执行经验是局部的且依赖上下文,因此编辑可能会过拟合已观察到的案例或捕获偶然行为。被拒绝的修订中也可能包含被丢弃的有用编辑。作者提出 EVISKILL,一个将技能持续演进组织为证据构建、行为验证和跨 epoch 细化的证据驱动框架。EVISKILL 将候选编辑建立在可重放执行证据之上,重新执行被引用的行为以验证预期效果,并保留不确定或未解决的证据以便在未来 epoch 中重新考虑。在多个 LLM 骨干上的三个交互基准实验显示相对于强技能演进基线的持续改进。
方法
作者提出 EVISKILL,一个围绕可重放证据卡组织技能演进的框架。这些卡记录提议的技能修正及其支持的执行证据,形成支持持续改进的结构化流水线。整体架构包含三个相互关联的阶段:基于证据的编辑合成、重放引导的编辑验证和跨 epoch 证据传播。
如下图所示:
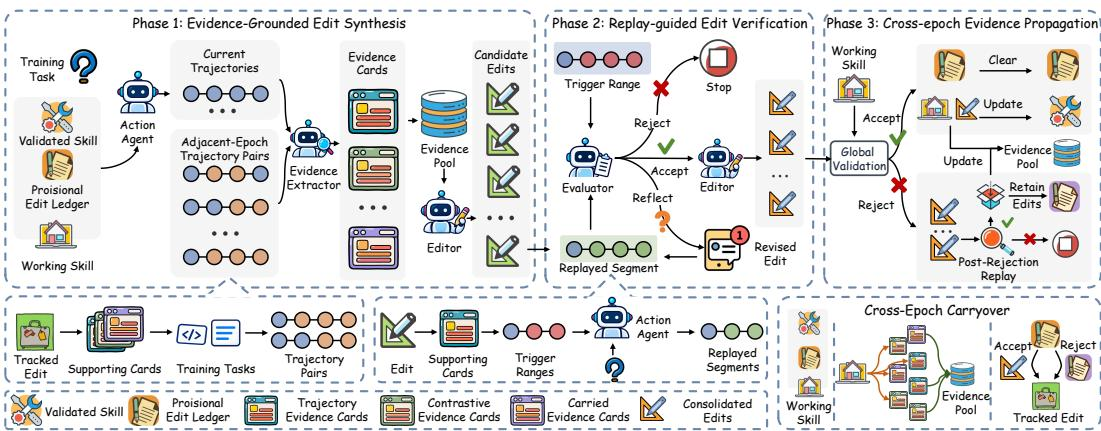
第一阶段为基于证据的编辑合成,系统区分仅在全局验证成功时更新的已验证技能(Validated Skill)和用于持续交互的工作技能(Working Skill)。在 epoch e,工作技能 SeW 将最新的已验证技能 SeV 与包含重放支持编辑以供进一步细化的临时编辑账本(Provisional Edit Ledger)Pe 相结合:
SeW=SeV⊕Pe其中 ⊕ 按顺序应用这些编辑。Action Agent 使用 SeW 收集轨迹,为技能修正提供基础证据。LLM 证据提取器分析工作技能及其轨迹以提出修正,并将每条提议记录为可重放证据卡。卡片 Ci 正式定义为:
Ci=⟨i,Gi,di⟩其中 i 是持久标识符,Gi 表示来自轨迹的支持触发区间,di 是提议的修正。该框架从当前交互中提取轨迹证据卡,从相邻 epoch 轨迹比较中提取对比证据卡,以识别持续存在的缺陷。这些卡被合并到证据池中,基于兼容上下文分组为证据窗口,并由 LLM 编辑器处理以合成候选编辑集 Ue。
第二阶段“重放引导的编辑验证”确保合成的编辑产生预期行为效果。对于每个候选编辑 u∈Ue,系统检索其支持卡并重放关联的触发区间。通过复现源轨迹的前缀,框架重建执行状态,并在修改后的技能 SeW⊕u 下重新执行该片段。LLM 评估器评估源片段与重放片段,返回接受、反思或拒绝编辑的决策。如果决策为反思,编辑器基于反馈生成修订后的编辑 u′,该编辑随后进行另一轮重放和评估。成功验证的编辑被整合为有序集合,产生用于全局验证的候选修订 Se。
最后一个阶段“跨 epoch 证据传播”管理技能和证据如何在各 epoch 之间更新。全局验证在验证集上将候选修订 Se 与当前已验证技能 SeV 进行比较。如果 Se 表现出更优性能,则替换 SeV,清空临时编辑账本,已纳入的编辑成为新的跟踪编辑(Tracked Edits),用于未来的跨 epoch 比较。
如果候选修订在全局验证中被拒绝,框架采用拒绝后重放来挽救有效编辑。每个整合后的编辑在原始已验证技能 SeV⊕v 下独立重放,以确定它在没有临时编辑的情况下是否仍然有效。通过该隔离评估的编辑被保留在下一 epoch 的临时编辑账本中,确保局部有益的修正不会因为全局不兼容而被丢弃。此外,证据卡的生命周期被动态管理:支持已接受编辑的卡被归档,而支持被拒绝编辑的卡可能被标记为过期或受保护,以用于未来的跨 epoch 比较。经过 E 个演进 epoch 后,最终已验证技能被冻结用于推理,确保只部署经过充分验证且受重放支持的技能。
实验
初步研究揭示了现有技能演进中的两个弱点:基于经验的编辑常常未能产生预期的执行效果,且全局被拒绝的修订中可能仍包含有用的组成编辑。主要实验在 App-World、ScienceWorld 和 ALFWorld 上使用多个 LLM 骨干评估 EVISKILL,结果表明将技能更新建立在执行证据上带来了广泛的收益,而技能演进并不保证相对其初始版本一定改进。消融与机制分析确认,重放引导的编辑验证改善了行为修正,跨 epoch 证据传播保留了受支持的编辑和未解决的证据,许多来自被拒绝修订的编辑后来被纳入已接受技能,证据卡在不同 epoch 间被重复使用。
基于执行的技能演进在交互基准上带来广泛的任务成功率提升,在每种设置下都优于无技能基线,并在大多数比较中位居前列。若干技能演进基线在 ScienceWorld 上出现退化,低于无技能和初始技能准确率,而基于执行的方法避免了这一模式。结果表明,通过观察到的行为验证更新有助于在吸收新经验的同时保留有用的技能。基于执行的技能更新在大多数模型-数据集设置中取得了最佳准确率,并在所有报告设置中优于无技能基线。在 ScienceWorld 上,若干演进基线低于初始技能,有些甚至低于无技能基线,而基于执行的更新几乎在所有设置中都优于初始技能。
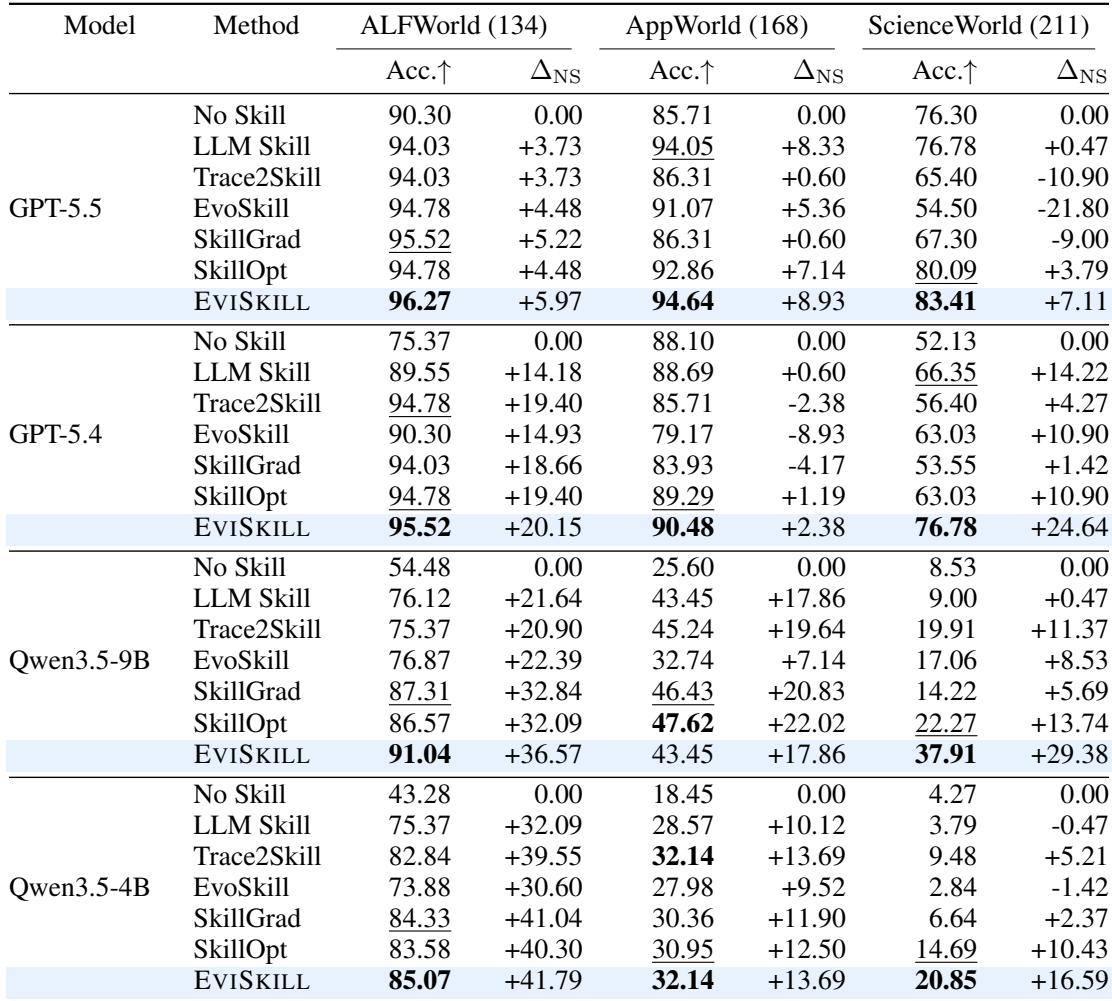
实验在交互基准上评估基于执行的技能演进,检验以观察到的行为为依据的更新是否提高任务成功率。该方法在所有设置中一致优于无技能基线,并位居前列,而若干技能演进基线在 ScienceWorld 上退化,低于无技能和初始技能准确率。基于执行的更新还在大多数模型-数据集设置中取得了最佳准确率,并几乎在所有 ScienceWorld 设置中优于初始技能。这些结果表明,将技能更新建立在执行之上有助于在整合新经验的同时保留有用技能。