Command Palette
Search for a command to run...
追问问题:维持推理模型的自我进化
追问问题:维持推理模型的自我进化
Jinyuan Li Chengsong Huang Langlin Huang Donghong Cai Shiping Gao Yuyi Yang Jiaxin Huang
摘要
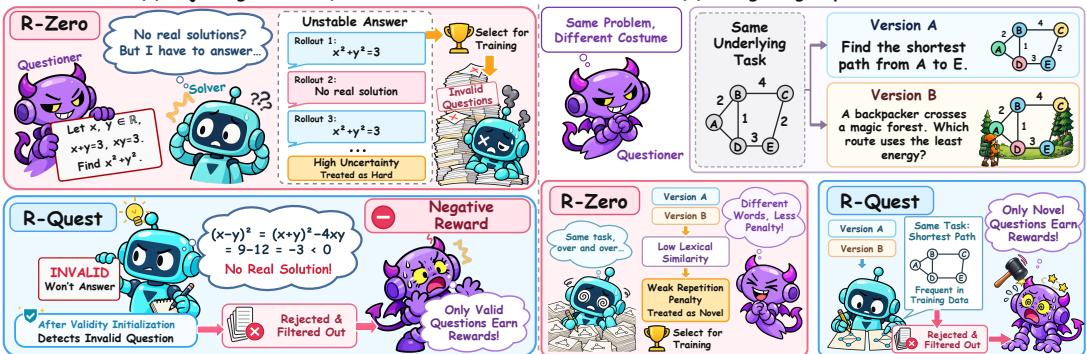
自进化推理模型从自身生成的问题中学习,但反复自训练可能导致性能崩溃。本文研究为何性能在连续轮次中下降,以及如何维持自我进化。我们的分析发现自生成问题中存在两个反复出现的质量问题:无效问题以及同一数学问题的重复变体。首先,无效问题在轮次间变得越来越普遍,而答案一致性过滤进一步提高了其在训练数据中的比例。其次,现有基于词汇相似性的问题多样性控制可能漏掉以不同方式表达但数学上等价的问题,这导致后期训练轮次中问题多样性崩溃。基于这些发现,我们提出 R-Quest,利用问题有效性和新颖性反馈来引导自我进化。我们首先训练求解器识别并拒绝无效问题,然后用其判断来引导提问器奖励并过滤求解器训练数据。为避免问题重复,我们使用冻结的基础模型比较采样的问题对,并提供新颖性反馈。实验上,我们的方法在两个模型家族的数学推理、通用领域推理和代码生成共 12 个基准上持续取得最高平均性能。此外,R-Quest 在十轮自我进化中保持稳定的性能提升,在最后一轮达到峰值,并以 17.32 分超过 R-Zero。
一句话总结
来自圣路易斯华盛顿大学和密歇根大学的研究者提出了 R-Quest,该方法利用有效性和新颖性反馈,通过拒绝无效问题并检测数学等价重复问题来维持推理模型的自进化,在 12 个数学、通用领域和代码生成基准上取得了最高平均性能,并比 R-Zero 高出 17.32 分。
核心贡献
- 一项实证分析识别出无效问题和数学等价重复问题是自进化推理模型中反复出现的两个瓶颈,并表明无效问题会随着轮次增加而增多,答案一致性过滤会进一步提高它们在训练数据中的比例。
- R-Quest 训练求解器识别并拒绝无效问题,利用求解器的有效性判断来指导提问者奖励并过滤求解器训练数据,并通过将采样问题对与冻结基础模型进行比较来提供任务级新颖性反馈。
- 在两个模型家族以及数学推理、通用领域推理和代码生成共 12 个基准上,R-Quest 取得了最高平均性能;它还在 Qwen3-4B-Base 上十轮自进化中持续保持收益,在最后一轮达到峰值,并比 R-Zero 高出 17.32 分。
引言
通过生成并求解自身训练任务来学习的自进化推理模型可以减少对人类策划数据的依赖,但 R-Zero 等先前的提问者-求解器框架往往会丢失早期收益并最终崩溃。作者识别出自我生成问题中的两个瓶颈:缺失或矛盾条件的无效问题,以及绕过词汇重复惩罚的同一数学任务的表面重复。为此,作者提出 R-Quest,训练求解器拒绝无效问题,并利用有效性和任务级新颖性反馈来约束提问者的难度奖励。R-Quest 在两个模型家族和 12 个基准上持续十轮改进,无需在自进化过程中使用更强的外部模型,且性能优于 R-Zero。
数据集
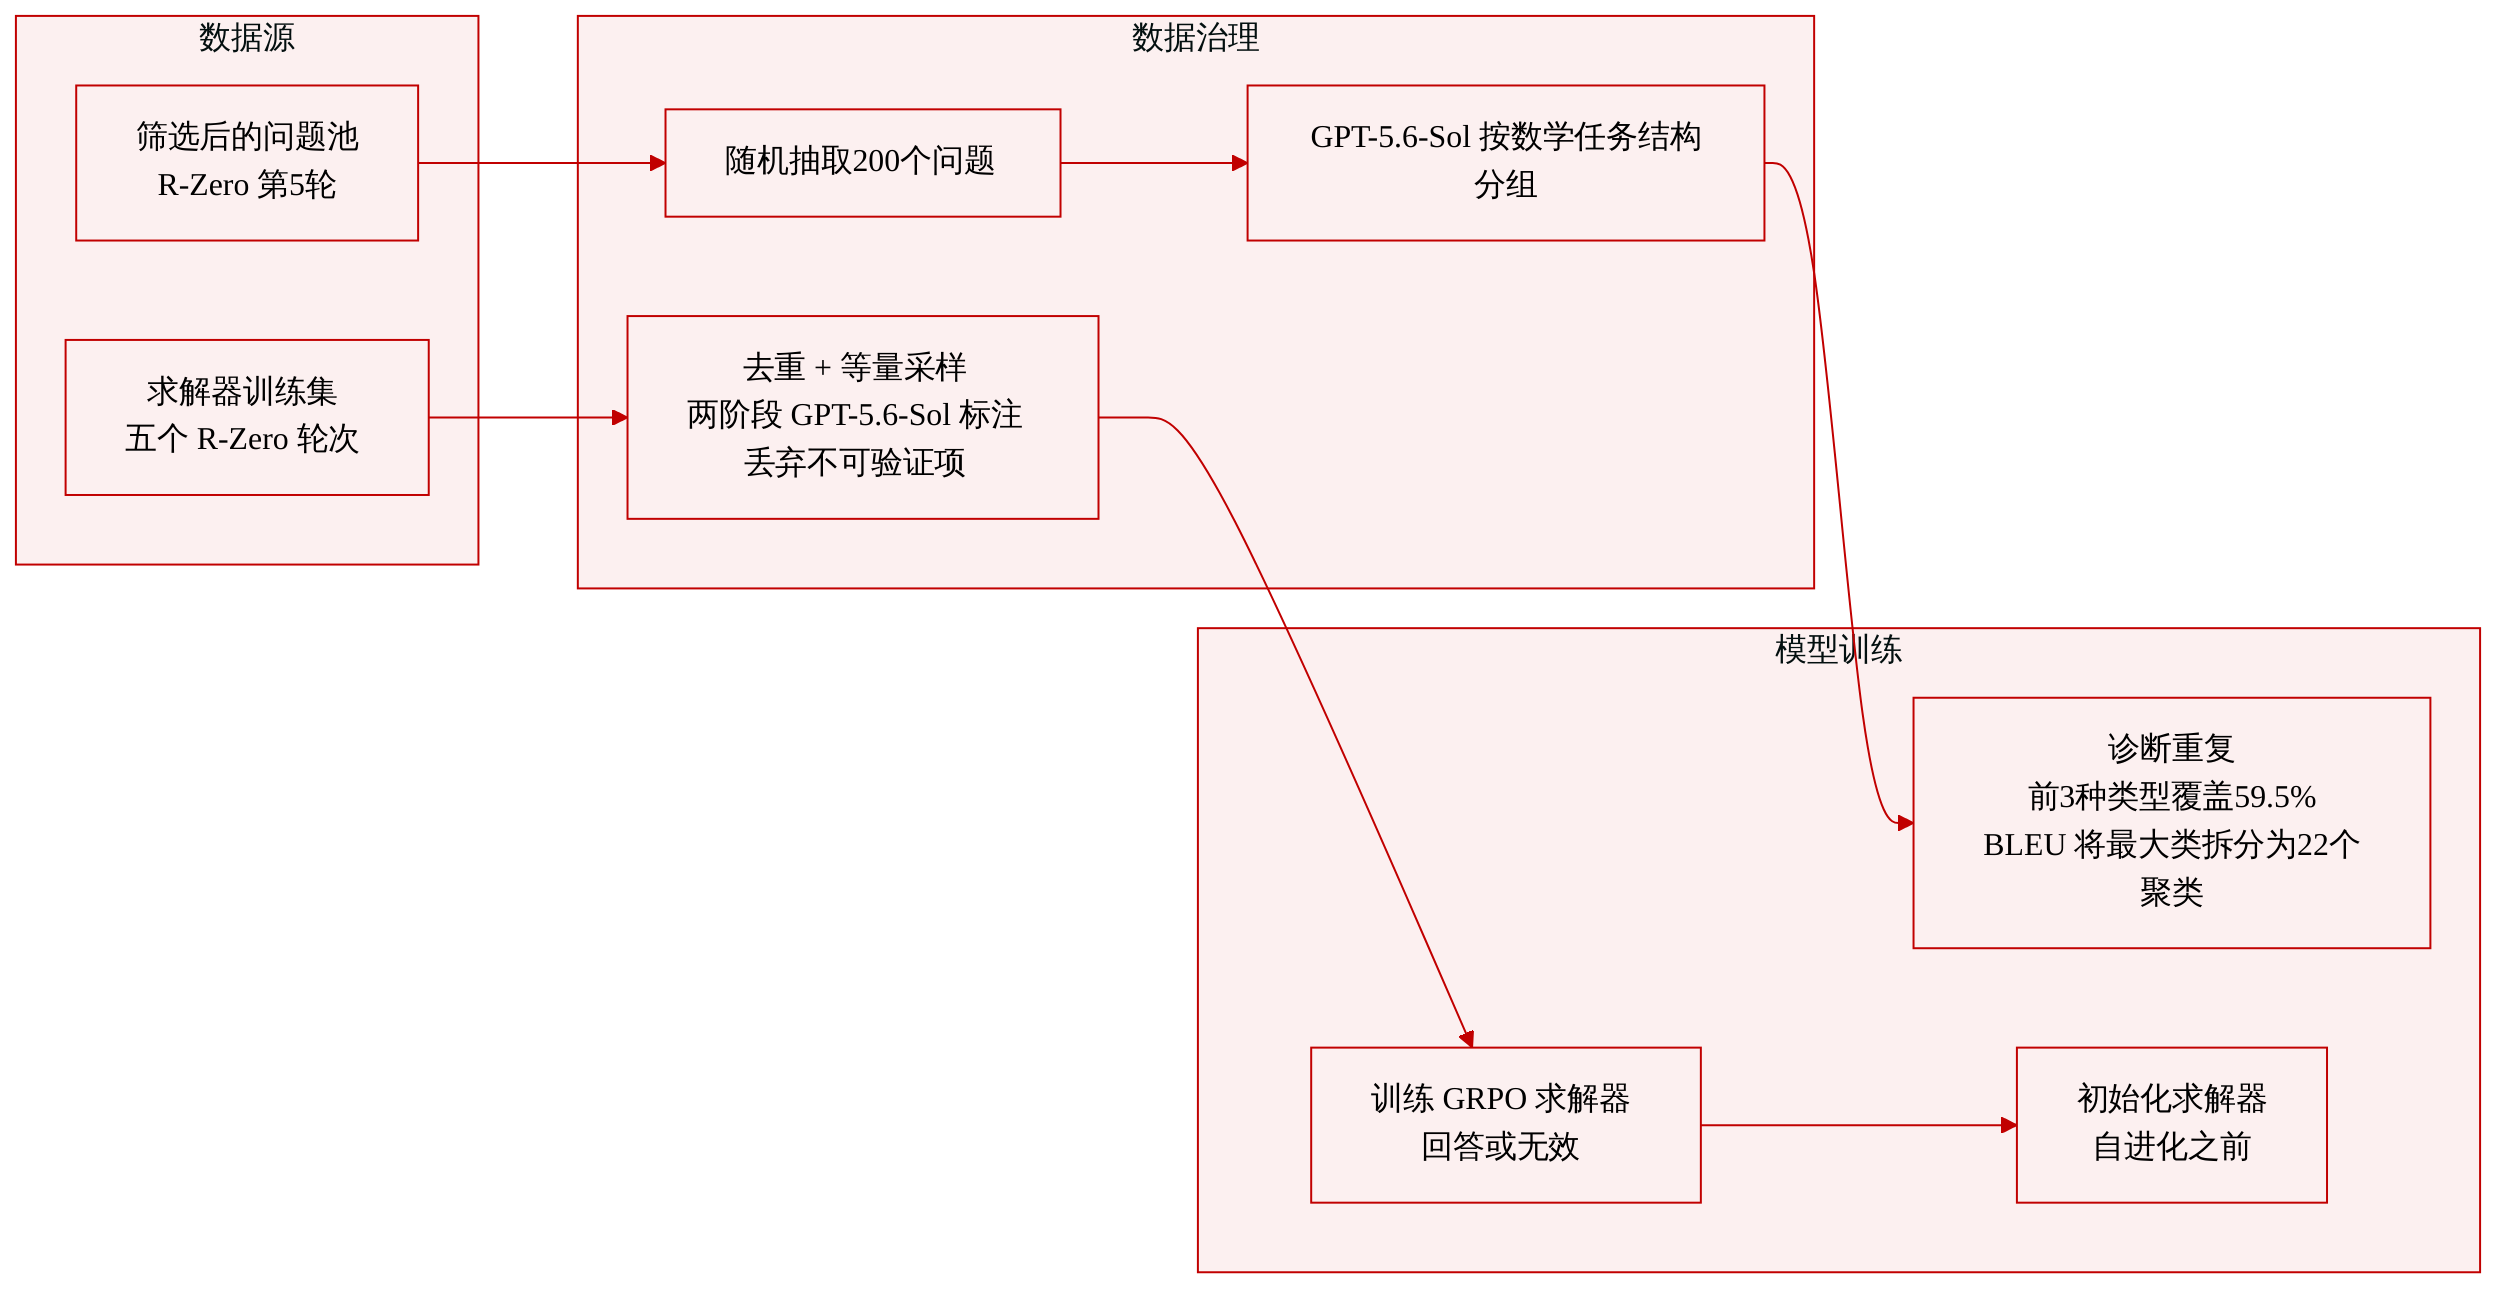
本文使用两个数据集组件:诊断性生成问题样本和有效性感知求解器初始化集。
-
诊断性重复样本
- 来源: 来自 R-Zero 第五轮生成的过滤后问题池。
- 构成: 随机采样 200 个问题。
- 处理方式: GPT-5.6-Sol 按照底层数学任务结构对问题分组,以识别重复问题类型。分组方案见附录 B.3。
- 统计: 最大的三个问题类型占样本的 59.5%。在基于 BLEU 的聚类下,最大的问题类型被拆分为 22 个簇,表明词汇聚类可能将结构相同的问题切碎。
- 用途: 诊断自进化中的重复问题,并支撑基于任务结构而非表面相似性来评估重复问题。
-
有效性感知初始化数据集
- 来源: 来自五次 R-Zero 迭代的求解器训练集。
- 构成: 去重后的问题,每次迭代随机采样相同数量。
- 处理方式: 使用 GPT-5.6-Sol 进行两阶段标注:首先,标注器尝试求解每个问题并判断其是否有效;其次,仅对有效问题进行求解以生成参考答案。无法可靠验证答案的样本被丢弃。
- 模式: 有效问题具有参考答案;无效问题被标记为无效。
- 用途: 用 GRPO 训练基础模型,使其对有效问题作答,或对无效问题返回 INVALID。奖励对正确答案给予正奖励,并对拒绝有效问题进行惩罚,惩罚强度由惩罚系数控制。所得模型用作自进化前的初始化求解器。
方法
作者提出了 R-Quest,一个旨在通过解决无效问题和重复任务引起的性能崩溃来维持推理模型自进化的框架。系统引入了两种核心反馈机制:来自专用求解器的有效性反馈,以及来自冻结基础模型的新颖性反馈。这些信号在提问者与求解器角色的交替更新过程中指导强化学习奖励。
如下图所示:
为防止求解器被有缺陷的提示误导,作者实现了有效性感知求解器初始化。该初始化从之前的自进化迭代中构建一个去重问题数据集,并标注有效与无效提示。随后使用分组相对策略优化(GRPO)训练基础模型,使其对有效问题返回数学答案,对无效问题返回显式 INVALID token。训练采用如下奖励函数:
Rinit(q,a)=1[a=a∗(q)]−λ1[a=INVALID∧a∗(q)=INVALID]其中 a∗(q) 是有效问题的参考答案,λ 用于惩罚过度拒绝有效问题。该初始化使求解器能够在主自进化循环开始前显式识别并拒绝有缺陷的问题。
为保持问题多样性并防止生成重复任务变体,作者采用冻结基础模型来评估新颖性。如果两个问题具有相同的数学设置和任务目标,则视为相同问题。尽管对批量大小为 B 的问题进行穷举两两比较会产生 O(B2) 的计算成本,作者通过为每个候选问题均匀采样 K 个参考问题来优化。若候选问题与 K 个参考问题中的任意一个匹配,则被拒绝,从而将复杂度降至 O(BK) 并有效抑制重复任务类型。
在交替自进化过程中,提问者和求解器使用这些集成反馈信号进行更新。对于生成的问题 q,求解器首先评估其有效性。令 u(q) 为求解器回答中返回 INVALID 的比例。有效性门控定义为 gvalid(q)=21−u(q)。若 gvalid(q)<0,该问题被分类为无效。对于有效问题,系统计算不确定性奖励 Runcertainty(q)=min{s(q),1−s(q)},其中 s(q) 是最大答案簇中回答所占比例。最终提问者奖励整合新颖性门控 gnovel(q):
Rquestion(q)={gvalid(q),gnovel(q)Runcertainty(q),gvalid(q)<0,gvalid(q)≥0.提问者使用该奖励结构通过 GRPO 进行更新。随后,更新后的提问者生成新的候选问题,这些问题经过多数投票有效性检查。通过的问题被求解以生成伪标签,并通过答案一致性过滤。求解器随后在这个过滤后的数据集上使用 GRPO 进行更新。关键在于,该训练数据与固定比例的初始有效性感知数据集混合,以确保求解器在持续更新循环中始终保持拒绝无效提示的能力。
实验
实验在数学、通用推理和代码生成基准上将 R-Quest 与基础模型以及 R-Zero、OCNR 和 R-Diverse 等自进化基线进行比较,并采用交替的提问者和求解器训练以及有效性和新颖性反馈。初步研究表明,R-Zero 生成的无效问题越来越多,而在修复后的问题上训练可减少求解器退化,这证实无效监督是性能崩溃的一个因素。主要结果表明,R-Quest 在长期自进化中持续保持收益,而 R-Zero 则逐渐下降;消融实验证实,有效性和新颖性反馈对于稳定改进都必不可少。进一步分析显示,R-Quest 改善了有效性评估,生成更多有效问题并产生更可靠的伪标签,同时限制了重复问题模式的集中,尽管过于严格的多样性控制可能抑制有用的高难度变体。
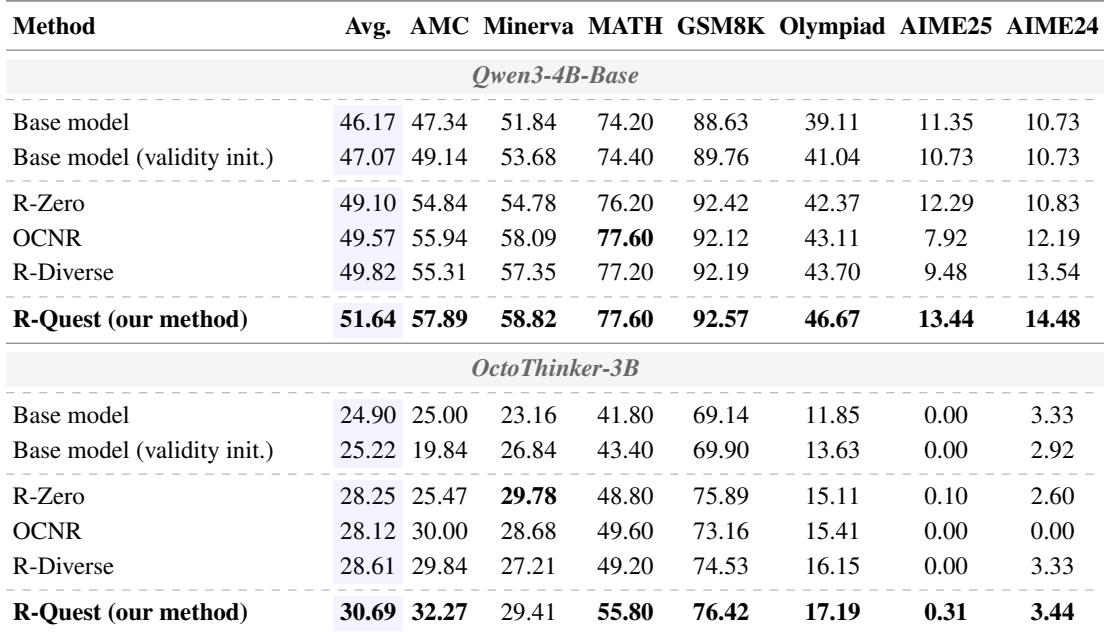
R-Quest 在两个被评估骨干模型上的七个数学推理基准中取得了最高平均性能,超过 R-Zero、OCNR 和 R-Diverse。仅使用有效性感知初始化得到的分数接近基础模型,而大部分收益出现在随后的自进化阶段。在更长周期的自进化中,R-Quest 在十轮内保持优势,而 R-Zero 下降至低于其基础模型。对两个骨干模型而言,R-Quest 在全部七个数学推理基准上取得了最高平均分。其平均得分比基础模型高出 5 分以上,并进一步优于 R-Zero。有效性感知初始化带来接近基础模型的性能,说明后期自进化贡献了最终收益的主要部分。在扩展训练中,每个 R-Quest 检查点都超过 R-Zero 的最佳得分,而 R-Zero 最终降至基础模型以下。
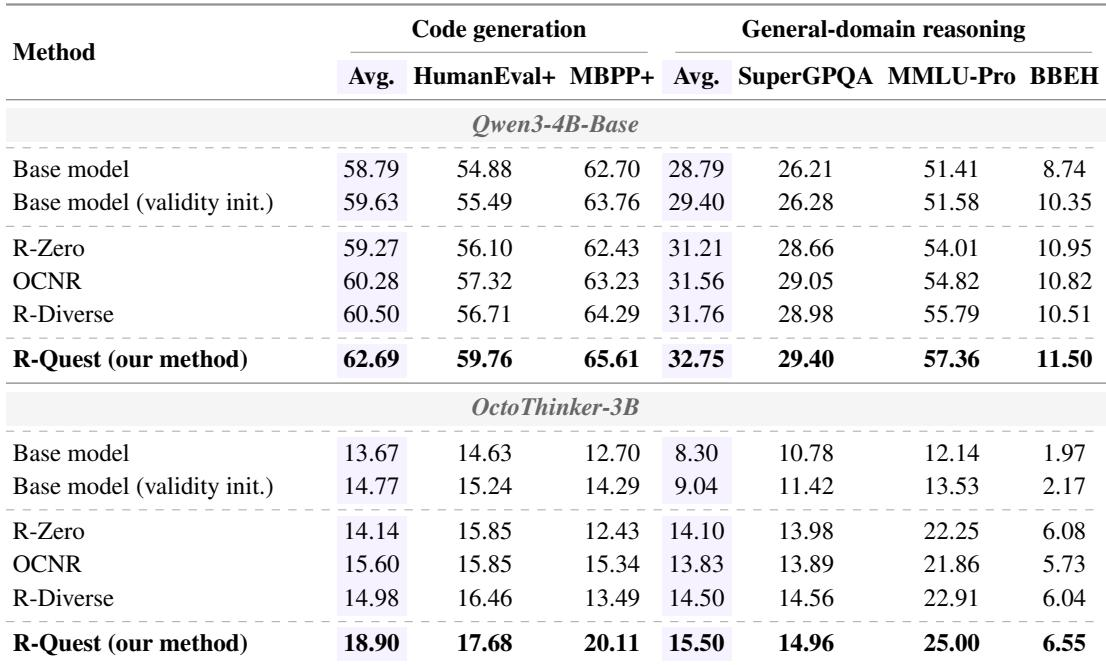
以数学为重点的自进化可迁移到代码生成和通用领域推理。实验报告显示,R-Quest 在两个测试骨干模型上提高了相对于基础模型的平均代码生成性能;在 Qwen3-4B-Base 上,列出的所有变体都将通用领域推理提升到基础模型以上。在所列的 Qwen3-4B-Base 基线中,R-Diverse 取得最高的代码生成平均分,而 OCNR 和 R-Diverse 在通用领域推理上领先。有效性感知初始化仅比基础模型带来小幅提升,而随后的自进化基线则表现出更明显的广泛推理收益。
完整的 R-Quest 配置在 Qwen3-4B-Base 上的数学、代码和通用领域均取得最高分。移除新颖性或有效性反馈会降低三个领域的表现,同时移除两种反馈信号得到最差的整体结果。冻结的有效性判断器也不如完整设置,这进一步证明了持续有效性训练的好处。完整的 R-Quest 变体在数学、代码和通用领域上均优于所有消融变体。单独移除新颖性或有效性反馈会降低每个领域的得分,同时移除两者会造成更大的综合损失。使用冻结的有效性判断器在三个领域上均不如完整 R-Quest 配置。
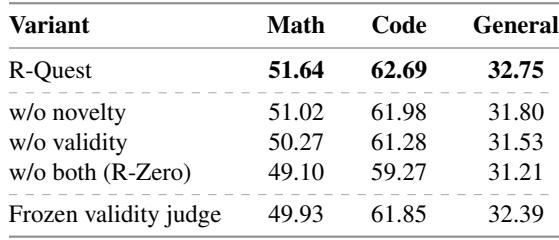
R-Quest 在两个骨干模型的七个数学推理基准上进行了评估,其中仅使用有效性感知初始化即可获得接近基础模型的性能,随后的自进化贡献了大部分改进,并在扩展轮次中持续保持收益,而 R-Zero 降至其基础模型以下。该方法还可迁移到代码生成和通用领域推理,在两个测试骨干模型上提高了相对于基础模型的平均性能。消融研究表明,移除新颖性或有效性反馈会降低数学、代码和通用领域的表现,冻结的有效性判断器不如完整配置,这证实了两种反馈信号以及持续有效性训练共同带来了最强的整体结果。