Command Palette
Search for a command to run...
ALODLM:自适应循环扩散语言模型
ALODLM:自适应循环扩散语言模型
摘要
扩散语言模型(DLM)通过并行预测多个 token 实现快速生成,但与同等规模的自回归(AR)模型相比,其实际应用仍受持续存在的质量差距阻碍。我们将这一差距归因于计算量与难度不匹配:在部分观测序列中,有些未知 token 容易预测,而另一些则需要大量额外计算才能确定。然而,现有 DLM 在每个去噪步骤中对每个未知位置施加相同的计算深度。我们提出 ALoDLM,以逐 token 自适应的潜空间循环取代这种均匀计算。在每个去噪步骤中,ALoDLM 在潜空间中迭代优化表示,并根据 token 难度分配计算。准备确定的 token 会作为离散上下文反馈,而尚未解决的 token 则保留并优化其潜状态,通过额外的循环传递继续处理。为了端到端地学习 token 预测和计算分配,我们将逐 token 的计算调度建模为潜变量,并推导出条件负证据下界(NELBO)。我们在 1.7B 和 8B 参数规模上训练 ALoDLM。在 11 个基准上,ALoDLM 在两个规模上的平均基准得分均超过所有被评估的 DLM 以及对应的 AR 基线。重要的是,ALoDLM 将更优的生成质量与快速并行解码相结合,在优化推理引擎下,在所有被评估的自回归模型和扩散模型中形成了较强的质量-效率权衡。
一句话总结
伊利诺伊大学芝加哥分校、Amazon AGI 和高丽大学提出 ALoDLM,这是一种扩散语言模型,它使用 token 自适应潜在循环和按 token 的计算调度,并将调度形式化为潜在变量,结合条件负证据下界(NELBO)按 token 难度分配计算;在 1.7B 和 8B 参数规模下训练后,该模型在 11 个基准上超过所有被评估的扩散语言模型和相应的自回归(AR)基线,同时支持快速并行解码。
核心贡献
- 为扩散语言模型引入一种 token 自适应循环架构,用动态潜在循环替代统一的去噪深度,使简单 tokens 提前提交为离散上下文,而困难 tokens 继续通过额外的循环传递细化其潜在状态。
- 将按 token 的计算调度形式化为潜在变量,并推导条件负证据下界,以联合优化 token 预测和计算分配,同时使用无偏单轨迹梯度估计器和方差缩减技术提高训练稳定性。
- 将 ALoDLM 扩展到 1.7B 和 8B 参数规模,并在 11 个基准上进行评估。ALoDLM 在两个规模上的平均基准分数均高于所有被评估的扩散语言模型和相应的 Qwen3 自回归基线,并且 ALoDLM-8B 在 GSM8K 上达到与 vLLM 服务的 Qwen3-8B 相当的准确率,吞吐量约为其 2.7 倍。
引言
自回归大语言模型生成质量强,但其逐 token 解码造成延迟瓶颈。扩散语言模型可以并行解析多个被掩码的位置,因此生成速度更快,但与同规模自回归模型相比仍存在实际质量差距。先前工作通过块扩散重新引入自回归结构、仅将扩散模型用作自回归验证的起草器,或应用基于置信度的延迟机制但仍从头重新计算被延迟的 tokens,以缩小这一差距。作者将核心问题归结为计算与难度不匹配:标准扩散模型对所有被掩码位置施加相同的固定深度去噪器,在简单 tokens 上浪费计算,而在困难 tokens 上计算不足。作者提出 ALoDLM,一种具有 token 自适应循环深度的循环扩散语言模型,其中简单 tokens 提前提交以提供已解析的上下文,而困难 tokens 持续细化持久潜在状态,并由一个针对潜在逐 token 退出调度的有理论依据的训练目标所支撑。
方法
作者提出 ALoDLM,一类具有 token 自适应循环计算的离散语言模型。该架构将标准 Transformer 划分为三个不同组件:Prelude(包含 token 嵌入层和可选前缀块)、Recurrent Core(由中间 Transformer 块组成)和 Coda(包含剩余后缀块)。有关解码过程的概述,请参见框架图。
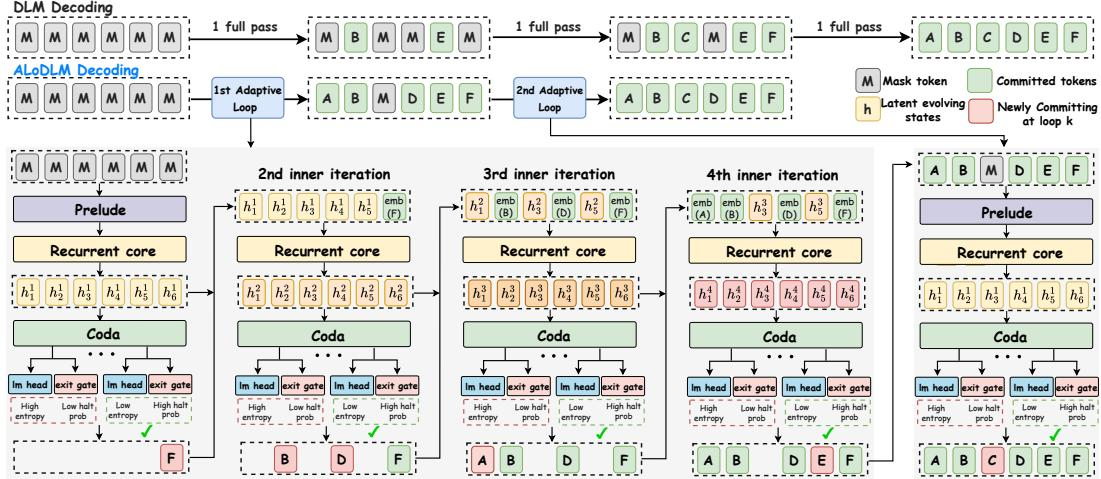
推理时,模型通过一个外部去噪循环和一个内部自适应循环运行。在每个去噪步骤中,被破坏的输入由 Prelude 处理以初始化循环状态。随后 Recurrent Core 和 Coda 通过多次传递更新该状态。在每次循环传递 s 中,中间状态和读出状态按如下方式计算:
h(s)=Recurrent Core(h(s−1)),r(s)=Coda(h(s)),s=1,…,K其中 K 是最大循环深度。读出状态由两个并行头处理。反嵌入头生成词表分布,而额外的 ExitGate 生成一个标量 logit,其 sigmoid 定义每次传递的停止概率。该概率决定一个 token 是提交为离散预测,还是保留其潜在状态以进一步细化。已提交的 tokens 为后续传递提供离散上下文,而未解析的位置则在其累积的潜在状态上继续构建。当所有 tokens 都已提交,或未解析位置上的平均累积停止概率达到预定义阈值时,内部循环终止。
为了训练模型,作者将退出深度视为潜在变量,联合学习去噪器和停止策略。他们将退出调度定义为一个离散随机向量,表示每个被掩码 token 在哪个循环传递中提交。由于对所有可能的退出调度进行边缘化在计算上不可行,作者推导出负证据下界以优化这两个组件。训练目标结合了轨迹损失和 KL 散度项,前者衡量去噪器的预测准确率,后者将学习到的退出分布正则化到截断几何先验。
由于离散退出决策使得无法通过停止策略进行标准反向传播,作者使用评分函数估计器计算无偏梯度。替代损失函数包含轨迹损失和一个去梯度成本项,该成本项为采样得到的调度提供结果信号,鼓励策略倾向于在保持接近先验的同时实现高预测准确率的配置。
为了进一步稳定训练,作者引入了实用的正则化和方差缩减技术。他们放宽联合 KL 惩罚,对小批量上的平均深度分布向几何先验进行正则化,同时对单个 token 深度变化施加较弱惩罚。此外,作者实施中间监督以降低条件梯度方差。如下图所示,该方法有效降低了采样退出轨迹上的相对梯度方差。
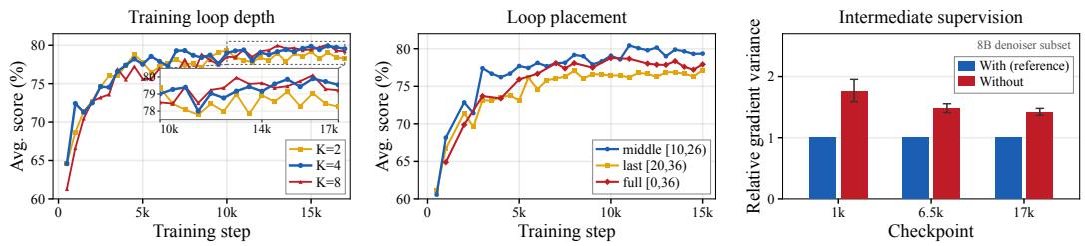
通过复用先前循环传递的预测,并对各深度交叉熵损失取平均,即使某个 token 在较晚深度退出,模型也能为较早传递提供直接学习信号。该机制与基于首轮传递预测成本的控制变量相结合,显著提高了优化过程中去噪器梯度的稳定性。
实验
ALoDLM 在基于 Qwen3 的 1.7B 和 8B 模型上进行评估,涵盖知识、数学和编程基准,采用直接监督微调而非继续预训练,并与自回归和扩散语言模型进行比较。主要性能评估显示,ALoDLM 超过先前的扩散语言模型和强自回归基线,而质量效率实验表明,自适应潜在循环改善了准确率与吞吐量或每 token 计算量之间的权衡。分析和消融进一步验证了通过循环深度实现的测试时扩展、将更多细化分配给数值 tokens 的 token 自适应停止、中间层循环位置,以及中间去噪器监督带来的梯度方差降低。
ALoDLM 在 1.7B 和 8B 两个规模上均持续优于被评估的扩散语言模型,同时平均表现也超过相应的 Qwen3 自回归基线。最大模型在大多数基准上超过最强扩散基线,并在代码生成方面展现出特别广泛的提升。这一结果通过直接监督微调实现,无需若干先前扩散模型所需的继续预训练。ALoDLM 在两个模型规模上均超过所有被评估的扩散语言模型,并在平均表现上小胜 Qwen3 自回归基线。8B 模型在多数任务上领先最强扩散基线,在代码生成基准上提升尤其一致。在适度语料上进行直接监督微调就足以使 ALoDLM 超过依赖继续预训练的基线。
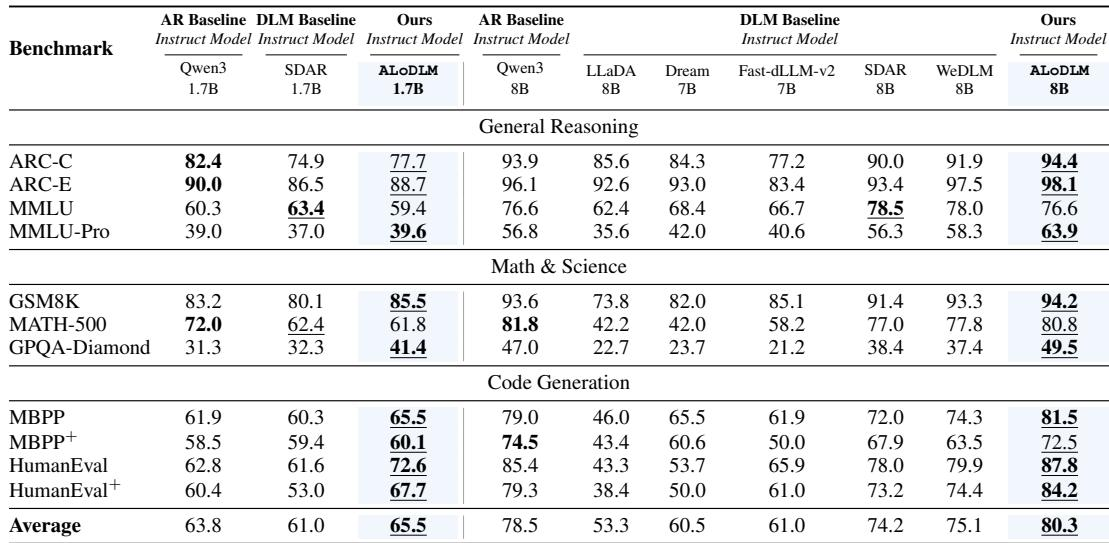
ALoDLM 在 1.7B 和 8B 两个规模上均持续优于所有被评估的扩散语言模型,并在平均表现上小胜 Qwen3 自回归基线。8B 模型在大多数基准上超过最强扩散基线,在代码生成方面提升尤其一致。这些结果通过适度语料上的直接监督微调实现,无需若干先前扩散模型所需的继续预训练。