Command Palette
Search for a command to run...
WING:通过以交互为中心的谱潜在引导进行世界动作学习
WING:通过以交互为中心的谱潜在引导进行世界动作学习
Zhiming Liu Yikun Miao Ying Chen Hongrui Yin Fangqi Zhu Xiaoyi Pang Quanxin Shou Zhengyang Yan Haodong Wang Song Guo
摘要
学习通用机器人策略需要大规模真实世界交互数据,但通过遥操作采集机器人示范仍然成本高昂且难以扩展。自我中心视频提供了丰富的人类交互经验来源,这些经验与机器人操作共享任务相关语义,为在共享潜在动作空间中对齐人类与机器人动作、实现跨具身知识迁移创造了机会。然而,现有潜在动作方法通常通过相邻帧之间的重建来推断动作,这些方法本质上并非以交互为中心,并且可能被自我相机运动等干扰变化所主导。此外,尽管人类交互与机器人动作共享交互语义,它们往往表现出显著不同的时间动态,使得直接迁移到机器人策略具有挑战性。为了解决这些挑战,我们提出了 WING(World Action Learning via INteraction-Centric Spectral Latent Guidance,即通过以交互为中心的谱潜在引导进行世界动作学习),一个将从自我中心视频中提取的交互知识迁移到机器人策略的框架。首先,我们引入了一种交互-运动解耦机制,将交互相关信号与任务无关运动分离,并选择性地将以交互为中心的分量蒸馏到潜在动作中。其次,基于跨具身任务语义主要编码于缓慢变化的时间结构这一观察,我们在谱域中识别自我中心潜在动作与机器人行为之间的共享分量,并在推理时将其用作动作生成的引导。凭借这些设计,WING 在 LIBERO、RoboTwin 2.0 和 RoboCasa–GR1 上分别取得了 99.20%、93.80% 和 57.7% 的平均成功率,同时在多种泛化设置下的四个真实世界任务中表现出强劲性能。这些结果表明,WING 能够有效地从大规模自我中心视频中蒸馏具身交互知识并将其迁移到机器人控制中,为从人类经验中获取物理交互知识提供了一条可扩展的途径。
一句话总结
香港科技大学的研究人员提出了 WING,一个通过将与交互相关的信号从任务无关运动中解耦,并在谱域对齐跨具身潜在动作,将第一人称人类交互知识迁移到机器人策略的框架,在 LIBERO 上达到 99.20%、在 RoboTwin 2.0 上达到 93.80%、在 RoboCasa-GR1 上达到 57.7% 的平均成功率,同时在四个真实世界任务中表现出强劲性能。
核心贡献
- 分析表明,第一人称潜在动作将观察者引起的相机运动与交互相关动态纠缠在一起,而低频潜在时间结构在人类和机器人交互之间具有更一致的对齐。
- 提出了 WING,其结合交互-运动解耦与谱潜在引导:前者将交互相关信号从任务无关运动中分离,后者将共享的低频分量迁移到机器人动作生成中。
- 在仿真中,WING 在 LIBERO 上达到 99.20%、在 RoboTwin 2.0 上达到 93.80%、在 RoboCasa-GR1 上达到 57.7% 的平均成功率;在四个双臂操作任务的真实世界测试中,在标准和多样化泛化设置下均表现出强劲性能。
引言
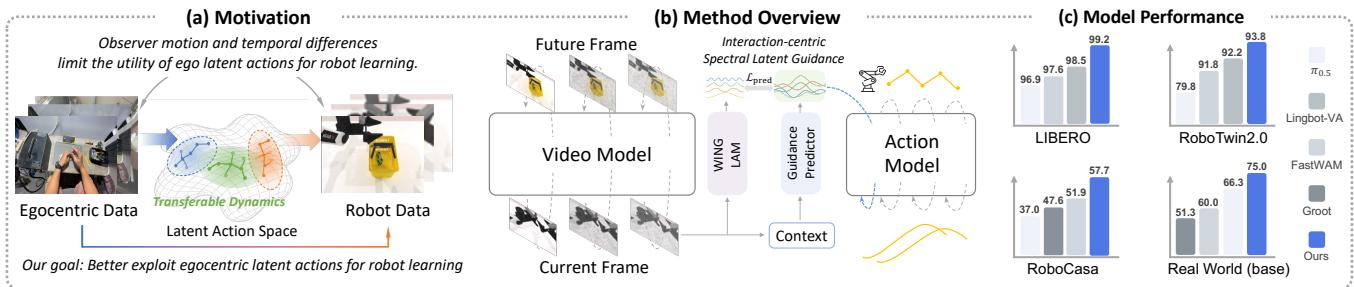
通用机器人策略需要大规模、多样化的操作数据,但通过遥操作收集机器人演示成本高且难以扩展。第一人称人类视频提供了有前景的替代来源,因为它们捕捉到与机器人观察相似的第一人称人物-物体交互,但将其迁移到机器人控制仍很困难。现有潜在动作模型通常通过学习重建未来观察来训练,因此可能吸收与任务无关的观察者运动,无法隔离可在不同具身之间迁移的交互相关动态。作者提出了 WING,该框架通过抑制观察者引起的变化并保留局部交互相关变化来学习以交互为中心的潜在动作,然后使用来自离散余弦变换分量的低频谱潜在引导来条件化机器人动作生成。该方法在仿真和真实世界双臂操作任务上得到验证,性能优于代表性机器人策略和第一人称预训练基线。
方法
作者提出了 WING,一个从大规模第一人称视频中提取结构化交互先验并将其迁移到机器人操作策略的框架。目标策略将语言指令 l、视觉观察 ot 和机器人本体感知 st 映射到可执行动作块 at:t+m。WING 通过两个主要组件迁移知识:WING-LAM,一个以交互为中心的潜在动作模型,以及一个谱潜在引导模块。前者将第一人称视觉变化编码为潜在动作,同时抑制观察者引起的运动;后者从这些潜在动作中蒸馏出缓慢的低频时间结构,作为下游动作生成的引导。
以交互为中心的潜在动作学习
WING-LAM 旨在将手-物交互动态与相机运动分离。由于观察者运动会引起图像范围内一致的变化,而交互运动更局部化,作者利用这一区别构建了显式的运动路由公式。给定两帧 ot 和 ot+δ,离线点跟踪器产生对应点 pt,i 和 pt+δ,i。区域掩码将背景轨迹与手-物交互轨迹分开。利用背景轨迹,估计一个可逆的全局 warp Wt→t+δ 作为观察者运动目标。在补偿该全局 warp 后,残差位移
rt,i=Wt→t+δ−1(pt+δ,i)−pt,i表示无法由观察者运动解释的运动,因此作为交互运动目标。
这些分解后的运动信号为双分支教师提供特权监督。一个分支产生相机潜在变量 zt,camT 并预测全局 warp,另一个分支产生交互潜在变量 zt,intT 并预测残差位移。解码后的运动共同重建第二帧中的被跟踪位置,从而促进观察者运动与交互动态的分解。此外还施加相机干预,以保持交互动态并强制潜在一致性。
由于特权运动线索在部署时不可用,教师交互表示被蒸馏到仅使用 RGB 的学生 Sϕ 中。对于每对帧 (otego,ot+δego),作者通过对第二帧施加类似相机的全局 warp,构造相机扰动视图 o~t+δego。原始帧对和增强帧对共享相同的交互目标 zt,intT,但观察者引起的运动不同。学生编码这两个帧对,得到 ztnat 和 ztaug,并通过
Ldistill=2Di1v∈{nat,aug}∑ztv−zt,intT22+Diλviewztnat−ztaug22.进行优化。第一项迁移教师交互表示,第二项鼓励学生在类似相机的图像 warp 下保持一致。
谱潜在动作引导
尽管 WING-LAM 产生以交互为中心的潜在变量,但语义匹配的人类和机器人执行在时间动态上仍可能不同。为此,谱引导模块作用于潜在轨迹
Zt=[zt,…,zt+H−1]⊤∈RH×Di,其中每个潜在变量都从连续观察中提取。沿时间维度应用正交离散余弦变换,并保留最低的 K 个频率分量作为引导目标 gtlow。这种截断抑制了在不同具身之间不够一致的快速变化分量,同时保留缓慢变化的交互结构。
由于计算 gtlow 需要未来观察,一个轻量预测器 Pψ 从当前语言指令、视觉观察和本体感知(统一记为 ct)中估计该引导。该预测器最小化
gtlow=Pψ(ct),Lpred=KDi1gtlow−gtlowF2.预测得到的引导被投影为 guidance token Ut∈RK×Dhid,其中 Dhid 是动作模型隐藏维度。每个频率系数向量都被投影,经过 LayerNorm 归一化,并获得一个用于标识其频率模式的学习到的嵌入。动作模型通过门控残差更新关注这些 token:
Ha(l)←Ha(l)+γlAttn(Q=LayerNorm(Ha(l)),K=Ut,V=Ut),其中 Ha(l) 是第 l 层的动作隐藏序列,学习得到的标量 γl 控制潜在引导的幅度。这样,机器人动作被条件化在高级谱先验上,而不是完整的人类潜在轨迹上。
训练策略
世界动作模型分两个阶段训练。在第一人称预训练中,作者采用 Wan2.2,训练一个用于未来帧生成的视频专家,同时训练用于低频谱引导预测的引导预测器 Pψ。该阶段通过生成目标和潜在引导预测目标,从第一人称视频中学习视觉和交互动态。
在机器人策略学习中,预训练的视觉骨干和引导预测器被迁移到机器人策略,并与动作专家在机器人演示上联合训练。引导预测器在机器人数据上进行监督,而 WING-LAM 编码器保持冻结。预测的低频引导在训练和推理过程中条件化下游动作生成,使策略能够将第一人称视频中的交互先验与从机器人演示中学习到的具身特定可执行动作结合起来。
实验
评估从表示和策略角度在多个仿真基准和一个真实世界双臂平台上考察 WING。表示实验表明,WING-LAM 抑制了与观察者相关的相机变化,同时保留动作语义,并且低频潜在动态携带了最可迁移的人机交互结构。策略和消融结果表明,将观察者去偏的潜在动作与谱低频引导相结合,可改善单臂、双臂和人形机器人设置下的操作表现,且中等数量的 DCT 分量能取得最佳平衡。预训练分析进一步表明,来自第一人称视频的潜在动作作为辅助谱引导比直接作为动作目标更有效,并且仅接触视频并不能解释这些增益。
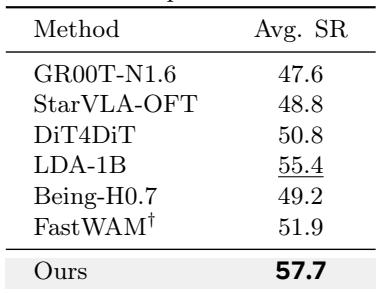
在 RoboCasa-GR1 桌面基准上,所提出的 WING 方法取得了最高的平均成功率,并以小幅优势超过最强的既有基线。大多数其他方法集中在 40 多的高段到 50 多的低段之间,复现的 FastWAM 基线表现低于最优条目。这表明在这一人形机器人操作设置中,WING 相对于先前基线和复现基线具有一致优势。WING 在 RoboCasa-GR1 上以最高平均成功率领先,排在第二位的是 LDA-1B。大多数基线紧密集中在 40 多的高段到 50 多的低段,而前两名方法与其余方法明显拉开差距。
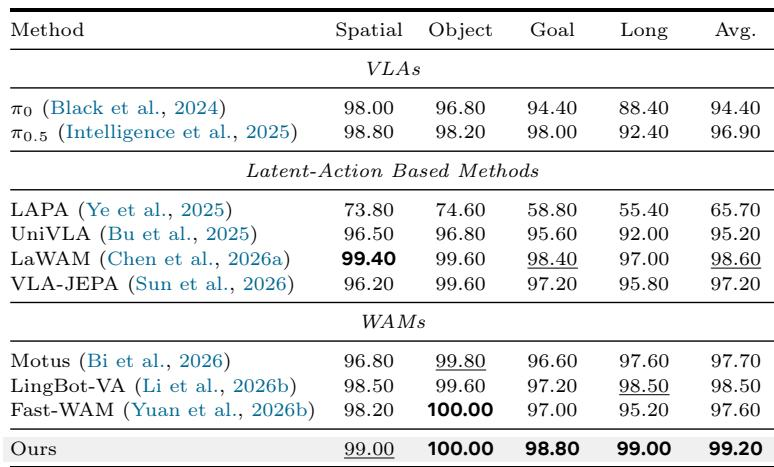
结果表明,WING 在 LIBERO 和 RoboTwin 2.0 上均处于领先地位,在平均成功率上超过最强基线。在 LIBERO 上,WING 超过所有列出的 VLA 方法和潜在动作方法,其中 LaWAM 是最强的列出基线,LAPA 明显落后。报告的优势还扩展到长时程和随机化场景,支持其在干净短时程任务之外的泛化能力。WING 在 LIBERO 和 RoboTwin 2.0 上取得最高平均成功率,领先于 VLA 和潜在动作基线。潜在动作方法表现范围很大,LAPA 明显落后,LaWAM 在其中最强但仍低于 WING。WING 的领先优势在长时程 LIBERO 划分和 RoboTwin 随机化场景中持续存在,表明其在简短干净任务之外具有鲁棒性。
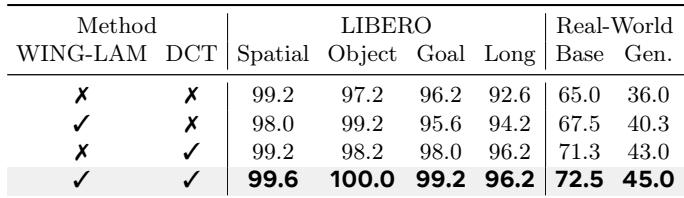
同时包含 WING-LAM 和 DCT 谱引导模块的完整配置在 LIBERO 和真实世界评估中取得了最高的成功率。移除任一组件都会降低性能,其中真实世界设置中的下降最为明显。频域分解和观察者引起变化的减少各自都有助于产生更有用的机器人控制潜在引导。包含 WING-LAM 和 DCT 的完整模型持续取得最高成功率,尤其是在真实世界基础任务和泛化任务中。在保留 DCT 的情况下消融 WING-LAM 会降低真实世界性能,表明观察者去偏的潜在动作改善了控制引导。绕过 DCT 并使用完整时域潜在轨迹会削弱真实世界性能,支持低频谱保留是更有效的引导。同时移除两个组件会带来最低的真实世界成功率,并且性能差距从基础设置到泛化设置逐渐扩大。
实验在人形机器人桌面操作、标准机器人学习基准和消融设置中评估了 WING。WING 在 RoboCasa-GR1、LIBERO 和 RoboTwin 2.0 上取得了最高平均成功率,优于 VLA 和潜在动作基线,并且优势在长时程和随机化场景中得以保持。消融实验表明,将观察者去偏的潜在动作与频域谱引导相结合可产生最强性能,尤其是在真实世界基础任务和泛化任务中,而移除任一组件都会导致明显下降。