Command Palette
Search for a command to run...
面向长视频生成的测试时分布内强制(In-Distribution Forcing)
面向长视频生成的测试时分布内强制(In-Distribution Forcing)
Jeongwoo Shin Youngyoon Choi Sangwoo Jo Hyunmog Kim Sungjoon Choi Joonseok Lee Jaewoong Choi Jaemoo Choi
摘要
现代自回归(AR)视频扩散模型在短时域视频生成方面表现出色,但由于漂移问题——颜色和纹理发生偏移、运动动态逐渐衰减——生成长视频仍然具有挑战性。现有工作主要依赖 KV 条件化,通过选择或修改缓存的键值(KV)项来缓解漂移。然而,我们观察到仅靠 KV 条件化是不够的,因为它假设缓存的 KV 项始终保持分布内。这一假设在超出训练时域后失效:在 rollout 过程中没有任何机制约束 KV 项的构建,从而产生了 KV 来源(KV-provenance)问题,即缓存项本身变得分布外(OOD)。为解决这一问题,我们提出了分布内强制(In-Distribution Forcing,ID-Forcing),这是一个测试时框架,使 KV 缓存和 KV 条件化均与训练配置对齐。其关键机制自缓存(selfcaching)可在源头防止 OOD KV 项的产生。每个块在不关注先前 KV 项的情况下被缓存,从而使滚动窗口完全保持在分布内。因此,ID-Forcing 能够将短时域模型无缝扩展到分钟级视频生成。大量评估表明,我们的方法在标准视频生成基准上保持了竞争力,同时在缓解漂移方面显著优于先前工作;我们的漂移指标和用户研究均验证了这一点。
一句话总结
来自首尔国立大学、高丽大学、成均馆大学和佐治亚理工学院的研究人员提出 In-Distribution Forcing (ID-Forcing),这是一个测试时框架,使 KV 缓存和 KV 条件化都与训练配置对齐,并使用自缓存机制在源头防止分布外的键值条目,优于先前的 KV 条件化方法,可缓解漂移并将短时域视频扩散模型扩展到分钟级生成。
核心贡献
- 本文识别出自回归视频扩散中的 KV 来源问题:在训练时域之外,滚动窗口生成所缓存的键值条目会变为分布外,因此仅靠 KV 条件化无法防止漂移。
- 本文提出一种无需训练的测试时框架 In-Distribution Forcing (ID-Forcing),其自缓存机制在缓存每个块时不关注先前的 KV 条目;在条件化层面,它将窗口长度限制为 L ≤ N−1,并永久固定第一个块 κ0。
- 在不同时长、骨干网络和指标上的评估表明,ID-Forcing 在标准视频生成基准上保持竞争力,并在缓解漂移方面显著优于先前的测试时方法,这通过漂移指标和用户研究得到衡量,包括分钟级生成。
引言
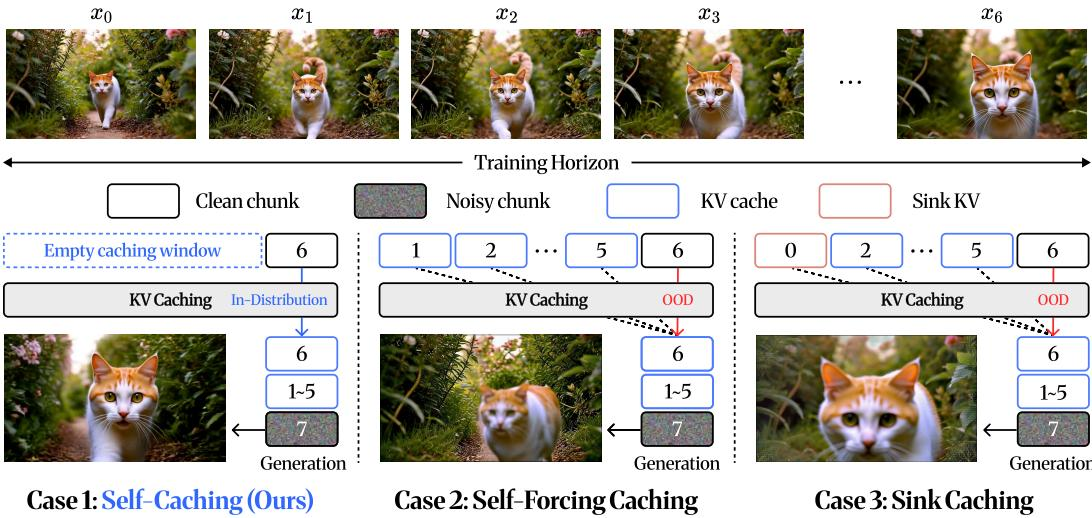
自回归视频扩散通过顺序生成视频块,并将每个块条件化在来自较早块的键值缓存条目上,使长时域合成成为可能,这对流式传输、世界模型和长篇幅叙事很重要。一个关键限制是漂移:在有限的训练时域之外,颜色和纹理会发生偏移,运动会衰减,因为测试时展开进入了训练期间未见过的条件化配置。先前方法大多调整 KV 条件化,例如注意力汇或时间位置嵌入,但它们假设缓存的 KV 条目本身保持在分布内。作者表明这一假设可能不成立,因为每个 KV 条目都建立在其自身关注的上下文之上,称为来源;在训练时域之外,缓存本身使用了未见过的来源。作者的主要贡献是 In-Distribution Forcing,它使用自缓存和有界滚动窗口,使 KV 缓存和 KV 条件化都保持在训练时配置范围内,从而使短时视频模型能够生成漂移更小的分钟级视频。
方法
作者提出 In-Distribution Forcing (ID-Forcing),一种无需训练的框架,旨在将测试时外推严格保持在训练分布内。与先前研究将漂移视为丢弃有信息量的过去上下文的结果并仅修改 KV 条件化不同,ID-Forcing 将漂移视为对训练分布的偏离,这种偏离同时发生在 KV 缓存和 KV 条件化中。因此,该框架对 KV 操作引入两级控制,以防止分布外状态累积。
层面 1:KV 缓存与 KV 来源问题
作者发现,同一个干净块会根据其来源映射到 KV 空间中的不同位置,其中来源指缓存窗口内已有的 KV 条目。当该来源涉及训练时域之外的未见上下文时,得到的 KV 条目会落入分布外,这一现象被称为 KV 来源问题(KV-provenance problem)。
如框架图所示,从分布外来源生成块会导致后续生成继承这一状态,从而引起逐步漂移。为解决该问题,作者引入 Self-Caching,即自缓存,这是一条将每个来源限制为训练期间执行过的配置的规则。对于长度为 L 的条件化窗口,前 ℓ 个条目通过仅关注自身来缓存,记作 E(xj;∅)。其余 L−ℓ 个条目在最后一个自缓存条目的基础上自回归缓存。这确保任何 KV 条目都不会在未见过的上下文下被写入,使来源在整个外推过程中严格保持在分布内。缓存规则形式化为:
κj={E(xj;∅),E(xj;κi−L+ℓ−1:j−1),i−L≤j<i−L+ℓ,i−L+ℓ≤j≤i−1.层面 2:KV 条件化与精确滚动窗口
虽然 Self-Caching 确保已存储的 KV 条目处于分布内,但作者指出,读取这些条目的方式也必须与训练一致。他们通过将第一个块视为持久条件并启用精确滚动窗口来处理 KV 条件化。
在训练期间,每次生成都以第一个块的 KV 条目 κ0 为条件。由于因果 3D-VAE 从单个像素帧编码初始潜变量帧,κ0 在分布上是唯一且不可替代的。在外推期间逐出它本身就属于分布外。因此,ID-Forcing 将 κ0 保留在槽位 0 作为持久汇,这与标准注意力汇不同,后者为了经验稳定性而保留多个早期条目。
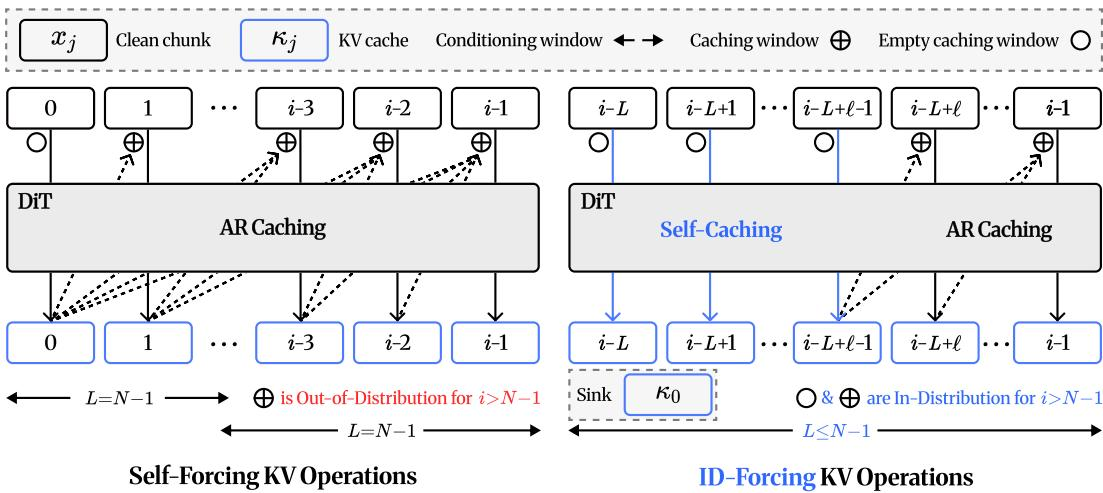
如下图所示,条件化窗口被限制为长度 L<N,在槽位 0 保留 κ0,其余槽位存放最近 L−1 个 KV 条目。这使总窗口大小严格限制在训练预算内。每次生成一个块后,最旧的非汇 KV 条目被逐出,剩余条目通过 R−f 重新旋转,而 κ0 保持固定。条件化规则表示为:
{κ0}∪{κi−L+1,…,κi−1}←{κ0}∪R−f[{κi−L+1,…,κi−1}].由于 Self-Caching 确保每个缓存的 KV 条目在逐出期间不会丢失外部来源,该滚动窗口严格保持分布内,与训练期间观察到的时间距离一致。
实验
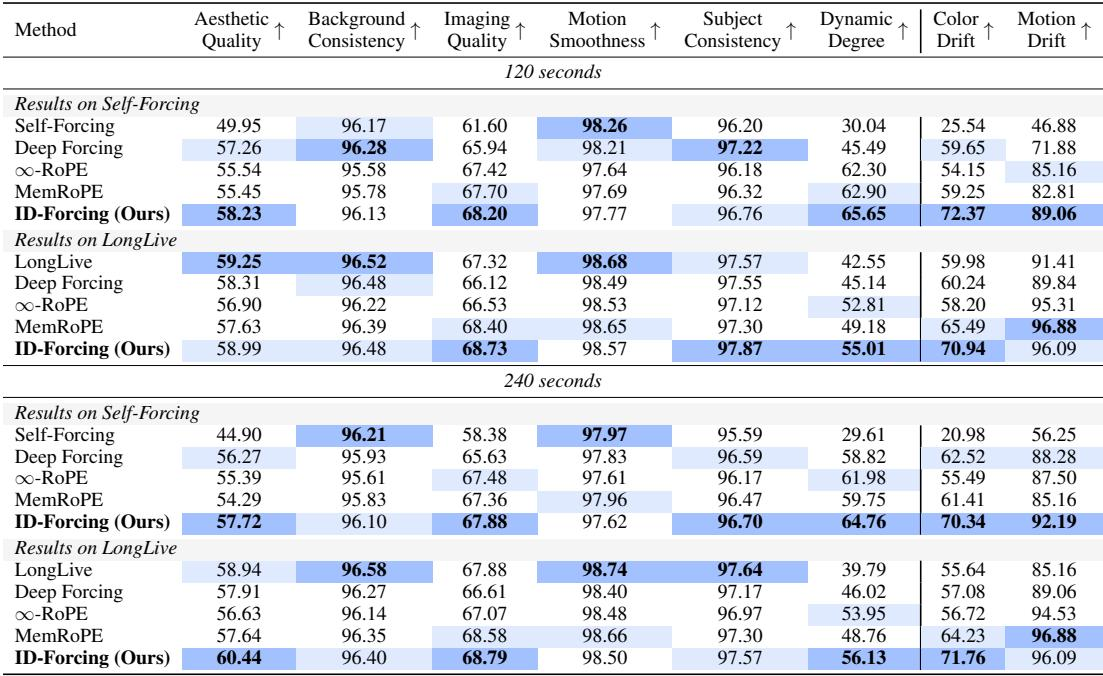
在 Self-Forcing 和 LongLive 基础模型上,对 ID-Forcing 进行超出训练时域的分钟级视频生成评估,使用 120 秒和 240 秒视频,并与 Deep Forcing、∞-RoPE 和 MemRoPE 进行比较,采用自动化漂移指标和用户研究。主要结果表明,ID-Forcing 减少了颜色和运动漂移,同时保持了主体一致性、视觉质量和动态运动,定性比较证实其避免了基线中出现的坍缩和伪影。消融实验验证了自缓存、将第一个块保留为汇以及重新旋转条件化窗口的贡献,表明这些组件共同抑制漂移,并且自缓存对于稳定的长时域生成尤为重要。
在报告设置中,ID-Forcing 在所有比较方法中表现出最强的长持续时间稳定性,具有最高的 Dynamic Degree,并在颜色和运动漂移指标上取得明显改善。它还在 Aesthetic Quality、Imaging Quality 和 Subject Consistency 上保持竞争力,而 Motion Smoothness 较低主要是因为该指标偏向动态较少的输出。定性比较进一步表明,ID-Forcing 在长视频中保持主体身份、颜色保真度和运动。ID-Forcing 在报告设置中取得最高的 Dynamic Degree,而 Self-Forcing 和 LongLive 基线在更长时长下倾向于帧冻结。它还在颜色和运动漂移指标上取得显著提升,并在质量和主体一致性上保持竞争力,Motion Smoothness 是唯一偏向动态较少输出的指标。
在一项成对用户研究中,参与者在每个评估维度上都更偏好 ID-Forcing,超过所有四个基于 Self-Forcing 的基线。与 Self-Forcing 的优势最大,偏好几乎一致,包括总体偏好。与 MemRoPE 相比,最接近的维度是 Dynamic Degree,但 ID-Forcing 仍获得多数偏好。ID-Forcing 在颜色一致性、背景一致性、主体一致性、Dynamic Degree、时间闪烁和总体偏好上均优于每个基线。偏好差距最大的是与 Self-Forcing 的对比,在大多数维度上评分几乎一致,而领先最小的是与 MemRoPE 的 Dynamic Degree 对比。
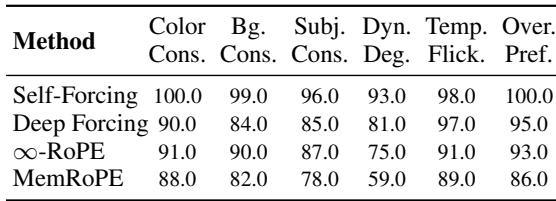
实验在长时视频生成上评估 ID-Forcing 与 Self-Forcing 和 LongLive 基线的对比,采用自动化指标、定性比较和成对用户研究。ID-Forcing 实现了最强的长持续时间稳定性和最高的 Dynamic Degree,在颜色和运动漂移上取得明显改善,同时在质量和主体一致性上保持竞争力;Motion Smoothness 较低主要是因为该指标偏向动态较少的输出。定性结果显示长视频中的主体身份、颜色保真度和运动得以保持。在用户研究中,参与者在每个评估维度上都更偏好 ID-Forcing,超过所有四个基于 Self-Forcing 的基线,包括总体偏好,与 Self-Forcing 相比偏好几乎一致,与 MemRoPE 相比在 Dynamic Degree 上领先最小。