Command Palette
Search for a command to run...
通过递归自重写实现复杂任务轨迹的扩展
通过递归自重写实现复杂任务轨迹的扩展
Zongxia Li Yucheng Shi Zhongzhi Li Junyao Yang Ruhan Wang Chengsong Huang Fuxiao Liu Haitao Mi Jordan Boyd-Graber Leowei Liang
摘要
在困难任务上的成功轨迹是模型改进的宝贵监督信号。不同的执行框架(harness)使同一个模型能够以不同方式解决这些任务。这些成功轨迹为自我改进提供了有用经验,但其中也可能包含控制器干预和工作流约定,而这些在通用执行框架下可能不可用。我们提出递归自重写(RSR)框架,通过递归轨迹自重写将这些经验转化为可复用的模型能力。我们使用单一基座模型 Qwen-3.8-27B,在多种执行框架下发现成功解决方案,并对其进行重写,以便在通用执行框架下学习。RSR 包含一个规划器,用于将有用流程提取成运行手册(runbook);一个批评器,用于筛查验证器泄漏和答案泄漏、拒绝候选,并根据批评反馈递归地重新生成;以及一个执行器,用于在全新沙箱中按照合格的运行手册在通用执行框架下解决每个任务。我们表明,使用三种执行框架扩大了 Qwen-3.8-27B 可解决的任务领域范围,并产生更有价值的成功轨迹;借助 RSR,我们进一步将这些轨迹重构为更大规模的高质量轨迹集。我们从约 3K 个自构建终端任务中收集经验。在 3K 个任务中,三种执行框架的并集解决了 759 个任务,比记录池中最强的单个执行框架多出 34.3%。我们进一步使用 RSR 重写成功源轨迹,将训练集从 2,001 条高质量轨迹扩展至 11,094 条,用于微调 Qwen-3.8-27B。在这些重写轨迹上训练后,模型优于基座模型和直接轨迹 SFT:pass@3 在 Terminal-Bench 2 上从 57.0% 提升至 74.2%,在 Terminal-Bench 4 上从 1.5% 提升至 9.1%,在我们自构建的 Terminal-Bench Hard 上从 39.0% 提升至 63.0%,在我们的 Software Terminal-Bench 上从 3.0% 提升至 6.0%。在 Long-Horizon Terminal-Bench 上,过程奖励从 0.21 提升至 0.29。
一句话总结
递归自重写(Recursive Self-Rewrite, RSR)由腾讯 HY LLM Frontier、马里兰大学帕克分校等机构的研究者提出。该方法通过规划器、防泄漏审查器和执行器,将来自多种执行框架的成功轨迹递归改写为可复用的运行手册,将 Qwen-3.8-27B 的微调数据从 2,001 条轨迹扩展到 11,094 条,并把 Terminal-Bench 2 的 pass@3 从 57.0% 提升到 74.2%。
核心贡献
- 论文提出递归自重写(Recursive Self-Rewrite, RSR),该框架将来自多种专用执行框架的成功轨迹转换为通用执行框架下经过验证的演示。它由以下部分组成:提取可复用运行手册的规划器,筛除验证器与解答泄漏并递归重新生成被拒绝候选的审查器,以及在全新沙箱中遵循合格运行手册的执行器。
- 研究表明,将多个执行框架用作发现工具可扩大任务覆盖范围:在大约 3,000 个自建终端任务中,三个执行框架的并集解决了 759 个任务,比最强单个执行框架多 34.3%。
- 实验证明,重写这些轨迹将训练集从 2,001 个高质量样本扩展到 11,094 个,并使微调后的 Qwen-3.8-27B 相比基座模型和直接轨迹 SFT 均有提升。在 Terminal-Bench 2 上,pass@3 从 57.0% 提高到 74.2%;在 Terminal-Bench 4 上从 1.5% 提高到 9.1%;在 Terminal-Bench Hard 上从 39.0% 提高到 63.0%;在 Software Terminal-Bench 上从 3.0% 提高到 6.0%;在 Long-Horizon Terminal-Bench 上,过程奖励从 0.21 提高到 0.29。
引言
作者研究 AI agents 在困难终端任务上的自我改进,其表现不仅取决于模型,还取决于执行框架,即控制观测、工具使用、验证、恢复和停止的系统。此前工作表明,专用执行框架可以在不改变模型权重的情况下提高任务成功率,并且不同执行框架解决的任务子集具有互补性。然而,从这些执行框架收集的轨迹会把框架特定的控制器干预、提示、工作流逻辑和停止规则与底层问题求解行为混合在一起。直接在此类数据上训练可能导致模型依赖外部控制模式,而这些模式在推理时的通用执行框架下不可用。为此,作者提出递归自重写(Recursive Self-Rewrite, RSR),利用同一基座模型在规划器、审查器和执行器角色中,将成功的多执行框架轨迹重写为通用执行框架下经过验证的轨迹。这使得模型能够利用自身在框架辅助下获得的经验进行监督微调,并在多个终端任务基准上改进 Qwen-3.8-27B。
数据集
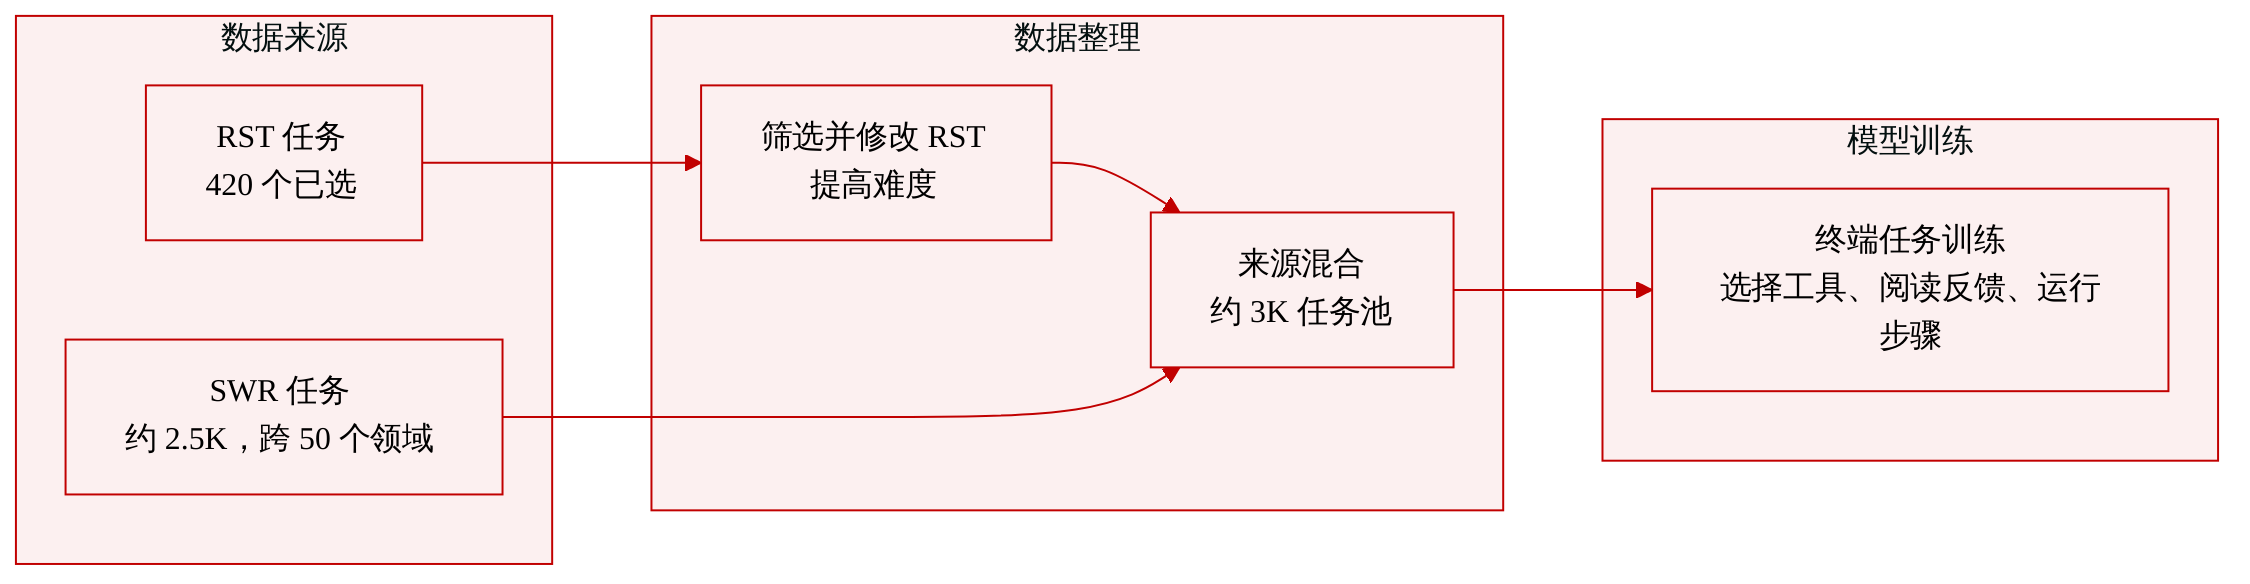
作者对终端任务数据集的描述如下:
- 组成与来源: 训练任务池由两个来源构建。SWR 是自建的约 2,500 个终端任务集合,覆盖 50 个领域。作者还纳入了来自 RST 数据集的 420 个经过筛选和修改的任务。
- 领域覆盖: SWR 涵盖软件使用、生物学、化学、物理学、硬件、运维和安全。
- 规模: 两个来源共同构成约 3,000 个任务的任务池。
- 筛选与修改: RST 子集经过筛选和修改,以增加难度。
- 用途: 该任务池用于终端任务训练,模型需要选择工具、根据环境反馈进行推理,并执行任务特定的流程。
- 其他处理细节: 所提供文本未说明模式、裁剪、元数据构建或混合比例。
方法
作者提出递归自重写(Recursive Self-Rewrite, RSR),该方法旨在通过从多种专用执行框架下发现的成功轨迹中学习,改进模型在通用执行框架下的表现。其核心思想是,不同执行框架可帮助同一基座模型解决不同的困难任务,而这些成功解法可被重写为与单一通用执行框架兼容的演示。整体流程如下图所示。
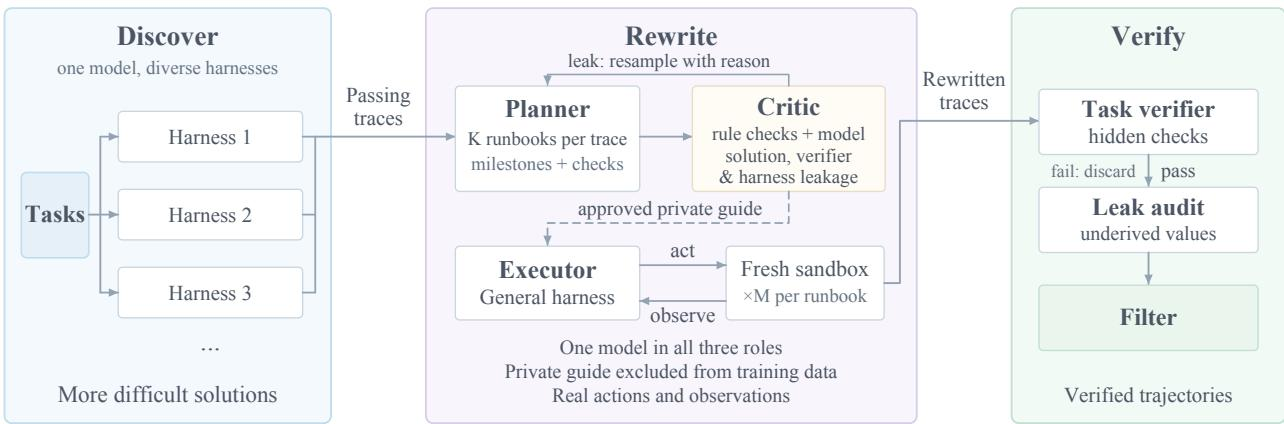
该方法包含三个主要阶段:多执行框架发现、轨迹重写和验证。
多执行框架发现
作者使用多个发现执行框架,它们在执行期间提供控制和支持的方式不同,例如进度跟踪、继续执行、验证、状态管理或失败恢复。由于不同执行框架适用于不同类型的任务,它们扩大了成功解法的范围,超出仅使用单个执行框架时模型能够达到的覆盖范围。基座模型在这些多个发现执行框架下运行,以收集成功轨迹。
用于经验学习的轨迹重写
在不同执行框架下收集的成功轨迹记录了模型如何以不同工作流逻辑解决问题。目标是将这些成功解法转化为模型可在通用执行框架下练习和学习的经验。轨迹重写涉及三种不同的模型角色:规划器、审查器和执行器。
- 规划器: 规划器为每条成功源轨迹重建一份运行手册,提供关于任务如何解决的结构化描述。在规划前,源轨迹会被压缩,保留任务指令、模型动作和环境观测,同时移除框架特定的控制消息。运行手册总结所需最终状态、关键里程碑、有用的检查、恢复策略和常见陷阱。为减少答案直接迁移,运行手册只描述任务、相关接口和验证流程,而不直接给出最终交付结果。每条源轨迹会采样多个候选运行手册。
- 审查器: 模型自身作为审查器,在执行前过滤候选运行手册。首先进行确定性检查,例如模式校验、移除已知伪影以及拒绝不受支持的工具引用。然后,基于模型的审查器只查看公开任务指令和候选运行手册,判断该运行手册是提供了有用流程,还是泄漏了执行器不应获得的信息。只有通过该筛选阶段的运行手册才会被保留用于重写。
- 执行器: 对于每个获批的运行手册,执行器在通用执行框架下的全新沙箱中重新解决任务。运行手册仅作为生成期间的私有指导提供,绝不会写入公开轨迹。因此,执行器必须基于当前环境产生新轨迹,而不是重放源轨迹。
轨迹过滤与验证
模型自身被用来标记轨迹中出现但无法从任务或环境推导出的值,这些值表明存在隐藏答案迁移。包含此类值的演示会被丢弃。用于微调时,仅保留公开交互历史,包括任务指令、环境观测和模型响应,运行手册和审查器对话会被移除。推理时,微调后的模型仅依赖通用执行框架运行,不再使用源执行框架或私有运行手册,从而确保任何规划、检查、恢复或继续执行都来自模型自身。
案例研究示例
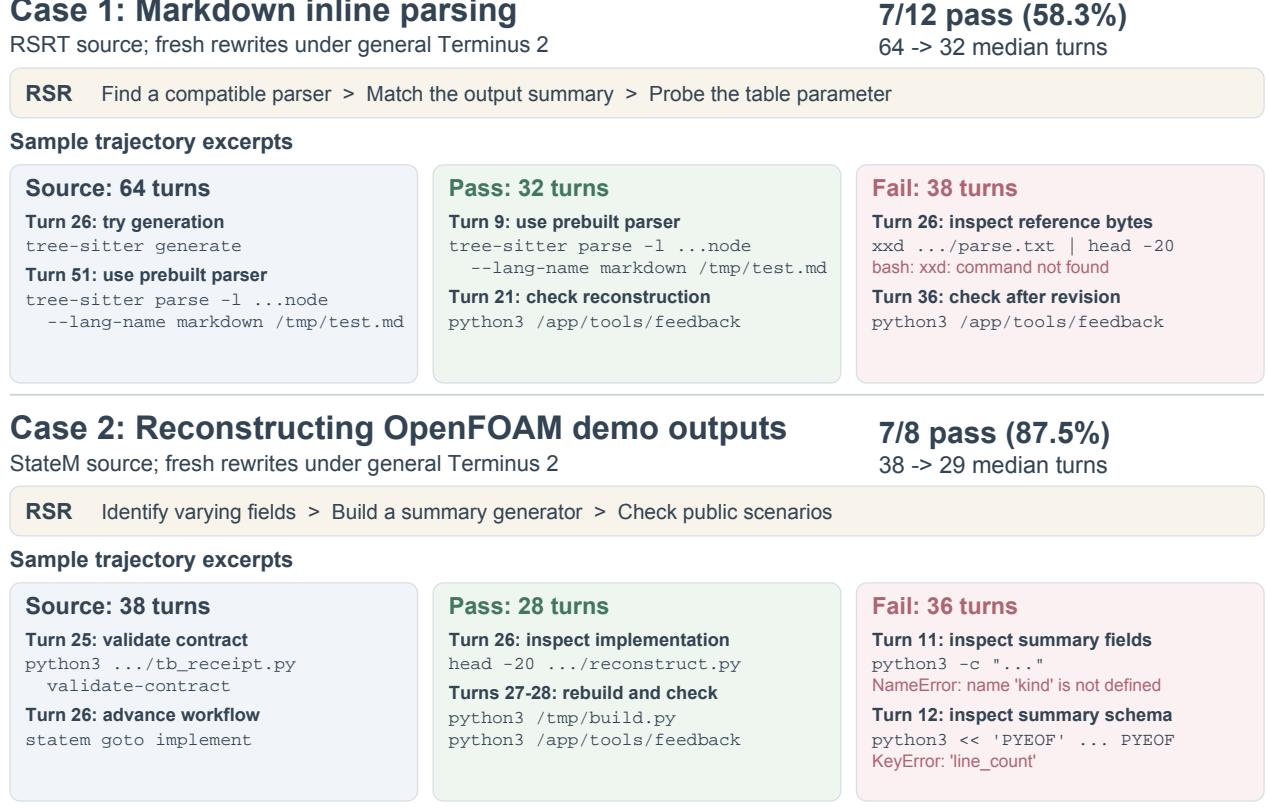
作者检查了重写后的任务,以展示源经验如何在通用执行框架下被转化为新轨迹。如下图所示,示例分别展示了同一运行手册指导下的通过执行和失败执行,并附有源轨迹和两次重写轨迹中的代表性命令摘录。
实验
实验评估了一个自我改进流程:从三个互补的执行框架 Terminus 2、StateM 和 Recursive Self-Reflect Terminus 收集成功的终端任务 rollout,然后将这些经验重构为通用执行框架下的标准化轨迹。结果表明,不同执行框架解锁了不同的问题求解行为,并共同扩大了任务覆盖范围;而直接在源 rollout 上微调带来的增益参差不齐,并可能引入循环失败。通过递归自重写对成功轨迹进行重写,可得到更干净、更易泛化的训练数据,并在基座模型和直接微调基础上进一步提升表现,同时在长时程任务上取得部分额外进展。
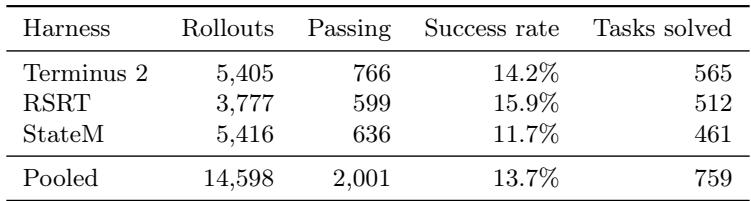
将 Terminus 2、Recursive Self-Reflect Terminus 和 StateM 的 rollout 合并,能扩展已解决任务的覆盖范围,超过任何单个或成对执行框架。三框架并集总体上解决了最多任务,并比最强单个执行框架多出大量任务,在 RST 和 SWR 上均获得相对提升。各执行框架展现出互补优势,领先者在不同基准划分上有所变化。三框架并集获得了最高的总体任务覆盖率,并比最强单个执行框架有约三分之一的相对提升。在各单个执行框架中,Recursive Self-Reflect Terminus 在 RST 上领先,而 Terminus 2 在 SWR 和汇总集合上领先;成对并集始终优于任何单个执行框架。
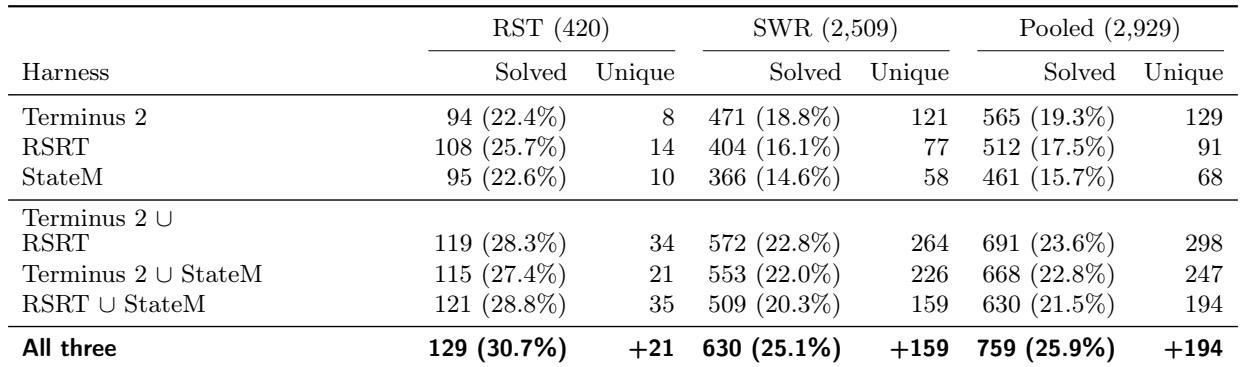
将 Terminus 2、Recursive Self-Reflect Terminus 和 StateM 的 rollout 合并,扩大了发现覆盖范围,超过任何单个执行框架。汇总集合包含 2,001 条成功轨迹,覆盖 759 个不同任务,比最强单个执行框架解决的任务更多。各执行框架的单次 rollout 成功率相近,表明多执行框架汇总主要增加任务覆盖。最强单个执行框架解决 565 个任务,而汇总并集解决 759 个任务,增加了 194 个已解决任务,相对覆盖率提升 34.3%。Recursive Self-Reflect Terminus 的单次 rollout 成功率最高,为 15.9%;StateM 最低,为 11.7%;汇总集合达到 13.7%。
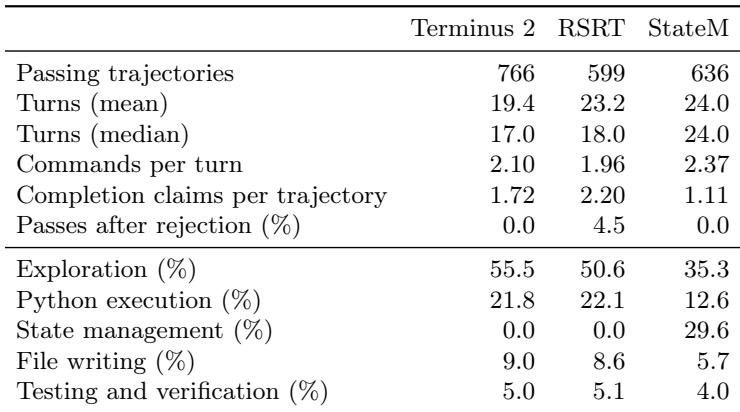
在通过轨迹中,三个执行框架表现出不同的执行风格。Terminus 2 产生更短的轨迹、更多探索导向命令和更多通过 rollout;StateM 产生更长的轨迹、每轮更多命令但探索较少。RSRT 在轨迹长度和探索方面介于两者之间,每条轨迹的完成声明最多,且有一小部分通过发生在被拒绝之后。Terminus 2 拥有最多通过轨迹,并且在三个执行框架中平均轮次和中位轮次最少。StateM 的中位轨迹长度最长,每轮命令数最高,但探索命令占比最低。RSRT 的每条轨迹完成声明最多,并且是唯一具有显著被拒绝后通过比例的执行框架。
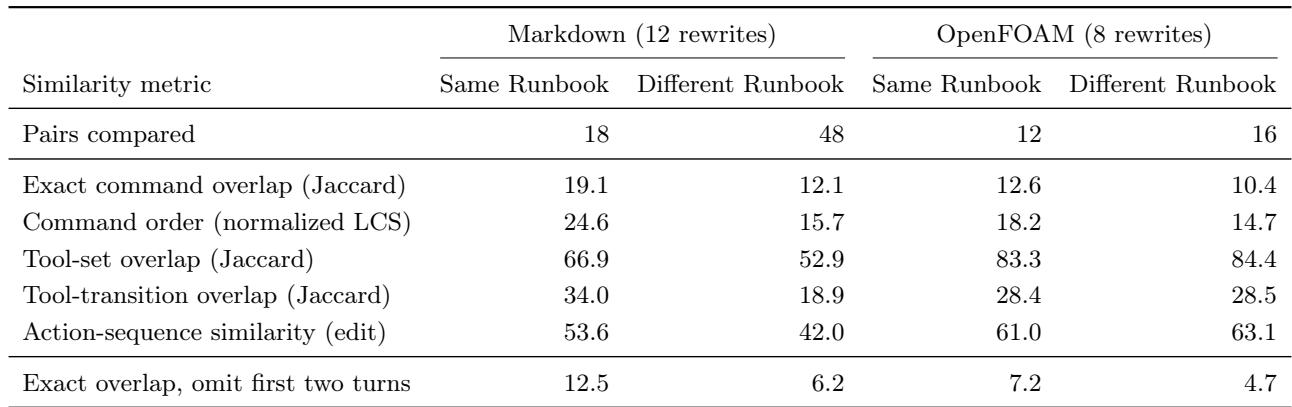
由相同运行手册指导的重写,在命令级行为上往往比使用不同运行手册的重写更相似。这一模式在 Markdown 上更强,而 OpenFOAM 在命令指标上效应较弱。工作流级相似性不太一致,并随任务变化。与不同运行手册对相比,相同运行手册对具有更高的精确命令重叠和命令顺序相似性,其中 Markdown 的差距更明显。工具转换和动作序列相似性在相同运行手册内并不始终更高;OpenFOAM 的工具转换差异很小,而运行手册内动作序列相似性略低。
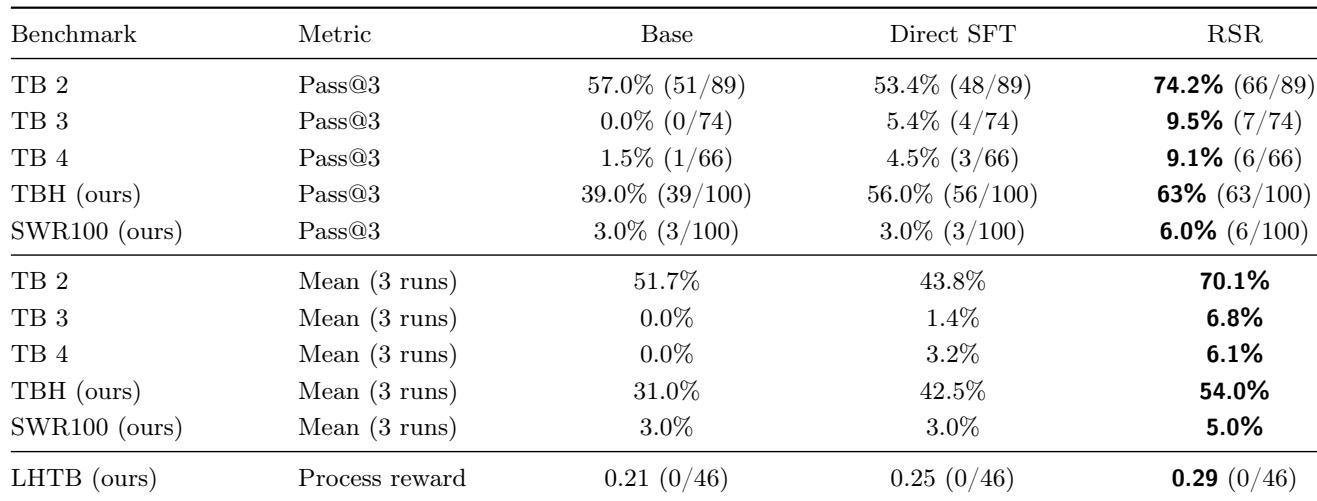
在所报告的基准上,RSR 均优于基座模型和 Direct SFT,具有更高的 pass@3、更高的每次运行平均通过率,以及在 LHTB 上更好的过程奖励。Direct SFT 表现参差不齐,在若干基准上有所提升,但在 TB2 上下降,因为在没有重写的情况下训练可能引入循环行为。结果表明,在通用执行框架下扩展并标准化成功经验可增强泛化能力。RSR 在所有五个报告基准上均取得最高的 pass@3 和每次运行平均通过率。Direct SFT 结果参差不齐,在 TBH、TB3 和 TB4 上优于基座模型,但在 TB2 上下降,并低于其基座每次运行平均通过率。
实验评估了来自 Terminus 2、Recursive Self-Reflect Terminus 和 StateM 的多执行框架 rollout,以及基于运行手册的重写相似性,并比较了 RSR 与基座模型和 Direct SFT 模型。合并三个执行框架带来了互补的任务覆盖和最大的已解决任务集合;各执行框架表现出不同的执行风格,且相同运行手册的重写在命令级上更相似,尤其对 Markdown 而言。RSR 持续优于基座模型和 Direct SFT,而 Direct SFT 在若干基准上有提升,但在其他基准上可能因循环行为而退化。