Command Palette
Search for a command to run...
基于渐进式视觉规划的世界动作建模
基于渐进式视觉规划的世界动作建模
Fei Zhang Zhaochong An Duncan Frost Yikai Wang Pengfei Liu Ya Zhang Michal Drozdzal Amir Bar
摘要
世界动作模型(WAM)已成为机器人控制中一种有前景的范式,其从初始观测和指令出发联合预测未来视觉动态和动作。然而,现有 WAM 在长时程预测方面存在困难,因为生成稠密视频 rollout 的效率很低。一些近期 WAM 通过预测单个未来帧而不生成完整视频来应对这一问题,但这种方法忽略了如何向目标推进。我们提出 ProWAM,一种渐进式世界动作模型,它联合预测动作和有序的稀疏视觉子目标序列,提供显式视觉引导,以在任务执行过程中锚定动作生成。该设计天然具备可扩展性,因为子目标预测可以从大规模无动作视频中学习,使视频主干能够将复杂视觉规划从动作策略中卸载。为实现高效动作生成,ProWAM 仅执行一次视频主干前向传播以缓存稀疏子目标特征,从而避免迭代式完整视频生成,并在重规划期间只需轻量级动作去噪。在大量评估中,ProWAM 展现出优越的分布外鲁棒性。在仿真基准上,它在 LIBERO-Plus(85.8%)和随机化 RoboTwin(75.7%)上取得了新的最优结果,相较最强基线相对提升最高达 +35.9%。在 RoboCasa365 上,ProWAM 达到 48.1% 的成功率,在具有挑战性的 Composite-Unseen 划分上达到 18.2%,总体排名第 4。关键的是,在零样本真实世界实验中,ProWAM 在新场景中取得 70.0% 的成功率,比最强基线高出 +15.0(从 55.0% 提高到 70.0%,相对提升 +27.3%)。这些结果证明了进度索引的视觉预见对闭环控制的价值。
一句话总结
来自上海交通大学、SII、Meta 和帝国理工学院的研究人员提出 ProWAM,一种渐进式世界动作模型,联合预测动作和稀疏视觉子目标,为机器人控制提供明确的视觉引导;该模型利用单次视频骨干前向传播缓存子目标特征,并在重规划期间使用轻量级动作去噪。在多项评估中,它在 LIBERO-Plus(85.8%)和随机化 RoboTwin(75.7%)上取得最先进结果,并达到 70.0% 的真实世界零样本成功率。
核心贡献
- ProWAM 是一种渐进式世界动作模型,联合预测动作和按相对进度索引的有序稀疏视觉子目标序列,将视觉规划与物理控制整合在统一的生成框架中,无需单独的高层规划器。
- ProWAM 通过共享注意力将缓存的子目标特征与动作生成耦合,并使用单次视频骨干前向传播来缓存这些特征,从而消除了迭代式全视频推演,在重规划期间仅需轻量级动作去噪;该架构还支持在大规模无动作视频上预训练,随后进行联合视觉-动作微调。
- 在多项评估中,ProWAM 在 LIBERO-Plus(85.8%)和随机化 RoboTwin(75.7%)上创造了新的最先进结果,在 RoboCasa365 上取得 48.1% 成功率,在 Composite-Unseen 上取得 18.2%,并达到 70.0% 的真实世界零样本成功率,比最强基线高出 15.0 个百分点,即相对提升 27.3%。
引言
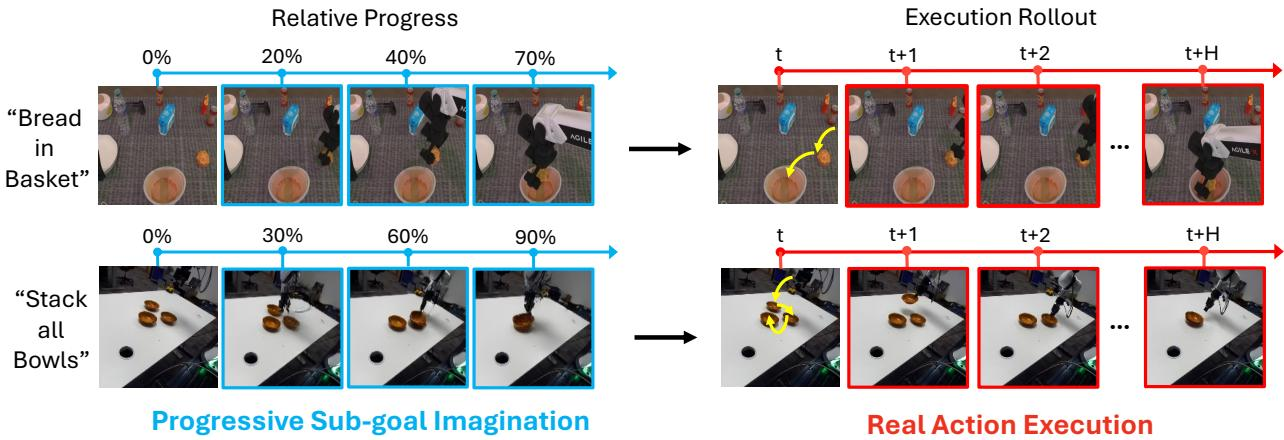
视觉-语言-动作模型继承了有用的语义知识,但由于依赖大规模且成本高昂的机器人演示数据集,仍然需要大量数据。世界动作模型从大规模视频生成中提供了可迁移的视觉动力学先验这一补充来源,但此前设计面临明确权衡:密集未来推演以高计算成本提供短视程引导,而高效的零想象或仅终点方法在较长任务中缺乏明确的中间进度引导。作者提出 ProWAM,一种渐进式世界动作模型,将长视程未来表示为按归一化任务进度索引的有序稀疏视觉子目标序列。ProWAM 将这些以进度为条件的子目标集成到视频生成专家中,并将其耦合到基于轻量扩散的动作专家,从而在不需要密集视频推演或外部规划器的情况下实现高效的闭环控制。
方法
为了使世界动作模型(WAM)具备明确的视觉规划能力,作者提出渐进式世界动作模型(ProWAM),将最终目标预测推广为稀疏子目标的渐进序列。与依赖专用多阶段目标生成模块的经典分层规划器不同,ProWAM 原生地生成整个子目标轨迹,并将这些特征直接注入动作专家。
如下图所示:
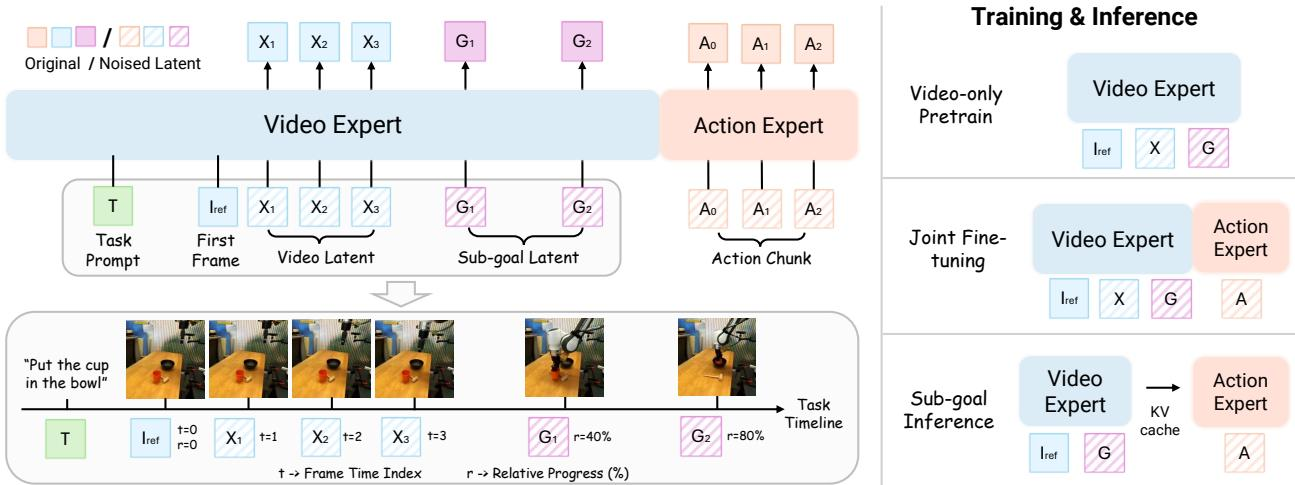
作者使用归一化进度坐标 r∈[0,1] 来参数化中间子目标,该坐标表示从当前观测到其终点的剩余演示轨迹上的相对时间位置。给定 k 个单调递增的进度水平 0<r1<⋯<rk≤1,第 i 个子目标对应于以下位置的帧:
τ(ri)=τ0+⌊ri(τend−τ0)⌉,i=1,…,k,其中 τ0 和 τend 分别表示当前帧索引和演示终点索引。每个被选中的帧独立编码,所得序列涵盖从近期目标到长期目标的选定未来状态。训练期间,子目标数量 k 从均匀分布中采样,以实现灵活的子目标学习策略。
为了直接将这一引导纳入架构,渐进式子目标序列被追加到视频潜变量序列:
Z=current observationX0clip transitionsX1,…,Xf/4−1progressive sub-goalsG1,…,Gk,其中 X 表示视频潜变量帧。训练期间,X0 作为干净观测潜变量,而过渡片段和子目标潜变量遵循流匹配过程。
为了指定每个子目标的目标时间阶段,作者实现了进度条件调制。进度坐标 ri 经正弦嵌入映射,再通过多层感知机,产生自适应 LayerNorm 调制偏移 Δmod(ri)。该偏移直接加到标准流匹配时间步调制上:
mod(Gi)=mod(t)+Δmod(ri).这将每个子目标锚定到其相对于参考观测的对应任务阶段。
在网络架构方面,ProWAM 通过一种 Transformer 混合架构实现视频专家和动作专家,并具有共享注意力头。信息流由结构化可见性掩码控制。子目标槽位在彼此之间以及与参考观测之间进行双向关注,使中间里程碑能够共享视觉特征。过渡潜变量在彼此之间进行双向关注,同时以参考观测和子目标为条件,以保持时间一致性。关键的是,视频专家不关注 action tokens,从而保持与动作无关的视觉前向通路。相反,action tokens 在彼此之间进行双向关注,并交叉关注视觉锚点,将低级动作执行直接锚定在预测的子目标上。
联合策略明确以当前观测所锚定的视觉上下文链为条件。为了共同实现渐进式视觉想象和下游动作控制,ProWAM 通过流匹配训练,并使视频专家和动作专家使用独立时间步。完整目标结合三个速度回归项:
Lfinal=λvideoLvideo+λsubLsub+λactLact,其中前两项监督过渡潜变量和子目标潜变量的流匹配速度预测,第三项训练动作专家预测动作块的速度。
作者在两个不同阶段优化该目标。第一阶段,作者在无动作视频语料库上预训练视频专家,以学习视觉动力学和以进度为条件的子目标预测。第二阶段,作者在机器人演示上联合微调两个专家,将动作执行直接锚定在规划的视觉子目标上。这使 ProWAM 能够利用大规模无动作视频语料库进行可扩展预训练,从而在有限机器人演示上微调时提高样本效率。
为了实现高效推理,作者采用子目标缓存,而不是执行繁重的联合视频-动作去噪。在每次重规划步骤中,视频专家仅评估一次以预测子目标,并缓存其键值特征。随后动作头在整个动作去噪步骤中重用这一固定缓存。收到新观测后,ProWAM 重新计算子目标并刷新缓存,从而显著减少视频专家前向传播次数。
实验
实验在 LIBERO、LIBERO-Plus、RoboTwin、RoboCasa365 和零样本真实机器人任务上评估 ProWAM,比较基础变体与视频预训练变体。仿真结果表明,域内性能接近饱和,零样本泛化更强,其中视频子目标预训练主要提升对视觉域偏移和长视程未见过组合的鲁棒性。真实世界零样本部署证实了无需环境特定微调的直接泛化,失败分析表明生成子目标中与任务相关的几何结构对成功执行至关重要。RoboTwin 上的消融实验表明,缓存的子目标特征可降低计算量和延迟,更近的子目标视程可提高域外鲁棒性,并且生成的子目标尽管存在轻微视觉伪影,仍保留有用的场景结构。
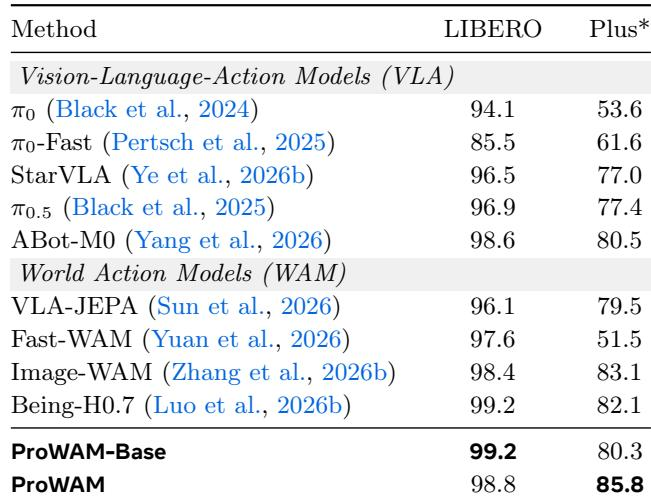
在 LIBERO 基准套件上,所提方法和最强先前模型的域内成功率接近饱和,因此零样本 LIBERO-Plus 设置提供了主要区分信号。ProWAM 在比较方法中取得最高的零样本成功率,超过先前的 VLA 和世界动作模型基线。没有子目标预训练的变体尽管域内性能相当,但零样本性能明显下降,表明子目标预训练有助于分布外泛化。LIBERO 域内性能对所提出的两个变体和强基线都接近饱和,使得 LIBERO-Plus 成为更具信息量的评估。ProWAM 达到新的最先进零样本 LIBERO-Plus 成功率 85.8%,高于先前 VLA 和世界动作模型基线。ProWAM-Base 在零样本任务上比 ProWAM 低 5.5 个百分点,将子目标预训练与更强的分布外鲁棒性联系起来。
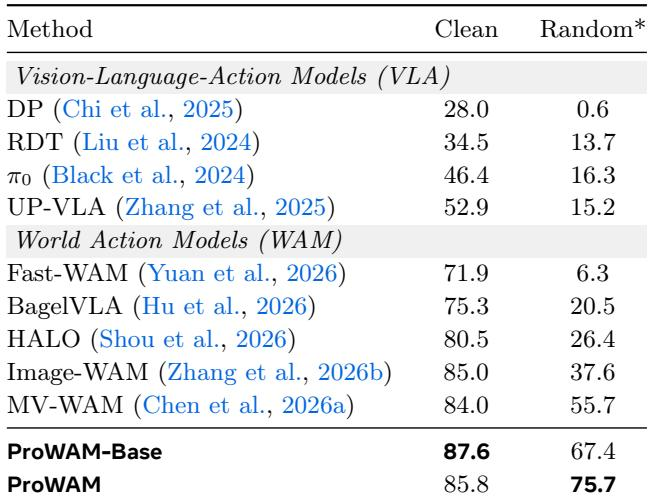
在 RoboTwin 上,ProWAM 取得了已报告的最强干净场景成功率和随机化成功率,在视觉域随机化下相比先前的视觉-语言-动作和世界-动作基线均有大幅提升。先前方法在随机化下性能急剧下降,尤其是 Fast-WAM,从较高的干净场景成功率下降到个位数性能。消融实验表明,视频预训练和近期子目标规划可提高分布外鲁棒性,同时干净场景性能保持稳定。ProWAM 在随机化评估中领先,并大幅超过最强的先前世界-动作模型。视频预训练主要提升对视觉域偏移的鲁棒性,而干净场景成功率保持相当。
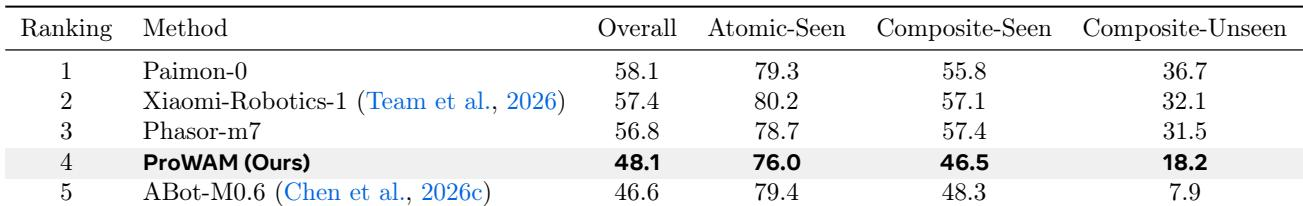
ProWAM 在 RoboCasa365 上达到 48.1% 的整体成功率,位列 ABot-M0.6 之前,但落后于 Paimon-0、Xiaomi-Robotics-1 和 Phasor-m7。其原子已见任务表现仅略低于领先方法,而复合任务,尤其是未见过组合,则差距更大。这表明在较短视程任务上相对表现更强,而在长视程泛化上更困难。ProWAM 在原子已见任务上接近最佳方法,仅落后领先方法几个百分点。在复合未见任务上,ProWAM 超过 ABot-M0.6,但仍远落后于前三个公开方法,其中与 Paimon-0 的差距最大。
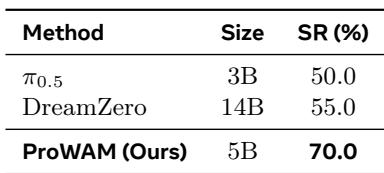
在四项物理任务的真实世界零样本评估中,ProWAM 在比较方法中取得最高平均成功率,明显超过规模更大的 DreamZero 模型。其优势在空间定位放置任务上尤为突出,达到完美成功率,证明了无需环境特定微调的直接泛化。ProWAM 使用的参数少于 DreamZero,但在四项真实世界任务上取得了更高的平均成功率。ProWAM 在空间定位放置上达到完美成功率,超过该任务上的基线。真实世界任务涵盖抓取放置、长视程多物体装配、接触丰富放置和空间定位放置。
在四种评估设置下,ProWAM 分别接受了零样本 LIBERO-Plus 泛化、RoboTwin 视觉域随机化、RoboCasa365 多任务性能以及真实世界零样本操作的测试。它取得了最先进的零样本 LIBERO-Plus 成功率,并在 RoboTwin 随机化测试中表现强劲;消融实验表明,子目标预训练和视频预训练可提高分布外鲁棒性。在 RoboCasa365 上,它在原子已见任务上接近领先水平,但在复合未见任务上落后,表明其短视程能力更强。在真实世界评估中,它以少于基线的参数取得最高平均成功率,并在空间定位放置上达到完美成功率。