Command Palette
Search for a command to run...
OneStreamer:统一流式视频交互中的感知、记忆与主动响应
OneStreamer:统一流式视频交互中的感知、记忆与主动响应
摘要
流式视频 LLM 必须在证据与未来任务的相关性尚不可知时保留证据,并在足够证据可用时作出响应。挑战在于形成可复用的事实记忆,同时不损害实时感知。我们提出 OneStreamer,它通过共享的主动生成过程联合学习与查询无关的证据记录和任务响应。其主动分层描述记忆(Proactive Hierarchical Caption Memory,PHCM)生成具有时间定位的局部细节描述和已完成事件摘要。在训练阶段,流式描述目标监督对已观测视频前缀的解读。在推理时,模型生成的记录补充近期视觉窗口,提供可复用的事实上下文,而无需重新访问历史视觉特征。主动状态转换学习(Proactive State Transition Learning,PSTL)通过在所有输出锚点处保留监督信号,并选择具有代表性的状态变化和状态持续 token,降低重复等待状态的主导性。我们进一步开发了一个流式数据合成流水线,将输出内容和时序与可用证据对齐。将由此生成的流式描述和问答(QA)数据与清洗后的开源数据相结合,得到 OneStreamer-1M,这是一个覆盖广泛、包含超过一百万条记录并跨越多种任务的流式视频交互数据集。我们的 4B 模型在全部八个已评估的流式视频理解基准上,在所比较方法中取得了最佳结果。消融实验表明,保留生成的描述能够提升历史 QA 性能,而不降低实时感知性能。PSTL 在仅监督 27.5% 的已标注状态 token 的情况下,也优于密集状态监督。这些结果共同支持主动生成作为连接流式视频交互中感知、记忆形成和及时响应的共享学习接口。
一句话总结
来自 NJU、PJLAB、JD 及其他相关机构的研究者提出了 OneStreamer,这是一种流式视频交互模型,通过共享的主动生成联合学习与查询无关的证据记录和任务响应,使用 Proactive Hierarchical Caption Memory 和 Proactive State Transition Learning,其 OneStreamer-1M 数据集和 4B 模型在全部八个评估的流式视频理解基准上取得了当前最优结果。
核心贡献
- OneStreamer 通过主动生成联合学习与查询无关的证据记录和任务响应,Proactive Hierarchical Caption Memory 生成时间对齐的局部细节字幕和已完成事件的摘要,以补充近期视觉窗口,而无需重新访问历史视觉特征。
- Proactive State Transition Learning 保留所有输出锚点处的监督,并选择具有代表性的状态变化和状态持续 tokens,以降低重复等待状态的主导影响;它优于密集状态监督,同时仅监督 27.5% 的标注状态 tokens。
- 流式数据合成流水线在内容上和时序上将字幕和 QA 目标与可用证据对齐,产生包含超过一百万条记录的 OneStreamer-1M。所得的 4B 模型在所有八个评估的流式视频理解基准上取得了对比方法中的最佳结果,消融实验显示保留的生成字幕改善了历史 QA,而不会降低实时感知。
引言
流式视频 LLM 在实时辅助、可穿戴 agent 和安全监控中是必需的,这些场景中帧持续到达,只有后续查询才会揭示哪些早期观察是重要的。先前的方法压缩或检索历史视觉 tokens,但这些 tokens 会与当前帧争夺有限的上下文,并可能削弱实时感知。流式推理轨迹不一定是可复用的时间对齐记录,密集状态 token 监督可能相对于稀疏响应决策过度强调静默标签。作者提出了 OneStreamer,这是一种通过主动生成统一证据记录和任务响应的模型。它使用 Proactive Hierarchical Caption Memory 生成时间对齐的局部细节字幕和语义事件摘要,作为与查询无关的事实记录,并使用 Proactive State Transition Learning 在无需密集静默标签的情况下监督响应时机。流式数据合成流水线构建了 OneStreamer-1M,4B 模型在八个在线视频理解和主动响应基准上报告了最佳结果。
数据集
作者通过将合成的流式示例与清理后的开源数据相结合,构建了 OneStreamer-1M。合成流水线有两个分支:流式字幕合成和流式 QA 合成。图 5 总结了该流水线和任务组成。
数据集来源与组成
- 视频来源:通过语义检索、场景检测和视觉丰富度评估构建的精选候选池。
- 标注来源:Gemini 和 Seed 生成带时间戳的字幕和 QA 对;也使用现有数据集中的选定标注。
- 最终数据集:合成的流式字幕示例、合成的流式 QA 示例以及清理后的开源数据。
流式字幕分支
- 过滤掉视觉质量低、长时间静止、黑帧、镜头碎片过多或解码失败的视频。
- 在帧/片段、片段和视频级别生成多粒度字幕。
- 将所有字幕与源视频进行事实和时间一致性校验。
- 丢弃不受支持或时间不对齐的字幕。
- 将验证后的字幕转换为因果流式序列:
- 帧/片段字幕在其支持区间的末尾成为
</Observe>目标。 - 片段字幕在片段边界处成为
</Summary>目标。 - 流结束后,全视频摘要指令使用视频级字幕作为
</Response>之后的答案目标。
- 帧/片段字幕在其支持区间的末尾成为
流式 QA 分支
- 使用经过验证的流式字幕标注以及现有数据集中的选定标注作为元数据来源。
- 定义流式交互的目标能力,然后使用任务特定模板提示 Gemini 和 Seed 生成有依据的问答对。
- 为每个 QA 对定位一个粗略证据区间。
- 通过要求 VLM 仅根据该片段回答来验证该区间。
- 丢弃模型无法生成正确答案的示例。
- 在每个粗略区间内进行细粒度响应时间校准:
- 面向推理的 QA 根据给定视频前缀时参考答案的条件似然进行评分。
- 面向感知的任务根据每个窗口与目标事件之间的视觉文本相似度进行评分。
- 选择满足可靠性标准的最早时间戳,产生定位的证据区间和校准后的响应时间戳。
数据使用方式
- 合成示例与清理后的开源数据结合,形成 OneStreamer-1M。
- 该数据集为流式视频交互提供训练监督,其中字幕、摘要和 QA 响应与已观察到的视频前缀对齐。
- 提供的摘录中未指定确切的子集大小、训练划分比例和混合比例。
方法
作者提出了 OneStreamer,它通过共享的因果生成过程统一与查询无关的证据记录和任务响应。如下图所示,模型将实时视频流按时间顺序片段逐步处理。视觉编码器从每个到达的片段中提取视觉 tokens,投影器将它们映射到 LLM 的嵌入空间。Recent-N FIFO 滑动窗口仅保留与最近观察到的 N 帧对应的视觉 tokens。这些 tokens 与包含累积字幕记录和对话的文本历史交错排列。所得的因果视觉语言序列仅包含当前时刻可用的信息。LLM 从该序列中预测任务特定的控制 tokens,并在预测状态启动输出时生成相应文本。
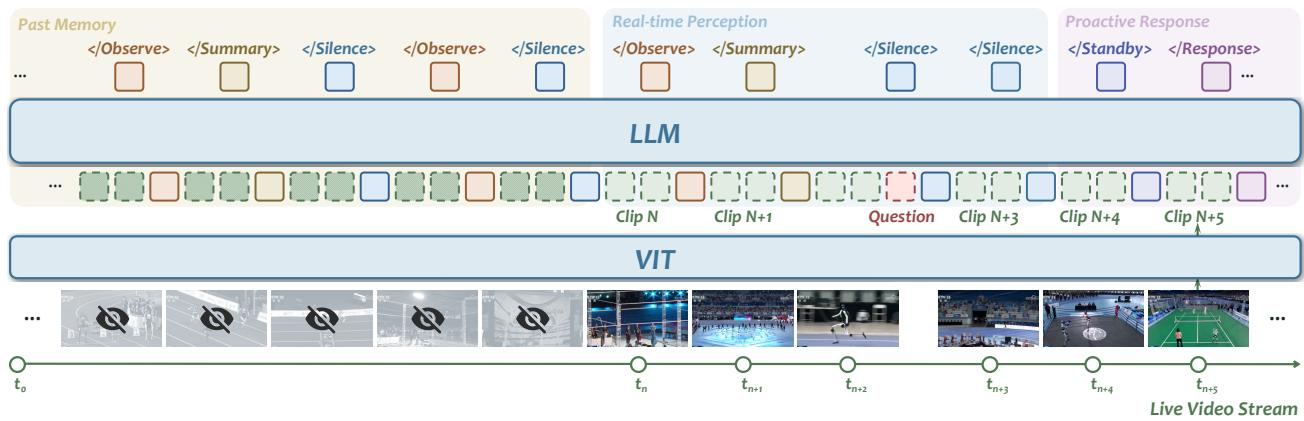
模型使用任务特定的控制 tokens 来指示是记录证据、继续观察还是生成用户可见响应。对于记忆形成,</Observe> 引入对已观察对象、动作、场景和状态变化的局部细节字幕。</Summary> 引入对已完成事件或片段的语义摘要。两种字幕类型都与其源区间对齐,并作为后续预测的事实上下文追加到文本历史中。主动 QA 使用 </Standby> 表示相关证据正在出现,但模型尚未准备好回答。模型仅在 </Response> 之后生成用户可见答案或其他任务输出。共享的 </Silence> token 表示继续观察而不生成字幕或响应。
在有限上下文容量下,保留历史视觉 tokens 会与当前感知所需的细粒度视觉证据竞争,而仅使用 Recent-N 窗口则会丢弃较远的视觉历史。因此,作者引入了 Proactive Hierarchical Caption Memory(PHCM),它用时间对齐的文本字幕补充近期视觉 tokens。随着流逐步展开,OneStreamer 从已观察内容中主动生成这些记录,并在其源帧离开视觉窗口后保留它们。这种异构表示通过紧凑文本扩展了对过去事件的访问,同时保持 Recent-N 视觉窗口不变。
PHCM 将观察到的证据组织为两类时间对齐记录。</Observe> 引入密集的局部细节字幕,描述在较短区间内直接观察到的对象、动作、场景和状态变化。</Summary> 在更粗的时间粒度上引入已完成事件或片段的较稀疏语义摘要。每条记录与其源区间相关联,两种粒度形成局部细节和事件级摘要的层级结构。在推理时,OneStreamer 仅使用当前可用的视觉语言上下文逐步构建 PHCM。在生成用户可见答案之外,预测的 </Observe> 或 </Summary> 会启动相应记录,而 </Silence> 继续观察而不写入记录。每条生成的记录按生成顺序追加到文本历史中,并可供后续预测使用。
主动流式交互要求模型判断可用证据何时足以生成记忆记录或任务响应。密集状态 token 监督可能在重复静默 tokens 数量超过输出启动 tokens 时过度强调等待,而仅监督状态变化则忽略了对当前状态应何时持续的监督。为了解决这个问题,作者引入了 Proactive State Transition Learning(PSTL),以保留所有输出锚点处的监督,并选择与状态变化或持续性相关的代表性状态 tokens。
PSTL 通过由任务特定输出锚点引导的选择性状态 token 监督实现。这些锚点是启动文本输出的控制状态。在每个训练序列中,状态 tokens 按照从前一个控制状态到当前控制状态的转移进行分组。针对输出锚点的最大组的规模定义了一个在该序列中所有组之间共享的监督配额。规模在配额内的组保留完整监督,较大组则无放回地均匀子采样以匹配配额。这保留了所有输出启动 tokens 的监督,同时选择状态变化和状态持续的示例。未选中的状态 tokens 保留在因果序列中,但不参与状态损失。
正式地,令 Aτ 表示任务 τ 的输出锚点集。令 nXY 为训练序列中连续标注控制状态之间转移 XY 的出现次数。这里 X 和 Y 在该任务的控制状态上取值。该序列中所有转移组共享的监督配额定义为:
q=Xmaxa∈AτmaxnX→a.从每个转移组 XY 中,状态 token 索引被无放回地均匀采样,以形成大小为以下值的 TXY:
∣IX→Y∣=min(nX→Y,q).只有由 T=⋃X,YTX→Y 索引的状态 tokens 参与状态损失。通过保留所有输出锚点并限制频繁转移组,PSTL 限制了重复静默 tokens 对状态目标的影响。
为了支持这一训练过程,作者开发了可复用的流式数据合成流水线,包含两个互补分支:流式字幕合成和流式 QA 合成。如下图所示,该流水线生成经过验证的、发布时间与证据对齐的流式字幕,以及有证据支撑且响应时间经过校准的流式 QA 序列。
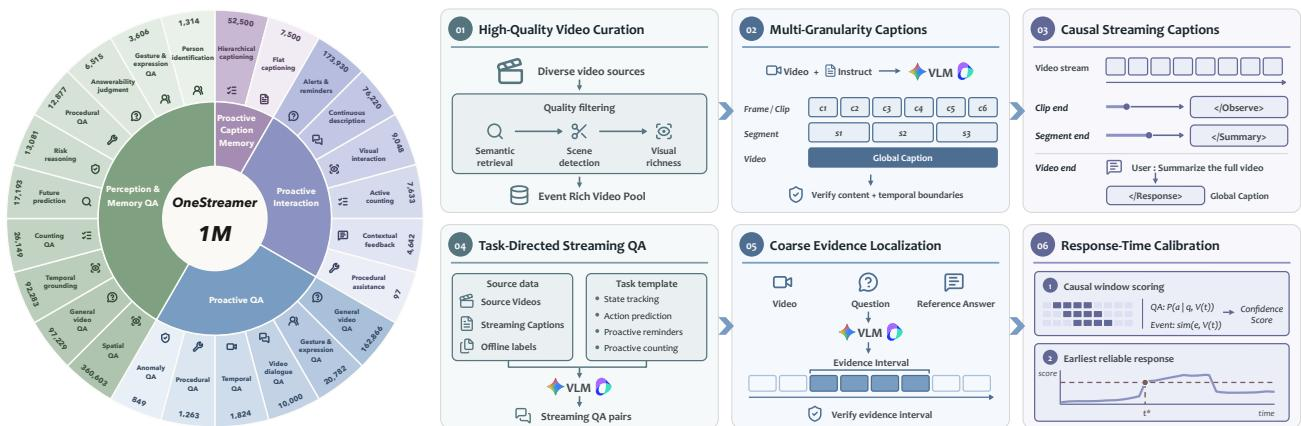
字幕分支将字幕内容和发布时间与可用证据对齐。局部描述仅在其支持视觉区间已被观察后才发布,而片段级摘要仅在相应事件或片段完成后才发布。QA 分支遵循的时间原则是:只要可用证据足以支持答案,每个响应就被分配到较早的时间点。在每个粗略证据区间内,使用滑动窗口评估候选时间戳。面向推理的 QA 根据给定每个视频前缀时参考答案的条件似然进行评分,面向感知的任务根据每个窗口与目标事件之间的视觉文本相似度进行评分。满足可靠性标准的最早时间戳被选为校准后的响应时间。
实验
OneStreamer 从 Qwen3-VL-4B-Instruct 初始化,并在 OneStreamer-1M 流式视频交互数据集及额外的离线数据上进行微调,随后在流式感知、记忆、主动响应、效率和定性基准上进行评估。主要结果显示,在实时感知和长程在线理解方面,相对于同规模及更大的基线模型均有一致的提升。消融实验表明,主动生成的字幕记忆提供了超出近期视觉窗口的可复用时间证据,同时改善感知和记忆,而不是以一方换另一方;同时,对状态转移和持续性的选择性监督增强了主动响应。效率分析和定性示例进一步证实,该方法以远低于保留完整视觉历史的上下文和延迟保存远处证据,并在相关证据出现时实现及时响应。
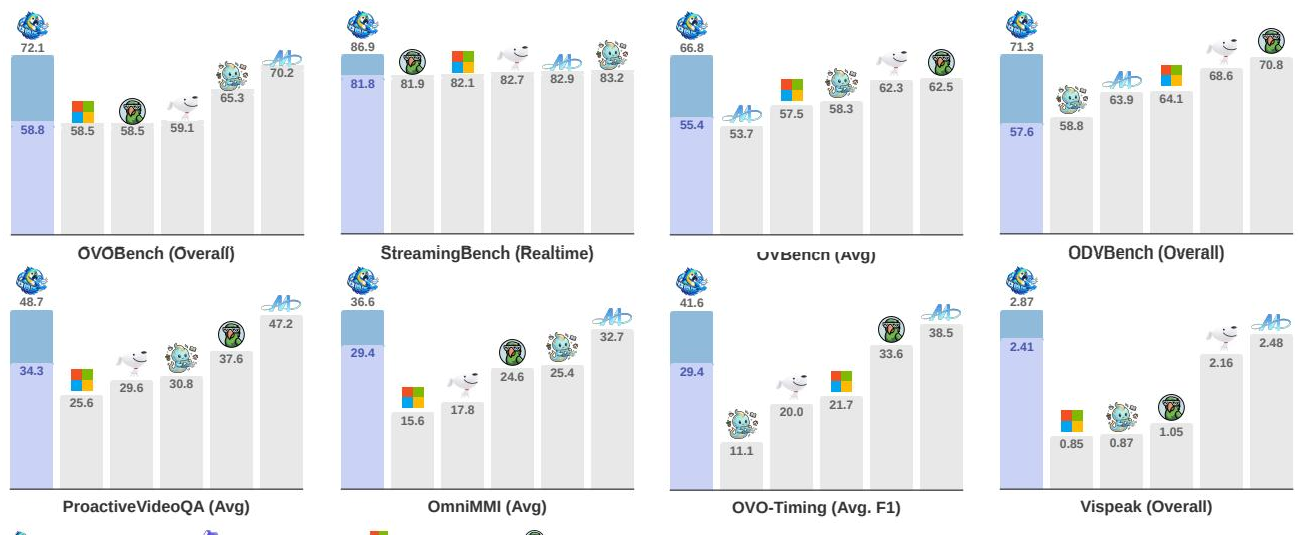
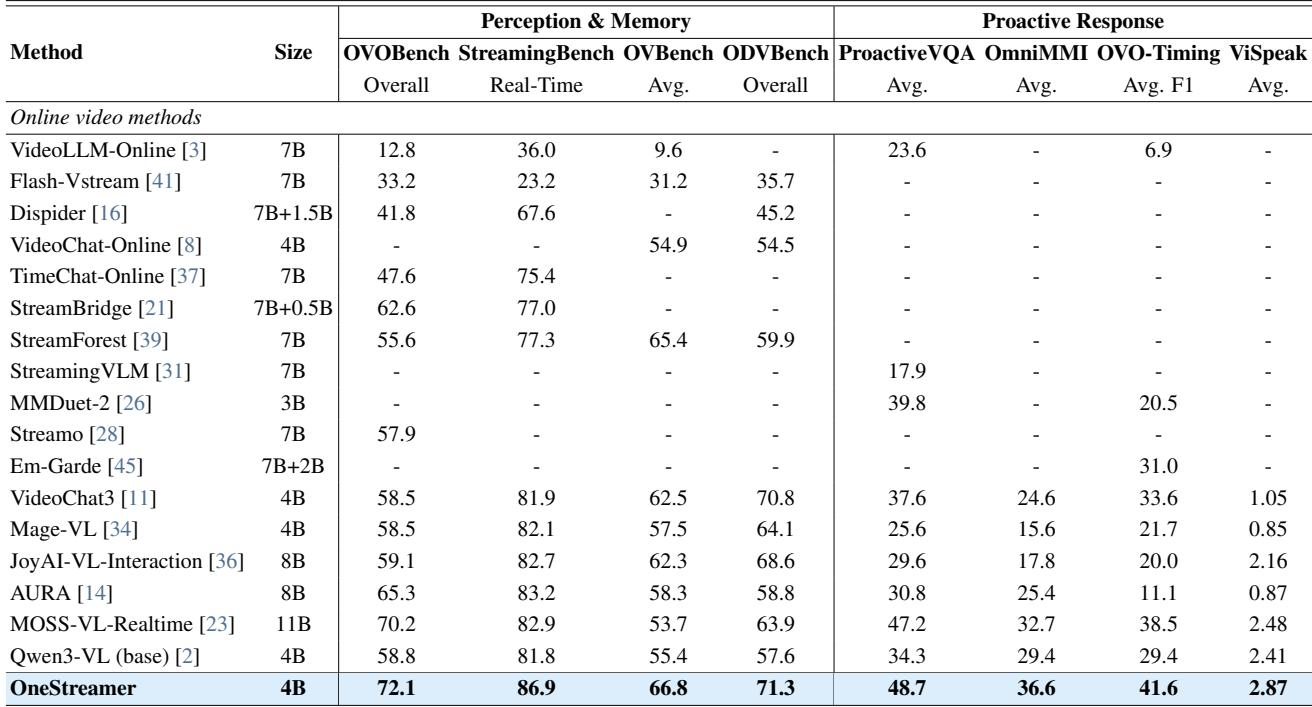
仅拥有 4B 参数的 OneStreamer 在全部八个涵盖感知、记忆和主动响应的在线视频基准上取得了对比方法中的最高分。它始终优于同规模的 Qwen3-VL 基座模型和一个更大的 11B 竞争对手,在若干感知和主动响应指标上提升尤为显著。结果表明,无需更大的模型即可实现强大的实时感知和长程在线理解。尽管只有 4B 参数,OneStreamer 在套件中的每个基准上都领先于所有对比方法。与同规模的 Qwen3-VL 基座模型相比,OneStreamer 在若干感知和主动响应基准上有两位数的提升。OneStreamer 在感知和记忆基准以及主动响应基准上也超过了更大的 11B MOSS-VL-Realtime。在 ViSpeak 上,OneStreamer 的总分高于 Qwen3-VL 和 MOSS-VL-Realtime。
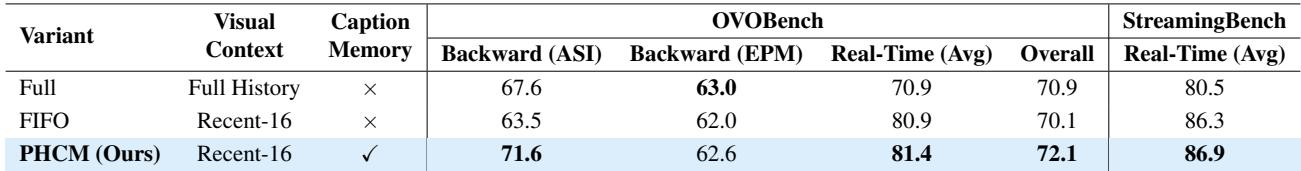
PHCM 用分层字幕记忆增强近期视觉窗口,并相对于仅使用相同视觉窗口改善了向后记忆。它还相对于 FIFO 带来了小幅实时感知提升,并在向后 ASI 上超过完整视觉历史,尽管其 EPM 略低于完整视觉历史。结果表明,字幕记忆在不牺牲当前感知的情况下提供了可复用的长期上下文。与 FIFO 相比,保留生成的字幕记录将向后 ASI 从 63.5 提高到 71.6,将向后 EPM 从 62.0 提高到 62.6。在与 FIFO 相同的近期视觉窗口下,PHCM 改善了实时感知,并在向后 ASI 上比 Full 高 4.0 分,尽管使用的是字幕记录而非远处视觉历史。
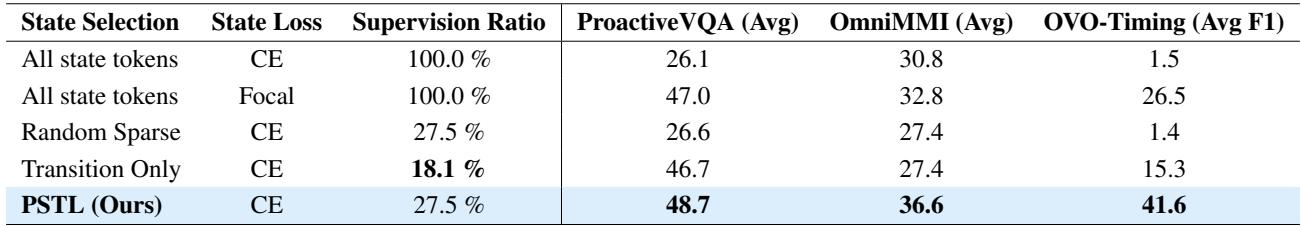
该消融实验比较了用于主动响应学习的状态 token 监督策略。密集 focal 监督优于密集交叉熵,但 PSTL 对状态转移和持续性的选择性监督在全部三个基准上取得了最佳结果,同时仅使用约四分之一的标注状态 tokens。相同监督比例下的随机稀疏选择表现明显更差,这表明具体的 token 选择策略是带来提升的原因。密集 focal 损失大幅优于密集交叉熵,反映出解决状态标签不平衡的益处。仅监督转移在 ProactiveVQA 上仍有竞争力,但在 OmniMMI 和 OVO-Timing 上落后于 PSTL,表明同时监督状态持续性具有价值。PSTL 仅监督约四分之一的状态 tokens,却在 ProactiveVQA、OmniMMI 和 OVO-Timing 上取得最高分,而相同比例下的随机稀疏选择表现差得多。
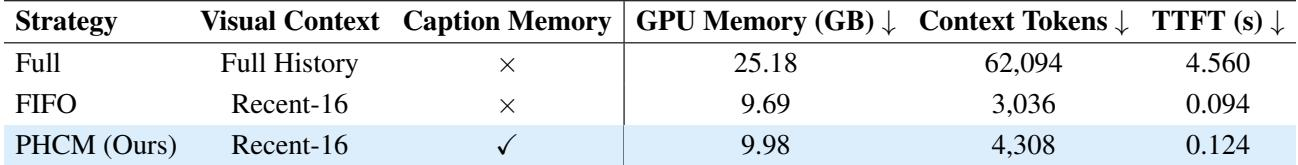
保留完整视觉历史会产生最高的答案阶段成本,包括最大的上下文、GPU 内存和首 token 时间。PHCM 使用近期视觉窗口加上紧凑字幕记忆,这相对于 Full 大幅减少了上下文和内存使用,同时仅比 FIFO 增加很小的开销。因此,它在答案阶段远比 Full 高效,仅比 FIFO 略高成本。相对于保留完整视觉历史,PHCM 大幅减少了上下文长度和 GPU 内存使用,并显著降低了首 token 时间。与 FIFO 相比,PHCM 只增加少量上下文、GPU 内存和延迟,同时通过字幕记忆保留了对较旧视觉证据的访问。
评估涵盖了一套在线视频基准,包括感知、记忆和主动响应,其中仅拥有 4B 参数的 OneStreamer 同时优于同规模的 Qwen3-VL 基座模型和更大的 11B 竞争对手,在感知和主动响应方面提升尤为明显。记忆消融实验显示,用分层字幕记忆增强近期视觉窗口可在向后记忆上优于 FIFO,并在向后理解上保持与完整视觉历史相当或更好,同时大幅减少上下文、GPU 内存和延迟。主动响应消融进一步表明,对状态转移和持续性的选择性监督在全部主动基准上取得了最佳结果,优于密集和随机稀疏策略,同时仅使用少量标注状态 tokens。