Command Palette
Search for a command to run...
ID 平衡:基于 PID 负载控制的极稀疏 MoE 稳定训练
ID 平衡:基于 PID 负载控制的极稀疏 MoE 稳定训练
摘要
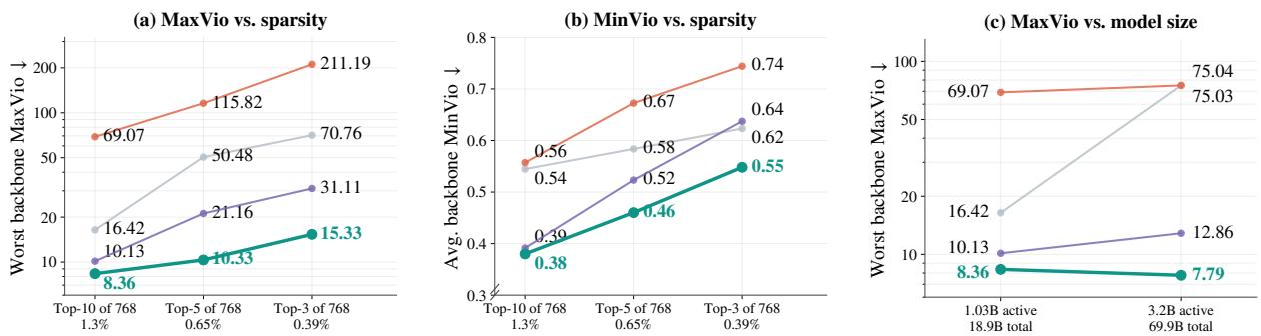
通过专家混合(MoE)扩展大型语言模型(LLM)可在近乎恒定的每令牌计算量下实现参数的大幅增长。然而,进一步扩展参数数量需要越来越稀疏的路由,此时专家负载不平衡问题变得更加严重。这种不平衡会降低参数利用率和训练效率,并可能破坏训练稳定性,成为可靠扩展的瓶颈。在本工作中,我们将两种具有代表性的无辅助损失方法统一为不完整的比例-积分-微分(PID)控制器:DeepSeek 的无损失方法充当固定步长的积分控制器,而 Kimi K3 的分位数平衡则充当广义比例控制器。基于这一控制视角,我们提出了 ID 平衡,一种积分-微分控制器。它根据负载误差缩放积分项,并仅在不平衡加剧时激活微分项,从而能够对较大或恶化的误差进行更强修正,并在接近平衡时进行较小更新。在 768 个专家上的 Top-10、Top-5 和 Top-3 路由评估中,与 Top-3 设置下的最佳基线相比,ID 平衡将最坏情况下的骨干 MaxVio 和训练平均骨干 MinVio 分别降低了超过 50% 和 12%。当总参数数量从 18.9B 增加到 69.9B(Top-10-of-768)时,ID 平衡的最坏情况骨干 MaxVio 几乎保持不变,并且比辅助损失基线低约 89.6%。ID 平衡还保持了具有竞争力的语言建模和下游性能。ID 平衡的优势随稀疏度增加而增强,使其成为扩展更大、更稀疏 MoE 模型的一种有前景的解决方案。
一句话总结
Qwen 团队与阿里巴巴集团提出 ID Balancing,一种受 PID 启发的积分-微分负载控制器,用于极度稀疏的 MoE 训练。该方法将无辅助损失方法统一视为不完整的 PID 控制器,其积分项随负载误差缩放,且仅在不平衡加剧时激活微分项,在参数从 18.9B 扩展到 69.9B 的过程中,相比最佳 Top-3 基线,最坏情况下的主干网络 MaxVio 降低超过 50%,同时保持稳定。
核心贡献
- 引入统一的 PID 控制视角来理解无辅助损失的 MoE 平衡方法,将 DeepSeek 的无损失方法视为固定步长积分控制,将 Kimi K3 的分位数平衡视为广义比例控制。
- 提出 ID Balancing,一种积分-微分控制器,其积分项随负载误差缩放,且仅在不平衡加剧时激活微分项,每层仅需 O(E) 的 token 计数反馈,且不向语言建模目标添加平衡梯度。
- 在 768 个专家的 Top-10、Top-5 和 Top-3 路由设置下,与最佳基线相比,ID Balancing 将最坏情况下的主干网络 MaxVio 降低超过 50%,训练平均主干网络 MinVio 降低超过 12%;在参数从 18.9B 扩展到 69.9B 时,最坏情况下的主干网络 MaxVio 几乎保持不变,同时保持有竞争力的语言建模和下游任务性能。
引言
混合专家(MoE)模型通过稀疏专家激活高效扩展大规模语言模型,路由器仅从更大的专家池中为每个 token 选择 K 个专家,从而在不按比例增加计算量的情况下实现容量增长。随着专家池扩大,保持专家负载平衡变得越来越困难;Top-K 选择边界附近的小幅偏移可能导致过载专家拖慢计算速度,而欠载专家训练不足,从而限制训练效率和模型容量收益。
现有无辅助损失平衡方法根据路由反馈调整专家偏置,但采用固定步长修正或批局部目标,无法适应误差幅度或加剧的不平衡。作者通过统一的 PID 控制框架解释这些方法,将 DeepSeek 的无损失方法识别为固定步长积分控制,将 Kimi K3 的分位数平衡识别为广义比例控制。这一视角揭示了这些方法在处理高度稀疏路由时的局限性,并促成了作者的主要贡献:ID Balancing,一种积分-微分控制器,采用幅度感知的积分修正和恶化门控微分项,每层仅需 O(E) 的 token 计数反馈,且无需向训练目标添加平衡梯度。
方法
作者将混合专家(MoE)负载平衡表述为一个控制问题,以管理训练过程中的专家利用。在该框架中,具有 E 个专家的 MoE 层使用 Top-K 路由器,该路由器为 token 表示 x 计算 logits z=Wrx。在筛选之前,将不可训练偏置向量 b 添加到专家分数中,使得所选专家为 T(x)=TopKi∈[E](si+bi)。控制目标是专家之间的均匀负载。在每个训练步骤 t,专家 i 的归一化负载误差定义为 ei(t)=(nˉ(t)−ni(t))/nˉ(t),其中 nˉ(t) 是平均 token 数,ni(t) 是专家 i 的计数。偏置向量同时充当持久控制器状态和路由输入。
为解释现有无损失平衡方法,作者采用广义 PID 控制视角,其中偏置更新表示为 b(t+1)=P(t)+I(t)+D(t)。在此视角下,DeepSeek 的无损失方法作为固定步长积分控制器运行,仅根据负载误差的符号更新偏置;而分位数平衡作为广义比例控制器运行,直接根据当前批次分数分布上计算的目标设置偏置。
基于这一控制视角,作者提出 ID Balancing,该方法结合幅度感知积分项与恶化门控微分项,同时省略比例项以维持稳定的路由边界。
幅度感知积分项解决了固定步长积分控制的局限性,后者无论误差严重程度如何都施加相同修正。ID Balancing 则按归一化误差本身缩放更新:
bi(t+1)=bi(t)+Kiei(t)其中 Ki≥0 为积分增益。这确保修正随不平衡幅度增长,并在专家接近目标负载时缩小。由于归一化误差之和为零,该积分更新在从零初始化时天然保持零均值偏置。
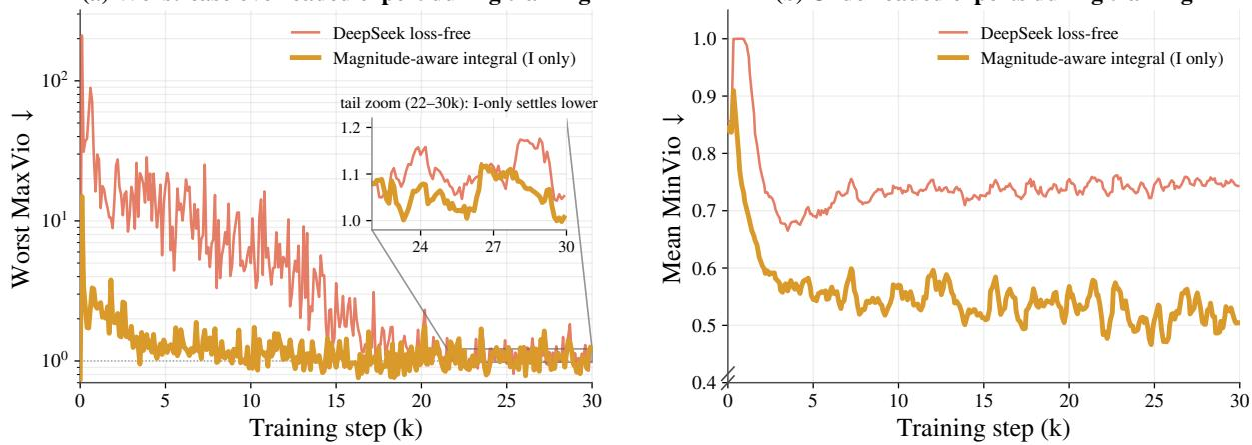
如上图所示,按误差幅度缩放积分更新可显著降低最差层最大违规(MaxVio)峰值,并降低持续欠载,优于 DeepSeek 方法中使用的固定符号更新。这证明了更强的早期修正能力和更好的专家利用。
为进一步捕捉负载误差的演变,ID Balancing 引入恶化门控微分项。该项计算误差变化 Δei(t)=ei(t)−ei(t−1),并应用门控 gi(t),该门控仅在不平衡加剧时激活。当前一误差与其变化符号相同时门控打开,表示偏差正在增长且未越过零点。微分修正 Kdgi(t)Δei(t) 与积分更新一同累加到偏置中。
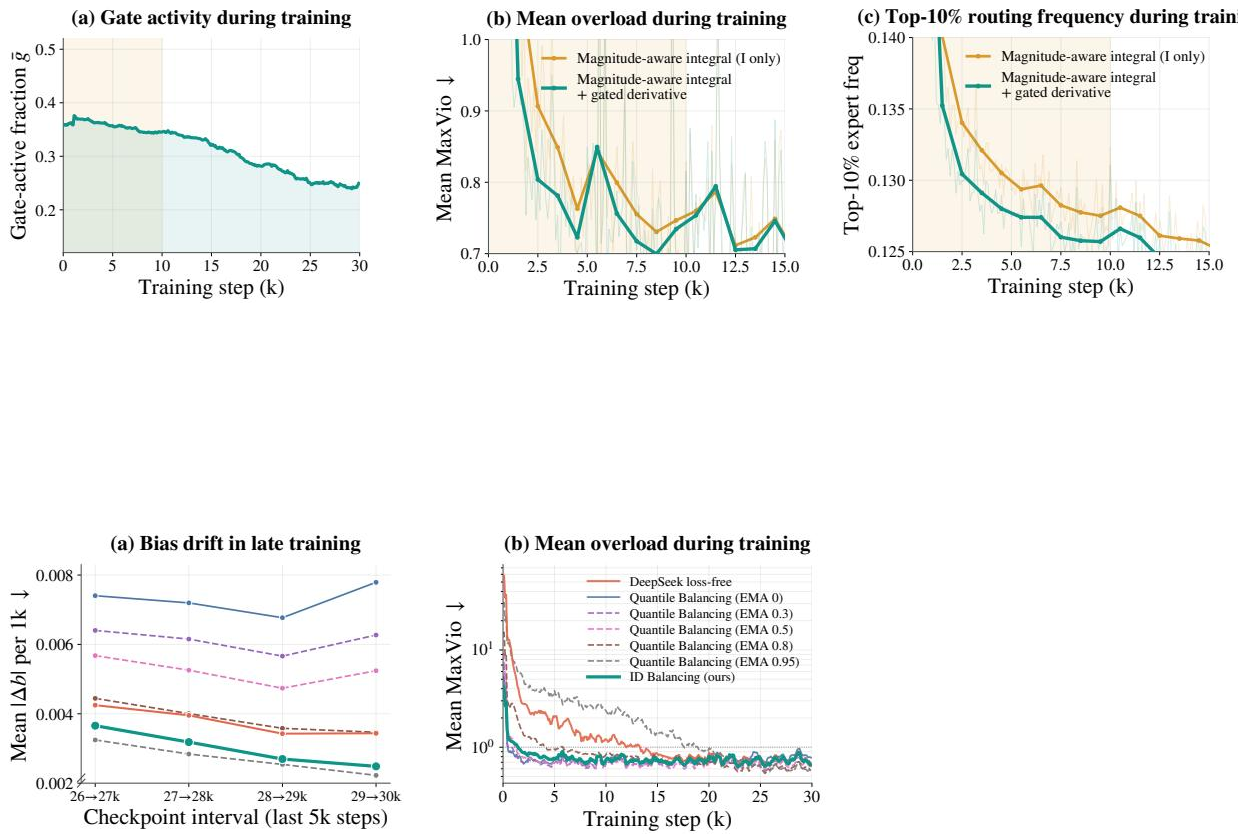
参见上文框架图,该图展示了微分项的行为。随着训练进行,激活门控比例逐渐下降,添加门控修正可降低早期负载违规并减少专家集中,同时轨迹最终接近仅积分更新的结果。
作者有意在 ID Balancing 中省略比例项。诸如分位数平衡等比例控制器会根据当前批次计算目标偏置,该目标随分数分布变化,导致后期偏置漂移更大。相对专家偏置的较小变化可限制对 Top-K 选择边界的扰动,从而稳定路由并便于权重合并。
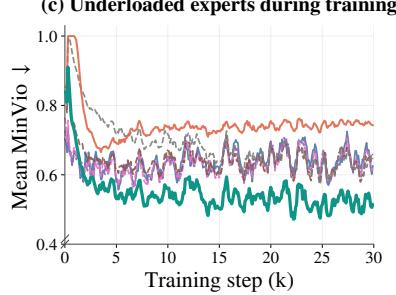
如上图所示,虽然指数移动平均(EMA)平滑可以减少分位数平衡中的偏置漂移,但会削弱早期负载控制。ID Balancing 通过其积分和门控微分更新实现低偏置漂移和有效负载平衡,无需额外平滑。
最后,由于微分项中的门控机制不保持零均值特性,ID Balancing 包含零均值居中步骤。在计算中间偏置 b~i(t+1) 后,通过减去所有专家的均值来移除公共分量:
bi(t+1)=b~i(t+1)−E1j=1∑Eb~j(t+1)这确保偏置总和保持为零,防止公共偏置漂移,同时不改变相对分数排序或所选专家集合。
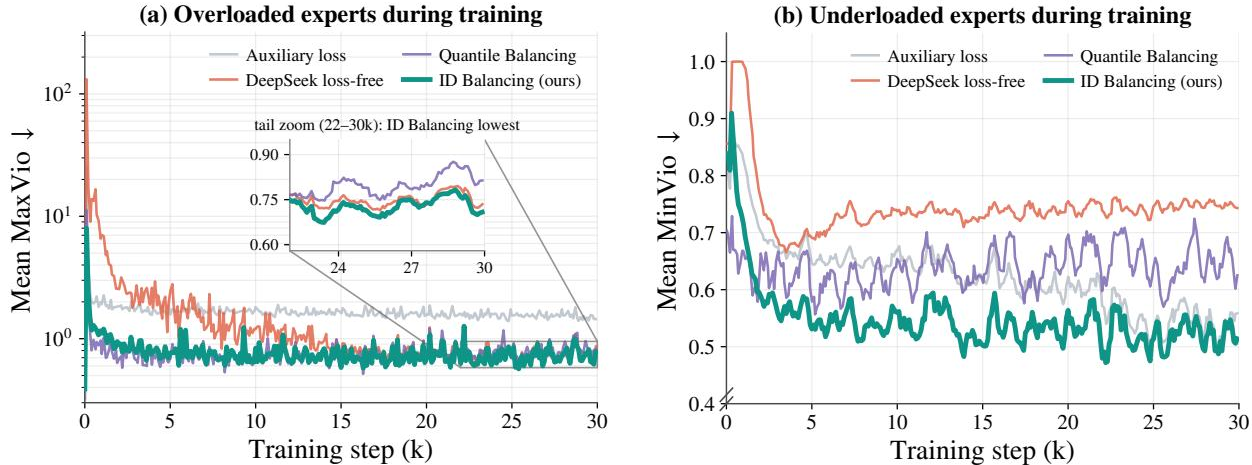
完整的 ID Balancing 更新有效限制了高度稀疏 MoE 训练中的瞬态过载和持续欠载。如上图所示,与辅助损失、DeepSeek 的无损失方法以及分位数平衡相比,ID Balancing 在整个训练过程中保持更低的平均 MaxVio 和 Mean MinVio,确保稳定高效的专家利用。
实验
实验在标准预训练和持续预训练、更高学习率以及推理时利用率等场景下验证了 ID Balancing。ID Balancing 在主干负载平衡方面持续优于辅助损失和 DeepSeek 的无损失方法,同时保持有竞争力的 LM 损失和下游质量,在持续预训练中缩小的收益仍能保持性能。在更高学习率下,ID Balancing 维持有效负载控制并具有更平滑的梯度范数,不过在此压力测试中分位数平衡实现了更紧的主干平衡。消融实验确认默认设置 Ki=Kd=6e−3 可在早期修正、最坏情况违规和 MTP 权衡之间取得平衡。
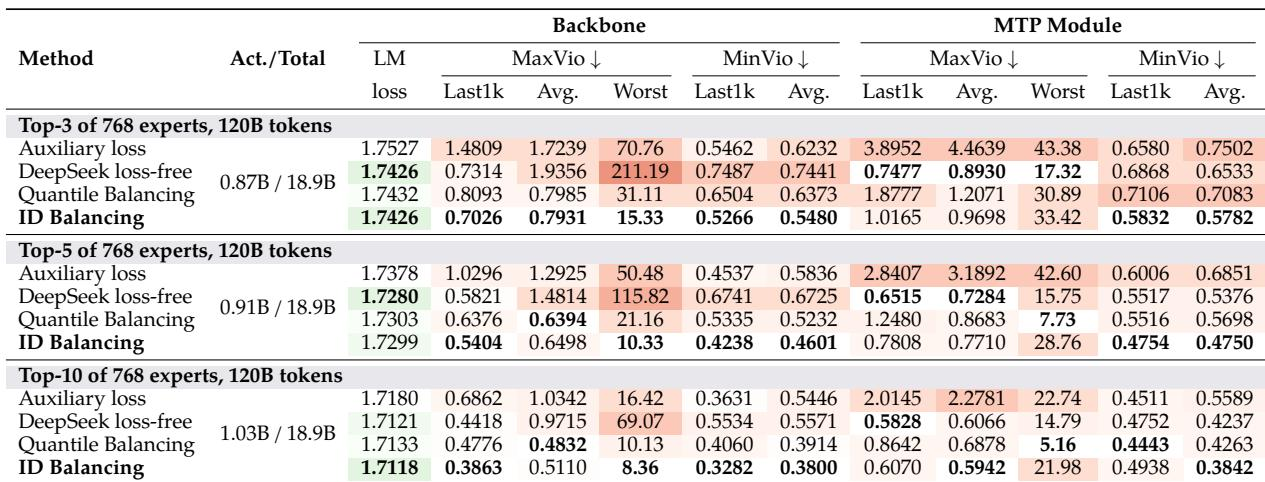
ID Balancing 在比较方法中实现最低的主干负载不平衡指标,同时保持有竞争力的语言建模损失,并提高推理时的专家利用率。比较在 18.9B 参数模型上以 Top-3、Top-5 和 Top-10 路由在 768 个专家上训练 120B tokens 进行。ID Balancing 在降低主干 MaxVio 和 MinVio 方面持续优于辅助损失、DeepSeek 的无损失方法和分位数平衡,在最坏情况和最终步负载控制方面尤其突出。在所有方法中,ID Balancing 在 last-1k、平均和最坏情况指标上均取得最低主干 MaxVio,最坏情况比辅助损失小数倍。ID Balancing 将 Top-10-of-768 路由下的平均非活跃专家比例从 8.4%(辅助损失)降至 6.4%,第一层比例从 9.3% 降至 2.6%。ID Balancing 保持有竞争力的语言建模损失,数值在最佳方法的窄范围内,同时提供显著更好的负载平衡。分位数平衡和 ID Balancing 在跨层负载控制方面均比辅助损失或 DeepSeek 的无损失方法更一致,训练平均值与最终阶段分布之间的差异更小。ID Balancing 的 MinVio 低于或相当于其他方法,表明专家利用率更高、欠载专家更少。
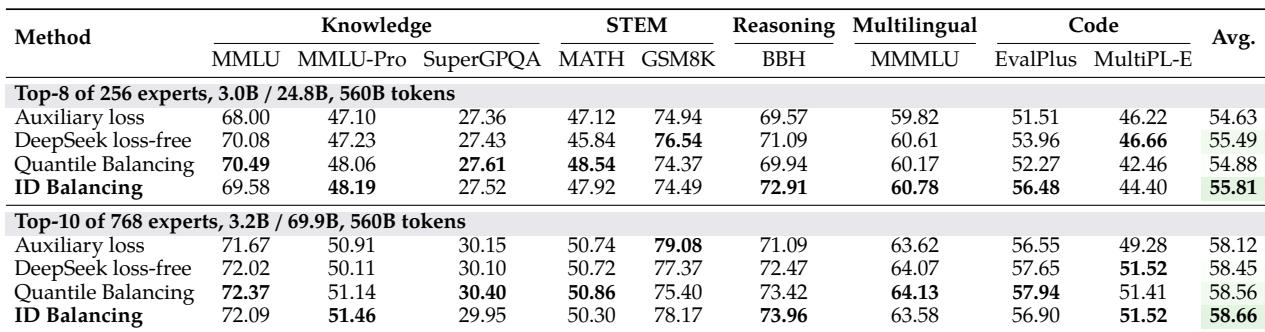
在九项基准测试中,ID Balancing 与其他路由方法相比保持有竞争力的下游性能,在知识密集型任务和代码生成方面表现强劲。在 Top-8-of-256 和 Top-10-of-768 两种配置下,其平均分数均属最佳之列,通常达到或超过辅助损失和 DeepSeek 无损失等基线。ID Balancing 在两种路由配置中均取得最高平均分数,略微领先辅助损失和 DeepSeek 无损失。在 Top-8 配置下,ID Balancing 在 MMLU-Pro 和 SuperGPQA 上领先,展示了扎实的知识和推理能力。在 Top-10-of-768 路由下,ID Balancing 在大多数单项基准上取得最佳或接近最佳的分数,包括强劲的代码生成结果。
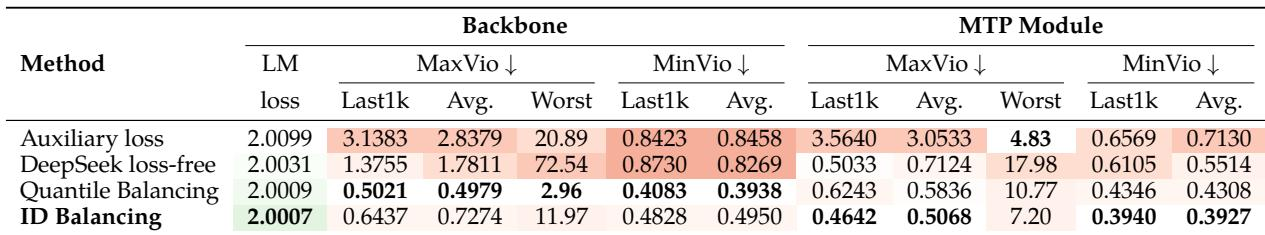
在恒定学习率为标准峰值 2.3 倍的条件下,ID Balancing 和分位数平衡均比辅助损失和 DeepSeek 的无损失方法保持更低的主干负载违规。分位数平衡实现最紧的主干平衡,而 ID Balancing 取得最低的 LM 损失和最低的 last-1k MTP 负载违规,表明主干与 MTP 平衡之间存在不同权衡。ID Balancing 和分位数平衡的主干 MaxVio 约为 0.64 和 0.50,而两个基线分别为 3.14 和 1.38。分位数平衡在所有方法中取得最低的主干 last-1k MaxVio。ID Balancing 取得最低的 LM 损失(2.0007)和最低的 last-1k MTP MaxVio。辅助损失的最坏情况主干 MaxVio 高达 20.89,而分位数平衡仅为 2.96。
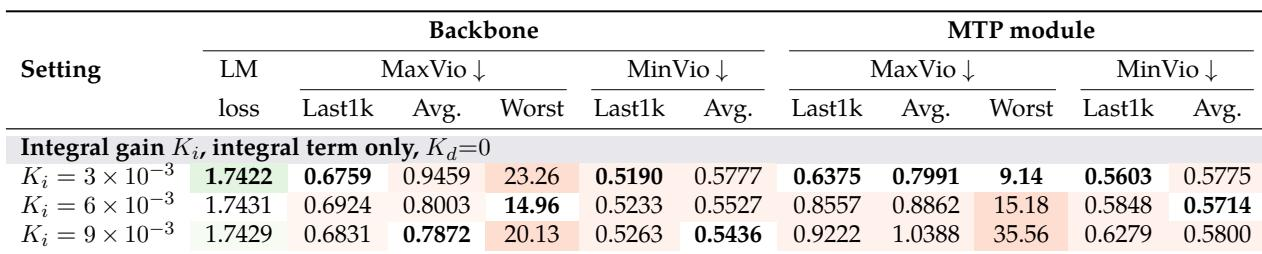
积分增益扫描显示,将增益从 3 增加到 6 可减少主干违规,但进一步增加到 9 会恶化最坏情况 MTP 平衡和主干最坏情况值。选择中间增益 6 是因为它在早期修正与较低最坏情况违规之间取得平衡。随后单独评估微分增益,显示早期主干负载改进以 MTP 平衡为代价。将积分增益从 3 提高到 6 可同时改善平均和最坏情况主干违规,而进一步增加到 9 仅略微改善平均值,但显著恶化最坏情况主干和 MTP 违规。最小积分增益取得最低 LM 损失以及更好的最终阶段和 MTP 指标,但早期不平衡修正较慢。添加微分项可改善早期主干负载控制,减少早期步骤的主干违规,但增加 MTP 违规,且更大的微分增益会放大这一权衡。
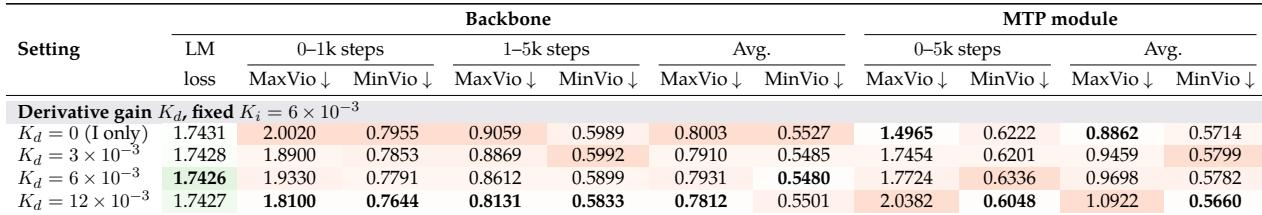
将微分增益从零增加到 12e-3 可逐步改善早期主干负载平衡,在前 5k 步内降低主干过载指标。但代价是更高的 MTP 模块过载,尤其是在后期和平均指标中。默认增益 6e-3 提供了平衡,在测试值中取得最低 LM 损失和训练平均主干 MinVio。在仅积分基线上添加微分项可减少 0–1k 和 1–5k 步的主干 MaxVio,且更大增益带来更强早期修正。默认微分增益 6e-3 将训练平均主干 MaxVio 从 0.8003 降至 0.7931(相对仅积分基线)。MTP 过载随更大微分增益而增加;训练平均 MTP MaxVio 从 0.8862(基线)升至最大增益时的 1.0922。默认增益在比较设置中取得最低 LM 损失(1.7426)和最低训练平均主干 MinVio。
ID Balancing 在 18.9B 模型的 768 个专家 Top-3、Top-5 和 Top-10 路由设置下持续改善专家利用和主干负载平衡,降低非活跃专家比例和最坏情况负载违规,同时保持有竞争力的语言建模损失。在九项下游基准上,ID Balancing 达到或超过基线,尤其在知识密集型任务和代码生成方面。恒定高学习率实验显示,ID Balancing 和分位数平衡比基线保持更低的主干违规,但存在不同权衡:分位数平衡实现更紧的主干平衡,而 ID Balancing 取得更低 LM 损失和 MTP 违规。增益扫描表明,适度的积分和微分增益可改善早期负载修正而不会牺牲最坏情况平衡,但更大的微分增益会恶化 MTP 过载。