Command Palette
Search for a command to run...
面向可信 AI 审稿人的一块缺失拼图:从基准评测修辞稳健性到 SciCore Review
面向可信 AI 审稿人的一块缺失拼图:从基准评测修辞稳健性到 SciCore Review
Chenguang Wang Ming Li Chengrui Fan Jianpeng Chen Han Chen Tianyi Zhou Dawei Zhou
摘要
AI 审稿人可能对以不同措辞呈现相同科学内容的稿件给出不同判断,从而可能奖励修辞优化而非科学改进。我们将修辞稳健性(Rhetorical Robustness)定义为一种联合要求:对保持内容的改写具有稳定性,并对不同论文具有区分性。我们引入了 RobustReview,一个包含 1,260 个稿件版本的受控全稿基准,并评估了 30 种审稿配置。该基准揭示了虚假稳健性,即较低的改写敏感性与跨论文评分坍缩同时出现,并表明人类一致性(human alignment)与修辞稳健性对审稿人的排序不同。此外,所评估的以内容为中心的提示协议并未在不同骨干模型上一致地提升稳健性。受这些发现启发,我们提出了 SciCore,一种双分支审稿人,它将对全稿的判断与基于所提取的结构化科学核心的判断进行平均。该设计将稿件层面的评估与旨在降低修辞敏感性的内容归一化视角相结合。在我们主要的 GPT-5.5 对比中,SciCore 在被评测的审稿人中取得了领先的稳定性-区分性联合表现,同时保持了具有竞争力的人类一致性。这些结果将修辞稳健性确立为一个独立的评估目标,并展示了基于科学核心的审稿在改善修辞稳健性方面的潜力。
一句话总结
来自弗吉尼亚理工大学、马里兰大学和 MBZUAI 的研究人员提出了 RobustReview,一个包含 1,260 份稿件的受控基准,该基准揭示了虚假鲁棒性,即重写不敏感与分数塌缩同时出现,并提出了 SciCore,一种双分支评审器,对完整稿件判断和提取的科学核心判断取平均值,在基准评审器中实现了领先的稳定性-区分性特征和具有竞争力的人类对齐。
核心贡献
- 本文正式将修辞鲁棒性确立为可信 AI 评审器的重要要求,其定义为对同一稿件内容保持性重写的稳定性以及对不同论文的区分性。人类对齐作为一项独立属性进行评估。
- RobustReview 是一个受控的完整稿件基准,包含 1,260 份稿件版本和 30 种评审器配置。该基准揭示了虚假鲁棒性,即低重写敏感性与跨论文的分数塌缩同时出现,并表明人类对齐和修辞鲁棒性对评审器的排序不同。
- 本文提出了 SciCore,一种双分支评审器,将传统的完整稿件判断与来自提取的结构化科学核心的内容归一化判断取平均值。在主要的 GPT-5.5 对比中,SciCore 实现了领先的联合稳定性-区分性特征,同时保持了具有竞争力的人类对齐。
引言
大语言模型越来越多地用于支持科学同行评审,其判断可能影响哪些研究被接受和传播。现有评估通常关注 AI 生成的评审是否有用、是否类似于专家反馈,或是否匹配人类决策,但先前工作表明评审器模型可能被措辞变化和保持含义的修辞修改所操纵。作者认为修辞鲁棒性是一项缺失的要求:可靠的 AI 评审器应在同一科学内容的修辞变体之间保持稳定,同时仍然区分不同论文。作者引入了 RobustReview,一个受控的完整稿件基准,包含 60 篇 ICLR 2026 投稿在 10 种修辞条件下的重写版本,以及 SciCore,一种双分支框架,将传统的完整稿件评审与对论文科学主张的提取结构化记录进行内容归一化判断相结合。
数据集
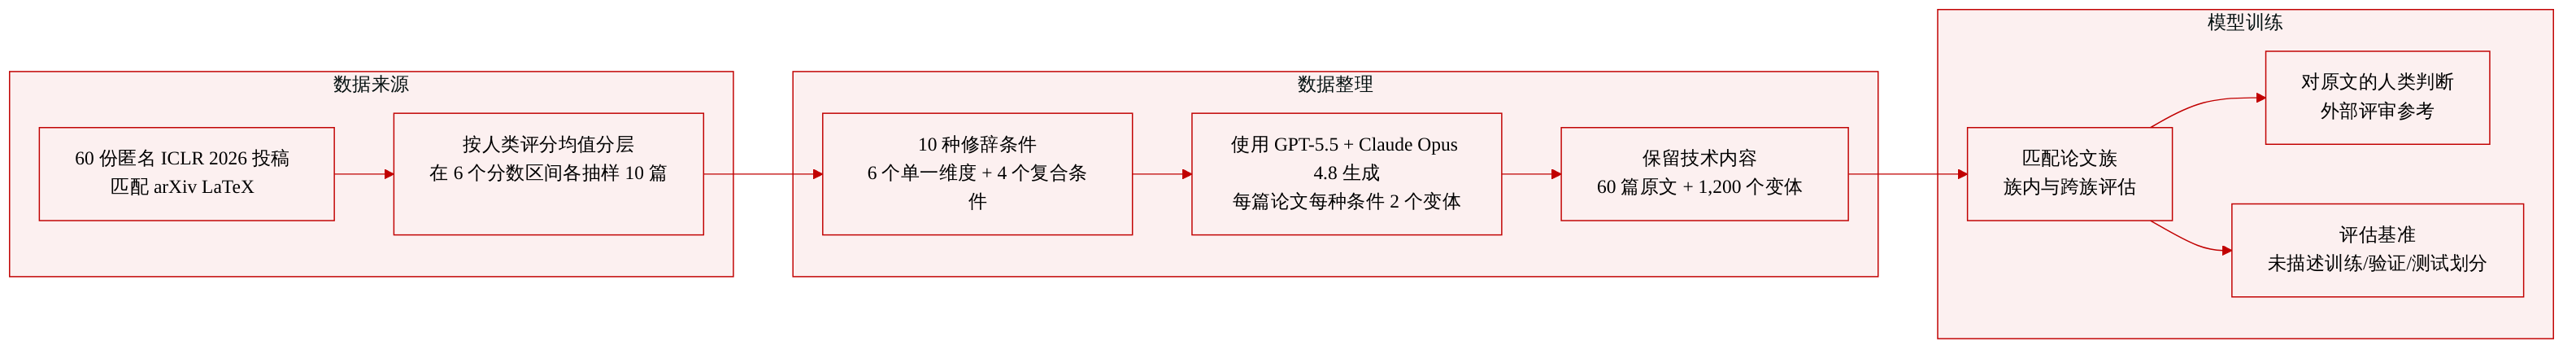
作者从 60 篇匿名 ICLR 2026 投稿及其匹配的 arXiv LaTeX 源文件构建 RobustReview。语料库包含 60 份原始稿件和 1,200 份修辞变体,共计 1,260 份完整稿件。
- 来源与抽样: 符合条件的论文按人类总体评估平均评分分层。作者从六个评分区间中每个区间随机抽取 10 篇论文,平衡人类评估评分的覆盖范围。
- 变体条件: 应用了 10 种修辞条件。六种改变单一维度:新颖性立场、范围框架、证据框架、贡献显著性、技术语域或语言复杂性。四种复杂条件应用跨维度联合重写、两轮或三轮递归重写轮次(R2 和 R3),或基于模型反馈的评审器引导重写。
- 生成与规模: 每种条件由 GPT-5.5 和 Claude Opus 4.8 独立实例化,每篇论文每条条件生成两个变体。由此产生 60 份原始稿件加 1,200 份变体。
- 处理与元数据: 所有重写均在内容保持和结构控制下对完整 LaTeX 项目进行操作。自动化和人工审计表明,核心技术内容在五个评估维度上基本得到保持。每个变体可通过其匹配的论文族、修辞条件和生成模型进行识别。
- 用途: 该基准使用匹配的论文族,因此族内比较直接测量重写引起的不稳定性。跨族比较提供参考,用于判断篇内一致性是否与论文间的区分共存。对原始稿件的人工判断作为独立外部参考,用于评估评审器评估。
- 训练划分、混合比例与裁剪: 所提供的摘录中未描述;RobustReview 作为评估基准呈现。
方法
RobustReview 与 SciCore
作者将修辞鲁棒性视为一个独立的评估目标。在其表述中,对所报告科学的判断应在稿件仅改变呈现方式的重写后保持稳定,而同一评审器应继续区分报告不同科学内容的稿件。对于论文 i,原始稿件记为 xi0。每个受控重写设置 k 指定修辞条件和重写生成器,生成预期保持论文报告的声明、方法、证据、结果和结论的变体 xik。然后评审器配置 m 为每个实现分配判断 ymik:
xik=Rewritek(xi0),k=1,…,K, ymik=Reviewm(xik),k=0,…,K.该基准要求两个互补的属性。篇内稳定性衡量同一论文的修辞变体之间判断是否保持一致。篇间区分性衡量评审器是否仍然保持不同稿件之间的有意义的区别。联合要求防止平凡的恒定评审器仅在稳定性上得分良好。作者通过直接的篇内指标和联合稳定性-区分性指标来操作化这一点。
为构建该基准,作者从匿名 ICLR 2026 投稿及其关联 LaTeX 源文件创建匹配的论文族。符合条件的论文按人类总体评估平均评分分层,在六个评分区间中抽取平衡样本。应用了十种修辞条件。六种每次改变一个维度:新颖性立场、范围框架、证据框架、贡献显著性、技术语域和语言复杂性。四种应用更复杂的重写:联合多维重写、两轮或三轮递归重写,以及基于模型反馈的评审器引导重写。每种条件由两个独立的重写生成器实例化,每篇论文每种条件生成两个变体。重写流程在内容保持和结构控制下对完整 LaTeX 项目进行操作。
SciCore 双分支评审
SciCore 评审器旨在降低修辞敏感性,同时不丢弃完整稿件上下文。SciCore 不是要求评审器在阅读完整论文时忽略修辞,而是首先将稿件转换为内容归一化的科学记录。该方法使用两个互补分支:稿件分支和科学核心分支。
稿件分支直接将基于证据的评审协议应用于完整稿件 PDF。它保留传统的完整论文评审上下文,并在 ICLR 风格量表上产生总体评估。
科学核心分支首先使用 LLM 从稿件中提取结构化科学核心。提取聚焦于报告的科学记录,包括核心研究思想和主张、问题表述、数学公式和推导、方法和假设、实验或理论证据、报告的结果、作者陈述的贡献、可复现性信息以及陈述的局限性。
提取器被指示以客观的第三人称语言书写,并保留对原始稿件的归属。具体而言,主张和作者陈述的贡献必须保持归属于作者,报告的结果和数值证据必须得到保留,提取器应避免主观评估、评价性语言、情感框架和无依据的解释。提取器不判断某个主张是否有说服力,也不判断论文应如何评分。
所得科学核心是基于文本的科学记录,而非原始论文的缩短重写。图不直接保留。表格被明确转录,以便其报告的值和比较仍然可用。方程、数学论证、报告的数值和其他细节在能够可靠恢复时均予以保留。如果信息无法定位或可靠读取,提取器记录该不确定性,而不是重建缺失的内容。
在评审时,科学核心分支仅接收提取的记录,而非原始稿件。其协议将标准评审指令适配到科学核心的结构。评审器被指示将陈述的问题和主张与方法、假设、数学推理以及经验或理论证据联系起来;评估报告的结果是否支持作者陈述的主张;并在判断证据的强度和范围时使用可复现性信息和陈述的局限性。稿件中缺失的信息可被视为缺失的科学支持,而提取不确定性则单独处理。该分支使用相同的 ICLR 风格评估标准和评分方案,并生成书面反馈、优点、缺点、问题及总体评估。
两个分支通过未加权算术平均进行融合。设 M(x) 为稿件分支总体评分,B(x) 为对实现 x 的科学核心分支评分。最终 SciCore 评分为
SSciCore(x)=21M(x)+21B(x).等权重给出对称组合,不引入调整过的融合参数。稿件分支和科学核心分支保持独立可解释,允许对每个组件的行为与融合后的评审器分别进行评估。
实验
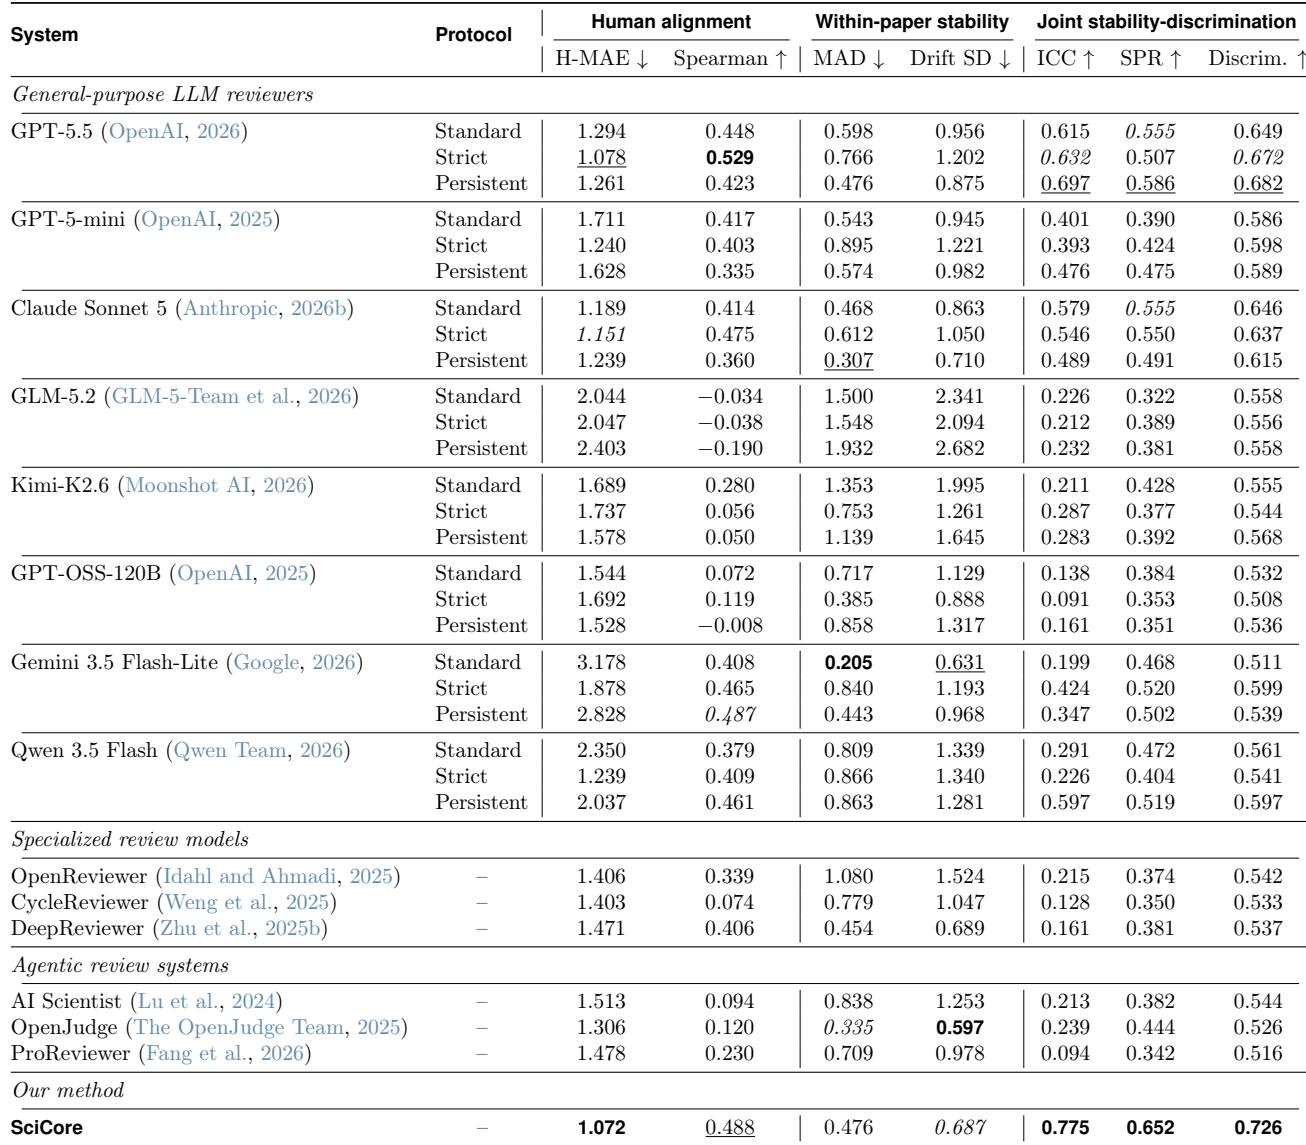
实验引入了 RobustReview,一个通过将原始稿件与内容保持性修辞重写相匹配来衡量修辞鲁棒性的基准,并从篇内稳定性、篇间区分性和人类对齐等方面评估评审器。在 30 种现有评审器配置中,仅靠提示无法可靠地强制执行以内容为重点的评审,低重写引起的漂移在伴随弱论文区分时可能反映虚假鲁棒性;人类对齐和修辞鲁棒性也偏向不同的协议。所提出的 SciCore 系统将直接科学核心评审与稿件评审相结合,实验表明它改善了联合稳定性和区分性,同时保持了具有竞争力的人类对齐,消融实验表明直接核心评审、适配的评审策略和等权融合对这些收益有贡献。
SciCore 在评估的评审器配置中实现了最强的联合稳定性-区分性结果,在 ICC、SPR 和可区分性上领先,同时记录了最低的人类平均绝对误差。其人类排名相关性具有竞争力但非领先值,并且在篇内变动或漂移上并非最佳。基准还表明,仅凭低篇内不稳定性本身可能反映输出塌缩而非有用的评审,因此稳定性必须与区分性一起解读。SciCore 在比较配置中取得了最佳 ICC、SPR 和可区分性,并配合最低的人类平均绝对误差和第二高的人类 Spearman 相关性。尽管联合特征强劲,SciCore 在 MAD 或 Drift SD 上并未领先,其人类 Spearman 相关性仍低于严格的 GPT-5.5 配置。某些核心配置中接近零的漂移与接近零的 SPR 相关联,表明篇内稳定性在没有论文层面区分的情况下可能具有误导性。
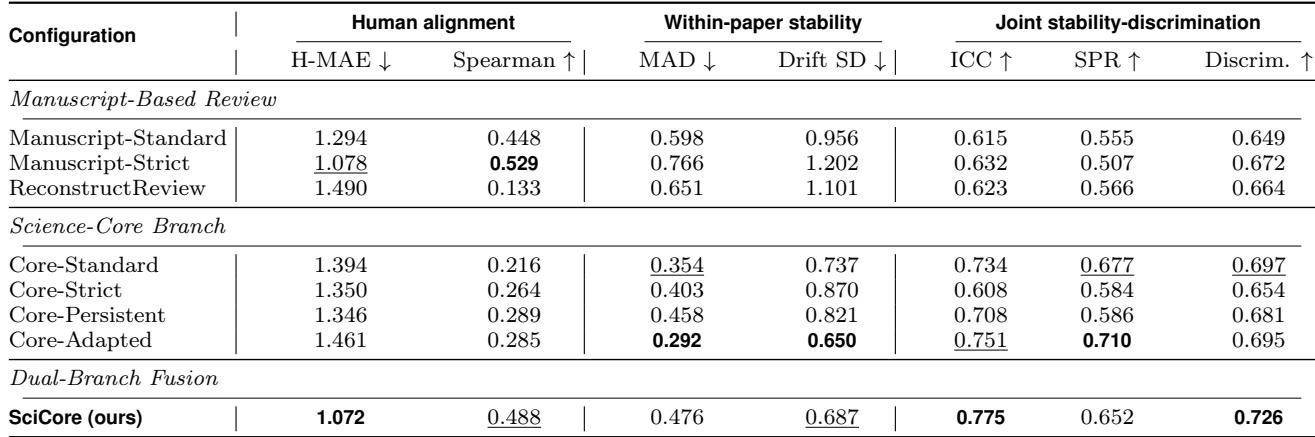
在共享 GPT-5.5 骨干下,直接科学核心评审提供了比稿件评审或重建更强的鲁棒性分支;重建恶化了篇内稳定性,同时仅提供适度的联合指标收益。在仅核心策略中,适配协议在稳定性和区分性之间取得最佳平衡,而更严格或持久的策略可能降低变异或鲁棒性。将适配核心分支与稿件严格评审融合,相较于稿件严格评审改善了鲁棒性,并相较于单独适配核心改善了人类对齐、ICC 和可区分性。直接科学核心评审比稿件标准或重建更鲁棒,重建恶化了 MAD 和漂移,联合收益有限。Core-Adapted 在仅核心配置中实现了最低 MAD 和漂移以及最高 ICC 和 SPR,而 Core-Persistent 相对于 Core-Standard 恶化了鲁棒性。最终融合的 SciCore 配置相较于 Manuscript-Strict 改善了全部五个鲁棒性指标,并相较于单独 Core-Adapted 改善了人类对齐、ICC 和可区分性。篇内稳定性在没有论文层面区分的情况下可能具有误导性,因为某些核心策略表现出接近零的漂移,同时伴随输出塌缩和接近零的 SPR。
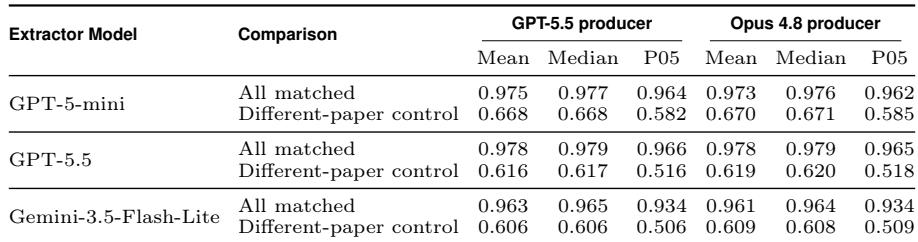
匹配的科学核心嵌入在所有提取器模型和两种重写生成器下始终比不同论文的对照组相似得多。这种分离在均值、中位数和第五百分位上均持续存在,表明重写版本的核心与其原始版本保持接近,同时与无关论文保持不同。GPT-5.5 表现出特别强的分离,但这一趋势在每个测试的提取器和生成器上都成立。匹配相似性在所有提取器和生成器上保持较高,而不同论文对照组的相似性大幅下降。即使在第五百分位也能看到分离,表明低相似性的匹配案例仍然超过大多数跨论文比较。
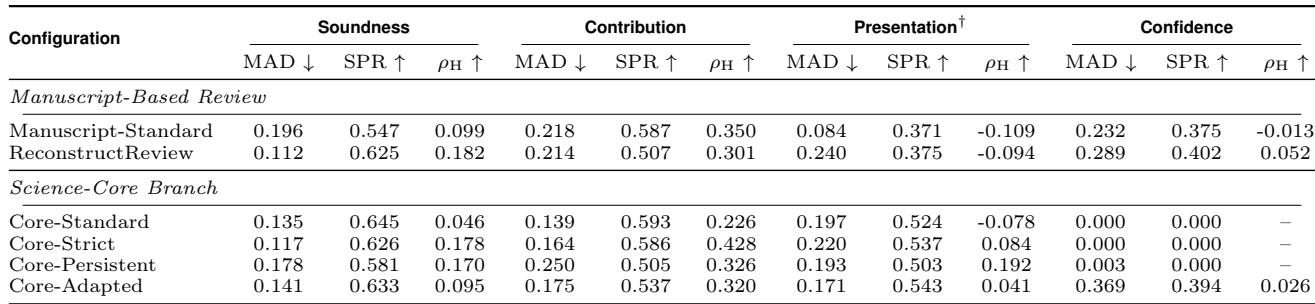
科学核心分支的行为取决于标准。相对于基于稿件的评审,它通常改善健全性稳定性,但人类对齐并未在所有标准上均匀改善。置信度是一个明显的失败模式:Core-Standard 和 Core-Strict 分配恒定的置信度分数,因此低漂移反映输出塌缩而非有意义的稳定性,而 Core-Adapted 恢复了变异并改善了置信度区分性。与基于稿件的评审相比,科学核心分支的健全性稳定性趋于改善,而健全性的人类对齐并未均匀改善。呈现具有诊断意义,因为基于稿件的评审和科学核心评审评估不同的构造:论文呈现与提取的科学记录的清晰性和完整性。Core-Standard 和 Core-Strict 分配恒定置信度分数且 SPR 为零;Core-Persistent 几乎没有变异,因此其接近零的漂移是虚假鲁棒性的结果。Core-Adapted 恢复了论文层面的置信度变异并提高了置信度 SPR,表明篇内稳定性不能在没有区分性的情况下解读。
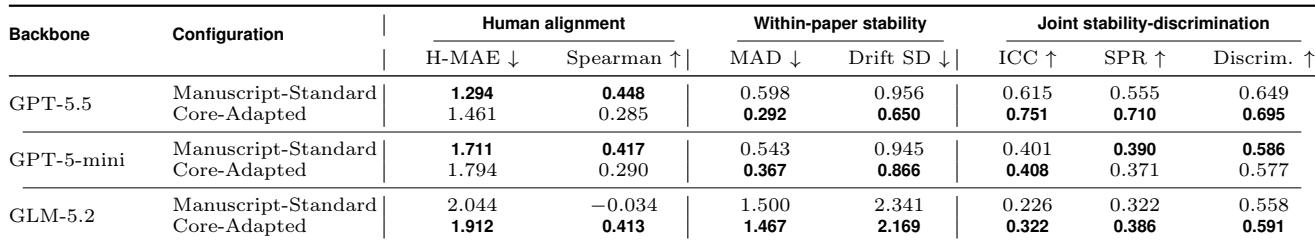
该比较评估了稿件标准的完整论文协议与核心适配配置,后者使用相同的骨干进行科学核心提取和评审。核心适配评审在三种骨干下均改善了 ICC,但更广泛的收益取决于骨干。证据支持科学核心分支的部分迁移,而非普遍收益。与稿件标准基线相比,核心适配评审在三种骨干下均提高了 ICC。GPT-5.5 改善了五个鲁棒性指标但降低了人类对齐。GPT-5-mini 改善了 MAD、漂移 SD 和 ICC,同时削弱了 SPR 和可区分性。GLM-5.2 改善了全部七个报告指标。人类对齐在不同骨干下并未一致改善。
实验在多个评审器配置、骨干模型、嵌入提取器、重写生成器和评审标准上评估了科学核心评审流程。主要结论是,适配后融合的科学核心分支产生了最平衡的鲁棒性特征,具有最强的总体稳定性和区分性以及较低的人类误差,而严格或持久的仅核心策略可能塌缩变异并产生误导性的接近零漂移。匹配的科学核心嵌入在重写和提取器之间保持高度相似,支持核心一致性,但收益取决于标准和骨干:健全性稳定性改善,人类对齐不一致,置信度除非恢复变异否则是失败模式,呈现改变了被评估的构造。总体而言,结果支持科学核心评审的部分迁移而非普遍收益,稳定性必须与论文层面的区分性一起解读。