Command Palette
Search for a command to run...
学习蛋白质折叠能否泛化到更广泛的推理?
学习蛋白质折叠能否泛化到更广泛的推理?
Yong Liu Zhanpeng Shi Yizhou Dang Zhongyue Zhang Xiaoliang Shi Zhijian Wei Shuangjia Zheng
摘要
大型语言模型严重依赖人类文本,而人类文本往往传达表面答案,而非答案背后的空间与结构逻辑。蛋白质折叠是一个天然的试验平台,因为一个已解析的结构可以产生数千条可精确检验的空间与拓扑陈述。我们要问:学习蛋白质折叠能否教会通用模型可复用的推理能力?为回答这一问题,我们构建了源自蛋白质的问答数据集 FoldingCorpus,以及 Fold2Reason 训练方案;该方案利用两种互补信号对其进行后训练:通过模型原生语言头预测的离散结构答案,以及从相同共享表示中解码的连续三维几何。在 FoldBench 上,Fold2Reason 的结构预测得分达到 Qwen3.5-9B 的 2.7 至 3.5 倍。除蛋白质结构预测之外,它在涵盖空间、图、科学和通用推理的全部 10 个基准上均取得提升,将宏平均准确率从 45.09% 提高到 48.33%(+3.23 个百分点),并在全部 10 个基准上均带来正向增益;而由随机结构、合成结构和打乱结构构建的匹配对照产生的增益显著更小或为负。我们的工作表明,非语言的、结构密集的科学数据能够系统性地提升语言模型的广泛推理能力,使一个已解决的科学问题成为实用的后训练监督来源。
一句话总结
上海交通大学、复旦大学、上海创新研究院和东北大学的研究者提出 Fold2Reason,这是一种基于 FoldingCorpus 蛋白质问答数据集的后训练方案,将模型原生语言头预测的离散结构答案与从共享表示解码的连续 3D 几何相结合,使结构预测分数达到 Qwen3.5-9B 的 2.7 到 3.5 倍,并将 10 个推理基准上的宏平均准确率提升 3.23 个百分点。
核心贡献
- FoldingCorpus 是一个基于现有蛋白质结构构建的问答数据集,包含 1,200 个蛋白质和 14,400 条记录,覆盖 12 个结构算子,并具有簇不相交的核心划分以及为可审计性而独立重新计算的答案。
- Fold2Reason 是一种后训练方案,利用共享表示中的两个互补信号:离散结构答案监督模型原生语言头,而冻结的坐标解码器约束相同的 LoRA 适配残基状态;下游评估仅使用适配后的基座模型。
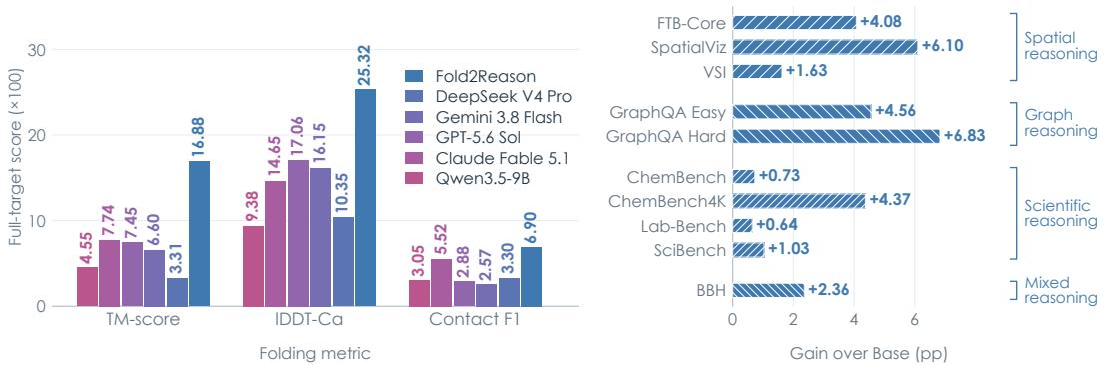
- 在 FoldBench 上,Fold2Reason 取得的蛋白质结构预测分数为 Qwen3.5-9B 的 2.7 到 3.5 倍。在 10 个通用推理基准上,宏平均准确率从 45.09% 提升到 48.33%,且所有 10 个基准均获得正向增益;而由随机、合成和打乱结构构建的匹配对照产生的增益明显更小或为负。
引言
作者针对的开放问题是:哪些监督属性能够使语言模型训练的收益迁移到其源领域之外。有限的人类书写文本和代码促使探索替代监督信号,但专门训练通常使更广泛行为保持不变甚至变差。蛋白质折叠提供了有说服力的测试平台,因为已解析的 Protein Data Bank 坐标能够在大规模上产生确定、可自动验证的接触、距离、方向和坐标目标,而无需额外标注。作者从 1,200 个蛋白质和 12 个结构算子构建了 FoldingCorpus,并提出 FOLD2REASON;该方法通过共享 LoRA 工作区,以离散结构答案加连续几何监督对 Qwen3.5-9B 进行后训练,然后在评估时移除所有蛋白质特异组件。在三个随机种子上,该方法将 General-10 宏平均从 45.09% 提升到 48.33%(+3.23 个百分点),并在全部十个通用推理数据集上均获得正向平均变化,这支持行为迁移而非均匀提升。
方法
训练目标:已知答案与隐藏证据
对于长度为 L 的蛋白质,令 x 包含氨基酸序列以及可选的 MSA 或模板证据,令 Y∈RL×4×3 包含已知骨架坐标,并令 m 表示残基有效性掩码。坐标用于生成目标和损失,但不是模型输入的一部分。语言模型处理包含每个残基一个标记的提示,并产生残基状态
H=fθ(x)res∈RL×4096,其中基础权重被冻结,θ 包含可训练的 LoRA 参数。
每个蛋白质生成一个包含 12 个问题的打包集合。在 Y 上计算的程序为接触、距离比较、片段方向、中心邻近、局部方向、手性、多约束和全局摘要任务创建标签。九个答案为二分类,两个为三分类,一个为 32 分类文本摘要匹配。每个选项由一个词表 token 表示。作者一次性构建这些问题包,独立重新计算答案,并将数值证据保留在审计记录中,而不是放入提示。独立哈希盐决定标签采样、选项顺序和问题顺序,冻结的问题包在各 epoch 间复用。32 分类问题在一个目标摘要和 31 个难负例摘要之间进行选择,但它仍是普通的 answer token 监督,而非单独的检索目标。
一个工作区,两个读出
工作区模块 Wϕ 将标记状态降至 256 维,在序列局部对和采样的长程对之间交换消息,并返回两个读出:
(E,M)=Wϕ(H),E∈RL×4096,M∈R16×4096.这里 E 与残基对齐。16 个学习查询对残基集合进行池化,并将其投影回语言模型宽度,产生证据 token M。工作区仅引用这些训练时的残基张量和池化张量。
消息传递对连接序列偏移 1 到 4 以及均匀间隔的更长程索引,每个蛋白质最多 2,048 对。目标接触不选择边。对称特征结合降维状态的绝对差和逐元素乘积。消息在关联残基处进行平均,然后进行残差更新。学习查询池化形成固定大小的前缀 M,而 E 保持残基级对应。
FoldingCorpus 路径将 M 前置到打包的问题序列 q。前缀位置和提示位置被忽略,仅对 12 个 answer token 和序列结束 token 进行监督。答案损失为
Lqa=−∣S∣1t∈S∑logpθ,ϕ(yt∣M,q,y<t).几何路径将 E 传递给冻结的坐标与 distogram 解码器 gψ。其损失结合坐标、残基对距离、接触、distogram、局部坐标系、扭转角和回转半径项:
Lgeo=Lcoord+Lpair+Lcontact+Ldist+Llocal+Ltorsion+LRg.冻结 ψ 可防止新的坐标头吸收该目标。梯度必须转而改变共享工作区和 LoRA 参数。标准目标是 L=Lqa+Lgeo。每个训练样本对同一个 LoRA 适配模型进行两次前向传播:蛋白质前向传播产生 H,答案前向传播以 M 与嵌入后的问答序列拼接作为输入。两次前向传播之间保留计算图,因此答案损失会同时更新回答参数和从蛋白质到工作区的路径。冻结解码器意味着从优化器中排除 ψ,而不是将 E 从计算图中分离。因此几何梯度仍然能够到达 ϕ 和共享的 LoRA 参数。
仅优化 LoRA 和活跃的工作区参数。在标准运行中,四个 worker 各自累积两个单蛋白微步,每次更新使用八个蛋白质。作者对 12 个标签和序列结束 token 的答案交叉熵取平均,将其与几何损失结合,并在每次 AdamW 更新前将累积梯度范数裁剪到 1.0。在迁移评估时,工作区 Wϕ 和解码器 gψ 被丢弃,仅将学到的 LoRA 适配器应用于模型的原生基准接口。因此,任何测得的迁移必须存在于适配后的语言模型中,而不是蛋白质特异模块中。
实验
本研究在蛋白质 FoldingCorpus 上训练 LoRA 适配器;该数据将经验证的问答目标与通过冻结结构读取器施加的几何监督结合起来,然后在 General-10 推理套件和 FoldBench 结构指标上评估迁移。匹配对照显示,格式复制和打乱标签不会产生可靠增益,而隐藏几何目标仅能部分迁移;扩展实验表明,不同数据集族普遍改善,但随着蛋白质覆盖量增大收益递减。消融实验将大部分通用推理迁移归因于 FoldingCorpus 答案监督,几何监督主要贡献于 3D 导向任务和局部结构读出;跨模型测试发现多个 Qwen 规模及 InternVL 均有增益,但 Gemma 没有。
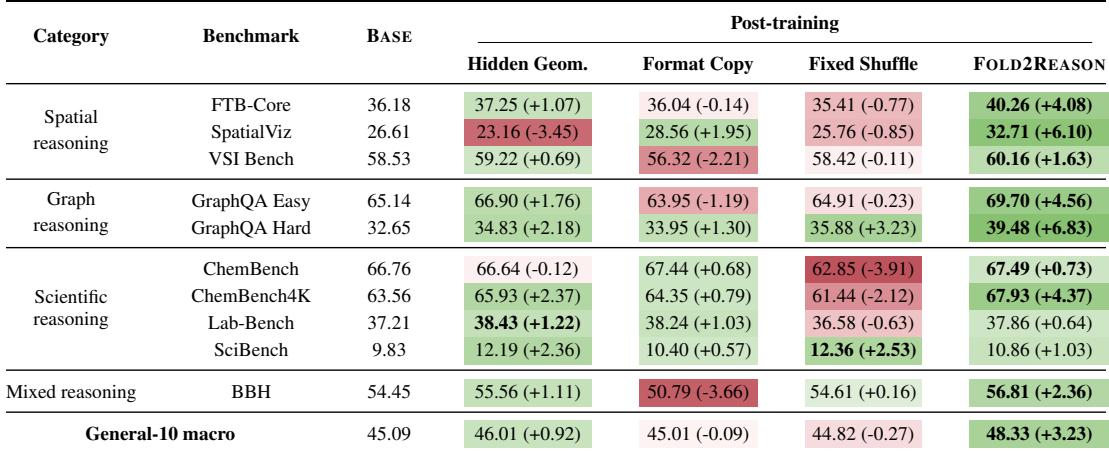
FOLD2REASON 将 General-10 宏平均从 45.09% 提升到 48.33%,增益为 3.23 个百分点,并在全部十个数据集上均获得正向平均变化。匹配对照显示,隐藏几何目标带来较小的总体增益,而格式复制和固定打乱标签则接近零。完整方案的增益超过最强对照的两倍以上,表明改进来自蛋白质来源的监督,而非答案格式或固定标签失配。FOLD2REASON 相较于基座模型将 General-10 宏平均提升 3.23 个百分点。增益具有广泛性,在全部十个 General-10 数据集上平均变化均为正,最大提升集中在图与空间推理基准上。在匹配对照中,只有隐藏几何(Hidden Geometry)产生适度的总体增益;格式复制(Format Copy)和固定打乱(Fixed Shuffle)保持接近零。FOLD2REASON 的增益超过最强对照的两倍,因此仅靠答案格式或固定打乱监督无法解释提升。
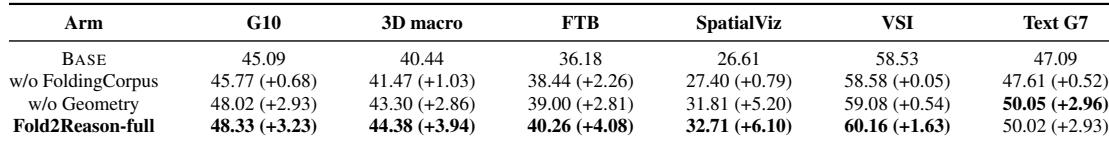
完整的 Fold2Reason 配置相较于基座模型将 General-10 准确率提升略高于三个百分点,3D 宏平均的增益大于纯文本聚合的增益。FoldingCorpus 监督贡献了大部分广泛且偏文本的增益,而附加的几何监督提供了进一步适度提升,主要集中在 FTB-Core、SpatialViz 和 VSI 等空间任务上。移除 FoldingCorpus 后仅剩较小的整体提升,这证实答案监督是行为迁移的主要驱动因素。完整配置相对于基座在 General-10 上提升约 3.2 个百分点,在 3D 宏平均上提升约 3.9 个百分点。无几何监督(w/o Geometry)组已经贡献了 General-10 和文本聚合的大部分增益,表明 FoldingCorpus 监督是主导贡献因素。在 FoldingCorpus 之上添加几何监督将 3D 宏平均提升约一个百分点,并改善每个 3D 导向数据集,同时文本聚合基本保持不变。没有 FoldingCorpus 时增益小得多,尤其是 SpatialViz 和 VSI,而 FTB-Core 仍显示适度提升。
评估测量了向 General-10 和 3D 基准的迁移。完整的 Fold2Reason 方法相较于基座模型将 General-10 准确率提升约 3.2 个百分点,并在全部十个数据集上呈现广泛的正向变化,在空间和 3D 任务上增益更大。对照实验显示,隐藏几何仅带来适度的总体增益,而格式复制和固定打乱标签接近零,说明改进来自蛋白质来源监督,而非格式或标签失配。消融实验证实,FoldingCorpus 答案监督是广泛且偏文本增益的主要驱动因素,附加的几何监督提供了进一步的适度提升,集中在 FTB-Core、SpatialViz 和 VSI 等 3D 导向基准上。