Command Palette
Search for a command to run...
FRAMEMORROW:面向长时程视频生成的基于前瞻 token 的未来引导帧选择
FRAMEMORROW:面向长时程视频生成的基于前瞻 token 的未来引导帧选择
Bo Yin Xiaobin Hu Jiaqi Zhao Shuicheng Yan
摘要
长时程视频生成要求模型有效利用不断变长的生成历史。随着生成历史增长,保留所有先前内容会变得日益昂贵且冗余,因此有效选择历史信息至关重要。现有方法通常依据当前内容判断历史相关性。然而,与当前相关的信息未必对未来生成有用,而看似不太相关的历史信息可能在之后变得重要。我们的核心洞见是:历史信息应当根据其与未来信息需求的相关性来选择。捕捉这些需求并不需要生成完整未来;对“接下来什么会变得重要”的紧凑表示就足以指导历史选择。基于这一洞见,我们提出 FRAMEMORROW,一种前瞻式帧选择器,它预测一小组表示未来信息需求的前瞻 token,并用它们从历史中识别相关信息。FRAMEMORROW 选择显式的历史帧,而非特定于模型的内部状态,因而能够以很小的额外推理代价即插即用地集成到各类生成器中,包括闭源模型。我们在 5 个基准和 11 个生成模型上评估 FRAMEMORROW,涵盖长视频生成、交互式生成和动作条件世界模型。大量实验表明,该方法在多种生成场景下改善了长程一致性、视觉质量和动作对齐。项目页面见 https://yinbo0927.github.io/FrameMorrow/。
一句话总结
新加坡国立大学与哈尔滨工业大学(深圳)的研究人员提出 FRAMEMORROW,这是一种未来引导的帧选择器,可预测表示未来信息需求的 prospective tokens,并据此选择显式历史帧,从而以即插即用方式集成到包括闭源模型在内的多种生成器中,并在五个基准和 11 个生成模型上改善长程一致性、视觉质量和动作对齐。
核心贡献
- 将长时程视频生成中的历史帧选择形式化为以未来信息需求为条件,而不仅仅以与当前内容的相关性为条件。
- 提出 FrameMorrow,一种即插即用的未来式帧选择器,预测一小组表示未来信息需求的 prospective tokens,并选择显式历史帧,从而兼容包括闭源模型在内的多种生成器,且额外推理成本很低。
- 在五个基准和 11 个生成模型上评估 FrameMorrow,涵盖长视频生成、交互式生成和动作条件世界模型,显示长程一致性、视觉质量和动作对齐得到改善。
引言
长时程视频生成要求模型在较长时间内保持主体、物体和场景一致,但自回归生成器的输入窗口有限,无法保留所有早期帧,否则计算量高且上下文冗余。现有的历史选择方法通常通过匹配当前视觉内容来检索过去信息,这能捕捉与当前相关的内容,但可能遗漏未来才会变得重要的早期内容。作者认为,历史相关性应由未来信息需求决定,即使未来尚未生成。为解决这一问题,作者提出 FRAMEMORROW,它预测一小组 prospective tokens 作为未来需求的紧凑代理,并利用它们选择显式历史帧。这使得选择器保持轻量且即插即用,可适配包括闭源模型在内的多种生成器,并在评估中改善长程一致性、视觉质量和动作对齐。
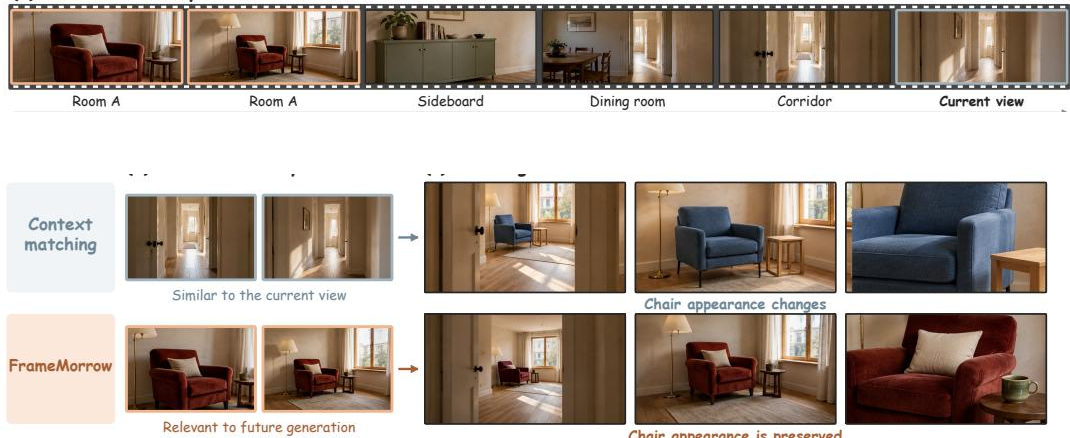
方法
作者提出 FRAMEMORROW,这是一种位于生成器外部的未来式选择器,用于识别和检索视频生成所需的相关历史帧。该模型不生成未来内容,而是预测一组紧凑的 prospective tokens,以表示未来信息需求。这些 tokens 评估可参与选择的历史帧的相关性,并引导选择过程,最终增强兼容的冻结生成器。
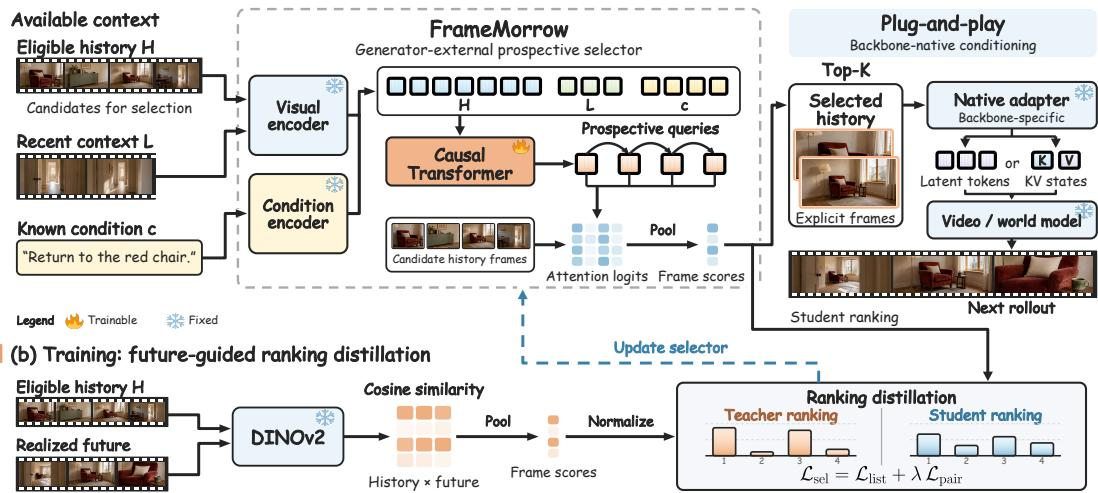
该框架通过区分近期上下文与可用的长期历史来运作。在给定 rollout 步中,近期上下文为选择过程提供信息,但不占用长期记忆预算,而可用历史则作为检索的候选池。已知的 rollout 条件,例如文本 prompt 或动作序列,也被纳入以引导选择。选择器为可用历史计算相关性分数,并选择 top-K 帧:
r^t=Sθ(Ht,Lt,ct+)∈RN,It=TopK(r^t,K)为了表示未来信息需求,一个因果 Transformer 自回归地预测一小组 prospective tokens。可用历史、近期上下文和 rollout 条件首先由冻结的视觉编码器和模态专用编码器编码,再经过可学习投影。因果 Transformer 处理这些编码后的序列并生成 prospective tokens:
qtm=Fψ(Ht,Lt,Ct+,qt<m),m=1,…,M每个 token 都可以以前序 token 为条件,使预测能够捕捉复杂依赖关系。随后,这些 prospective tokens 作为对可用历史帧的注意力查询。模型计算投影后的 tokens 与编码后的历史帧之间的缩放点积注意力 logits,并用平滑最大值函数聚合,从而为每个历史帧生成最终相关性分数。
在训练阶段,作者采用一种基于未来监督的排序蒸馏策略来监督 prospective tokens。一个冻结的视觉教师模型,具体为 DINOv2 编码器,评估候选历史帧与已实现的未来延续之间的对应关系。通过计算编码历史帧与未来帧之间的余弦相似度,教师模型导出视觉相关性代理。这些相似度用平滑最大值聚合,以偏向至少对应一部分未来内容的帧。教师和学生分数都被归一化为排序分布。选择器使用 listwise 排序损失与 pairwise 排序损失的组合进行优化:
Lsel=Llist+λLpairlistwise 项使学生的完整概率分布与教师对齐,而 pairwise 项保留在教师排序中按特定间隔分开的帧的相对顺序。该蒸馏过程确保 prospective tokens 学会识别历史相关帧,而无需在推理时显式生成未来内容。
在推理时,基于未来延续的目标构造被完全移除。选择器仅使用可用的历史、近期上下文和 rollout 条件对已观测帧进行编码并预测 prospective tokens。选定的显式历史帧随后通过即插即用机制集成到生成流程中。每个冻结主干通过其自身的原生条件机制处理这些选定帧,例如参考帧接口或记忆适配器。这种设计使选择器能够动态决定提供哪些历史证据,同时生成器保留其原始架构和处理方式,无需训练额外的条件模块。
实验
实验在五种设置下评估 FRAMEMORROW:长视频生成、单镜头和多镜头交互式生成、闭源生成器以及动作条件世界模型。在开源主干中,它持续改善生成一致性和 prompt 对齐,后期分段的收益更大,并且通过闭源模型的参考条件接口仍然有效。在世界模型基准上,它增强了视觉一致性、抗闪烁和动作对齐,同时保持运动质量。消融研究表明,基于未来推导的排序目标、选择相关历史帧而非简单增加帧数,以及四个自回归 prospective tokens 提供了大部分收益,推理开销仅适度增加。
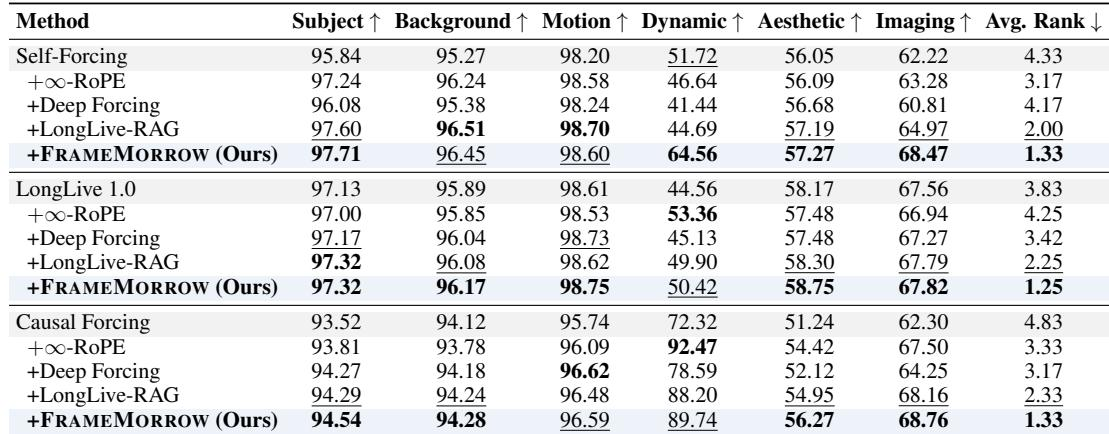
FRAMEMORROW 在 60 秒生成的三个评估主干上均取得长上下文方法中的最佳平均排名。在 Self-Forcing 上,它在成像质量和动态程度上带来明显提升,而 LongLive-RAG 保持更高的背景和运动分数。一致的平均排名优势支持帧选择在不同生成器上的有效性,尽管单项指标存在权衡。FRAMEMORROW 在 Self-Forcing、LongLive 1.0 和 Causal Forcing 主干上均取得最佳平均排名。在 Self-Forcing 上,FRAMEMORROW 将成像质量从 62.22 提高到 68.47,将动态程度从 51.72 提高到 64.56。尽管 FRAMEMORROW 在 Self-Forcing 上的平均排名更好,LongLive-RAG 仍保持更高的背景和运动分数。
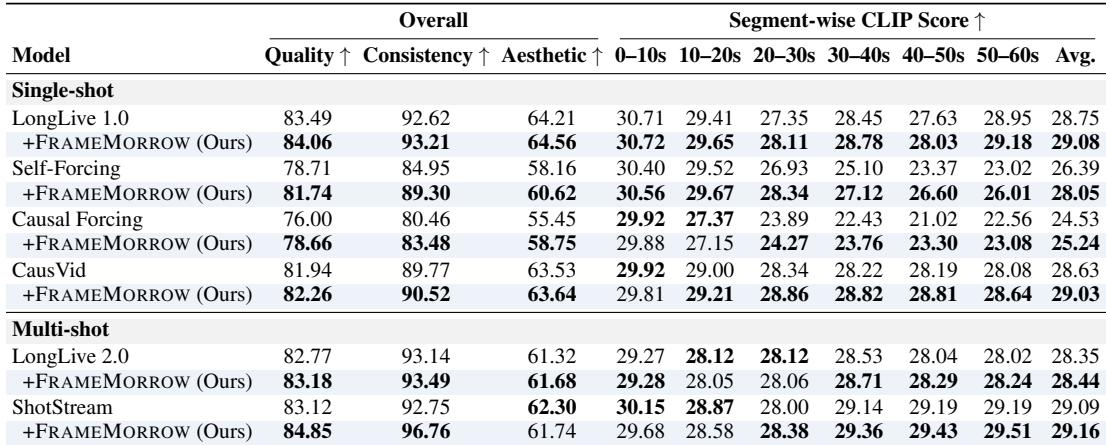
在 60 秒的单镜头交互式视频生成中,FRAMEMORROW 相对于所报告的原生主干提高了整体质量、一致性和美学分数。分段的 CLIP 分数增益在较晚的 10 秒区间更大,尤其是 Self-Forcing,这表明后期 prompt 对齐更强。对于单镜头生成,FRAMEMORROW 在 LongLive 1.0 和 Self-Forcing 基线上改善了整体质量和一致性。在 Self-Forcing 上,一致性从 84.95 上升到 89.30,而分段 CLIP 分数增益在前 10 秒最小,在最后 10 秒最大。对于所报告的主干对,美学分数也适度提高,且较晚的 10 秒窗口显示更大的 prompt 对齐增益。
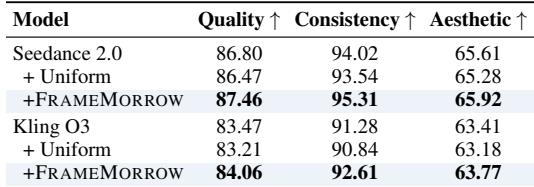
在 Seedance 2.0 和 Kling O3 上的闭源生成测试中,使用相同参考预算时,FRAMEMORROW 相对于原始生成器和均匀历史帧选择均提高了质量、一致性和美学分数。均匀选择相对于原生基线略微降低了所有报告的指标。结果表明,该方法可以通过公开的参考条件接口工作,而无需访问生成器内部。FRAMEMORROW 在两个闭源生成器的所有报告指标上均优于均匀选择。均匀历史帧选择相比原始闭源基线降低了质量、一致性和美学分数。FRAMEMORROW 在 Seedance 2.0 和 Kling O3 上相对原生生成器实现了一致性提升。
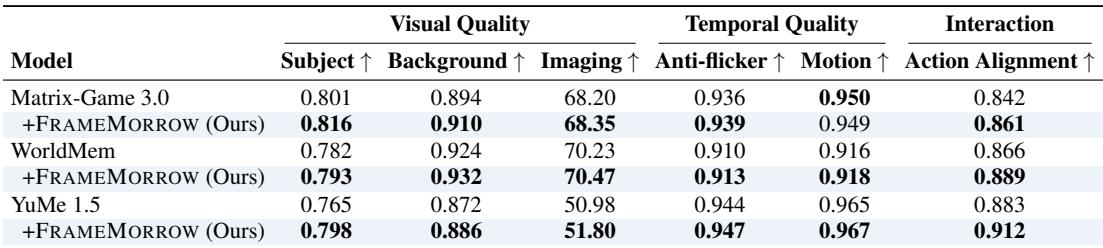
FRAMEMORROW 在 Matrix-Game 3.0、WorldMem 和 YuMe 1.5 上持续改善主体一致性、背景一致性、成像质量、抗闪烁和动作对齐。运动质量基本保持稳定,仅有双向的小幅变化。这些提升在每个基础模型对内均出现,表明该方法有益于多种交互式世界模型。FRAMEMORROW 提高了所有三个主干上的动作对齐,其中在 YuMe 1.5 上提升最大。在每对评估中,主体一致性、背景一致性、成像质量和抗闪烁都优于对应的基础模型。运动分数几乎不变,表明该方法在保持运动质量的同时改善了一致性和控制对齐。
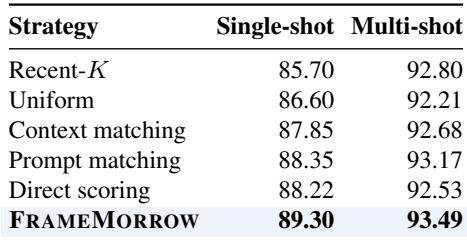
FRAMEMORROW 在单镜头和多镜头生成中均优于所有五种历史帧选择策略。Prompt matching 是最强基线,其后是直接评分和上下文匹配,而简单近因采样和均匀采样相对落后。性能差距在单镜头生成中比多镜头生成中更明显。FRAMEMORROW 在单镜头和多镜头设置中均取得最高一致性分数。Prompt matching 是表现最好的基线,直接评分和上下文匹配也具竞争力。简单近因采样和均匀采样落后于学习式匹配和评分策略。与单镜头生成相比,所有策略在多镜头生成中都有改善。FRAMEMORROW 相对于最强基线的优势在单镜头生成中大于多镜头生成。
在各项实验中,FRAMEMORROW 在多种主干上的长上下文生成、单镜头交互式视频、通过公开参考条件接口的闭源 API、多种交互式世界模型以及与若干历史帧选择基线的比较中接受了评估。它持续取得最佳平均排名或最高一致性,并相对于原生基线改善主体一致性、背景一致性、成像质量、美学分数和动作对齐,同时运动质量保持稳定,偶尔在背景或运动分数上存在权衡。prompt 对齐的增益在较晚的 10 秒区间更强,该方法在单镜头生成中尤其优于均匀采样、近因采样和学习式评分基线。总体而言,结果表明 FRAMEMORROW 的帧选择有利于多种生成器和闭源场景,而无需访问生成器内部。