Command Palette
Search for a command to run...
UNIEVO-VL:一种用于多模态模型自我改进的在线策略自蒸馏训练方案
UNIEVO-VL:一种用于多模态模型自我改进的在线策略自蒸馏训练方案
摘要
现代多模态模型将生成与理解整合到同一个统一系统中,使其能够提供自身反馈并从中学习。受这一统一能力的启发,我们提出 UniEvo-VL,一个自进化框架,使多模态模型在测试时计算过程中能够从这种建设性的自我纠正反馈中学习。我们不再依赖一个独立的、通常更大的教师模型,而是利用模型的自我批评作为特权信息,让同一个多模态模型在不同上下文下同时扮演教师和学生。学生仅看到原始问题,而教师则以特权批评信息为条件。随后,训练在学生自身的采样轨迹上最小化二者去噪扩散分布之间的逐状态散度。实验表明,UniEvo-VL 提升了多模态模型的图像生成能力,同时保持其对额外反思信息的敏感性。具体而言,我们以开源 Qwen-image-2512 为基础构建,观察到在 GenEval 上性能从 0.747 显著提升至 0.808,在 GenEval2 Soft-TIFA 上从 32.97 提升至 35.53。此外,使用更强外部批评者(如 GPT5.6-Luna)的尝试表明,具有强评判能力的多模态模型能够预示着更高的自进化上限。最后但同样重要的是,混合的文本渲染结果表明,我们的自我改进在不同任务上可能并不均衡。我们的研究旨在为当前热门的递归自我改进研究方向提供启示,以提升在无外部监督或引导情况下使用多模态模型的用户体验。
一句话总结
斯坦福大学、约翰斯·霍普金斯大学及合作者提出 UniEvo-VL,这是一个自进化框架:将单个多模态模型同时用作教师和学生,让教师以自我批判为条件,并最小化去噪扩散分布之间的逐状态散度。该框架在无外部监督的情况下,将 Qwen-image-2512 在 GenEval 上的图像生成分数从 0.747 提升到 0.808。
核心贡献
- UniEvo-VL 引入了以批判为条件的同策略(on-policy)自蒸馏框架,其中一个多模态模型同时充当教师和学生。教师以自生成的纠正性批判为条件,而学生只看到原始提示;训练沿着学生自身的采样轨迹匹配去噪分布,不需要修正图像目标,也不使用基于奖励的策略优化。
- 该工作通过比较训练前后的直接生成和反思辅助生成,将学到的改进与推理时纠正区分开来。这种成对评估将保留在初始模型中的收益与测试时反思带来的额外收益分开。
- 在 Qwen-image-2512 上的实验将 GenEval 从 0.747 提升到 0.808,将 GenEval2 Soft-TIFA 从 32.97 提升到 35.53。对批判模型选择和修订后验证的进一步分析表明,使用更强外部批判模型(如 GPT5.6-Luna)的尝试显示出更高的自进化上限,但文本渲染任务中的提升并不均匀。
引言
统一多模态模型既能生成图像,也能理解图像,这为通过自我批判实现自进化创造了机会。在组合式图像生成和视觉文本渲染中,先前的自改进方法依赖选择自生成输出进行微调、用反思三元组训练,或将多模态评估转化为奖励。然而,这些方法没有将纠正性反馈直接迁移到依据原始提示并沿自身采样轨迹生成的策略中;批判说明了应当修复什么,但没有说明中间去噪预测应如何改变。作者们通过 UniEvo-VL 弥补这一差距。UniEvo-VL 是一个自蒸馏框架,其中教师模型以批判修订后的提示为条件,学生模型只观察原始请求,学生自身轨迹上的预测被对齐。这样就将视觉批判转化为逐状态的稠密监督,不需要修正图像目标,也不使用基于奖励的策略优化。
方法
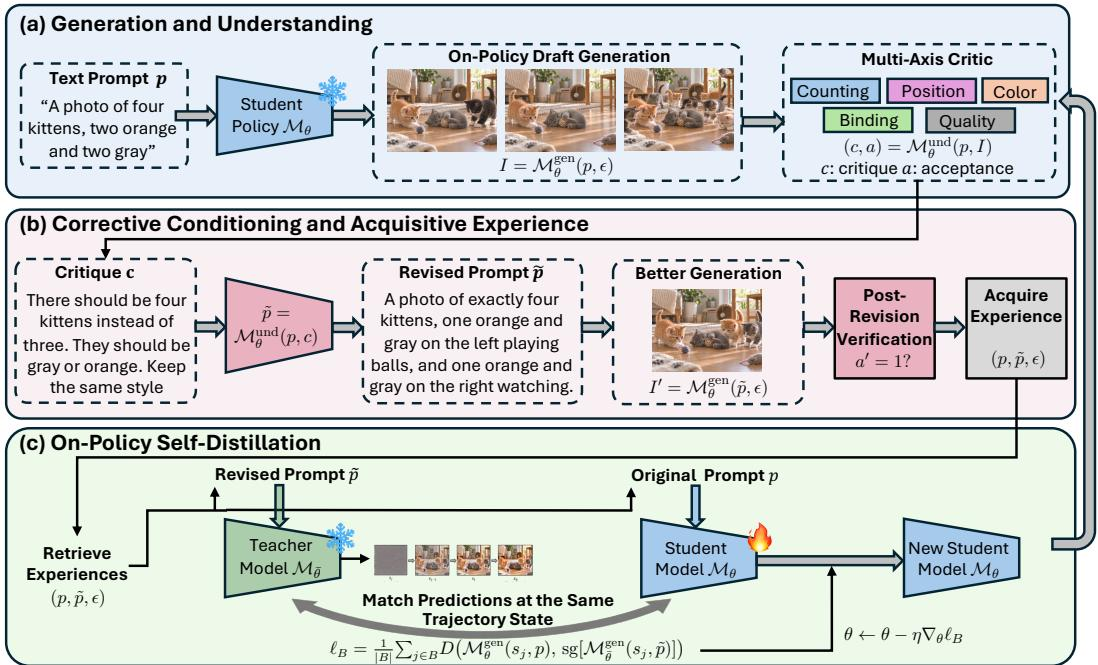
UniEvo-VL 围绕单个多模态模型 Mθ 构建,该模型支持两种工作模式:生成和理解。在生成模式下,模型将提示 p 和采样噪声 ϵ 映射为图像:
I=Mθgen(p,ϵ).在理解模式下,模型根据条件提示 p 评估图像 I,返回二元接受决定 a 以及差异描述 c:
(c,a)=Mθund(p,I).当 a=1 时,图像被视为与提示一致,不需要修订。当 a=0 时,图像被视为有缺陷,c 提供纠正性反馈。空的或不可用的批判响应被视为无效,并从循环中移除。
作者们通过纠正性条件连接生成与理解,并定义了两种策略。学生策略 Mθ 只观察普通提示 p。教师策略是同一模型的指数移动平均版本 Mθˉ,并且允许观察特权纠正信息。这种设置使教师能够生成反映纠正的蒸馏目标,而学生必须学会在没有特权上下文的情况下实现相同行为。
对于收到有效拒绝且 a=0 的图像,理解模式根据原始提示 p 和纠正性反馈 c 合成特权提示 p:
p=Mθund(p,c).特权提示重新陈述所请求的场景,同时明确解决 c 中指出的差异。例如,如果原始提示要求两个红色杯子,但模型生成了三个杯子,则构造 p 以强调恰好两个杯子,同时保留指定的颜色和场景。
在将修订提示用于训练之前,UniEvo-VL 应用修订后验证阶段。学生模型使用相同噪声从修订提示重新生成图像 I′:
I′=Mθgen(p,ϵ).随后,理解模式根据原始提示 p 评估重新生成的图像。只有当第二轮评估有效并接受 I′ 时,修订提示才会被接受,这表明修订提示能够产生更对齐的图像。重新生成的图像 I′ 仅用于验证提示,之后不会被当作训练目标。
在收集到有效的修订提示后,方法使用同策略自蒸馏。对于来自当前接受集合 Ak 的训练三元组 (p,p,ϵ),学生策略执行 T 步去噪轨迹,仅以 p 为条件:
τ={s0,…,sT},其中每个 sj 是中间潜在状态。学生只观察原始提示,与推理时条件一致。教师观察包含纠正建议的特权提示 p,因此产生更丰富的去噪目标。
训练目标是在每个采样状态上对齐学生单步转移与教师转移。令 Mθgen(sj,p) 表示学生转移,Mθˉgen(sj,p) 表示教师转移。蒸馏损失为:
L(θ)=E(p,p,ϵ)∼Ak,τ∼Mθgen(p,ϵ),sj∼τD(Mθgen(sg[sj],p),sg[Mθˉgen(sg[sj],p)]),其中 D(⋅,⋅) 是诸如 KL 散度或 Jensen-Shannon 散度之类的散度,sg[⋅] 表示停止梯度。生成、评估和提示合成均不进行梯度流动,因此梯度仅更新学生参数 θ。在基于流的实现中,散度被实例化为确定性潜在转移之间的平方误差。
实验
实验评估了一个 Qwen-Image 生成和 Qwen-VL 反馈设置,其中仅更新生成器 LoRA 参数,并在采用与不采用修订后验证的两种设置下测试 GenEval、GenEval2 和 OCR 文本渲染。经过验证的反馈普遍改善直接生成,提升集中在基础模型最初表现困难的提示上,对较简单提示只有小幅退化。训练迁移了反思收益,同时额外反思仍然有用;更强的外部批判产生更好的组合式结果,但其收益取决于类别特定技能。
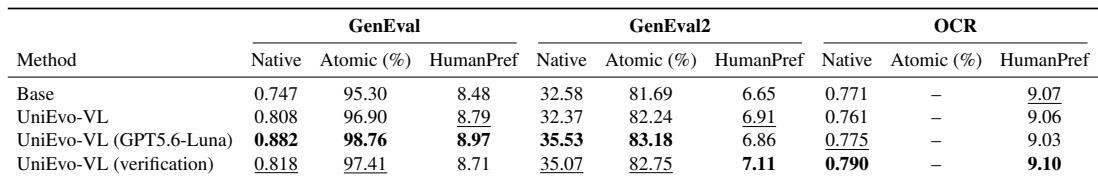
表格比较了 Base、未验证 UniEvo-VL、采用 GPT-5.6-Luna 反馈的 UniEvo-VL 和验证后 UniEvo-VL 在 GenEval、GenEval2 和 OCR 上的直接生成性能。验证后 UniEvo-VL 在三个任务的所有报告指标上都超过 Base,而外部批判模型配置在多个 GenEval 和 GenEval2 指标上领先。任务特定差异仍然存在:验证后反馈在 OCR 上最强,外部反馈在 GenEval 原生和 atomic 指标上最强。验证后 UniEvo-VL 在 GenEval、GenEval2 和 OCR 的所有报告指标上都超过 Base,但不同配置在个别指标上领先,GPT-5.6-Luna 外部批判模型取得最高的 GenEval 和 GenEval2 原生和 atomic 分数。在 OCR 上,验证后 UniEvo-VL 在原生分数和 HumanPref 上领先,而未验证 UniEvo-VL 在这两项指标上低于 Base;在 GenEval2 上,未验证 UniEvo-VL 在原生 Soft-TIFA 上略低于 Base,尽管提高了 atomic 准确率和 HumanPref。
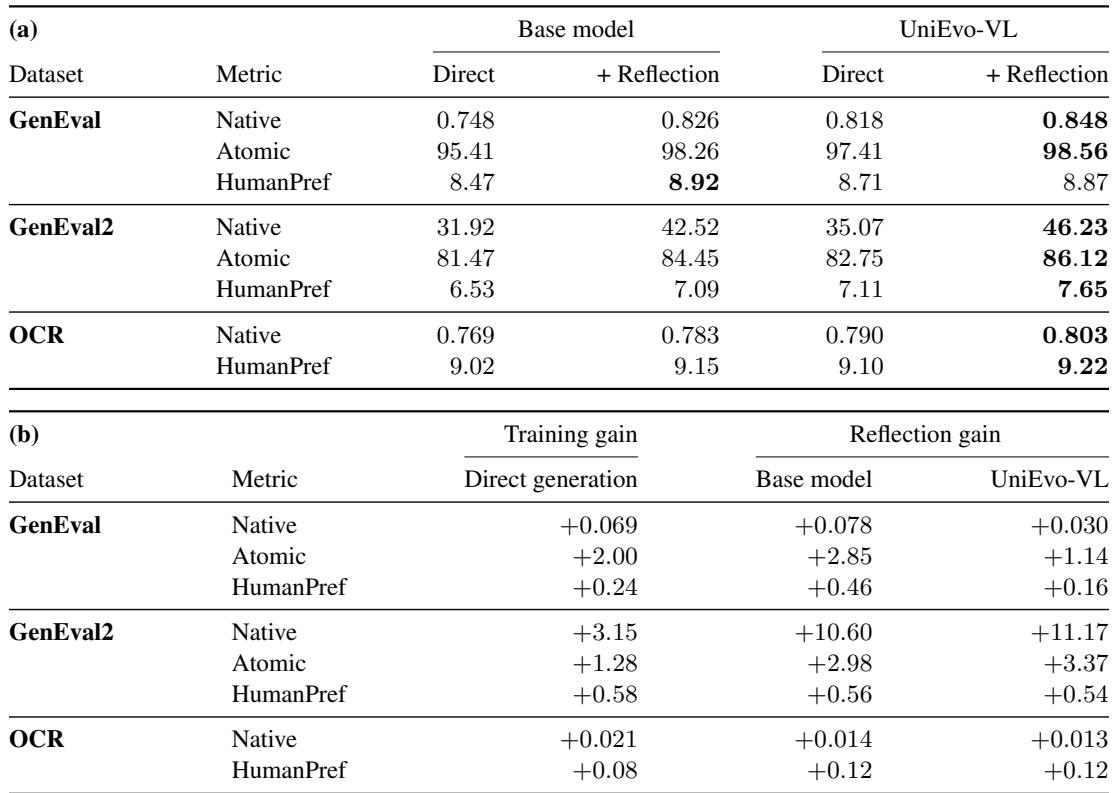
训练改善了 GenEval、GenEval2 和 OCR 上所有报告指标的直接生成表现。进化后模型的直接原生分数在 GenEval 和 OCR 上接近或超过带反思的基础模型,但在 GenEval2 上仍低于后者。反思进一步改善了进化后模型的每个指标,组合设置在三个基准上取得最高原生分数。训练后直接生成在三个基准的所有报告指标上都有提升。在直接生成方面,进化模型在 GenEval 上接近带反思的基础模型,在 OCR 上超过后者,而在 GenEval2 上仍低于后者。训练后的反思收益在 GenEval 上缩小,但在 GenEval2 上仍然显著,在 OCR 上变化不大。将训练与反思结合在三个基准上都获得最高原生分数,尽管带反思的基础模型仍保持略高的 GenEval HumanPref 分数。
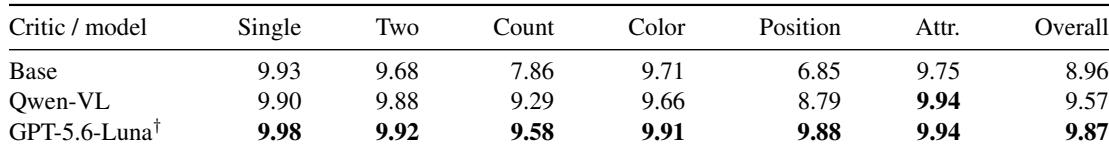
更强的批判模型反馈改善了组合式生成,但收益与技能相关,并且在基准之间并不均匀。更强批判模型取得最高的总体 GenEval 分数,在空间组合类别(如位置和计数)中提升最大。在 GenEval2 上,更强批判模型在双物体组合和颜色方面带来更大收益,而位置和属性分数仅适度提升。更强批判模型反馈产生最高的总体 GenEval 分数和更大的空间组合收益,尤其是在位置和计数方面。在 GenEval2 上,与 Qwen 反馈相比,更强批判模型反馈对双物体组合和颜色的改善更大,而位置和属性收益仍然有限。Native Soft-TIFA GM 印证了这一趋势:更强批判模型相对基线有所提升,而 Qwen 反馈略有下降。
这些实验评估了 GenEval、GenEval2 和 OCR 上的文本到图像生成,比较了基础模型、训练后的 UniEvo-VL 变体和批判模型引导反馈。验证后反馈在三个基准上都一致优于基础模型,外部批判模型反馈在多个 GenEval 指标上领先,验证后反馈在 OCR 上最强。训练改善了跨基准的直接生成,训练与反思结合取得最高原生分数,尽管反思收益在 GenEval 上缩小,在 GenEval2 上仍较大。更强的批判模型反馈改善了组合式生成,尤其是空间组合和双物体组合,但收益不均匀且与技能相关。