Command Palette
Search for a command to run...
STEPQUANT:Delta 规则循环状态量化中误差何时与何处重要
STEPQUANT:Delta 规则循环状态量化中误差何时与何处重要
Bingchen Yao Haobo Xu Haokun Lin Yichen Wu Ziyu Guo Renrui Zhang Zhichao Lu Zhenan Sun Ying Wei
摘要
线性注意力以固定尺寸的循环状态取代不断增长的 KV 缓存,但在并发服务场景下,这些持久状态可能成为显著的内存瓶颈。直接将循环状态量化到低精度通常会导致严重的精度下降,因为量化误差会通过逐次状态更新传播。我们发现这些误差的影响取决于两个互补的维度:在时间上,长寿命记忆中的误差可以跨多个解码步骤持续存在;在空间上,不同 key 行中的误差对模型输出的影响不同,同时状态幅值沿行和列均存在显著变化。基于这些观察,我们提出 STEPQuant,一种面向 Delta 规则循环状态的时空训练后量化框架。STEPQuant 根据误差大小和记忆寿命分配精度,并基于状态分布和 key 行对输出误差的影响联合拟合 key 行和 value 列的缩放系数。在 Qwen3.8-27B 和 Kimi-Linear-48B-A3B-Instruct 上,跨长生成与短生成基准的实验表明,在标称 6 比特预算下,STEPQuant 达到接近 FP32 状态的精度,并且其 4 比特配置优于均匀 INT8。集成到 SGLang 并配合优化的 GPU kernel 后,6 比特 STEPQuant 实现了超过 5 倍的循环状态压缩,并将总服务内存最多降低 68.7%。
一句话总结
浙江大学、中国科学院、清华大学等机构的研究人员提出 STEPQuant,一种面向 Delta-rule 循环状态的时空后训练量化框架,根据误差幅度和记忆寿命分配精度,同时联合拟合键行和值列缩放,在 Qwen3.8-27B 和 Kimi-Linear-48B-A3B-Instruct 上以 6 位精度匹配 FP32 状态精度,实现超过 5× 的循环状态压缩,并将总服务内存最高降低 68.7%。
核心贡献
- Delta-rule 循环状态中量化误差的影响取决于两个互补维度:时间持久性,即长寿命记忆中的误差可能在多个解码步骤中持续存在;空间结构,即不同键行对输出的影响不同,同时状态幅度沿行和列变化。
- 提出 STEPQuant,一种面向 Delta-rule 循环状态的时空后训练量化框架,根据误差幅度和记忆寿命分配精度,并基于状态分布和键行对输出误差的影响联合拟合键行和值列缩放。
- 在 Qwen3.8-27B 和 Kimi-Linear-48B-A3B-Instruct 上的长生成和短生成基准实验表明,在标称 6 位预算下,6 位 STEPQuant 紧密匹配 FP32 状态精度,其 4 位配置优于均匀 INT8。在 SGLang 中集成并采用优化 GPU 内核后,6 位 STEPQuant 实现超过 5× 的循环状态压缩,并将总服务内存最高降低 68.7%。
引言
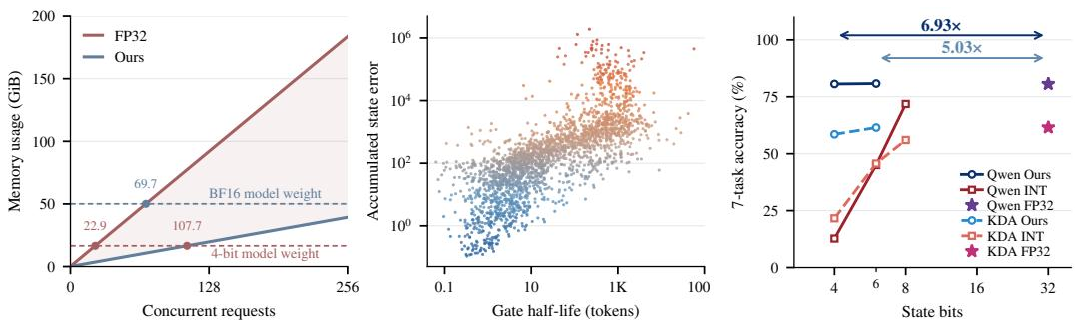
混合线性注意力模型(如 Qwen3.8-27B 和 Kimi-Linear-48B-A3B-Instruct)用固定尺寸的门控 Delta-rule 循环状态替代不断增长的 softmax KV 缓存,但在并发服务期间,每个请求都需要自己的持久状态,因此状态池内存随并发增长,即使在短上下文场景下也可能超过权重内存。直接均匀量化虽能减小这一占用,但会严重降低精度,因为误差会通过反复状态更新在时间上累积,同时也取决于状态内部的空间位置。作者分析了这些误差模式,并提出 STEPQuant,它结合了基于寿命的混合精度位分配和基于键行的双轴缩放。在标称 6 位预算下,STEPQuant 在两种模型上紧密匹配 FP32 状态精度,其 4 位设置在 SGLang 中优于均匀 INT8,同时实现超过 5× 的循环状态压缩和更快的状态更新。
方法
作者采用对称均匀量化将浮点循环状态映射到有限的一组离散级别,以降低存储需求。在每个解码步骤中,模型以浮点方式更新重建状态并计算输出,之后更新后的状态被量化以供存储。然而,这一过程会递归地将量化误差反馈回状态更新。第 t 步的累积误差由转移矩阵刻画,该矩阵通过保留门和 Delta 更新衰减已有误差。当保留值接近 1 时,误差可能持续多个解码步骤。因此,门半衰期较长的循环头往往累积更大的状态误差,直接施加均匀量化会在低位宽下严重降低模型性能。
为了缓解时间误差累积,作者提出寿命感知位分配(Lifetime-Aware Bit Allocation),这是一种混合精度量化方法,在固定位预算下根据量化误差的持久性分配精度。对每个循环状态单元,方法估计不同位宽下的重建失真,并计算平均对数保留率以确定记忆寿命。经过 j 次更新后的误差保留因子按指数近似,得到表示误差持续时长的寿命权重。给定平均位预算后,该方法从候选位宽集合中选择位宽,以最小化寿命加权重建失真。该目标确保量化误差较大、记忆寿命较长的单元获得更高精度,而风险最高的单元以 FP16 形式保留为稀疏枢轴。
除时间传播外,作者分析了状态矩阵内量化误差的空间分布。不同键行中幅度相同的误差对读出的影响不同,这取决于由转移矩阵和查询向量导出的加权因子。为捕捉这一点,作者将行影响分数定义为校准 token 上加权因子平方的期望。对影响分数较高的键行进行量化会导致更大的困惑度下降。此外,循环状态矩阵沿键行和值列都表现出大幅值离群值,这种双轴几何结构在解码过程中持续存在。与针对单一主导轴的常规量化不同,这种双轴结构需要更灵活的缩放方法。
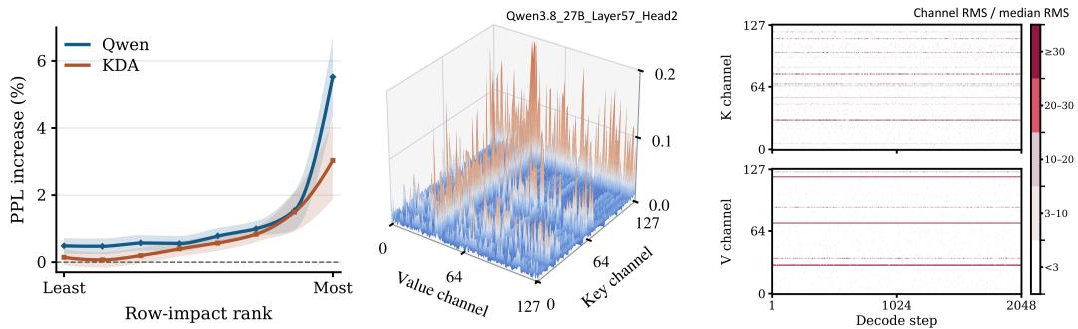
为解决循环状态的空间特性,作者引入键行感知双轴拟合(Key-Row-Aware Dual-Axis Fitting),结合校准后的行影响分数与独立的行、列缩放。更新后的状态表示为行因子、列因子和低位整数的乘积。每个键行的行因子同时考虑其当前幅度和对读出误差的影响,采用平方根缩放为大幅值行提供更宽的量化范围,并为高影响行提供更细的分辨率。给定行因子后,通过最小化影响加权重建误差拟合列缩放,对高影响键行上的误差施加更大惩罚。最后,每个缩放后的条目被量化到指定精度下最接近的可表示级别。
作者将所提量化方案实现为打包状态内核,并集成到 SGLang 循环状态池中。寿命感知位分配和 FP16 枢轴选择离线执行,确保没有逐 token 分配开销。在解码期间,融合内核处理分块状态重建、Delta 更新和当前读出,以减少内存流量。一旦获得头部输出,键行感知双轴拟合和打包回写会在单独的 CUDA 流上执行,与模型计算重叠缩放更新,并在 token 之间保持状态压缩。
实验
评估在 SGLang 上使用两个线性注意力模型,并分别采用 BF16 和 AWQ 量化权重,覆盖七个长生成推理基准和六个短语言理解任务。STEPQuant 表明,循环状态可以量化到 4 到 6 位且精度损失有限,优于均匀整数量化,并且在与 4 位 AWQ 权重量化结合时仍保持有效。消融实验确认空间键行感知拟合和 FP16 枢轴保护是互补的,而生成长度和效率结果表明 STEPQuant 避免输出过长,并显著降低内存和状态更新成本。
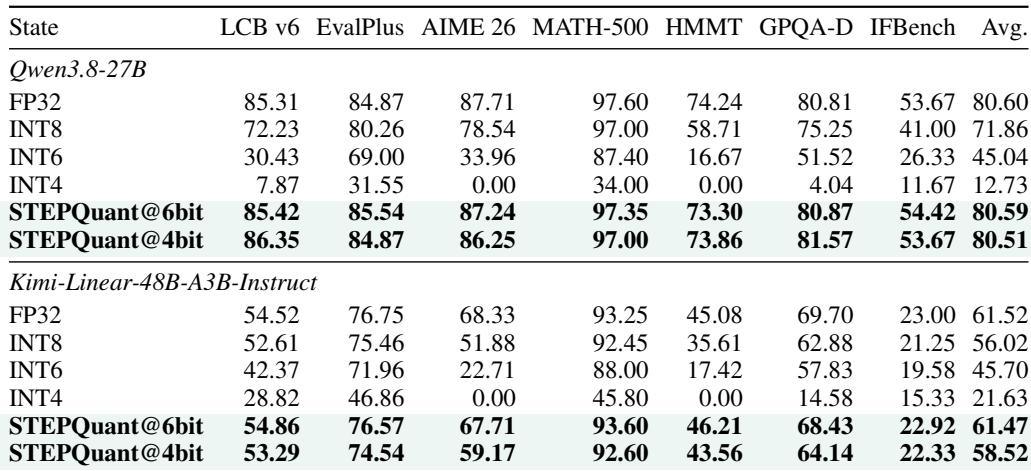
在长生成推理任务上,6 位和 4 位 STEPQuant 都紧密跟踪 FP32 状态基线,而均匀量化随着位宽降低显著退化。尤其是均匀 INT4 在多个任务上崩溃至接近零精度,而 STEPQuant 在七个任务集上保持竞争力。这些结果表明,使用 STEPQuant 时低位循环状态量化可以保持长推理精度。STEPQuant@6bit 和 STEPQuant@4bit 的平均精度几乎与 FP32 相同,而均匀 INT6 和 INT4 远低于此。在 AIME 和 HMMT 等任务上,均匀 4 位精度降至零,而 STEPQuant@4bit 仍接近 FP32。
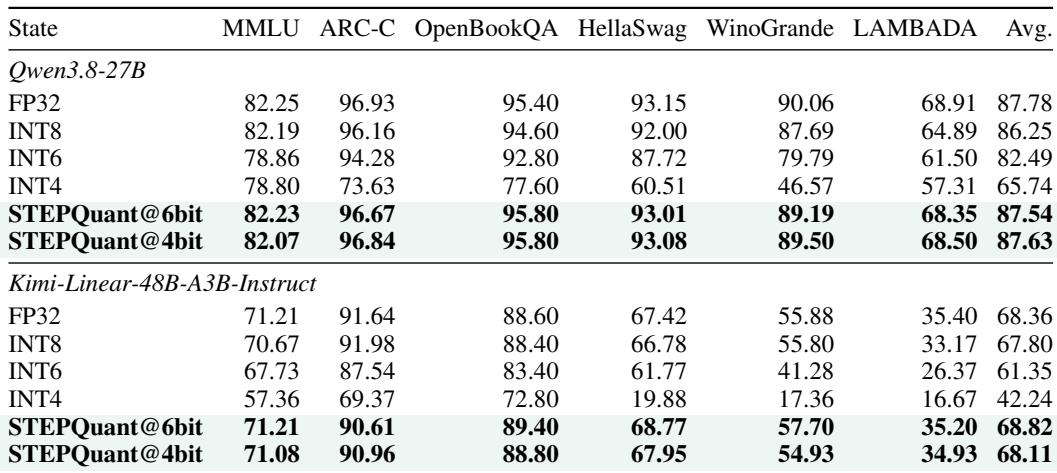
在 Qwen 短生成基准上,6 位和 4 位循环状态精度的 STEPQuant 紧密匹配 FP32 基线。位宽越低,均匀量化退化越严重,均匀 INT4 在平均精度和单任务精度上均出现大幅下降。4 位 STEPQuant 也超过 INT8 平均精度,同时仍接近 FP32。4 位 STEPQuant 与 FP32 基线的平均分仅相差 0.15,而均匀 INT4 从 87.78 降至 65.74。在 WinoGrande 上,均匀 INT4 从 90.06 降至 46.57,而 4 位 STEPQuant 保持 89.50。
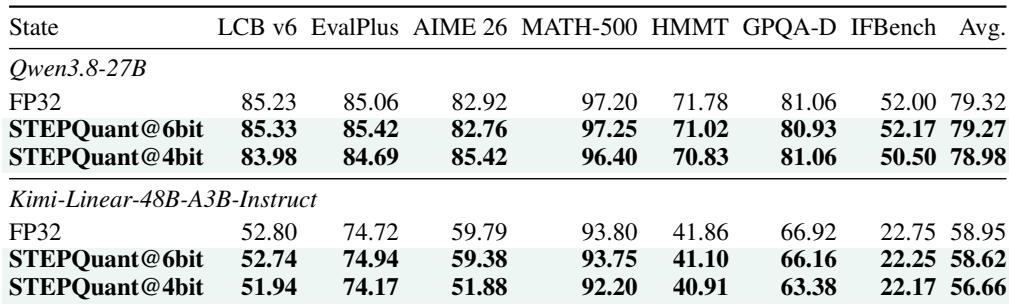
在采用 4 位 AWQ 量化权重时,6 位 STEPQuant 状态压缩在 Qwen 和 Kimi 上几乎达到 FP32 状态的推理精度。Qwen 的 4 位状态配置也接近其 FP32 状态基线。这表明 STEPQuant 在与权重量化结合时仍然有效。在 Qwen 和 Kimi 上,6 位 STEPQuant 的七任务平均精度与 FP32 状态基线相差不到 1 个点。在 Qwen 上,4 位状态配置保持与 FP32 状态精度的竞争力,并在部分任务上有所提升。将 STEPQuant 与 AWQ 权重量化结合可保持推理性能,支持内存高效部署。
在 Qwen 长推理任务上的消融实验显示,空间键行感知拟合和带 FP16 枢轴的时间混合精度分配均比均匀量化和基线量化提升精度。完整 STEPQuant 组合显著优于每一单独部分,并在 6 位下紧密跟踪 FP32 精度。移除枢轴保护或使用均匀量化会导致精度大幅下降。仅空间量化优于 Q-Mamba 基线,表明键行感知双轴拟合能提升长推理精度。用 FP16 枢轴保护一小部分头相比无枢轴保护的时间分配带来显著增益。将空间和时间部分结合可取得最佳量化精度,在 6 位预算下紧密匹配 FP32。均匀 INT6 量化远落后于 FP32 和各个组件变体,证实了所提保护机制的必要性。
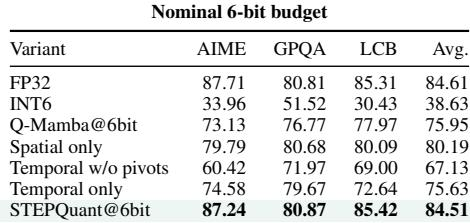
评估涵盖长生成推理任务、短生成基准、权重量化组合以及 STEPQuant 各组成部分的消融实验。在长生成任务上,6 位和 4 位循环状态精度的 STEPQuant 紧密跟踪 FP32 状态基线,而均匀量化急剧退化,均匀 INT4 常常崩溃至接近零精度。短生成结果同样显示 4 位 STEPQuant 仍接近 FP32,甚至优于均匀 INT8,并且该方法在与 AWQ 权重量化结合时仍然有效。消融实验确认,空间键行感知拟合和带 FP16 枢轴的时间混合精度分配均发挥作用,二者结合后在低位预算下取得接近 FP32 的量化精度。