Command Palette
Search for a command to run...
MotorMind:为通用视觉语言模型搭建零样本机器人操作脚手架
MotorMind:为通用视觉语言模型搭建零样本机器人操作脚手架
Bingxuan Li Siqi Song Yizhuo Wu Jiarui Yao Tong Zhang Huan Zhang
摘要
视觉-语言-动作(VLA)模型推动了机器人操作的发展,但它们在新任务和新环境中的零样本泛化能力仍然有限,而且对专门训练的依赖使其无法直接受益于快速发展的通用视觉语言模型(VLM)。与此同时,近期智能体机器人系统利用 VLM 进行高层推理,或利用编程智能体进行机器人控制,但往往依赖大量外部模型和工具,带来额外复杂性和成本。这促使我们提出一个问题:通用 VLM 本身能否更像人类遥操作员那样操作机器人,即直接从观察中推理、发出动作并持续根据执行反馈进行调整,而不依赖诸如学习到的动作专家、编程智能体或类似 SAM3 的定位工具等外部模型?在本工作中,我们提出了 MotorMind,这是一种机器人操作框架,将 VLM 提出的中层动作与确定性机器人控制和反馈相连接,并具备异步监控和后台记忆更新功能。在不进行任务特定策略训练、不使用编程智能体或 SAM3 等额外定位工具的情况下,MotorMind 在基础 LIBERO-PRO 套件上取得 66.7% 成功率,在扰动条件下取得 53.8% 成功率;而我们所评估的先前零样本方法分别至多为 13.3% 和 19.2%。同一接口在真实 xArm6 机器人上,在直接操作和人为扰动设置下平均成功率达到 95%。将骨干模型替换为更强的 VLM 可进一步提升性能,而剩余失败——主要源于视觉定位、具身推理和动作知识——会随着 VLM 能力提升而减少。这些结果表明,通用 VLM 在具备合适的中层动作表示和异步执行框架时,能够实现有效的零样本机器人操作。
一句话总结
伊利诺伊大学厄巴纳-香槟分校的研究人员提出了 MotorMind,一个机器人操作控制框架,将 VLM 提出的中层动作与确定性机器人控制和反馈相连接,并带有异步监控和后台记忆更新,从而在无需任务特定策略训练、coding agents 或 SAM3 等定位工具的情况下实现零样本操作,并在基础 LIBERO-PRO 套件上达到 66.7% 成功率,在扰动下达到 53.8%,在真实 xArm6 机器人上平均成功率达到 95%。
核心贡献
- 本文提出了 MotorMind,一个零样本机器人操作控制框架,通过中层动作表示将冻结的通用 VLM 连接到确定性机器人控制,并具备异步执行监控、后台记忆更新和结果验证。
- MotorMind 在 LIBERO-PRO 基础套件上达到 66.7% 成功率,在扰动下达到 53.8%,而此前被评估的零样本方法最高分别仅为 13.3% 和 19.2%;在真实 xArm6 机器人上的直接操作和人类扰动设置中,平均成功率达到 95%。
- 将 Qwen3.8-Flash-Next 主干替换为 GPT-6 Sol 后,LIBERO-PRO 基础套件成功率从 66.7% 提高到 83.3%;失败分析指出,视觉定位、具身推理和动作知识是剩余的主要瓶颈。
引言
视觉-语言-动作机器人基础模型将视觉观测和语言指令直接映射到机器人动作,但在物体外观、空间配置、任务语义和环境结构变化下,其零样本迁移能力有限。这些模型还在专用机器人数据上训练,无法直接受益于新兴的通用视觉语言模型。使用通用 VLM 进行规划的 Agentic 方法通常依赖外部组件,例如学习得到的动作专家、分割模型、技能库和运动规划器,这限制了简单性和通用性。为弥补这些不足,作者研究通用 VLM 是否能处理局部操作决策,并提出了 MotorMind,一个以 VLM 为中心的控制框架,该框架提供紧凑的平移、旋转和夹爪命令中层动作表示,通过后台监控和结果评估协调执行,并能在不同机器人本体之间迁移,无需任务特定策略训练。该设计在仿真和真实机器人上取得了较强的零样本表现,且在更强 VLM 主干下进一步改善,这表明通用多模态模型的进步可以直接转化为更强的机器人控制能力。
数据集
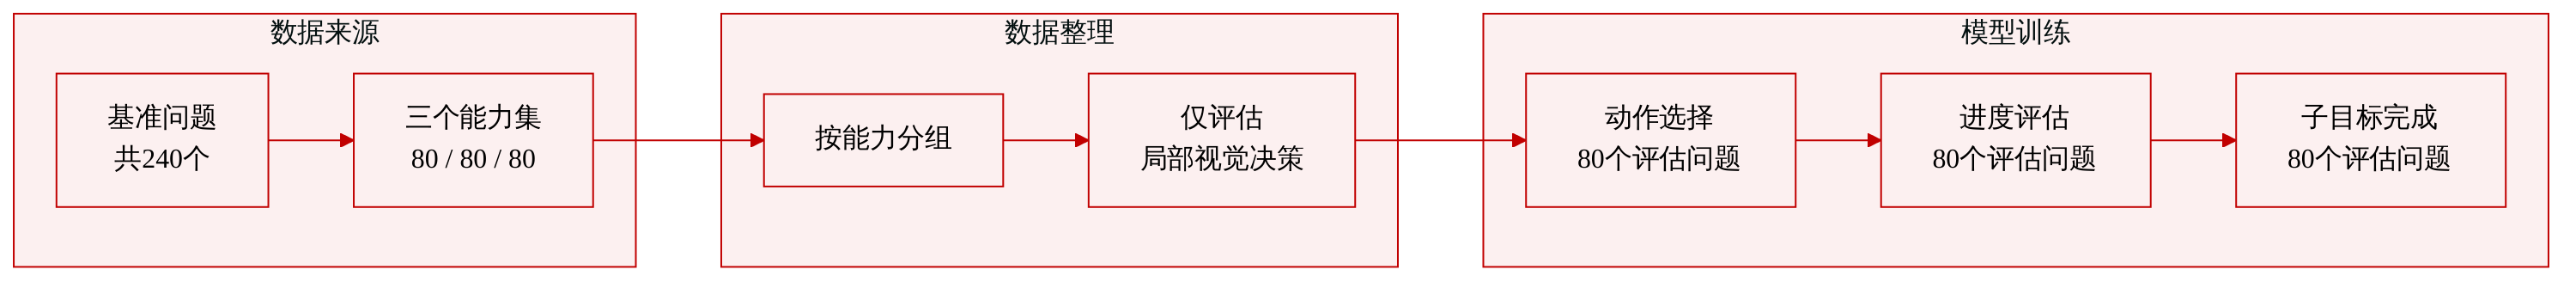
作者构建了一个用于诊断机器人操作中视觉语言模型的具身问答基准。摘录将其描述为评估数据集,而不是训练数据集。
-
构成和规模:共 240 个问题,平均分布在三种能力上:
- 动作选择:80 个问题
- 进度评估:80 个问题
- 子目标完成:80 个问题
-
底层来源:提供的文本没有描述原始机器人观测数据、采集过程或环境来源,仅说明作者构建了该基准。
-
动作选择子集:
- 要求模型使用过去和当前观测以及指令。
- 任务:选择下一个动作。
- 报告准确率在所有被评估模型中最低,表明这是最难的诊断能力。
-
进度评估子集:
- 要求模型判断观测到的转移是否推进任务。
- 使用过去和当前观测。
- 任务:判断是否已经实现当前子目标的进展。
-
子目标完成子集:
- 要求模型判断当前观测是否满足所声明的子目标和成功标准。
- 使用当前观测。
- 任务:判断当前子目标是已完成还是需要进一步动作。
-
处理和使用:
- 该基准评估局部视觉决策,而不是完整任务的闭环控制。
- 它用于在设计机器人策略之前诊断性地评估 VLM 能力。
- 摘录没有描述训练划分、混合比例或训练用途;这些数据用于模型评估。
-
论文中报告的示例诊断结果:
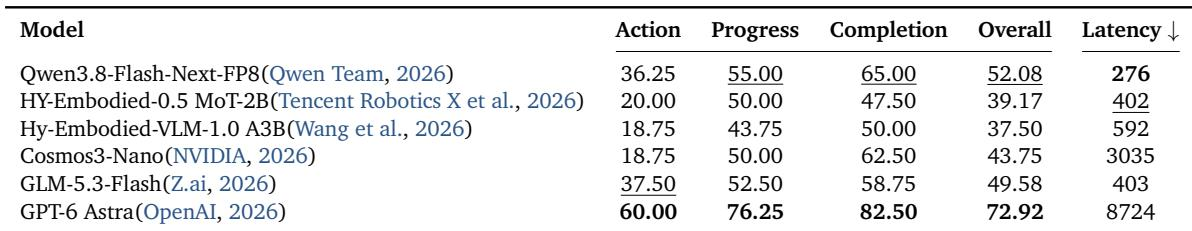
- Qwen3.8-Flash-Next:动作选择准确率 36.25%,进度评估准确率 55.00%,子目标完成准确率 65.00%。
- GPT-6 Astra:在三项能力上均达到最高准确率,但查询延迟高得多,每次查询 8.724 秒,而 Qwen3.8-Flash-Next 为 0.276 秒。
- 这些发现促使下游机器人系统采用可修订、反馈驱动的控制接口。
方法
作者设计 MotorMind,通过结构化控制框架将冻结的通用视觉语言模型(VLM)连接到物理机器人反馈。给定自然语言指令 ℓ,系统旨在生成一组机器人动作序列,以实现所请求的物理结果。在每个决策周期 t,控制框架观测 ot=(Tt,rt),其中 Tt 包含可用相机图像,rt 包含测量得到的机器人状态,包括工具位姿和夹爪状态。为了在任务级指令与物理交互之间建立桥梁,规划器(Planner)构建有序子目标序列 G=(g1,…,gM)。每个子目标指定一个预期状态变化、目标描述和成功标准。
系统不生成低级关节命令,而是在机器人基坐标系中提供参数化的中层动作。每个周期,执行器(Executor)返回一个结构化提案,其中包含对当前子目标的评估、完成信号、可选的动作批次和预期结果。动作批次表示如下:
At=(at,1,…,at,Kt),at,k=(τt,k,ηt,k)其中 τt,k 表示动作类型,ηt,k 表示其参数。核心操作原语包括移动、旋转和夹爪动作。确定性控制器(Controller)验证这些命令,将其参数解析为笛卡尔运动,并记录实际执行的运动,确保后续提案基于新鲜观测和测量反馈,而不是假设的结果。
如下图所示:
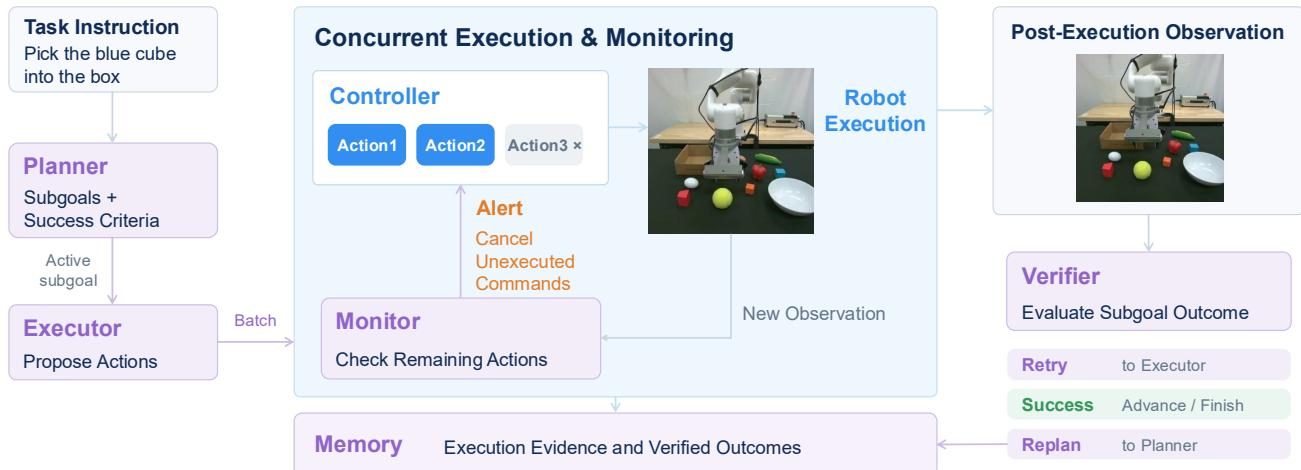
MotorMind 将五种不同的推理角色分配给同一个 VLM:Planner、Executor、Monitor、Verifier 和 Memory。这些角色共享模型能力,但接收不同的上下文并拥有不同的输出权限。Planner 将指令转换为子目标,并在执行证据表明需要改变时修订未完成的计划。Executor 使用当前图像、机器人测量值和近期周期历史,为当前子目标提出短动作批次。随后 Controller 验证并执行该批次,闭合局部决策回路。
为了评估交互是否始终与任务一致,Monitor 观察正在执行的子目标,并报告诸如目标错误、物体掉落或场景变化等事件。其输出是警报,而不是替代动作。在每次尝试结束时,Verifier 使用观测和机器人状态证据评估成功标准。直接测量的结果(例如抓取失败)可以在需要模型判断之前结束一次尝试。由此产生的评估决定控制框架是继续推进、重试该子目标,还是请求修订计划。最后,Memory 将执行证据和评估结果压缩为简洁的笔记,用于后续规划和验证,并在多次尝试之间传递信息。
作者实现了一种异步调度机制,以确保后台检查不会阻塞机器人。主执行循环保持顺序执行,因为每个提案都依赖于当前观测,且下一周期依赖于批次的测量结果。然而,异步性被引入该决策循环周围。Monitor 在整个子目标尝试期间运行在后台线程中,定期检查更新后的观测。如果检测到关键问题,它会发出 STOP 警报,在下一个动作边界取消正在运行的批次,并丢弃待处理命令。这种中断会触发重新评估,而不是立即给出失败结论。此外,每次结果评估后,控制框架会在后台写入器上请求生成记忆摘要。下一个子目标可以在该摘要仍在生成时开始,从而保持运动决策的顺序链,同时允许场景监控和证据总结与正在进行的执行重叠。
实验
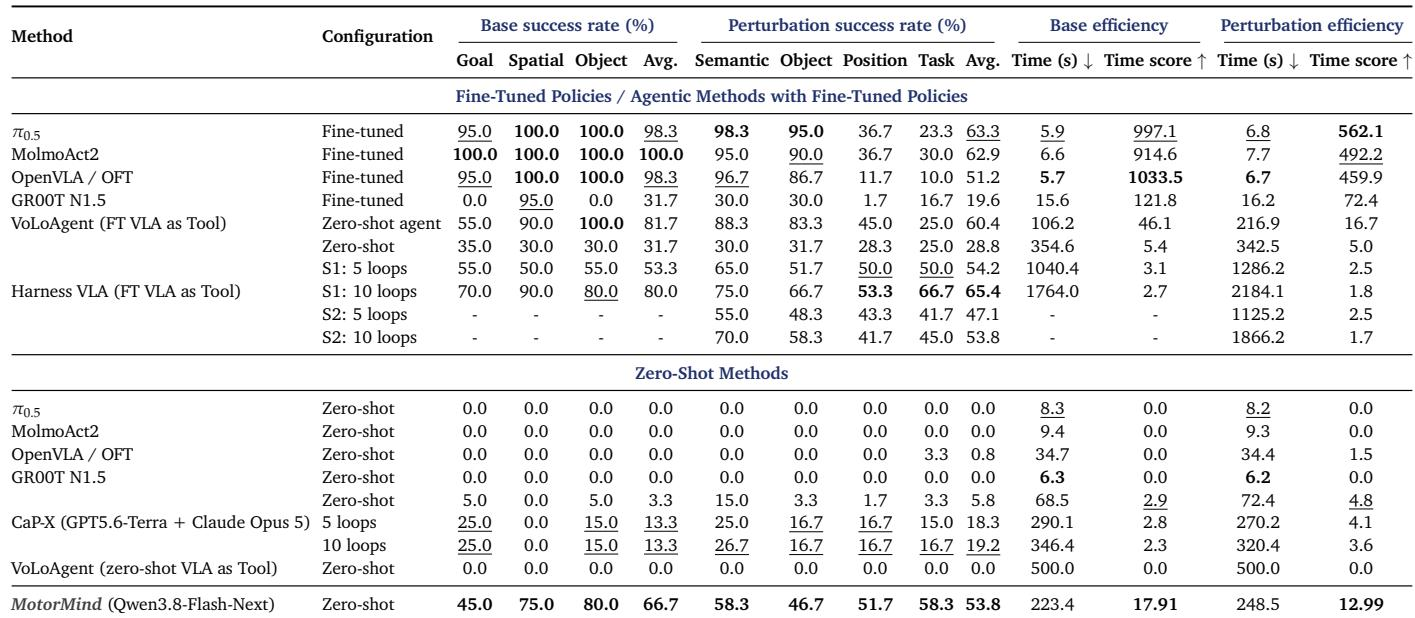
评估结合了诊断性具身问答基准、LIBERO-PRO 操作套件、自适应执行场景和真实 xArm6 试验。诊断实验表明,动作选择是最弱的 VLM 能力,进度和完成判断仍不完善,这促使采用可修订、反馈驱动的控制接口。主实验和自适应实验发现,该接口使冻结的通用 VLM 能够超越零样本基线,匹敌针对任务微调的策略,并在无需任务特定训练的情况下适应移动物体、场景变化和修订后的指令。真实机器人部署证实了可靠的物理执行和纠错能力,而消融实验表明规划与重规划至关重要,定位错误仍然是主要失败模式。
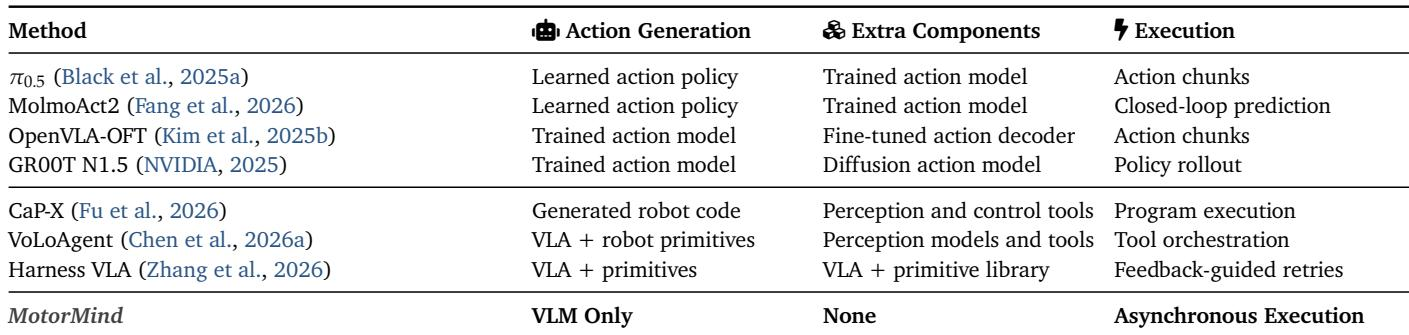
与先前操作方法的区别在于,MotorMind 直接使用 VLM 进行语义动作生成,避免学习得到的动作策略、生成的机器人代码以及外部感知或 IK 模块。它在直接感知和人类扰动设置中取得了较高的综合成功率,其中直接感知接近完美,人类扰动仅略低。消融实验表明,规划器至关重要,重规划对恢复有很强的支持作用,更强的推理主干会提高成功率,但会延长执行时间。现有方法依赖学习得到的动作策略、生成的机器人代码或额外的感知与控制模块;MotorMind 则直接使用 VLM 进行语义动作生成。移除规划器会使任务成功消失,移除重规划会在剩余组件中造成最大降幅,而更强的主干会提高平均成功率,但会增加墙钟时间。
GPT-6 Astra 在所有诊断类别和总体准确率上领先,但其平均推理延迟远高于任何其他被评估模型。在速度较快的模型中,Qwen3.8-Flash-Next 和 GLM-5.3-Flash 提供中等总体准确率和相当的性能,而面向具身的模型在动作选择和总体结果上通常落后。动作选择是大多数模型中最弱的能力。GPT-6 Astra 在动作选择、进度验证、子目标完成和总体问题上均达到最高准确率,但每次查询速度远慢于其他模型。Qwen3.8-Flash-Next 和 GLM-5.3-Flash 是最强的低延迟模型,而面向具身的模型尤其在动作选择和总体准确率上落后。
直接微调的 VLA 基线(如 π0.5、MolmoAct2 和 OpenVLA/OFT)实现了近乎完美的基础成功率,并在七秒内完成基础回合,因此时间归一化成功率得分非常高。在扰动下,各方法成功率均下降,其中位置扰动和任务扰动导致最大降幅,而语义扰动和物体扰动仍相对稳健;GR00T N1.5 是直接微调策略中明显的低表现例外。使用微调 VLA 作为工具的 VoLoAgent 达到中等成功率,但墙钟时间长得多,因此其时间归一化得分远低于快速的直接微调 VLA。最强的直接微调 VLA 策略实现了近乎完美的基础成功率,并在七秒内完成基础回合。位置扰动和任务扰动导致最急剧的下降,而最强的微调 VLA 在语义扰动和物体扰动上的成功率仍相对较高。使用微调 VLA 工具的 VoLoAgent 产生中等成功率,但墙钟时间超过 100 秒,因此时间归一化得分远低于最快的直接微调 VLA。
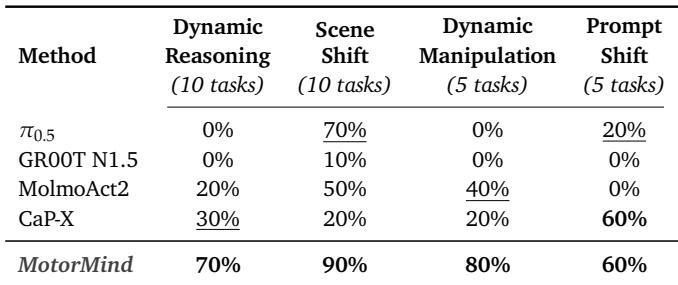
MotorMind 在大多数自适应推理任务组中领先,在动态推理、场景切换和动态操作中取得最高成功率。基线方法表现更不均匀,若干方法在动态任务上接近为零,只有 CaP-X 在提示切换上与 MotorMind 相当。MotorMind 在四个自适应任务组中的三个中取得最高成功率,并在提示切换上并列第一。若干基线方法在动态推理和动态操作上得分为零,而 MotorMind 在这些组中达到显著更高的成功率。CaP-X 是唯一在提示切换上与 MotorMind 相当的基线,但在场景切换和动态操作上不如 MotorMind。
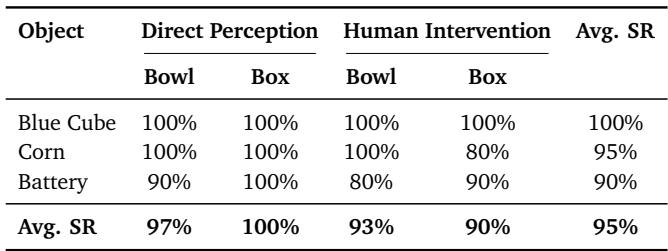
MotorMind 在真实机器人上跨显式物体和目的地配对取得了较高的零样本放置成功率。在人类扰动下表现仍然强劲,仅部分物体和目的地组合出现适度下降。语义理解任务波动更大,某些指令类型被完美解决,而另一些则显著较低。直接感知任务高度可靠,碗和箱子目的地的平均成功率均接近上限。人类扰动仅导致有限的总体下降,但某些放置任务(例如将玉米放入箱子、将电池放入碗)受影响更大。语义理解表现在不同指令类型之间差异很大,从某些任务上的完美成功到另一些任务上的显著较低成功率。
实验在仿真直接感知、人类扰动、自适应推理和真实机器人放置设置中评估了 MotorMind,一个由 VLM 驱动的语义动作生成器,避免了学习得到的动作策略、生成的机器人代码以及外部感知或 IK 模块。MotorMind 实现了近乎完美的直接感知成功率,在扰动和动态推理任务下仍保持强劲表现,同时消融实验确认规划器和重规划必不可少,更强的推理主干会提高成功率,但代价是更长的执行时间。直接微调的 VLA 基线在基础任务上快速且准确,但在位置扰动和任务扰动下急剧下降,而 MotorMind 保持了更强的鲁棒性。真实机器人测试表明,零样本直接放置高度可靠,扰动影响适中,但语义理解在不同指令类型之间差异显著。