Command Palette
Search for a command to run...
E-MOE:面向非因子化扩散语言模型的增强型混合专家
E-MOE:面向非因子化扩散语言模型的增强型混合专家
Arseny Ivanov Alexander Kolesov Alexander Korotin Ivan Oseledets Mikhail Goncharov
摘要
掩码扩散模型(MDMs)通过在每个去噪步骤中逐步去掩码多个 token 来生成序列,但其逆向过程通常按位置因子化,限制了少步情形下的样本质量,而少步情形正是扩散模型相较于自回归解码的速度优势最为关键的场景。近期一类工作引入连续高斯潜变量,并以变分自编码器方式进行训练,以捕捉位置间的相关性;但这类方法容易出现后验坍缩,导致潜变量被悄然忽略。我们提出增强型混合专家(E-MoE),将逆向过程构建为在一个离散共享潜变量上的因子化分布混合,该离散共享潜变量由混合专家(MoE)骨干的专家路由决策给出,且相较因子化基线不增加活跃参数。在合成多模态基准、二值化 MNIST 和 LM1B 上,E-MoE 相比因子化基线改善了少步生成效果。
一句话总结
Applied AI Institute 的研究人员提出了 Enhanced Mixture-of-Experts (E-MoE),该方法将反向过程构建为基于离散共享隐变量的因子化分布混合,该共享隐变量来自 Mixture-of-Experts (MoE) 的专家路由决策,且相比因子化基线不增加活跃参数,从而在合成多模态基准、二值化 MNIST 和 LM1B 上改善少步生成。
核心贡献
- 提出了 Enhanced Mixture-of-Experts (E-MoE),它是一种掩码扩散模型,其反向过程是基于 MoE 骨干网络专家路由决策给出的离散共享隐变量的因子化 token 分布混合。
- E-MoE 使用学习到的离散路由隐变量代替已有工作中的连续高斯隐变量和识别网络,在相比因子化基线不增加活跃参数的情况下避免后验坍缩。
- 在合成多模态基准、二值化 MNIST 和 LM1B 上的实验表明,E-MoE 相比因子化基线改善了少步生成质量。
引言
自回归语言模型提供可计算的似然,但需要固有的顺序解码。掩码扩散模型提供更快的并行去掩码,但通常的因子化反向过程预测独立的 token 边际分布,因此在同一步中生成的 token 被视作条件独立,相关性会丢失。已有方法通过连续共享隐变量解决这一问题,但这需要高斯先验和额外的识别网络,增加了模型复杂度。作者提出了 Enhanced Mixture-of-Experts (E-MoE),该方法复用 mixture-of-experts 骨干网络的离散路由决策作为共享隐变量,在不增加参数或推理成本的情况下实现相关的反向过程,并推导出可处理的 ELBO 用于训练。
方法
作者提出了一种掩码离散扩散模型,在离散共享隐变量空间上构建反向过程。为了在无需训练 VAE 等额外辅助模型的情况下克服因子化障碍,他们利用 Mixture-of-Experts (MoE) 骨干网络的路由决策。该离散隐变量本质上决定了每一层中哪个稀疏专家混合应解释去掩码步骤。
MoE 架构在 D 层中包含 E 个专家。对于序列 xti,隐编码 z 被建模为一组逐层和逐 token 的路由分配。作者使用逐层和逐 token 的因子化,在这些路由决策上定义后验分布和先验分布。后验分布同时以含噪输入 xti 和干净目标 x0 为条件,而先验分布仅以含噪输入 xti 为条件。
训练期间,模型需要两次前向传播来对齐路由分布。如下图所示:
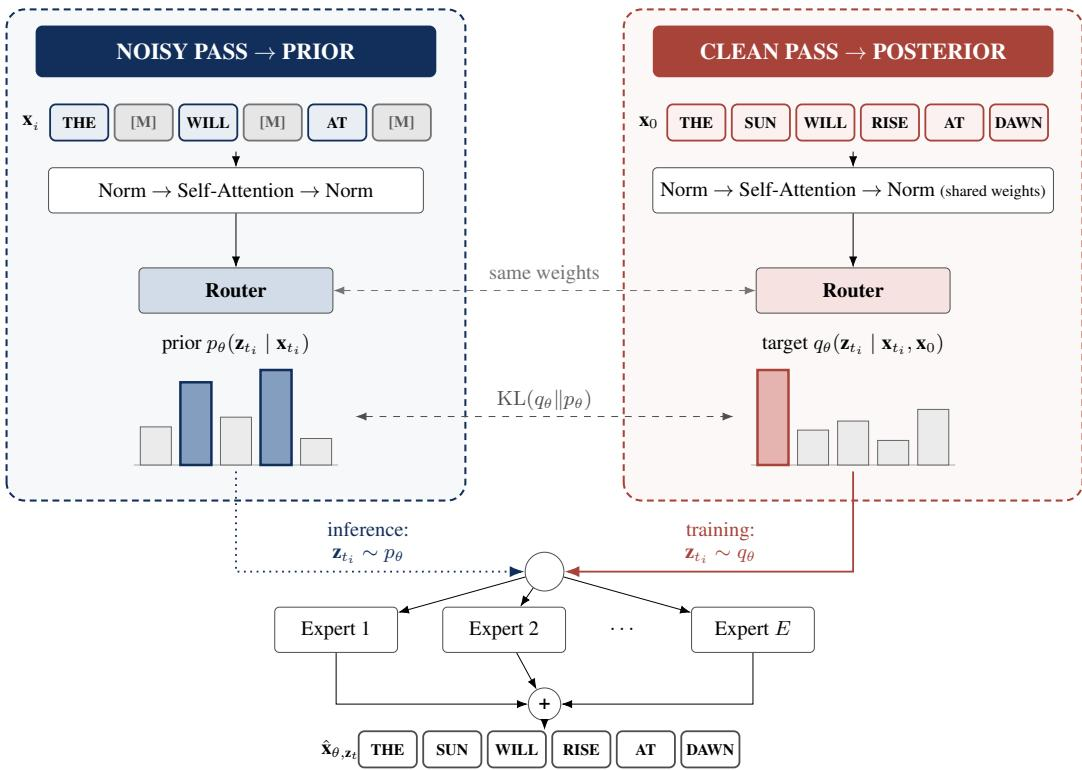
在第一次前向传播中,称为干净前向传播,路由器处理含噪样本与干净序列的拼接,以计算后验路由分布。在第二次前向传播中,称为含噪前向传播,同一个路由器仅处理含噪样本以近似先验分布。核心训练目标是使有干净样本时选择的路由与仅从损坏序列中选择的路由对齐。
训练目标由两个主要部分组成。第一项计算所选专家预测的干净 token 的负对数似然。第二项是路由器匹配损失,其形式为所有层和位置上后验与先验路由分布之间的分类 KL 散度之和。由于共享隐变量 z 是离散的,作者使用 Gumbel-Softmax 技巧和直通估计器,以实现从路由分布可微采样。这包括向路由器 logits 添加 i.i.d. Gumbel 噪声,并应用温度参数控制向 one-hot 专家分配的松弛程度。
在推理阶段,模型仅使用含噪前向传播,从而高效运行。它直接从先验分布采样隐路由决策,并在一次前向传播中计算 token 预测,确保一次网络函数评估对应一次通过 MoE 骨干网络的前向传播。
实验
实验在三个设置中评估 E-MoE 与因子化 MDLM 和 VADD 的对比,并匹配骨干网络、优化器和训练预算:二维玩具密度、二值化 MNIST 生成和 LM1B 文本生成。玩具结果表明,因子化采样会产生虚假的坐标组合,而 E-MoE 的离散共享隐变量保留了真实簇和流形。在图像和文本生成中,E-MoE 产生更连贯的低步样本,在 MNIST 上取得最佳的 bits per dimension,并在文本的一步和两步采样中显著改善生成困惑度和 MAUVE。总体而言,共享离散隐变量有助于打破因子化障碍,并在不增加活跃参数的情况下改善少步生成。
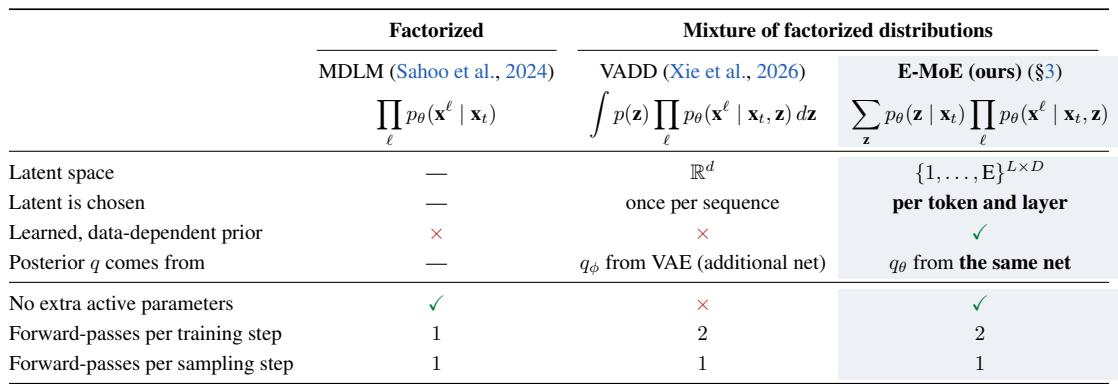
E-MoE 保留了 VADD 的因子化分布混合视角,但将连续高斯隐变量替换为骨干网络已经计算的离散路由隐变量。这消除了对单独识别网络和额外活跃参数的需求,同时学习按每个 token 和每一层选择的依赖数据的先验。实验表明,共享离散隐变量捕获跨 token 相关性,并相比因子化和连续隐变量基线改善了少步生成。E-MoE 将骨干网络已经计算的路由决策复用为离散隐变量,因此不需要单独的识别模型或额外的活跃参数。与 VADD 每个序列采样一次的固定连续先验不同,E-MoE 学习按每个 token 和每一层选择的依赖数据的离散先验。E-MoE 相比因子化 MDLM 产生更连贯的少步样本,并改善似然和生成困惑度,同时与 VADD 的参数数量相当。
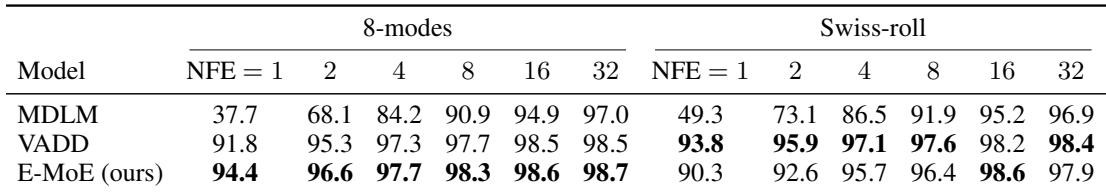
在两个合成二维密度上,E-MoE 和 VADD 在少步机制下均相比因子化 MDLM 显著提高了有效性。E-MoE 在 8-modes 上始终优于 VADD,在 Swiss-roll 上保持竞争力,且优势随采样步数增加而缩小。在一步采样时,因子化 MDLM 在两种合成密度上的有效性显著低于 VADD 和 E-MoE。E-MoE 在每个步数预算下都在 8-modes 上取得最佳有效性,并在 Swiss-roll 上具有竞争力;在 Swiss-roll 上 VADD 在大多数步数下领先,但差异随步数增加而缩小。
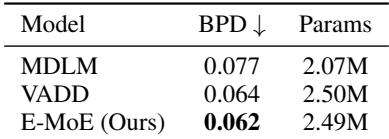
在二值化 MNIST 上,E-MoE 在比较方法中报告了最低的 bits-per-dimension,紧随其后的是 VADD,然后是 MDLM。E-MoE 在参数数量与 VADD 基本相当的情况下取得这一结果,而 MDLM 参数略少但在似然上效果较差。E-MoE 取得了最佳的测试 bits-per-dimension,略低于 VADD,并明显低于因子化 MDLM。E-MoE 和 VADD 的参数数量几乎相同,而 MDLM 使用更少参数但产生更高的 bits-per-dimension。
在 LM1B 上的少步无条件文本生成中,E-MoE 在每个报告的函数评估次数下都取得了最佳生成困惑度。它相对因子化和隐变量基线的最大改进出现在一步和两步采样时,此时其显著降低生成困惑度,同时保持样本熵接近数据水平。随着使用更多采样步,优势缩小。E-MoE 在 LM1B 上所有报告的 NFE 设置中取得了最低生成困惑度。在 1 和 2 个 NFE 时,E-MoE 相对 MDLM、SEDD 和 VADD 将生成困惑度降低约 2 到 2.6 倍,同时样本熵与这些基线相似且接近数据熵。随着 NFE 增加,E-MoE 相对最强基线的优势缩小,这与每步去掩码的 token 更少一致。
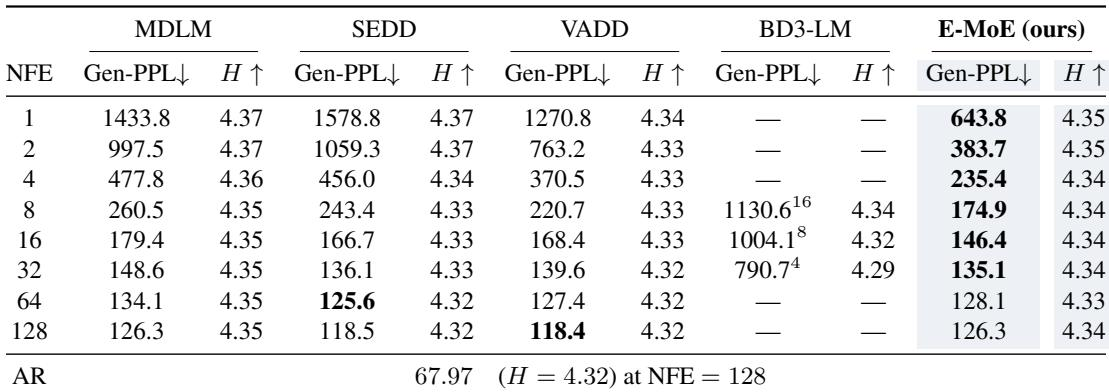
E-MoE 在合成二维密度、二值化 MNIST 似然建模和 LM1B 少步无条件文本生成上进行了评估。其离散路由隐变量消除了对单独识别网络的需求,并捕获跨 token 相关性,在有效性和似然上优于因子化 MDLM,同时与 VADD 的参数数量相当。最大收益出现在少步文本生成中,E-MoE 在其中取得最佳生成困惑度,尤其是在一步和两步采样时,且优势随更多步骤的使用而缩小。