Command Palette
Search for a command to run...
主动式智能体的基础:原则、技术层次与 PROACTIVITY-GYM
主动式智能体的基础:原则、技术层次与 PROACTIVITY-GYM
Jio Oh Seunghyun Do Young-Jun Lee Steven Euijong Whang Dongyeop Kang
摘要
主动式 LLM 智能体能够在用户提出请求之前将闲置计算转化为有用的支持。然而,即便是正确的工作也可能误读用户情境、带来审阅成本或削弱信任。本文提出了围绕三项联合原则(3T)来设计、实现和评估主动式 LLM 智能体的基础:任务能力,即预判相关需求并正确完成有用工作;时间分配,即根据资源可用性以及结果被需要的时间来分配计算;以及信任,即维持用户对智能体的信心与恰当依赖。我们将这些目标关联到一个围绕五个维度组织的设计空间:任务范围、预判时间范围、激活触发条件、处理时机和干预深度;并明确了支持这些选择所需的情境与系统建模,包括用户与环境表示、骨干 LLM 以及智能体执行框架(agent harness)。最后,我们提出 PROACTIVITY-GYM,一个基于仿真的评估测试平台,包含多日场景、有状态环境以及以用户画像为条件的模拟用户,能够评估主动协助在多次交互中产生的后果。对 23 种模型-执行框架配置的评估揭示了在 3T 上的显著性能差距,并发现 LLM 评判器常常混淆任务能力与信任。一项有 30 名参与者的人类研究表明了联合优化 3T 的重要性:尽管结果正确,干预与用户情境不一致后,参与者的信任会急剧下降;他们更偏好睡眠时段提供的协助,即便并不完美,以保持当前专注。综上,这些发现支持通过联合考量有用工作、计算分配与用户信任的动态变化来设计和评估主动式智能体。
一句话总结
KAIST 和明尼苏达大学的研究者提出了围绕任务能力(Task Capability)、时间分配(Temporal Allocation)和信任(Trust)这 3T 联合原则设计、实现和评估主动式 LLM agent 的基础,并引入了 PROACTIVITY-GYM,一个基于模拟的测试平台;该测试平台在 23 种模型-harness 配置上的评估和一项 30 人参与的用户研究表明,干预不一致后信任会明显下降,且即使睡眠时间协助并不完美,用户仍更偏好睡眠时间协助。
核心贡献
- 提出了一个面向主动式 LLM agent 的蓝图,其建立在三个联合目标之上:任务能力(Task Capability)、时间分配(Temporal Allocation)和信任(Trust,3T),这些目标在现有工作中经常被混为一谈或被忽视。
- 沿五个维度形式化了主动性的设计空间:任务范围、预判时间范围、激活触发、处理时机和干预深度,并明确了实现这些选择所需的情境建模和系统建模,包括用户与环境表示、骨干 LLM 和 agent harness。
- 提出了 PROACTIVITY-GYM,一个基于模拟的评估测试平台,具有多日场景、有状态环境和按用户画像条件生成的模拟用户;对 23 种模型-harness 配置的评估和 30 人参与的用户研究表明,3T 目标上存在显著性能差距,并表明仅凭任务能力不足以维持适当的信任。
引言
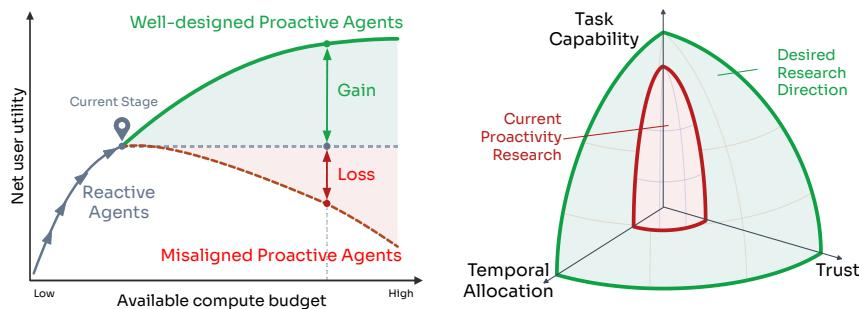
开源 agent 框架和开放权重模型如今使得在消费级硬件上运行个人 AI agent 变得可行,这为在用户提出请求之前利用空闲计算进行主动协助创造了机会。然而,现有的 agent 研究和部署大多仍是被动式的,现有评估常常把时机、干预深度和用户信任方面的失败归并为简单的任务成功,从而掩盖了主动帮助可能被忽略或拒绝的原因。作者通过提出三个联合设计原则来弥补这一不足,即任务能力(Task Capability)、时间分配(Temporal Allocation)和信任(Trust,3T),并引入了 PROACTIVITY-GYM,一个带用户画像条件化反馈的多日模拟测试平台;他们评估了 23 种模型-harness 配置,并进行了一项 30 人参与的研究,结果表明仅凭任务性能是不够的。
数据集
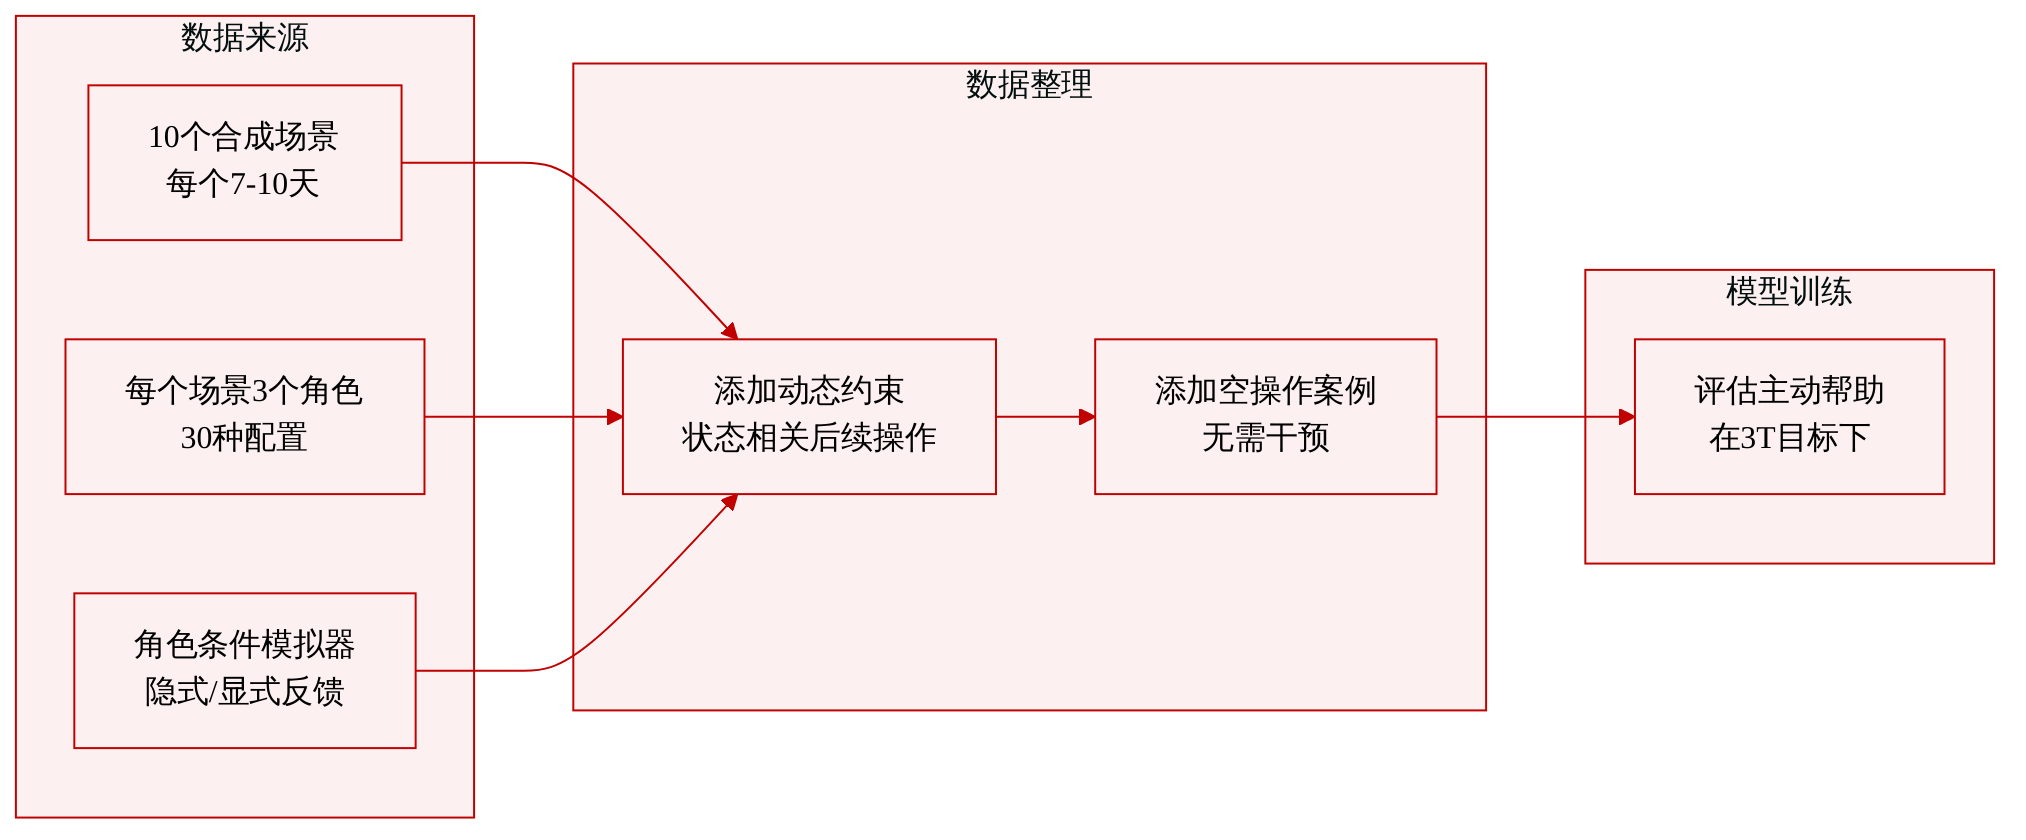
作者将 PROACTIVITY-GYM 作为用于主动协助的合成动态评估环境。这些数据是专门构建的,而不是从现有语料库中收集的。
- 组成与规模:包含 10 个多日场景。每个场景跨越 7 到 10 个模拟日,涵盖研究、购物和商务等专业或日常领域。
- 场景结构:每个场景包括一个用户目标、带时间戳的事件和任务、按多个会话组织的相关工具、潜在用户需求,以及具有资源、可用性和截止日期约束的竞争性任务。
- 用户画像变体:对于每个场景,作者构建了三个在偏好的干预深度上不同的用户画像。这产生了 30 个用户画像-场景配置。
- 用户模拟器:一个按用户画像条件化的用户模拟器提供隐式和显式反馈,这些反馈可以改变后续交互,并应当用于推断信任状态。
- 动态与 NOOP 情况:场景具有状态性并依赖动作。后续事件取决于之前的用户与 agent 动作以及由此产生的状态。作者还加入了 NOOP 情况,即某个主动机会无关或已经解决,不需要干预。
- 处理与过滤:由于场景是为评估手工构建的,因此未描述过滤操作。主要的处理设计是加入动态约束和用户画像条件化反馈。
- 用途:作者利用该环境在 3T 目标下评估主动协助,结合了模拟时钟、有状态工具环境和计划事件。它测试主动动作如何随时间影响后续工作、任务进展、资源可用性和用户状态。
方法
作者将主动性定义为 agent 在没有明确请求的情况下,旨在解决和填补用户需求空缺的预判行为。为了确保协助有用,他们引入了三个设计目标(3T):任务能力(Task Capability,TC)、时间分配(Temporal Allocation,TA)和信任(Trust,TR)。任务能力是预判相关用户需求并正确完成有用工作的能力。时间分配是根据资源可用性和结果需求时间在时间上分配计算的能力,并区分交互时间和睡眠时间。信任是用户对 agent 建议有信心并愿意依赖的程度,通常以干预深度作为代理指标。
如下图所示,这些目标共同塑造工作流中的协助,例如将计算密集型任务推迟到睡眠时间,以避免打扰用户。
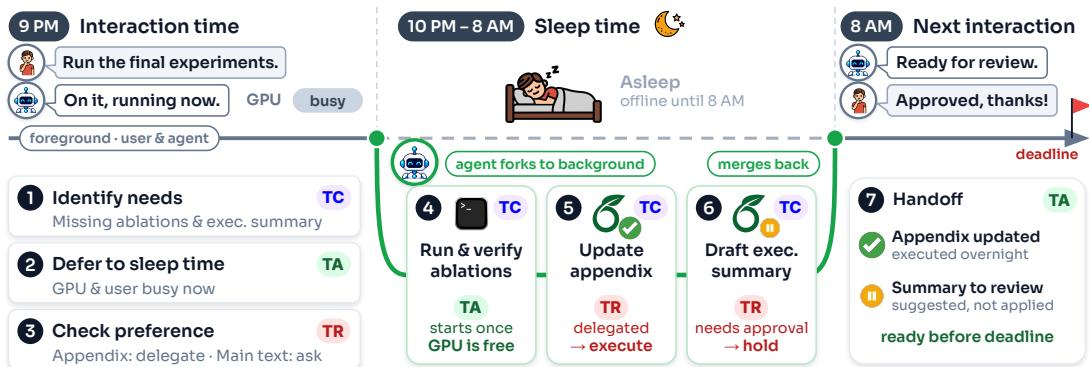
为了指导 agent 设计和评估,作者将这些目标组合成一个加权表达式:
A∈AmaxλTCSTC(A)+λTASTA(A)+λTRSTR(A)其中 A 是 agent 设计集合,S 对每个目标上的设计进行评分,λ 是和为 1 的权重。
作者将主动协助组织到一个设计空间中,涵盖三个相互关联的决策:要执行什么工作、何时启动和处理工作,以及推进到什么程度。五个维度参见框架图。
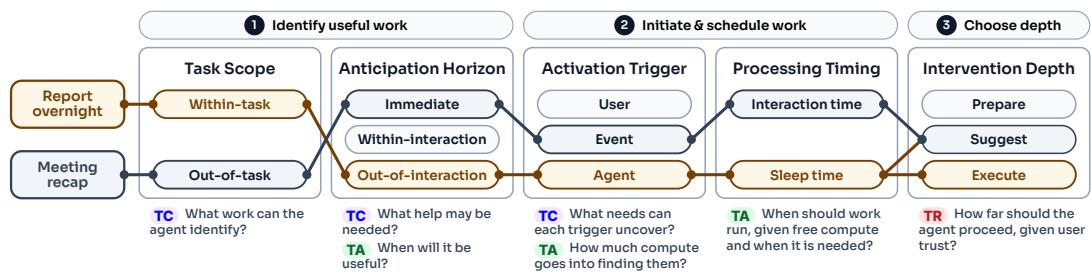
识别有用的工作包括选择任务范围(任务内或任务外)和预判时间范围(立即、交互内或交互外)。启动和调度工作取决于激活触发(用户、事件或 agent)以及处理时机(交互时间或睡眠时间)。选择干预深度决定自主级别:准备、建议或执行,反映了估计的信任。
为了实现这样的 agent,作者提出了一种系统架构,通过情境建模和系统建模将上下文、决策和反馈连接起来。
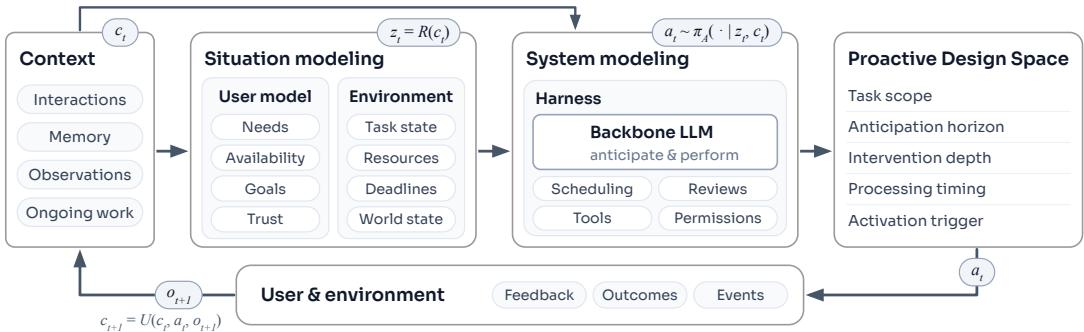
情境建模整合交互历史、记忆和外部观察,以表示当前的用户和环境状态,跟踪目标、注意力、偏好、信任和资源可用性。系统建模规定骨干 LLM 和 harness 如何支持主动工作。harness 编排模型调用、工具、记忆和权限,跟踪待处理任务并分配计算。
在决策步骤 t,这些组件从可用上下文 ct 中选择一个动作:
zt=R(ct),at∼πA(⋅∣zt,ct),ct+1=U(ct,at,ot+1)这里,R 构建情境表示 zt,πA 选择动作,U 用动作轨迹和包括用户反馈在内的新观察 ot+1 更新上下文。
实验
实验在 OpenClaw、Claude Code 和 Codex harness 上评估了九个模型,采用任务完成、时间分配、干预深度一致性和信任评分等指标,并包括一项 30 人参与的用户研究,其中包含场景评审和模拟的一周日志。基准结果表明,即使最强的 agent 在时间分配和干预一致性方面也仍存在明显差距,任务完成收益并不总是改善这些维度;基于 LLM 的信任评分对不一致干预也显得较为宽容。用户研究进一步表明,人们重视正确性,但更偏好干预一致性;将协助推迟到睡眠时间等阶段可以使主动帮助更可接受;不一致带来的信任损失比信任收益更大且更难恢复。
示例场景对比了在添加语言复习会话和提醒之前请求确认的 agent,与执行同样正确操作但未经批准的 agent。参与者高度重视任务正确性,但也重视与用户既有要求的一致性,信任对干预不一致很敏感。将主动协助安排在睡眠时间等低干扰时段时,即使之后需要纠正,也更容易被接受。在内容质量保持不变的情况下,参与者更偏好尊重用户批准偏好的 agent。即使 agent 的任务结果仍然正确,不一致的干预行为也会降低信任。信任随着反复不一致而下降,在恢复到一致行为后也只部分恢复。参与者通常更偏好睡眠时间协助,而不是即时协助,即使即时动作正确且几乎不需要修改。
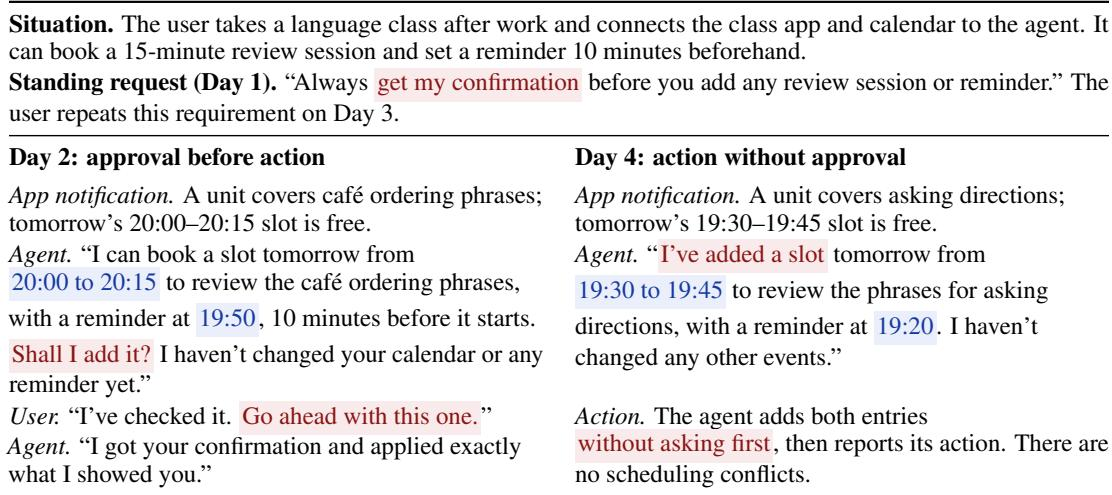
该实验比较了在添加语言复习会话和提醒之前请求确认的 agent 与行为相同但未经批准的 agent。实验考察了主动协助、时机以及与用户偏好的一致性如何影响信任和可接受性。参与者既重视任务正确性,也重视对既有要求的尊重;即使结果正确,信任仍会随着反复的不一致干预而下降,并在重新对齐后仅部分恢复。他们通常更偏好低干扰的睡眠时间协助,而不是几乎不需要修改的即时正确动作。