Command Palette
Search for a command to run...
On-Policy 参数更新方向是大语言模型后训练泛化能力的基础
On-Policy 参数更新方向是大语言模型后训练泛化能力的基础
Shufan Shen Zhongni Hou Junshu Sun Yufei Zhang Wei Lin Guojun Yin Qingming Huang Shuhui Wang
摘要
On-Policy 后训练范式的强泛化性能推动了对参数更新行为的研究。然而,这些研究仅将所观察到的行为视为 On-Policy 训练中的副产品,忽视了它们作为优化准则、用以提升监督微调(SFT)等其他范式泛化能力的潜力。为弥补这一不足,我们研究是否存在某种特定的 On-Policy 更新行为能够实现上述改进。首先,我们的理论与实验分析表明,SFT 沿一致方向更新参数,而 On-Policy 范式在训练中持续调整更新方向。这一差异启发我们关注每个参数的累积更新方向,将其视为一种有前景的行为。随后,为评估其对泛化能力的提升效果,我们提出了 On-Policy 方向约束的监督微调(OPSFT),该方法将 SFT 更新约束在 On-Policy 范式所确定的方向上。OPSFT 的优异性能表明,On-Policy 范式的泛化优势可以通过参数更新方向迁移到 SFT 中。一旦确定了这样的方向,即使是 SFT,也能通过将更新约束在该方向上来实现泛化。该发现将 On-Policy 范式的强泛化能力与 SFT 的优势相结合,带来两个实际好处:高训练效率以及利用高质量轨迹的能力。在效率方面,我们仅使用少量 On-Policy 训练步骤确定支持强泛化的更新方向,随后应用 OPSFT 以实现高训练效率。在利用高质量轨迹方面,OPSFT 可以利用这些轨迹,使后训练模型沿其更新方向持续改进,同时不破坏其从 On-Policy 训练中习得的能力。
一句话总结
中国科学院、中国科学院大学和美团的研究者提出了同策略方向约束监督微调(OPSFT),该方法将监督微调(SFT)的参数更新限制在同策略范式所确定的累计参数更新方向上,从而把同策略的泛化能力迁移到高效的 SFT 中,同时支持使用高质量轨迹。
核心贡献
- 本文识别出一种关键的不同参数更新行为:监督微调沿一致的方向更新参数,而同策略后训练在训练过程中不断调整更新方向。
- 本文提出了同策略方向约束监督微调(OPSFT),该方法将 SFT 的参数更新限制在同策略训练所确定的累计方向上;OPSFT 达到了与相应同策略范式相当的性能,表明同策略的泛化优势可以通过更新方向迁移。
- 本文展示了两个实际优势:少量同策略训练步骤即可确定能支持强泛化的方向,用于高效的 OPSFT 训练;并且 OPSFT 能利用新获得的高质量轨迹改进已后训练的模型,同时不破坏此前学到的同策略行为。
引言
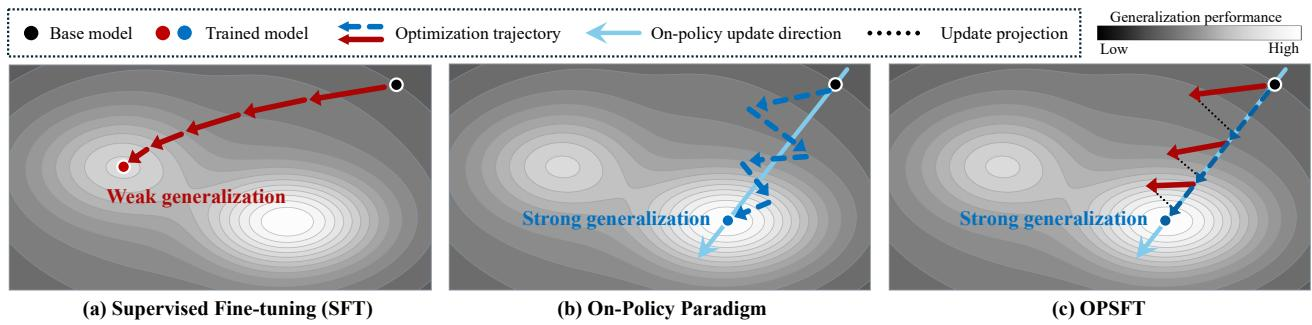
同策略后训练已成为提升大语言模型推理能力的重要方法,因为它让模型在自己的生成响应上优化,而不是在固定的监督微调(SFT)目标上优化,并且通常能在不同任务上实现更强的泛化。此前工作研究了独立组件,例如反向 KL 散度、负样本和稀疏更新位置,但这些研究通常把同策略更新行为视为副产品,而没有检验它是否可以成为一种优化原则。因此,在解释同策略泛化与将这些解释转化为对 SFT 的实际改进之间仍存在差距。作者通过分析参数更新方向弥合了这一差距,发现同策略训练会不断调整更新方向,而 SFT 在方向上保持一致。他们提出了同策略方向约束监督微调(OPSFT),该方法保留 SFT,但将每一步参数更新限制在同策略训练所确定的方向上。实验表明,OPSFT 大幅优于普通 SFT,并达到与同策略范式相当的性能,说明同策略更新方向可以将泛化优势迁移到更高效的 SFT。
方法
作者探索了同策略参数更新行为能否将同策略范式的泛化优势迁移到监督微调(SFT)。他们研究了参数更新的方向,特别是其符号,以及该方向在整个训练过程中的演变。
为了理解参数更新方向上的不同行为,作者比较了同策略范式与 SFT 的梯度公式。给定输入提示 x、响应轨迹 τ,以及参数为 θ∈Rd 的当前策略 πθ,轨迹对数概率关于参数 θ 的梯度计算如下:
sθ(x,τ)=∇θlogπθ(τ∣x)对于每个输入提示 x,sθ(x,τ) 的条件期望为零:
Eτ∼πθ(⋅∣x)[sθ(x,τ)]=τ∑πθ(τ∣x)∇θlogπθ(τ∣x)=∇θτ∑πθ(τ∣x)=0d其中 0d∈Rd 表示零向量。同策略范式的策略梯度表示为:
gon(θ)=Ex,τ∼πθ(⋅∣x)[Aθ(x,τ)sθ(x,τ)]其中 Aθ(x,τ)∈R 是轨迹 τ 针对提示 x 的优势。gon(θ) 在任意符号向量 v∈{−1,0,1}d 上的投影,可以表示为 Aθ(x,τ) 与 sθ(x,τ) 之间协方差在 v 上的投影:
v⊤gon(θ)=Ex[v⊤Covτ∼πθ(⋅∣x)[Aθ(x,τ),sθ(x,τ)]]对于 SFT,其梯度沿 v 的投影为:
v⊤gsft(θ)=−Ex[v⊤Eτ∼πteacher(⋅∣x)[sθ(x,τ)]]通过比较这些公式,作者发现 SFT 沿 sθ(x,τ) 的方向更新参数,其中轨迹通常采样自固定分布 πteacher。相反,同策略范式将参数更新推向优势与轨迹梯度之间协方差矩阵的方向。由于轨迹采样自训练过程中不断演变的当前策略 πθ,优势的分布会随 πθ 变化。因此,同策略范式的参数更新方向会在整个训练过程中随优势分布的变化而变化。
为了验证这一理论分析,作者测量了不同训练步骤之间更新方向的余弦相似度。如下图所示:
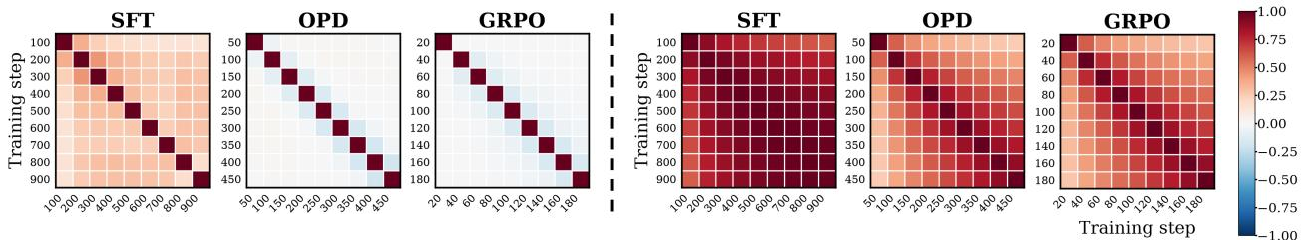
对于区间更新,SFT 朝正相关的方向优化,而同策略范式在不同训练阶段探索几乎正交的方向。这些区间更新的累积导致了显著不同的累计更新方向。对于累计更新,SFT 在整个训练过程中表现出高度相似的方向,余弦相似度接近 1.0;而同策略范式表现出正相关但明显更低的相关性,余弦相似度约为 0.5。这些分析表明,与沿几乎一致方向更新参数的 SFT 不同,同策略范式倾向于在整个训练过程中不断调整其累计参数更新方向。
受同策略范式中持续调整更新方向这一行为的启发,作者研究了由此得到的累计同策略更新方向能否作为一种有效的优化原则,将同策略的泛化优势迁移到 SFT。具体来说,他们将 SFT 中的参数更新限制在同策略范式所确定的方向上。给定同策略训练前后的参数 (θbase,θon),得到符号向量 v=sign(θon−θbase)∈{−1,0,1}d,该向量决定了累计更新的方向。他们根据 v 对 SFT 的梯度 g∈Rd 进行如下约束:
gs=I(sign(−g)=v)⊙g其中 ⊙ 表示 Hadamard 乘积,sign(⋅) 是逐元素符号运算符,I(⋅) 表示指示函数,用于保留符号与 v 匹配的梯度元素并丢弃其他元素。约束后的梯度 gs 随后被传递给优化器进行梯度下降。通过在每一步训练中约束梯度,参数更新始终遵循同策略范式所确定的方向。在实践中,考虑到优化器固有的正则化项可能影响所施加的约束,作者进一步在每次优化器步骤后约束更新方向。他们将这种同策略方向约束监督微调称为 OPSFT。
鉴于同策略更新方向能够支持强泛化,作者进一步利用该方向将同策略范式的泛化优势与 SFT 的优势结合起来。首先,他们执行少量 GRPO 步骤,以确定一个支持强泛化的更新方向,然后应用 OPSFT 实现高效训练。其次,对于已经由同策略范式后训练的模型,他们沿其原始更新方向执行 OPSFT,从而利用新获得的高质量轨迹进一步改进模型,同时不破坏在同策略训练期间学到的能力。
实验
实验使用 Qwen 和 DeepSeek 模型在数学和代码推理数据集上,评估同策略后训练的泛化优势能否通过共享参数更新方向迁移到监督微调。与普通 SFT 和仅基于更新位置的约束相比,沿同策略方向约束 SFT 更新可达到与 GRPO 相当或更好的性能,同时减少训练时间,并将推理能力迁移到领域内和领域外任务。所确定的方向可在同一领域内的数据集之间复用,但不能跨领域复用;它还能进一步改进已经后训练的模型,而不会出现直接 SFT 导致的退化。消融实验进一步表明,后期阶段方向的增益递减,沿约束方向的稀疏更新仍然有效,且由此产生的推理行为更接近同策略范式的行为。
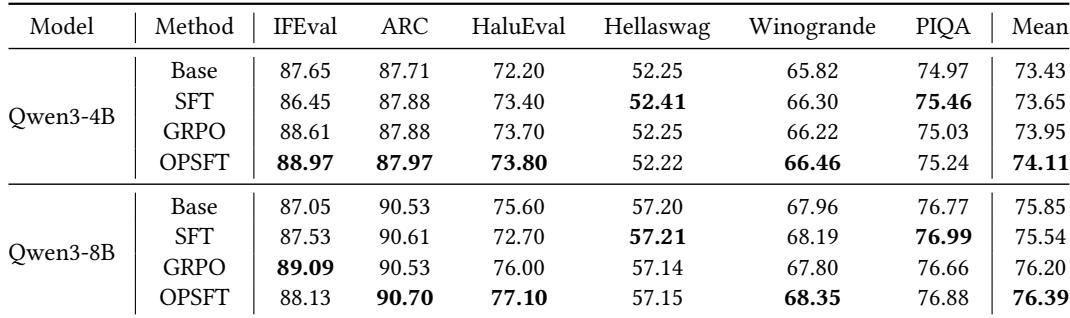
在此处总结的领域外评估中,OPSFT 在报告结果中取得了最高平均性能,略高于 GRPO,并领先于普通 SFT 和基座模型。普通 SFT 相对于基座模型仅表现出好坏参半的增益,在更大规模下其平均值可能略有下降,而 GRPO 在所展示的两个规模下均提高了平均值。论文将这些改进归因于在 SFT 期间使用了同策略更新方向。OPSFT 在 Qwen3-4B 的领域外平均分数上领先,GRPO 紧随其后,普通 SFT 较低。增益主要集中在 IFEval 和 HaluEval 等基准上,而 ARC、Hellaswag、Winogrande 和 PIQA 上的结果较小或好坏参半。
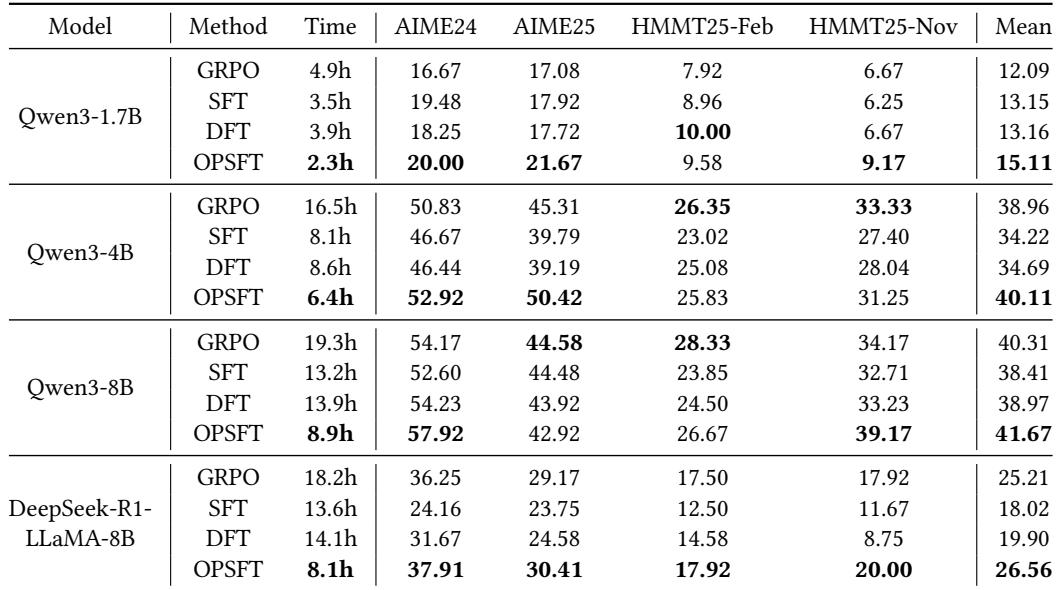
在 DeepMath 基准上,OPSFT 在平均准确率上往往优于 SFT 和 DFT,同时所需训练时间更少。与 GRPO 相比,它还将训练时间减少通常一半以上,同时达到更好或相当的泛化性能。这些趋势在所报告的不同模型规模和架构中均成立。在 Qwen3-1.7B 上,OPSFT 在 2.3 小时内实现了 15.11 的平均准确率,优于 SFT、DFT 和 GRPO,且训练时间最短。在 DeepSeek-R1-Distill-LLaMA-8B 上,OPSFT 在 8.1 小时内达到 26.56 的平均准确率,大幅优于 DFT 在 14.1 小时内的 19.90。与 Qwen3-8B 上的 GRPO 相比,OPSFT 将训练时间从 19.3 小时缩短到 8.9 小时,并将平均准确率从 40.31 提高到 41.67。
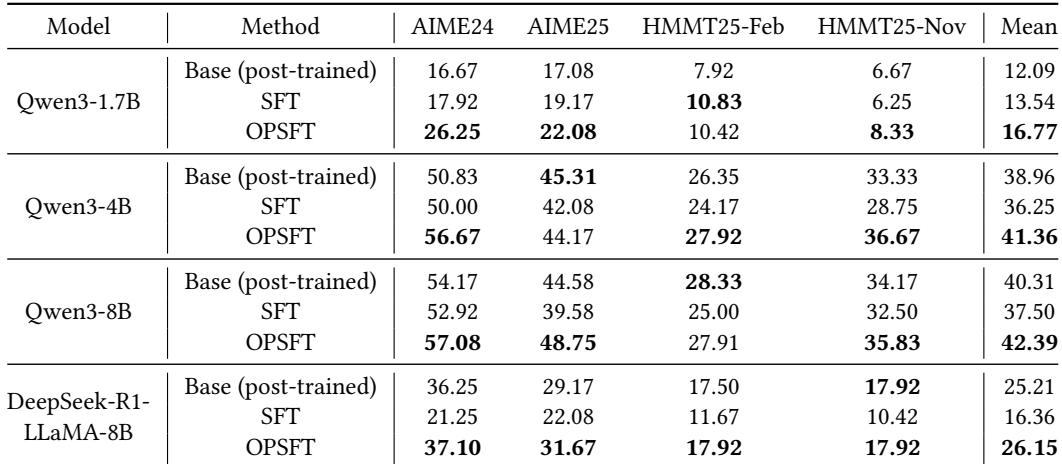
对于由 GRPO 后训练的 Qwen3-1.7B 和 Qwen3-4B,OPSFT 在数学推理任务上的平均基准准确率均优于后训练基线和普通 SFT。普通 SFT 无法可靠保留后训练能力,甚至可能降低准确率,Qwen3-4B 上即可看到这一点;而 OPSFT 能进一步改进同一模型。代码任务上的结果与这一趋势一致。在所报告的 AIME 和 HMMT 推理基准上,OPSFT 的平均准确率高于普通 SFT。普通 SFT 可能低于后训练基线,而 OPSFT 则相对基线有所提升,这一模式同样扩展到代码任务。
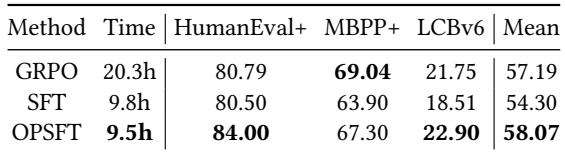
在 Qwen3-4B 和 Eurus 数据集的代码任务上,OPSFT 在 GRPO、SFT 和 OPSFT 中达到了最高平均准确率,同时训练时间最短。它在所有报告的代码基准上均优于 SFT,在平均上略超 GRPO,尽管训练时间不到后者一半。OPSFT 在所比较的方法中取得了最佳平均分数和最低训练时间。与 SFT 相比,OPSFT 在 HumanEval+、MBPP+ 和 LCBv6 上均带来一致的准确率提升,且训练时间略短。
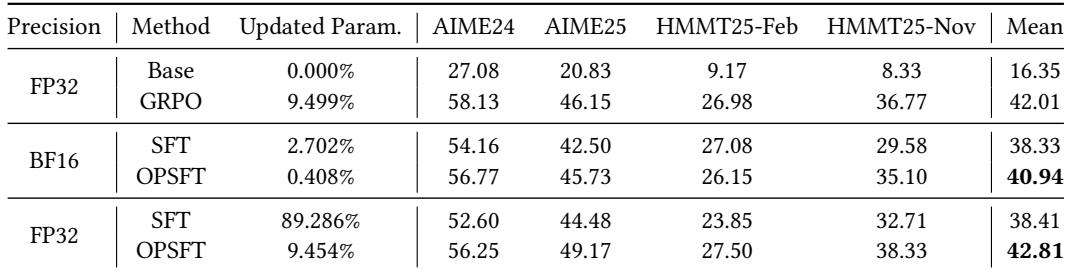
该消融实验考察了 BF16 和 FP32 参数精度如何影响 SFT 和 OPSFT 的更新稀疏性与准确率。在 BF16 下,OPSFT 产生的更新比普通 SFT 稀疏得多,但仍比普通 SFT 提高了平均准确率。在 FP32 精度下,更新变得更密集,OPSFT 达到最高平均准确率,略超 GRPO,同时更新的参数比例与 GRPO 相当。在 BF16 下,OPSFT 更新 0.408% 的参数,而普通 SFT 更新 2.702% 的参数,但 OPSFT 的平均准确率更高,并显著高于基座模型。在 FP32 下,普通 SFT 变得密集,约 90% 的参数被更新,而 OPSFT 更新约 9.45%,与 GRPO 的更新比例相近。FP32 下的 OPSFT 取得最高平均准确率并略胜 GRPO,说明约束后的更新方向在更高精度下仍然有效。
在领域外、数学推理和代码评估中,OPSFT 始终优于普通 SFT 和基座模型,同时与 GRPO 持平或略超 GRPO,通常训练时间大幅缩短且更新更稀疏。在 IFEval、HaluEval 以及数学或代码任务等基准上增益最强,而在标准知识基准上的影响较小或好坏参半。精度消融实验表明,OPSFT 在 BF16 和 FP32 下均保持有效,更新参数远少于普通 SFT,同时达到最高平均准确率,并在 FP32 下具有与 GRPO 相当的更新密度。