Command Palette
Search for a command to run...
Transformer 模型过早停止思考,一个微小的 LoRA 即可修复
Transformer 模型过早停止思考,一个微小的 LoRA 即可修复
Zehao Jin Ruixuan Deng Junran Wang
摘要
预训练 Transformer 在上下文中跟踪引用时只利用了模型深度的很小一部分。13 个基础模型仅能可靠跟踪 1.4–3.6 行,额外的预训练循环也几乎不带来提升。在一个早期层上添加任务训练的 rank-8 LoRA,并在冻结所有模型权重的情况下扩展了这一计算过程。Qwen38B 在 24 行链条上的精确准确率从 15.5% 提高到 99%;训练更长时间的 LoRA 可达到 50 行。Ouro-1.4B 在四个循环后达到 60 行,在八个循环后至少达到 160 行。该 LoRA 启动了一种接力:程序行在中间层的一个短区间内传递其链身份。冻结的注意力头会逐步读取链条中更上游的内容,而移除父行注意力会终止这一接力。一种冻结模型测量方法在四个留出模型中的三个上,能在容差范围内定位到最后一个有用的干预层。任务特定的 LoRA 也能改进 MuSiQue。因此,默认答案低估了通过微小编辑可获得的计算能力。代码和交互式演示可在 https://lunamos.github.io/stop-thinking-too-early/ 获取。
一句话总结
作者证明,在保持所有模型权重冻结的情况下,将一个经过任务训练的秩为8 LoRA插入一个早期层,可以纠正预训练Transformer过早停止跟踪链式引用的问题:Qwen38B在24行链上的精确准确率从15.5%提高到99%,Ouro-1.4B达到60到160行,任务特定的LoRA也改善了MuSiQue。
核心贡献
- 本文量化了预训练Transformer中默认的引用跟踪计算,在十三个基础模型和两个循环模型族上表明,模型只能可靠跟踪1.4到3.6行,额外的预训练循环几乎没有带来提升。
- 本文提出一种轻量干预:保持模型权重冻结,并在一个早期层加入经过任务训练的秩为8 LoRA,使Qwen38B在24行链上的精确准确率从15.5%提高到99%,经过更长训练可达到50行,并且使Ouro-1.4B在四个循环后可跟踪60行,在八个循环后可至少跟踪160行。
- 本文给出了扩展计算的因果解释:它是一种接力,链身份通过一小段中间层传递,父行注意力对于冻结的注意力头继续向上读取链是必需的。冻结模型测量在四个留出模型中的三个中,在容差范围内定位了最后一个有效干预层,早期LoRA提高了MuSiQue精确匹配。
引言
语言模型通常需要跟踪上下文中的引用链,例如在回答查询前解析一系列变量赋值。这种能力对多跳推理和指令跟随很重要,因为模型必须组合完全在上下文中提供的事实。作者发现,冻结的预训练模型只能可靠跟踪大约1.4到3.6行赋值,即使较大的模型或预训练的循环架构也不会显著扩大这一范围,尽管Transformer原则上可以执行长得多的引用跟踪计算。其主要贡献在于表明,这一失败来自中间层的一段较短默认计算,而一个非常小的适配,例如在一个层上的秩为8 LoRA,可以将该接力扩展到单次传递中的50行,在循环情况下超过160行。作者还提供了该接力的因果解释,以及一个关于应当在何处应用此类适配的前瞻性放置测试。
数据集
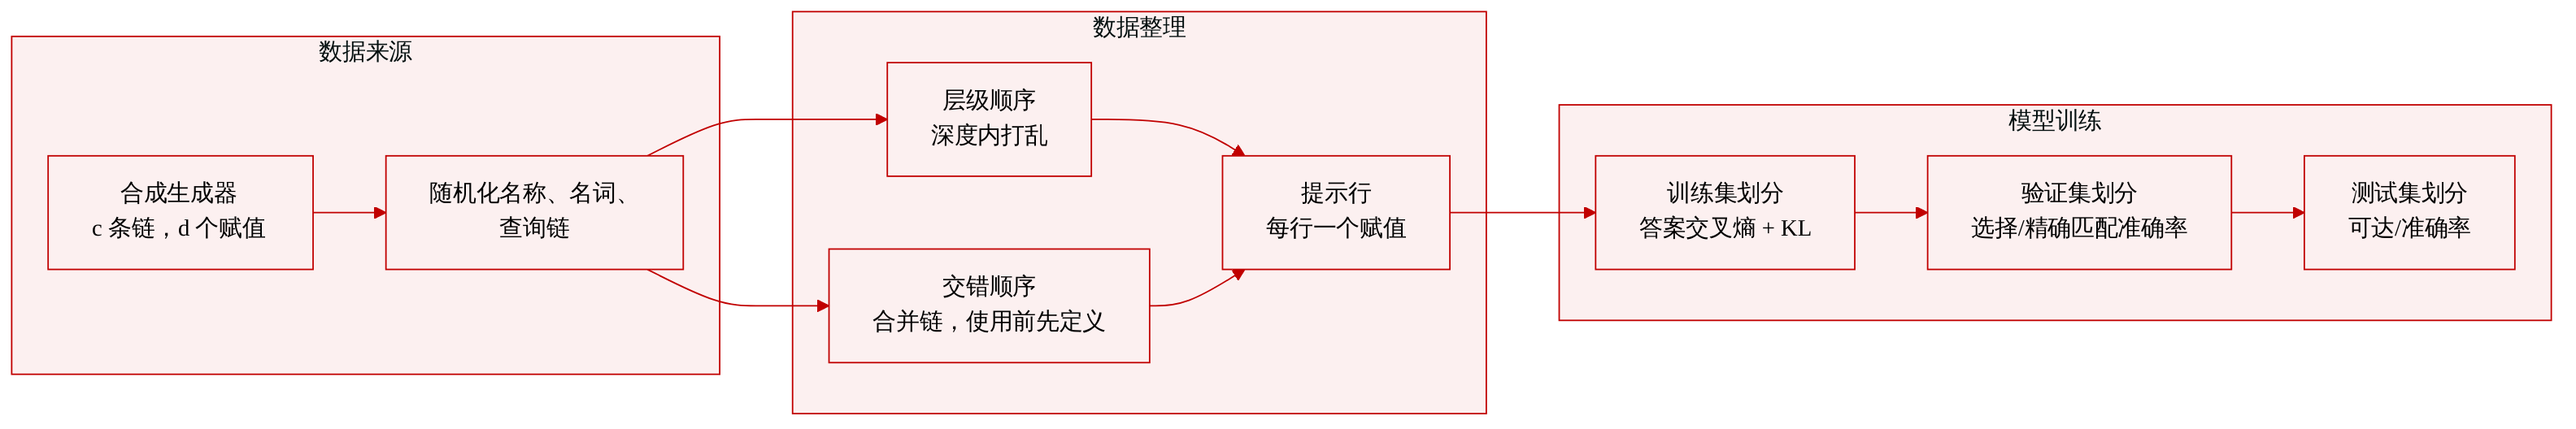
作者使用一个合成的引用链程序数据集。每个程序包含 c 条链,每条链有 d 个赋值,后跟一个查询和 Output:。
- 来源与组成: 数据是生成的,而不是从现有语料中收集。名称、名词和被查询的链均随机化。每个根赋值存储一个单 token 名词,后续每个赋值引用前一个变量。每个赋值占一个单独的提示行。答案是被查询链的根名词。
- 处理与顺序: 使用两种顺序:层序,其中赋值按深度分组并在每个层级内随机打乱;交错顺序,其中链被随机合并,同时保持先定义后使用。一行的指针是其右侧的变量,其父行定义该变量。提示头、词汇表、训练细节和评估协议见附录A。
- 规模与模式: 链长度计算包括根节点在内的赋值数。示例混合了两条三行链,而一般设置使用 c 条链和 d 个赋值。主要标准结果每个单元使用200个程序;其他样本量在附录中说明。
- 评估指标: 选择准确率在链的根值中选择,随机概率为 1/c。精确准确率要求正确根在整个词汇表上排名第一。可达范围是在至少80%准确率下被跟踪的最长链,首次向下穿越处线性插值。
- 数据使用方式: 标准模型用三链选择准确率评估。标准模型LoRA评估使用两链精确准确率。循环模型实验使用两链选择准确率,除非另有说明。该任务也用于LoRA训练,训练将答案交叉熵与WikiText-103上的KL惩罚结合。标准Qwen LoRA在最多20行的程序上训练;Ouro用四个循环训练;更长训练版本使用最多40行和更大词汇表;Huginn使用最多24行。
方法
作者设计了一个诊断性引用链任务,并将其与预训练模型中的最小单层干预配对。目标是隔离是否可以通过编辑一个隐藏状态变换、同时冻结模型其余部分来恢复长距离复制和变量绑定。
一个程序包含 c 条链,每条链有 d 个赋值。根赋值存储一个单 token 名词,链中每个后续赋值引用前一个变量。链长度计算根加上所有后续赋值。例如,一条链可能以 K = apple 开始,接着 B = K,再接着 D = B,所以正确输出值为 apple。最终查询要求模型打印其中一个变量,答案必须从各链的根值中选择。名称、名词和被查询的链均随机化。程序可以按层序排列,即赋值按深度分组并在每个层级内随机打乱;也可以按交错顺序排列,即链被合并,同时保持变量先定义后使用的约束。每个右侧变量充当指针,指向定义该变量的行。
主要干预是一个秩为8的LoRA,应用于单层输入处的残差流。变换为
h←M(h)=sh+BAh,其中 h 是所选层输入处的隐藏状态,A∈R8×n,B∈Rn×8,s 是学习到的标量,没有偏置项。这是一种DiReFT形式的表示干预。它独立作用于每个 token 位置,而冻结的注意力和 MLP 层继续处理所有 token 间的通信。只有 A、B 和 s 被训练。
学习到的缩放保持接近恒等。标准 Qwen 和 Ouro LoRA 学到的 s 分别为 1.0006 和 1.004,它们更长训练版本学到 1.008 和 1.002。因此,干预保持在原始状态上的一个小秩为8扰动。可训练参数数量为 Qwen3-8B 的 65,537、Ouro-1.4B 的 32,769 和 Huginn 的 84,481。对于循环模型,除非另有说明,在每次循环中应用相同的 LoRA。
训练将答案交叉熵与 KL 惩罚 KL(p0∥pM) 结合,该惩罚在 WikiText-103 上计算。该正则项使修改后的模型在通用文本上保持接近原始模型。在标准设置中,Qwen LoRA 在第14层输入,并在最多20行的程序上训练;Ouro LoRA 在第6层输入,并用四个循环训练。更长训练的 Qwen 和 Ouro LoRA 使用最多40行和更大词汇表,Huginn LoRA 使用最多24行。WikiText 困惑度仅略微变化,Qwen 从10.14到10.148,Ouro 在四个循环下从13.294到13.302,表明该方法是一种受控的表示级编辑,而不是广泛的行为改变。
实验
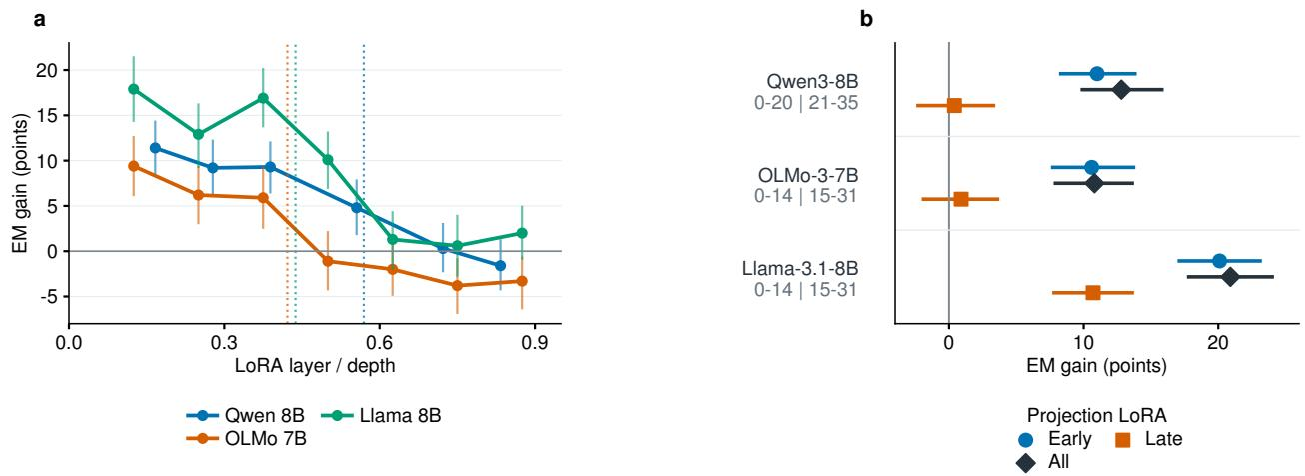
实验评估了冻结语言模型和 LoRA 干预在合成指针链程序及多跳问答上的表现,使用因果追踪、注意力分析和放置扫描。默认模型只解析少数引用步骤后接力就停止,无论增加深度或循环。一个放置在特定中间层的小型 LoRA 通过重启并扩展现有接力机制实现更长的链,并且同样的放置偏好迁移到改善的多跳问答。结果表明,在有针对性的干预下可以获得有用的计算,但其成功强烈依赖于干预施加的位置和时机。
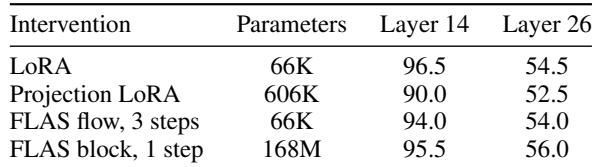
在两链、24行程序上跨多种适配方法,将编辑放在第14层时准确率远高于第26层。该模式对小型 LoRA、更大的投影 LoRA、以及 FLAS 风格的流和块编辑均成立,且训练和步数匹配。因此,早期放置优势在不同编辑类型间是共同的,并非仅仅是参数量的函数。所有测试干预在较早层均显示出显著优势,后期层准确率下降到低得多的区间。最小 LoRA 在早期层取得最佳结果,尽管参数远少于投影和块的替代方法,这强调在此位置比编辑容量更重要。
冻结截止点预测了 LoRA 更新仍然有效的位置,在四个留出模型中的三个匹配观察到的放置区间,并对一个留出模型偏离区间中点五层。其平均误差低于45%深度和值复制基线,并基本与事后相对深度规则持平。放置本身是尖锐的,因为将 Qwen3-8B 的 LoRA 后移一层可将可达范围从大幅扩展降低到接近冻结基线。冻结截止点正确找到了四个留出模型中三个模型的有效放置区间,平均绝对误差低于45%深度和值复制基线。将 Qwen3-8B 的 LoRA 放置从第20层移到第21层会急剧降低可达范围,而仅后期层干预表明,剩余深度本身并不能决定是否有用计算能够继续。
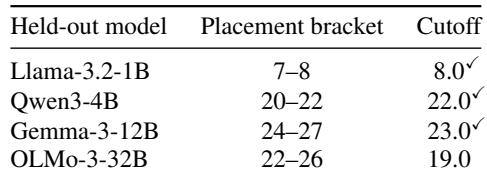
实验使用两链24行程序和留出模型,评估编辑和 LoRA 更新应放置在哪里。在小型 LoRA、投影 LoRA 和 FLAS 风格编辑中,将更新放在较早层始终产生远高于较后层的准确率,且最小 LoRA 尽管参数更少但在早期表现最佳,表明放置比编辑容量更重要。冻结截止点指标在大多数留出模型中预测了有效放置区间,并优于深度和值复制基线,而 Qwen3-8B 中一层的移动会急剧降低可达范围,说明放置是尖锐的,并且不仅仅由剩余深度决定。